日期:2026-07-30
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
關鍵詞:ablation study、控制變量、負結果、機制解釋、復現實驗
摘要
Ablation study 常被翻譯成“消融實驗”,但很多論文裡的消融其實只是“把模塊拿掉,看分數掉不掉”。這種做法能補一張表,卻不一定能回答科學問題。真正有價值的消融,是把論文裡的核心主張拆成可證偽假設:如果某個模塊、訓練目標、數據過濾規則或推理策略確實重要,那麼在控制其他因素後,移除、替換、削弱或擾動它,應當產生可解釋、可重複、方向一致的影響。
這一篇不追逐某個單一方向的 SOTA,而把 ablation study 當作科研訓練的基本功來講:如何從方法圖裡列出變量,如何設計 full model、minimal baseline、remove / replace / perturb / scale 四類消融,如何處理隨機種子和顯著性,如何把負結果寫成貢獻,以及如何從“性能變化”進一步走向“機制解釋”。2025-2026 年的 AbGen、AblationBench、NeurIPS 2026 對負結果和復現研究的強調,都說明消融設計本身已經成為 AI 研究能力的一部分,而不只是論文附錄裡的慣例。
目錄
- 為什麼 ablation study 重要
- 從論文主張到可消融假設
- 四類常用消融:remove、replace、perturb、scale
- 控制變量:別讓實驗表格騙你
- 負結果為什麼有價值
- 從分數下降到機制解釋
- 代表論文與資料路線圖
- 方法/實驗對比表
- 復現實操清單
- 常見誤區與研究生選題
- 參考資料
為什麼這個主題重要
AI 論文的方法部分越來越複雜:一個 LLM 方法可能同時包含數據篩選、prompt 模板、偏好優化、檢索器、planner、verifier、採樣策略、reranker 和專用 benchmark;一個多模態方法可能同時改視覺編碼器、投影層、訓練階段、指令數據和評估協議。主實驗表格只能告訴你“最終系統在某些 benchmark 上表現如何”,卻很難告訴你“到底是哪一部分讓它有效”。
這就是消融實驗的核心位置:它負責把“系統有效”拆成“哪些因素有效、在什麼條件下有效、為什麼可能有效”。對研究生來說,消融能力直接對應三件事:
- 讀論文時,不被複雜方法圖牽著走,而能識別真正的因果主張。
- 復現論文時,能判斷結果偏差來自實現細節、數據處理、隨機性,還是原論文主張本身不穩。
- 做 follow-up 時,能從失敗、邊界條件和機制衝突裡找到新的研究問題。
2025 年的 AbGen 把“讓 LLM 生成 ablation study design”做成 benchmark,包含來自 807 篇 NLP 論文的 1,500 個專家標註樣例,並評估重要性、faithfulness 和 soundness。2025-2026 年更新的 AblationBench 則面向 AI 研究代理,設置了 AuthorAblation 和 ReviewerAblation 兩類任務:一個幫助作者從方法部分提出消融計劃,一個幫助審稿人從完整論文裡找缺失消融。它們共同說明:消融設計已經不只是實驗技巧,而是“科研判斷力”的可評估對象。
從論文主張到可消融假設
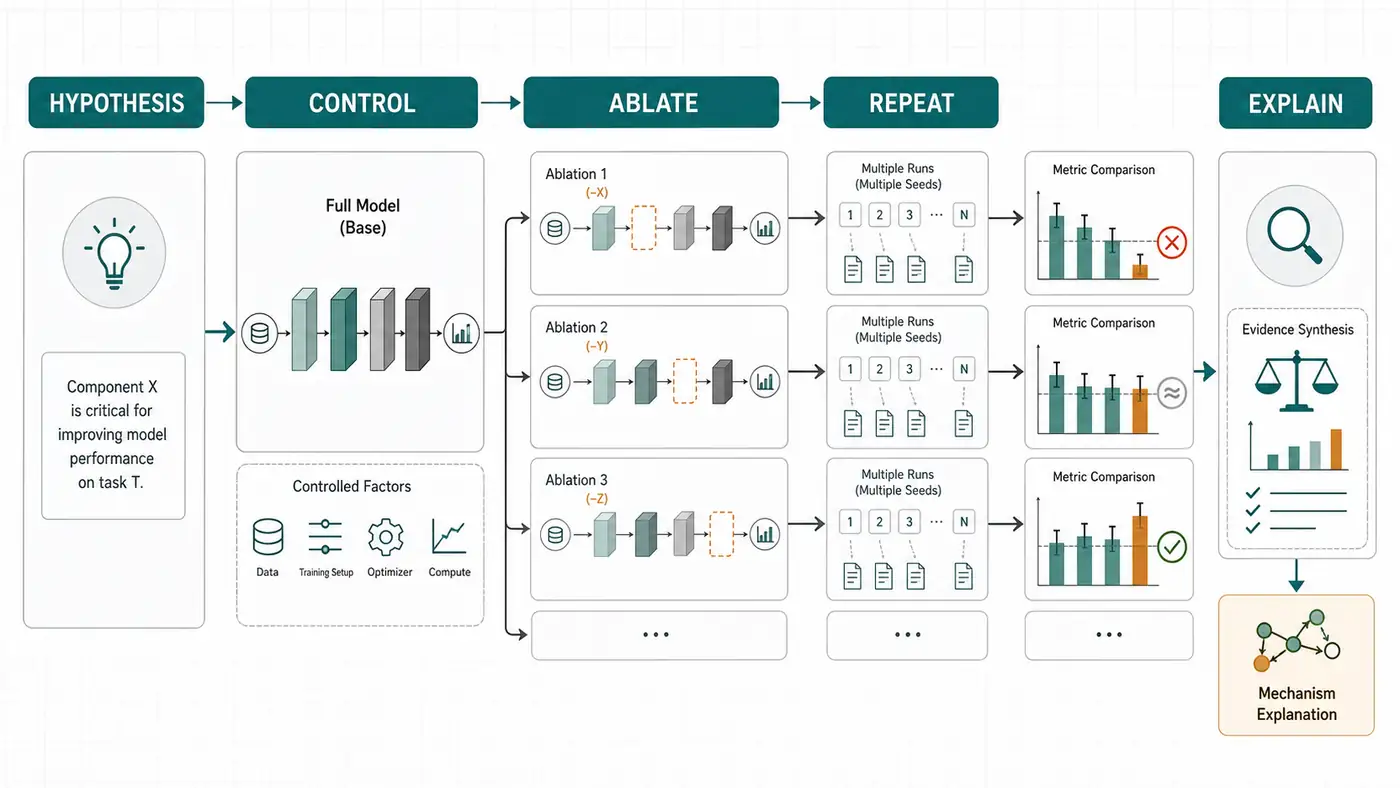
做消融的第一步不是開跑實驗,而是把論文主張寫成句子。一個可消融的假設通常長這樣:
在固定模型規模、訓練數據、訓練步數、評估集和解碼策略的條件下,模塊 X 通過機制 M 改善任務 T 上的指標 Y;如果移除或替換 X,指標 Y 應下降,且相關中間現象 Z 應同步變化。
這個句子裡有五個部分:
X:被消融對象,可以是模塊、loss、數據源、prompt、檢索策略、訓練階段或推理預算。T:任務,不要只寫“提升能力”,要具體到數學推理、長上下文問答、代碼生成、醫學報告生成等。Y:主指標,如 accuracy、pass@k、BLEU、ROUGE、F1、win rate、human preference 或 cost-normalized metric。M:機制解釋,即為什麼 X 會幫助模型,不寫機制就很容易變成純經驗堆料。Z:輔助證據,如錯誤類型、檢索命中率、verifier 通過率、token 使用量、梯度穩定性、校準誤差、重複運行方差。
很多失敗的消融實驗,是因為它只檢查 Y,沒有預先聲明 M 和 Z。比如一篇工具調用論文說 planner 模塊能提升複雜任務成功率,如果只報告 “without planner” 的總分下降,還不夠。更好的設計應同時檢查:任務是否真的被分解成更多可執行子步驟、工具調用失敗率是否下降、錯誤是否從“選錯工具”轉向“工具結果解釋錯誤”。這樣,消融才從“性能表格”變成“機制審計”。
四類常用消融
1. Remove:移除組件
最常見的消融是 full model 對比 w/o X。優點是直觀,缺點是容易混淆“組件本身重要”和“系統因接口破壞而退化”。如果移除 retrieval 後輸入長度也變短、訓練步數也減少、推理成本也變化,那麼下降不能直接歸因於 retrieval。
適合 remove 的對象包括獨立模塊、額外 loss、訓練數據子集、post-processing 規則、verifier、memory buffer 等。關鍵是移除後要有合理的替代路徑,不能讓模型進入原本不會出現的異常狀態。
2. Replace:替換為弱但合理的版本
有時 w/o X 太粗暴,更好的問題是“X 是否優於一個簡單替代方案”。例如把 learned retriever 替換成 BM25,把複雜 reranker 替換成 embedding similarity,把 agent planner 替換成固定模板,把 RLHF 替換成 SFT-only。Replace 消融更接近審稿人真正關心的問題:你的複雜設計是否必要,還是一個簡單 baseline 已經足夠。
3. Perturb:擾動組件或輸入
Perturb 消融適合驗證機制。比如打亂 retrieved documents 的順序、隨機替換 memory 條目、擾動 prompt 中的 reasoning instruction、遮蔽圖像區域、打亂工具返回內容、給 verifier 輸入錯誤證據。如果論文聲稱模型依賴某種結構性信息,那麼結構擾動應比語義無關擾動更傷性能。
4. Scale:改變強度或預算
很多 AI 方法不是開關變量,而是連續變量:檢索 top-k、CoT sample 數、test-time compute、LoRA rank、MoE expert 數、數據過濾閾值、溫度、訓練 token 預算。Scale 消融能回答“效果是否隨劑量變化”。如果只在一個超參上贏,機制解釋通常比較弱;如果隨著預算增加呈現穩定趨勢,並在成本歸一化後仍成立,證據強度更高。
控制變量:別讓實驗表格騙你
消融實驗最容易出錯的地方不是代碼,而是實驗公平性。你以為自己只改了一個模塊,實際可能同時改了訓練時間、輸入長度、參數量、隨機性和 early stopping 選擇標準。
一個可靠的 ablation table 至少要固定這些變量:
- 數據:訓練/驗證/測試劃分、過濾規則、去重策略、few-shot 示例、檢索庫版本。
- 模型:base checkpoint、參數量、tokenizer、adapter 配置、凍結/解凍範圍。
- 訓練:batch size、learning rate、scheduler、warmup、訓練步數、gradient accumulation、optimizer、精度設置。
- 推理:temperature、top-p、beam/search budget、max tokens、工具調用上限、retrieval top-k。
- 選擇:checkpoint selection 依據、是否用 validation best、是否做多次 seed、是否報告均值和方差。
- 環境:CUDA/cuDNN、推理框架、硬件、並行策略、量化設置。
ACL-IJCNLP 2021 的 reproducibility checklist 早已要求報告訓練/評估運行次數、超參邊界、選擇標準、均值方差、數據劃分和預處理。ICLR 2026 作者指南也繼續鼓勵 reproducibility statement,並要求把代碼、證明、數據處理等復現材料指向主文、附錄或補充材料。對做消融的人來說,這些不是投稿格式要求,而是實驗設計的最低防線。
一個實用原則是:每個消融變體都要寫成一條 “diff”。例如:
| 變體 | 改動 | 必須保持不變 | 主要回答的問題 |
|---|---|---|---|
| Full | 原方法完整配置 | 所有條件 | 系統上限是多少 |
| w/o verifier | 移除 verifier,直接輸出 | 數據、模型、解碼預算 | verifier 是否貢獻了質量控制 |
| BM25 retriever | 替換 dense retriever | top-k、上下文長度、生成器 | dense retriever 是否必要 |
| shuffled evidence | 打亂證據順序 | 證據集合、token 長度 | 模型是否依賴證據結構 |
| top-k sweep | k=1/3/5/10 | 其他推理參數 | 性能是否隨檢索預算穩定變化 |
如果這張 diff 表寫不清,實驗表格通常也解釋不清。
負結果為什麼有價值
很多學生害怕負結果:模塊拿掉分數沒變、複雜方法不如簡單 baseline、換數據集後提升消失、調大 test-time compute 後成本漲得比性能快。其實這些恰恰是科研最重要的信號。
NeurIPS 2026 明確把 Negative Results 列為 Main Track contribution type,並在 2026 年 MLRC 相關說明中強調,負結果和部分復現失敗只要控制嚴謹、記錄清楚,就是有價值的科學貢獻。對 ablation study 來說,負結果至少有四種含義:
- 冗餘:模塊 X 可能被其他模塊替代,系統有功能重疊。
- 條件依賴:X 只在某些數據規模、任務難度或推理預算下有用。
- 實現依賴:X 的效果來自未報告的調參、checkpoint 選擇或數據處理細節。
- 機制錯誤:論文解釋的機制 M 不成立,即使總分有時上漲。
經典的 “Understanding deep learning requires rethinking generalization” 就是負結果訓練的好例子:它不是提出一個更高分模型,而是通過系統實驗挑戰“顯式正則化解釋泛化”的常識。2025 年 “A Sober Look at Progress in Language Model Reasoning” 也把數學推理進展放回透明、穩健、統計化的評估框架中,指出許多增益對解碼參數、seed、prompt 格式、硬件和軟件配置敏感。這樣的論文提醒我們:負結果不是“沒做出來”,而是把不穩的主張變成可檢查的邊界。
從分數下降到機制解釋
消融表最常見的寫法是:
| Method | Score |
|---|---|
| Full | 最高 |
| w/o X | 下降 |
| w/o Y | 小幅下降 |
這張表只支持一個弱結論:X 可能有貢獻。它不能自動支持“X 通過某機制發揮作用”。要走向機制解釋,需要補三類證據。
第一類:中間變量證據。 如果你聲稱 retriever 提升 factuality,就不要只看最終 QA accuracy,還要看檢索命中率、引用覆蓋率、answerable rate、錯誤歸因。如果你聲稱 process supervision 改善推理,就要看步驟級錯誤、verifier 接受率、搜索樹深度和錯誤傳播。
第二類:反事實證據。 不是隻移除 X,而是替換成不同性質的 X。比如隨機檢索、oracle 檢索、低質量檢索、打亂順序檢索分別對應不同機制假設。若 oracle 檢索大幅提升而 learned retriever 不提升,問題可能在檢索器;若高質量證據仍無效,問題可能在生成器使用證據的方式。
第三類:邊界條件證據。 在簡單樣本、困難樣本、長上下文、跨域數據、低資源設置、不同模型規模下分別觀察。真正的機制解釋通常不是“X 總是有用”,而是“X 在某類瓶頸出現時有用,在另一類瓶頸下無效”。
2019 年 “Ablation Studies in Artificial Neural Networks” 從神經科學的 ablation 傳統出發,把人工神經網絡中的結構損傷、表示冗餘和恢復訓練聯繫起來。它提醒我們,消融不是隻為投稿表格服務,也可以作為理解模型內部表徵和魯棒性的工具。2019 年 Lottery Ticket Hypothesis 也可作為機制型實驗的閱讀對象:剪枝不只是壓縮技巧,圍繞初始化、子網絡和可訓練性的一系列實驗把“哪些連接重要”轉化為可檢驗假設。
代表論文與資料路線圖
經典基礎線
- 2016/2017:Zhang 等人的 “Understanding deep learning requires rethinking generalization”。學習重點:如何通過控制實驗挑戰主流解釋,而不是隻追求更高指標。
- 2018/2019:Frankle 和 Carbin 的 “Lottery Ticket Hypothesis”。學習重點:從剪枝實驗走向關於初始化和可訓練子網絡的機制假設。
- 2019:Meyes 等人的 “Ablation Studies in Artificial Neural Networks”。學習重點:把 ablation 當作分析結構、冗餘和魯棒性的工具。
復現與評估規範線
- ACL-IJCNLP 2021 reproducibility checklist:學習重點是運行次數、超參範圍、選擇標準、均值方差和數據處理。
- ICLR 2026 Author Guide:學習重點是 reproducibility statement 如何引用代碼、數據處理、理論證明和補充材料。
- AAAI-26 Reproducibility Checklist:學習重點是理論主張、實驗代碼、數據動機和數據可用性的基本核查。
- NeurIPS 2026 Evaluations & Datasets reviewer guidelines:學習重點是評估協議、工具、數據審計和負結果的審稿標準。
2025-2026 新趨勢線
- AbGen:把 ablation study design 做成 LLM 科研能力評測。它的重要性不在於“讓模型替你設計實驗”,而在於把重要性、faithfulness、soundness 這些人類科研判斷拆成可標註維度。
- AblationBench:從作者和審稿人兩個視角評估自動消融規劃。最新版 arXiv v3 更新於 2026-06-01,論文頁鏈接了 Hugging Face 數據和 GitHub 代碼。它對研究生很有用:你可以反過來用它訓練自己從 method section 裡找缺失實驗。
- A Sober Look at Progress in Language Model Reasoning:適合學習為什麼 seed、prompt、decoding 和環境差異會改變結論。
- 100 Days After DeepSeek-R1:適合看 reasoning model 復現研究如何圍繞 SFT、RLVR、數據構造和訓練配方尋找可復現實驗路徑。
方法/實驗對比表
| 消融目標 | 推薦設計 | 證據強度 | 常見風險 |
|---|---|---|---|
| 證明模塊有用 | Full vs w/o module,同時保持輸入長度和訓練預算 |
中 | 接口破壞導致虛假下降 |
| 證明覆雜模塊必要 | 與簡單替代方案比較,如 BM25、固定 prompt、SFT-only | 高 | baseline 調參不足 |
| 證明機制成立 | 加中間指標和結構擾動 | 高 | 只看總分,不看錯誤類型 |
| 證明趨勢穩定 | 多 seed、多個數據集、預算 sweep | 高 | 計算成本高,容易選擇性報告 |
| 解釋負結果 | 報告失敗條件、日誌、誤差分析 | 高 | 被寫成“實驗沒成功”而非科學結論 |
復現實操清單
復現一篇論文的消融時,可以按下面順序推進。
第 0 步:先復現 full model 或主實驗。 不要一上來做消融。先確認原配置、數據版本、checkpoint、評估腳本和主指標能跑通。若主實驗偏差很大,消融結果沒有解釋力。
第 1 步:畫變量圖。 把方法拆成輸入、模型、訓練目標、數據處理、推理策略、評估協議。每個節點標註“可移除、可替換、可擾動、可調強度”。
第 2 步:寫 hypothesis log。 每個消融前寫下預期方向、預期機制和可能失敗原因。不要等結果出來後再補解釋。
第 3 步:建立配置矩陣。 用 YAML、JSON 或實驗管理工具保存每個變體。配置文件裡只改一個關鍵字段,其他字段繼承 base config。
第 4 步:固定隨機性但不要迷信單 seed。 記錄 seed、框架版本和硬件;風險較高的實驗至少跑 3 個 seed。LLM 推理任務還要固定 sampling 參數、prompt 模板、batching 和 stop tokens。
第 5 步:同時保存原始輸出。 對生成式任務,只保存聚合分數不夠。要保存 prompts、model outputs、tool traces、retrieved docs、judge inputs、judge outputs 和失敗樣例。
第 6 步:先看 sanity check。 如果 w/o X 比 full model 高,不要急著寫驚喜結論。先檢查是否 full model 過擬合、X 引入噪聲、評估腳本緩存錯誤、或兩個變體使用了不同 checkpoint。
第 7 步:寫 negative result note。 即使實驗不支持原假設,也要記錄:哪些條件固定了、跑了幾次、結果方向如何、最可能的解釋是什麼、下一步如何區分這些解釋。
第 8 步:形成機制圖。 最後的圖不應只是柱狀圖,而應展示“假設-干預-觀察-解釋”的鏈條。正文流程圖可以比單純分數表更能幫助讀者理解研究貢獻。
常見誤區
誤區一:把所有模塊都 w/o 一遍就叫完整消融。 真正的問題不是“每個模塊刪掉會怎樣”,而是“論文主張依賴哪些必要條件”。有些模塊適合 remove,有些更適合 replace 或 perturb。
誤區二:不調 baseline,只調 full model。 如果 full model 經過大量調參,而 ablation baseline 用默認參數,下降可能只是調參不公平。複雜方法尤其要給強 baseline 足夠預算。
誤區三:只報告提升,不報告方差。 在小 benchmark、LLM judge、開放式生成任務中,單次運行的差異可能足以改變結論。沒有 seed 和方差的消融表,證據強度很有限。
誤區四:把負結果藏到附錄。 如果負結果改變了對方法的理解,它應該進入主文敘事。一個模塊只在特定數據規模下有效,比“模塊普遍有效”更誠實,也更可能啟發後續研究。
誤區五:把 ablation 當成審稿補丁。 消融應該在方法設計初期就進入實驗計劃。等審稿人問了再補,常常會發現日誌缺失、配置不可追蹤、計算預算不夠。
適合研究生繼續做的選題
- Ablation quality rubric for LLM papers:構建一套面向 LLM 論文的消融質量評分表,區分 remove、replace、perturb、scale 和機制證據。
- Seed sensitivity audit:選擇一個熱門 reasoning 或 agent benchmark,系統評估 seed、prompt、decoding 和框架版本對消融結論的影響。
- Negative ablation report collection:收集“複雜模塊沒有帶來穩定收益”的復現報告,分析哪些負結果最容易被論文敘事忽略。
- Ablation planner assistant:基於 AblationBench 或 AbGen 的任務形式,做一個輔助研究生生成消融計劃的工具,但重點評估 faithfulness 和 soundness,而不是隻看生成數量。
- Mechanism-aware ablation for RAG or agents:不只看最終 answer accuracy,而把檢索命中率、工具調用軌跡、錯誤傳播路徑和 judge 偏差納入機制解釋。
總結
Ablation study 的本質不是“刪模塊”,而是“用受控干預檢驗科研主張”。一張好的消融表應該回答三個層次的問題:第一,某個組件是否帶來穩定效果;第二,這個效果是否優於簡單替代方案;第三,觀察到的變化是否符合論文聲稱的機制。負結果、方差、失敗樣例和邊界條件不是噪聲,而是形成研究判斷的材料。
對 AI 論文精讀與復現訓練來說,消融是從讀者走向研究者的一道門檻。讀論文時問“這個主張應該怎麼被消融推翻”;復現時問“我是否只改了一個變量”;寫 follow-up 時問“哪個負結果暴露了更深的問題”。能穩定回答這些問題,比多背幾篇論文摘要更重要。
參考資料
檢索日期:2026-07-30。
- Yilun Zhao et al., “AbGen: Evaluating Large Language Models in Ablation Study Design and Evaluation for Scientific Research,” arXiv:2507.13300, submitted 2025-07-17, ACL 2025. https://arxiv.org/abs/2507.13300
- Talor Abramovich and Gal Chechik, “AblationBench: Evaluating Automated Planning of Ablations in Empirical AI Research,” arXiv:2507.08038, submitted 2025-07-09, latest version v3 on 2026-06-01; AI4Science Workshop, ICML 2026. https://arxiv.org/abs/2507.08038
- Hugging Face dataset page, “ai-coscientist/researcher-ablation-bench,” dataset for AblationBench with repository link and dataset structure. https://huggingface.co/datasets/ai-coscientist/researcher-ablation-bench
- Richard Meyes, Melanie Lu, Constantin Waubert de Puiseau, Tobias Meisen, “Ablation Studies in Artificial Neural Networks,” arXiv:1901.08644, 2019. https://arxiv.org/abs/1901.08644
- Chiyuan Zhang, Samy Bengio, Moritz Hardt, Benjamin Recht, Oriol Vinyals, “Understanding deep learning requires rethinking generalization,” arXiv:1611.03530, ICLR 2017. https://arxiv.org/abs/1611.03530
- Jonathan Frankle and Michael Carbin, “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks,” arXiv:1803.03635, ICLR 2019. https://arxiv.org/abs/1803.03635
- Andreas Hochlehnert et al., “A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility,” arXiv:2504.07086, accepted to COLM 2025, latest arXiv version checked 2025-10-06. https://arxiv.org/abs/2504.07086
- Chong Zhang et al., “100 Days After DeepSeek-R1: A Survey on Replication Studies and More Directions for Reasoning Language Models,” arXiv:2505.00551, latest version v3 on 2025-05-15. https://arxiv.org/abs/2505.00551
- ICLR 2026 Author Guide, reproducibility statement and code/supplementary guidance. https://iclr.cc/Conferences/2026/AuthorGuide
- NeurIPS 2026 Evaluations & Datasets Reviewing Guidelines, sections on reproducibility, auditing, stress-testing, code artifacts and negative results. https://neurips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines
- NeurIPS Blog, “2026 Conference” category page, MLRC 2026 and contribution type notes mentioning negative results and reproducibility. https://blog.neurips.cc/category/2026-conference/
- AAAI-26 Reproducibility Checklist. https://aaai.org/conference/aaai/aaai-26/reproducibility-checklist/
- ACL-IJCNLP 2021 Reproducibility Checklist. https://2021.aclweb.org/calls/reproducibility-checklist/