日期:2026-07-29
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
本篇目標:把零散實驗記錄整理成可審計的 reproduction report,再轉寫成一篇對讀者有幫助的中文技術博客。
摘要
很多論文復現失敗,並不是因為實驗本身沒有價值,而是因為記錄方式太像“個人流水賬”:今天裝了環境,明天改了 bug,後天跑出一個分數,最後寫一句“沒有復現成功”。這樣的筆記對自己有短期幫助,卻很難讓導師、同學或後來讀者判斷:你復現的是論文哪個主張?使用了哪些作者工件?哪些配置與原論文一致?哪些地方是你自己的替代實現?結果差異來自資源限制、實現錯誤、隨機性、評測腳本,還是論文主張本身不穩?
2025-2026 年,復現報告的重要性繼續上升。MLRC 2026 成為 NeurIPS 官方 track,明確把 reproduction、replication、generalizability study、meta-reproducibility 和 AI-assisted reproducibility 視為可發表的研究貢獻;ACL 2026 的 ReproEvalCard 進一步指出,現代 LLM pipeline 的復現需要記錄 prompt、judge 配置、retrieval snapshot、intermediate traces 等評測工件;OpenAI 的 PaperBench 則把“從論文到可運行實驗”拆成分層 rubric,讓復現任務可以被逐項評分。這些變化說明:復現筆記不只是實驗備忘錄,而是科研證據鏈。
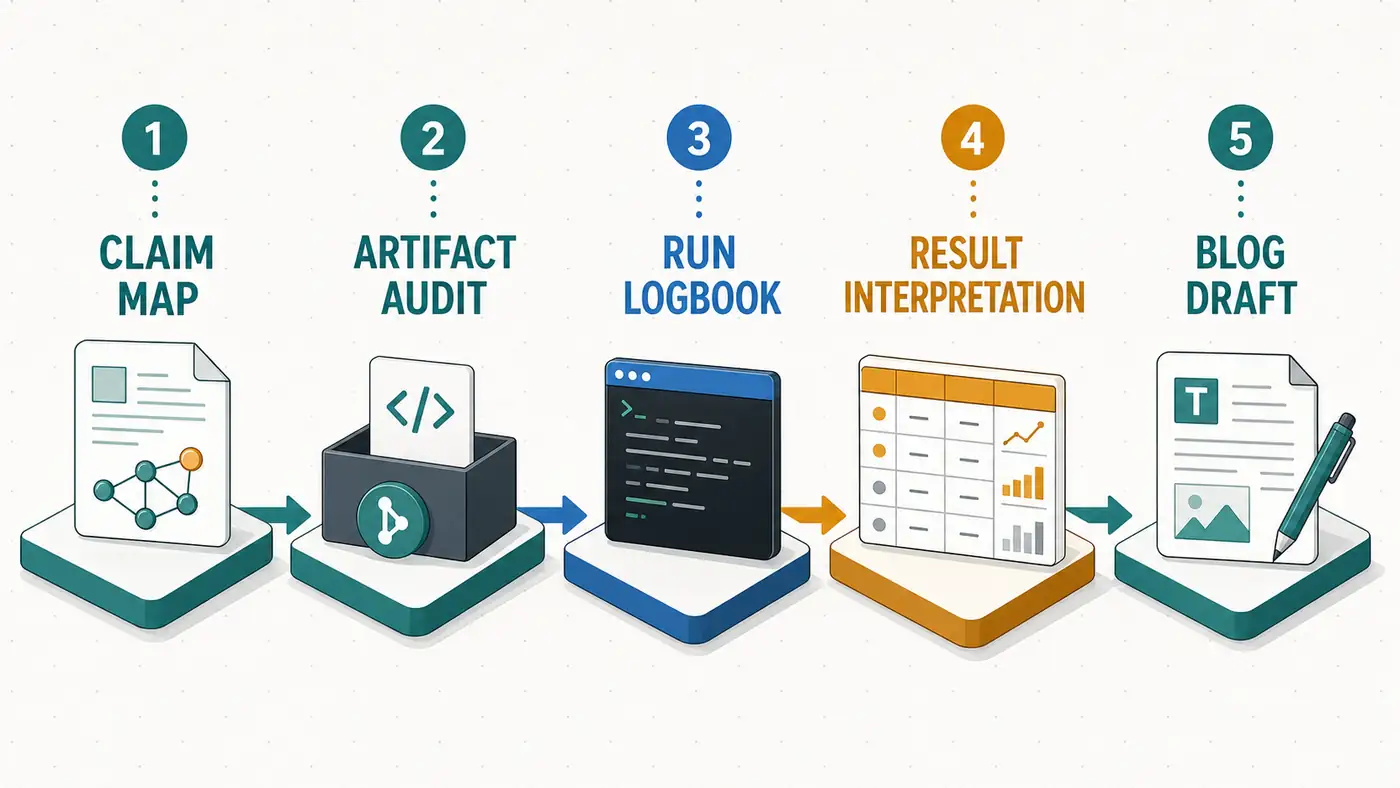
本篇給出一套面向研究生的寫作方法:先寫 claim map,再寫 artifact audit,然後維護 run logbook,最後把 reproduction report 轉寫成博客草稿。核心原則是:博客可以有敘事,但底層必須有報告;結論可以簡潔,但證據鏈不能斷。
目錄
- 為什麼復現筆記不能等到實驗結束再寫
- 三種文檔:實驗日誌、reproduction report、博客草稿
- 寫作前先定義復現範圍
- Reproduction report 的七個核心模塊
- 從 report 轉寫成博客的五步流程
- 代表資料與寫作路線圖
- 方法與實驗記錄對比表
- 可操作檢查清單
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼復現筆記不能等到實驗結束再寫
復現筆記最容易被誤解成“實驗做完後的總結”。這會導致三個問題。
第一,很多關鍵信息只在實驗當下可見。比如你第一次跑通代碼時使用的倉庫 commit、下載數據時的 revision、某個依賴自動解析出的版本、一次失敗運行中的報錯、一次指標異常時的 raw output。如果不當場記錄,幾週後很難還原。
第二,復現結論常常依賴負結果。論文主表是否能復現當然重要,但“哪一步跑不起來”“哪個超參數論文沒寫”“哪個 baseline 需要額外 patch”“哪個 metric parser 會吞掉異常樣本”同樣是證據。MLRC 2026 的官方說明特別強調,負結果和部分復現失敗也有科學價值,關鍵是要清楚說明嘗試過什麼、發現了什麼、結論邊界在哪裡。
第三,博客寫作需要比個人日誌更強的結構。讀者不會關心你所有的安裝細節,但會關心:這篇論文的主張是否值得信?如果我要繼續做這個方向,應該避開哪些坑?如果我用更小資源復現,哪些實驗最值得優先跑?這要求你在實驗過程中就按“未來讀者會問什麼”來組織材料。
因此,復現筆記應該從第一天開始寫。它不是最後的包裝,而是復現實驗的一部分。
三種文檔:實驗日誌、Reproduction Report、博客草稿
建議把復現寫作拆成三層,不要混在一個文件裡。
實驗日誌面向自己,記錄事實。它可以粗糙,但必須及時:命令、配置、commit、數據版本、報錯、修改、GPU 時間、seed、raw output、metric 文件路徑。實驗日誌不追求文采,追求可追溯。
Reproduction report面向審閱者,記錄證據鏈。它要回答:復現範圍是什麼?主張如何拆解?哪些工件可得?方法如何實現?結果如何比較?哪些結論被確認、部分確認、未能確認或無法判斷?它的讀者可能是導師、課程助教、reviewer 或未來的自己。
博客草稿面向更廣泛的科研讀者,記錄可遷移經驗。它不應堆滿所有日誌,而要把關鍵路徑講清楚:為什麼選這篇論文,怎麼拆 claim,復現中遇到什麼證據問題,結果如何影響你對方法的理解,下一步可以做什麼研究。
這三層的關係是:日誌提供原始證據,report 形成審計結論,博客負責教學表達。不要直接從日誌跳到博客,否則文章容易變成“踩坑日記”;也不要只寫博客不留 report,否則結論缺少可核驗底座。
寫作前先定義復現範圍
正式寫 report 前,先用一句話定義範圍:
本復現嘗試檢驗論文 P 中 claim C:在數據集 D、split S、metric M、模型或方法 A、baseline B、訓練/推理預算 R 和環境 E 下,A 是否產生論文報告的方向性結果或數值結果。
這句話看似繁瑣,卻能避免大多數復現報告的模糊表達。比如“我們復現了某篇 RAG 論文”太寬;“我們復現了表 2 中方法 X 在 HotpotQA distractor split 上相對 BM25 + FiD 的 EM/F1 改進,並在無法取得原始檢索索引時使用作者 release 的索引快照替代”才是可審計目標。
復現範圍可以分四類:
| 類型 | 目標 | 適合寫成什麼結論 |
|---|---|---|
| Exact reproduction | 使用作者代碼、數據和配置重跑主結果 | “在相同工件下,主結果可/不可重複” |
| Partial reproduction | 關鍵工件缺失或資源不足,只復現子集 | “在受限設定下,方向性證據支持/不支持 claim” |
| Independent reimplementation | 不用作者代碼,獨立實現方法 | “論文描述是否足以支持第三方實現” |
| Replication / generalization | 換數據、模型、硬件或任務測試 | “claim 是否能推廣到新設定” |
很多研究生項目其實是 partial reproduction 或 independent reimplementation,卻在標題裡寫“復現某某論文”。這會誇大結論。更好的寫法是把範圍寫清楚:復現了哪張表、哪條 claim、哪組 ablation;沒復現的部分為什麼沒做。
Reproduction Report 的七個核心模塊
1. Reproducibility Summary
報告第一頁建議保留一個固定摘要。Papers with Code 組織的 ML Reproducibility Challenge 2022 曾要求報告首頁包含 scope、methodology、results、what was easy、what was difficult。這個模板非常適合訓練,因為它迫使作者把復現貢獻壓縮成可讀的證據摘要。
可以使用下面的中文版本:
| 字段 | 應該寫什麼 | 不要寫什麼 |
|---|---|---|
| Scope of reproducibility | 復現哪個 claim、表格、圖或實驗設定 | “復現整篇論文” |
| Methodology | 使用作者代碼還是重寫,改了哪些地方 | “參考論文實現” |
| Results | 與論文結果的方向、數值、方差和差異 | 只寫“基本一致” |
| What was easy | 作者工件中降低復現成本的部分 | 禮貌性誇獎 |
| What was difficult | 缺失、歧義、資源限制、環境問題 | 把所有失敗歸咎於作者 |
| Communication | 是否聯繫作者、issue、郵件或討論區 | 隱去關鍵澄清來源 |
| Verdict | 確認、部分確認、未確認、無法判斷 | 二元化“成功/失敗” |
摘要不是引言。它應該讓讀者在一分鐘內知道這次復現的範圍和可信度。
2. Original Claims
復現報告必須把原論文主張拆成編號列表。每條 claim 都要對應證據來源,例如論文摘要、引言貢獻段、方法章節、表格、圖、附錄或項目頁。
推薦格式:
Claim 1: 方法 A 在 benchmark D 上优于 baseline B。
Evidence in original paper: Table 2, Section 4.1.
Reproduction target: rerun official evaluation with released checkpoint.
Status: tested / partially tested / not tested.
注意,claim 不等於論文貢獻點的中文翻譯。它必須能被實驗檢驗。如果一條 claim 寫成“方法很有效”,說明還沒有拆到位;應該改成“在 X 數據集、Y metric、Z baseline 下,方法 A 的結果方向優於 B”。
3. Artifact Inventory
Artifact inventory 是 report 的骨架。它回答“讀者能否重建你的實驗現場”。
至少記錄:
- 論文 PDF、OpenReview / arXiv / ACL Anthology / proceedings 鏈接和版本;
- 作者代碼倉庫、commit hash、release tag、license;
- 數據集名稱、版本、split、下載時間、hash 或樣本數;
- 模型權重、tokenizer、adapter、quantization、revision;
- 環境:OS、Python、CUDA、GPU、關鍵依賴;
- 配置:訓練、推理、評測、prompt、post-processing;
- 日誌:原始命令、stdout/stderr、metric 輸出、raw generations;
- 修改:本地 patch、bug fix、替代實現、無法使用的原始工件。
2025 年 NeurIPS Datasets & Benchmarks Track 要求數據和 benchmark code 在提交時可訪問,並引入 Croissant metadata 要求;ICLR 2025 Author Guide 也鼓勵作者提交代碼並寫 reproducibility statement。這些會議要求可以反過來成為復現者的審計清單:作者有沒有給足足以復現的材料?缺口在哪裡?
4. Environment and Execution
環境記錄不要只寫“Python 3.10 + PyTorch”。要寫到別人能定位差異:
OS: Ubuntu 22.04
GPU: A100 80GB x 1
Driver / CUDA: ...
Python: ...
Key packages: torch, transformers, datasets, accelerate, vllm, peft
Repo commit: ...
Command: bash scripts/eval_x.sh --config configs/y.yaml
Seed policy: 3 seeds, seed = 13 / 21 / 42
如果你改了代碼,必須把 diff 放入附錄或倉庫,並在正文說明改動意圖。不要把“修了幾個 bug”寫成一句話。復現報告關心的是:這些改動是否改變了論文方法?是否只修正環境兼容性?是否可能解釋結果差異?
5. Results and Deviation Analysis
結果部分要同時報告“數值”和“解釋”。建議每張結果表後面加三段:
- Matched parts:哪些結果與原論文一致;
- Divergent parts:哪些結果不同,差異有多大;
- Likely causes:可能原因是什麼,還需要什麼實驗才能區分。
不要編造 SOTA 或排名結論。對於復現報告,更重要的是“證據強度”而不是“漂亮數字”。如果只跑了一個 seed,就寫一個 seed;如果只跑了 10% 數據,就標明 scale;如果沒有原始測試集,就寫無法完整比較;如果復現失敗但無法定位原因,就寫“無法判斷”,不要寫“論文錯誤”。
6. Error Log and Decision Log
高質量 report 通常有兩種附錄:error log 和 decision log。
Error log 記錄失敗運行:錯誤類型、復現步驟、解決方案、是否影響最終結果。Decision log 記錄人為判斷:為什麼換數據 split、為什麼降低 batch size、為什麼把 fp32 改成 bf16、為什麼跳過某個 baseline。
這兩個日誌的價值在於減少“事後合理化”。很多復現結論看起來清楚,是因為作者把不方便解釋的路徑刪掉了。科研訓練應該反過來:保留關鍵失敗路徑,並說明它如何改變你對論文的理解。
7. Verdict and Recommendations
結論建議避免“成功復現 / 未成功復現”的二元表述,改用四級 verdict:
| Verdict | 含義 | 示例表達 |
|---|---|---|
| Confirmed | 主要 claim 在約定範圍內得到支持 | “主表方向和量級均接近原文” |
| Partially confirmed | 部分設定支持,部分設定不支持 | “小模型成立,大模型或新數據未確認” |
| Not confirmed | 復現實驗與主 claim 衝突 | “同一配置下未觀察到論文報告優勢” |
| Inconclusive | 工件缺失或資源不足,無法判斷 | “缺少測試集標籤,無法比較主 metric” |
最後給作者、復現者和後續研究者各寫一條建議。比如作者應公開 evaluation script 和 raw outputs;復現者應固定數據 revision;後續研究可以做多 seed 方差分析或跨硬件測試。
從 Report 轉寫成博客的五步流程
第一步:把 claim map 改寫成讀者問題
Report 寫給審閱者,博客寫給學習者。轉寫時先把每個 claim 改成讀者會問的問題:
- 這篇論文真正想證明什麼?
- 證據來自哪張表或哪組實驗?
- 這個證據依賴哪些隱藏條件?
- 如果復現資源有限,最小可驗證實驗是什麼?
- 結果差異會如何影響後續選題?
博客開頭不要複述摘要。更好的開頭是講清楚“為什麼這篇論文值得復現,以及復現它能訓練哪種科研能力”。
第二步:把 artifact audit 改寫成可學習的檢查清單
Report 中的 artifact inventory 可能很細,博客中不必全部展開,但要保留模式。比如可以把“環境、數據、權重、seed、日誌”寫成一張 checklist,並配合具體例子說明。
博客讀者最需要的不是你的完整 conda list,而是學會問:
- 論文有沒有提供不可變版本的代碼?
- 數據集是否可能在 Hub 上發生 revision 漂移?
- checkpoint 與 tokenizer 是否匹配?
- baseline 是作者重跑的,還是引用過去論文數字?
- metric script 是否與 leaderboard 一致?
- raw outputs 是否可以複查?
這樣寫,文章就從“我的復現經歷”變成“讀者可遷移的方法”。
第三步:把 run logbook 改寫成關鍵轉折
實驗日誌裡有大量噪聲。博客只保留改變判斷的節點:
- 第一次 minimal run 暴露了什麼問題;
- 哪個配置差異解釋了主要結果偏差;
- 哪個失敗樣本揭示了 metric 或 prompt 的脆弱性;
- 哪個 ablation 讓你改變了對方法機制的理解;
- 哪個缺失工件導致結論只能 partial。
寫作時可以採用“問題 -> 排查 -> 證據 -> 結論邊界”的段落結構。不要寫成“上午裝環境,下午跑腳本,晚上報錯”的時間線。
第四步:把結果表改寫成證據強度
博客裡的表格不要只是複製 report 數字。每個結果都要告訴讀者它支持什麼、不能支持什麼。
建議用下面的表格:
| 觀察 | 支持的結論 | 不能推出的結論 | 下一步實驗 |
|---|---|---|---|
| 方法在 3 個 seed 上方向一致 | claim 在本設定下較穩 | 不代表跨數據集泛化 | 換數據或換模型 |
| baseline 與論文數字差異大 | 評測 pipeline 可能不同 | 不等於作者結果錯誤 | 複查 split 和 parser |
| ablation 方向不穩定 | 機制解釋較弱 | 不等於主方法無效 | 增加 seed 和樣本量 |
這種寫法比“我們跑出了 X 分”更適合科研訓練。
第五步:把 verdict 改寫成選題入口
一篇好的復現博客,結尾不只是“總結經驗”,還應該提出 follow-up idea。復現過程中發現的問題,往往正是研究選題來源:
- 如果結果依賴 prompt,可以做 prompt sensitivity study;
- 如果缺少 raw outputs,可以做 evaluation trace standard;
- 如果 baseline 復現困難,可以做 benchmark implementation audit;
- 如果多 seed 方差很大,可以做 variance-aware evaluation;
- 如果小模型和大模型趨勢相反,可以做 scaling-dependent mechanism study;
- 如果作者工件質量參差不齊,可以做 artifact quality checklist 或自動審計工具。
這樣,復現筆記就不只是練習,而是通向 proposal 的材料庫。
代表資料與寫作路線圖
1. NeurIPS 2019 Reproducibility Program:制度化復現的起點
Pineau 等人在 JMLR 2021 的報告總結了 NeurIPS 2019 reproducibility program:code submission policy、community-wide reproducibility challenge 和 ML reproducibility checklist 共同構成制度化嘗試。對寫作訓練來說,它提醒我們:復現不是個人“跑代碼能力”的問題,而是論文寫作、工件發佈、會議審查和社區反饋的組合問題。
讀這篇報告時,重點不在歷史細節,而在三個問題:會議如何要求作者報告?復現挑戰如何組織學生和社區?checklist 如何把“可復現”拆成可檢查項?
2. MLRC 2026:復現成為正式研究貢獻
MLRC 2026 官網顯示,它將作為 NeurIPS 2026 官方 track 舉辦;NeurIPS 博客在 2026 年 5 月說明,復現論文需要先在 TMLR 接受,並且歡迎確認、部分復現、失敗復現、泛化研究、元復現研究、AI-assisted reproducibility 等類型。對研究生來說,這改變了復現筆記的定位:它不再只是課程作業,也可能是可以繼續打磨的研究產物。
寫 report 時可以借鑑 MLRC 的精神:不要把失敗藏起來。只要範圍清楚、證據充分、原因分析謹慎,部分失敗也能產生知識。
3. ReproEvalCard:LLM Pipeline 的評測工件標準
ACL 2026 的 ReproEvalCard 審計了 2022-2025 年 pipeline-based LLM 論文,並指出 prompt、judge configuration、retrieval snapshot、intermediate traces 等是復現評測所需的關鍵工件。它還報告了隨機性控制和中間 trace 缺失會限制評測復現。
這對博客寫作有直接啟發:如果你復現的是 RAG、agent、tool-use、LLM-as-judge 或 prompt-chain 論文,正文必須單獨寫“評測工件”。不要只寫模型和數據。沒有 prompt、judge、檢索庫快照和執行軌跡,很多 LLM 系統結果只能被部分審計。
4. PaperBench:把復現拆成可評分任務
OpenAI 在 2025 年發佈 PaperBench,要求 agent 從頭復現 20 篇 ICML 2024 Spotlight / Oral 論文,並用分層 rubric 拆成大量可評分子任務。它對普通研究生最有價值的不是 agent 分數,而是 rubric 思想:復現不是一個動作,而是由 paper understanding、implementation、experiment execution、result matching、analysis 等子任務組成。
寫復現筆記時,可以給自己做一個小型 rubric:理解貢獻 20 分,工件審計 20 分,最小運行 15 分,主結果 25 分,誤差分析 20 分。這樣能避免只追最終數字。
5. Papers with Code Research Code Checklist:代碼工件的最低線
Papers with Code 的 research code checklist 把依賴、訓練代碼、評測代碼、預訓練模型、README 與復現命令列為核心項。雖然它最初面向作者發佈代碼,但復現者也可以倒過來用:如果一個倉庫缺訓練腳本、缺評測腳本、缺精確命令、缺權重或缺依賴說明,report 中就應該明確標註。
6. DeepSeek-R1 之後的 replication studies:開放細節不足時如何寫
2025 年 arXiv 綜述“100 Days After DeepSeek-R1”總結了 DeepSeek-R1 發佈後大量 reasoning model replication studies,指出部分實現細節未完全開源,因此社區圍繞 SFT、RLVR、數據構造和訓練過程進行了復刻。這個案例很適合訓練“開放權重不等於完整可復現”的判斷:當訓練數據、過濾策略、獎勵細節或算力配置缺失時,報告應寫成 replication / approximation,而不是 exact reproduction。
方法與實驗記錄對比表
| 記錄對象 | 低質量寫法 | 高質量寫法 | 博客轉寫方式 |
|---|---|---|---|
| 復現目標 | “復現論文結果” | “復現 Table 3 的 Claim 2,使用官方 checkpoint 和 dev split” | 用讀者問題開頭 |
| 環境 | “按 README 安裝” | 記錄 OS、GPU、CUDA、依賴、commit、命令 | 提煉為環境審計清單 |
| 數據 | “使用 GSM8K” | 記錄來源、版本、split、preprocess、樣本數、hash | 說明數據漂移風險 |
| 權重 | “使用 Qwen 模型” | 記錄 repo、revision、tokenizer、adapter、quantization | 解釋權重配對關係 |
| 失敗運行 | “報錯很多” | 記錄錯誤、原因、patch、是否影響結論 | 只寫改變判斷的失敗 |
| 結果 | “基本一致” | 報告數值、方差、scale、差異和可能原因 | 寫成證據強度 |
| 結論 | “復現成功” | Confirmed / Partially confirmed / Not confirmed / Inconclusive | 引出 follow-up idea |
可操作檢查清單
寫 reproduction report 前,逐項檢查:
- 我是否列出了 1-3 條可測試 claim?
- 每條 claim 是否對應論文中的表、圖、段落或附錄?
- 我是否說明了復現類型:exact、partial、independent reimplementation 或 replication?
- 作者代碼是否記錄了 commit、branch、license 和本地 patch?
- 數據是否記錄了來源、版本、split、預處理和樣本數?
- 權重是否記錄了 checkpoint revision、tokenizer、adapter、量化和 license?
- 評測是否記錄了 prompt、metric、parser、judge、raw outputs?
- seed 是否不只寫一個數字,而是說明隨機源和多 seed 策略?
- 結果是否區分數值差異、方向性差異和統計不確定性?
- 失敗運行是否保留了足夠的信息,讓別人知道你嘗試過什麼?
- 結論是否避免把資源限制誤寫成論文錯誤?
- 博客是否把個人經歷轉化成讀者可複用的方法?
寫博客草稿前,再檢查:
- 開頭是否說明“為什麼復現這篇論文值得學”?
- 是否用一張圖或一張表展示覆現路線?
- 是否減少安裝流水賬,保留關鍵證據節點?
- 是否明確哪些內容待人工核驗?
- 是否在文末給出參考資料和檢索日期?
常見誤區
誤區一:把 README 跑通當作復現。 跑通 demo 只能說明 artifact 可執行,不能說明論文主張被複現。真正的 report 必須連接 claim 和 evidence。
誤區二:只報告最好的 run。 如果跑了多個 seed,只寫最高分,會把復現報告變成選擇性報告。至少要說明 run 數、均值、方差和選擇 checkpoint 的規則。
誤區三:把實現差異藏起來。 研究生常擔心寫出 patch 會顯得“不夠純”。恰恰相反,透明記錄 patch 是 report 可信的前提。
誤區四:把不可得工件寫成小問題。 數據、權重、prompt、judge、檢索索引、評測腳本缺任何一個,都可能改變結論。不要用“由於資源限制略過”一筆帶過。
誤區五:博客寫成論文摘要翻譯。 復現博客的價值不是告訴讀者論文說了什麼,而是告訴讀者你如何檢查這些說法,以及檢查後學到了什麼。
誤區六:用“論文錯了”製造衝突。 復現失敗可能來自環境、依賴、硬件、seed、metric、數據版本、baseline 實現或資源不足。除非證據非常充分,否則更嚴謹的表達是“在本復現範圍內未確認該 claim”。
適合研究生繼續做的選題
復現報告模板自動化:設計一個腳本,從 git commit、conda env、GPU 信息、運行命令和 metric 文件自動生成 report skeleton。
LLM 評測 trace 標準:針對 RAG 或 agent 論文,定義 prompt、retrieval snapshot、tool calls、judge config、raw output 的最小保存格式。
論文 claim 抽取工具:讓模型從論文 PDF 中抽取可測試 claim,並要求每條 claim 綁定表格、圖和實驗設定,再由人工核驗。
Benchmark parser audit:系統比較不同開源評測腳本對同一 raw output 的解析差異,評估分數漂移。
復現成本估計模型:基於論文工件完整度、模型規模、數據規模和依賴複雜度,預測一篇論文的復現成本。
負結果寫作規範:收集 MLRC、ACL、ICLR、NeurIPS 中的 reproduction / negative results 論文,分析高質量負結果如何組織證據。
總結
論文復現筆記的目標不是記錄“我做了什麼”,而是留下“別人如何判斷我的復現結論是否可信”的證據鏈。實驗日誌負責保留事實,reproduction report 負責組織證據,博客草稿負責把方法教給讀者。
如果你是研究生,建議從下一篇論文開始就使用固定模板:先寫 claim map,再做 artifact audit,然後維護 run logbook,最後給出 verdict 和 follow-up idea。這樣訓練一個月後,你得到的不只是 30 篇讀書筆記,而是一套可以長期複用的科研閱讀與復現實踐系統。
參考資料
檢索日期:2026-07-29。
- Koustuv Sinha 等,MLRC 2026 官方網站:https://reproml.org/
- NeurIPS Blog,MLRC 2026: Reproducibility as an Official Track at NeurIPS,2026-05-04:https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- Priyaranjan Pattnayak, Apoorv Bhatia,ReproEvalCard: A Reporting Standard for Reproducible Evaluation of LLM Pipelines,ACL 2026:https://aclanthology.org/2026.acl-short.22/
- Giulio Starace 等,PaperBench: Evaluating AI’s Ability to Replicate AI Research,OpenAI,2025-04-02:https://openai.com/index/paperbench/
- OpenAI frontier-evals GitHub repository:https://github.com/openai/frontier-evals
- ICLR 2025 Author Guide,Reproducibility section:https://iclr.cc/Conferences/2025/AuthorGuide
- NeurIPS 2025 Datasets & Benchmarks Track Call for Papers:https://neurips.cc/Conferences/2025/CallForDatasetsBenchmarks
- Papers with Code,Tips for Publishing Research Code:https://github.com/paperswithcode/releasing-research-code
- Joelle Pineau 等,Improving Reproducibility in Machine Learning Research: A Report from the NeurIPS 2019 Reproducibility Program,JMLR 2021:https://www.jmlr.org/papers/v22/20-303.html
- Chong Zhang 等,100 Days After DeepSeek-R1: A Survey on Replication Studies and More Directions for Reasoning Language Models,arXiv:2505.00551,2025:https://arxiv.org/abs/2505.00551
- National Academies of Sciences, Engineering, and Medicine,Reproducibility and Replicability in Science,2019:https://www.ncbi.nlm.nih.gov/books/NBK547531/
- ACL 2026 Main Conference Call for Papers:https://2026.aclweb.org/calls/main_conference_papers/
來源說明:本文引用的會議政策、項目頁、論文頁面和代碼倉庫均在 2026-07-29 檢索。會議時間、track 規則、OpenReview 狀態、代碼倉庫 commit、benchmark 結果和模型工件可能隨時間變化;正式發表前應再次核對。OpenReview 頁面如遇訪問挑戰或狀態變化,請以會議官網、ACL Anthology、arXiv、TMLR/JMLR 頁面和作者倉庫為準。