日期:2026-07-28
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
本篇目標:把“跑通論文代碼”升級為“審計論文主張”,學會用環境、數據、權重、隨機性和日誌構造一份可信的 LLM 復現報告。
摘要
復現一篇 LLM 論文,最容易犯的錯誤是從 pip install 和 bash run.sh 開始。真正的復現應該先問:論文到底聲稱了什麼?哪些結果是主結論,哪些只是展示?需要復現的是訓練、微調、推理、評測,還是完整 pipeline?如果資源不足,哪些 claim 可以用小規模實驗驗證,哪些只能做 implementation check 或 partial reproduction?
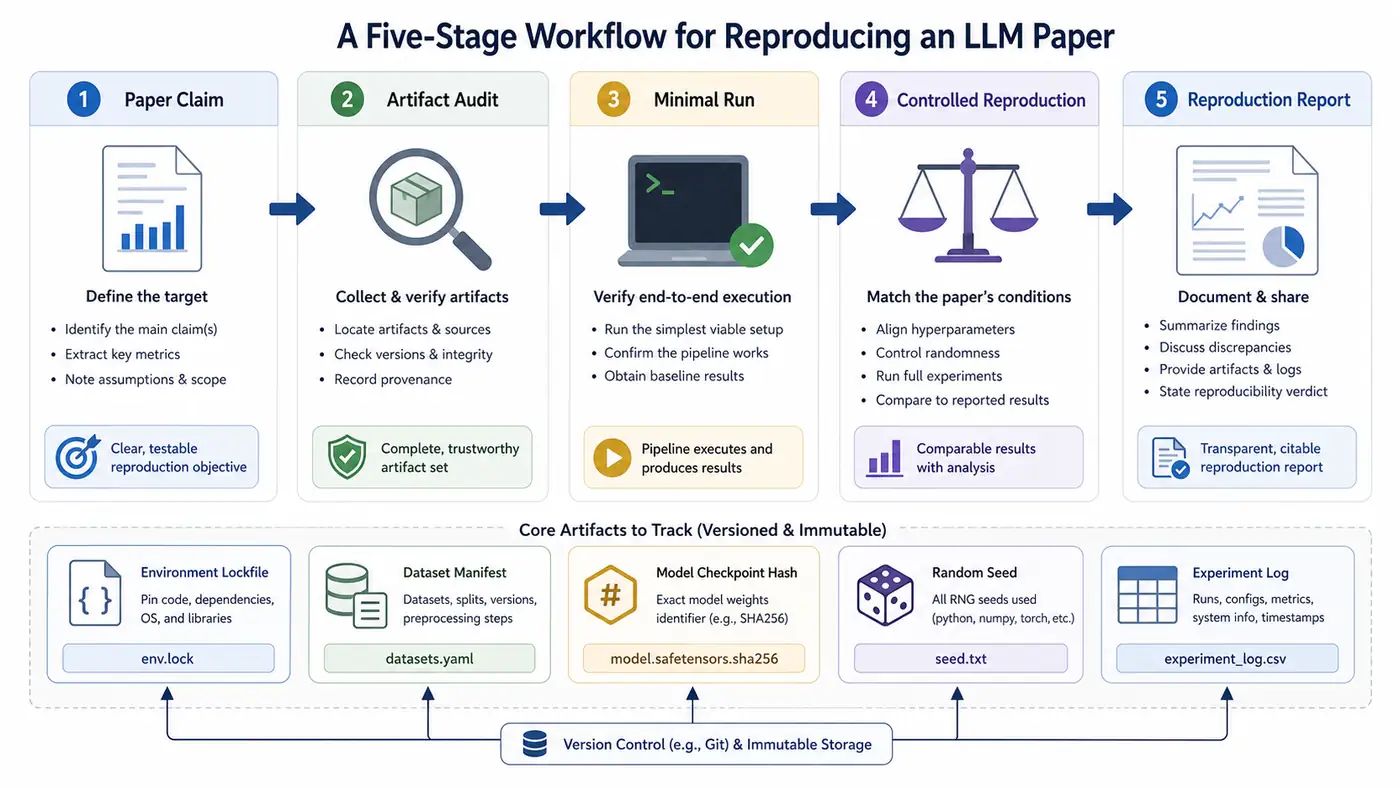
2025-2026 年,復現已經從“論文附錄裡的工程細節”變成獨立研究對象。MLRC 2026 成為 NeurIPS 官方 track,ReproEvalCard 針對 LLM pipeline 提出評測工件報告標準,PaperBench 把“從頭復現 AI 論文”做成 agent benchmark,PyTorch、vLLM、Hugging Face 等工具文檔也反覆提醒:相同 seed 不保證跨硬件、跨版本、跨 serving 調度完全一致。本篇給出一套適合研究生訓練的復現流程:先把論文 claim 拆小,再審計 artifacts,然後跑 minimal run,最後做 controlled reproduction 和 reproduction report。
目錄
- 為什麼 LLM 論文復現比傳統深度學習更難
- 復現前先定義目標:claim、範圍和成功標準
- Artifact audit:環境、數據、權重、seed、日誌
- 五階段復現工作流
- 代表論文與工件路線圖
- 方法與實驗對比表
- 可操作檢查清單
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼 LLM 論文復現比傳統深度學習更難
傳統模型論文的復現,常常可以抽象成三件事:拿到代碼、拿到數據、按超參數重新訓練或評測。LLM 論文當然也需要這些,但難點更多。
第一,模型工件層級變多。一個“模型”可能包括 tokenizer、base checkpoint、SFT checkpoint、DPO / RLHF adapter、system prompt、chat template、generation config、retriever、reranker、tool schema、judge prompt 和後處理腳本。論文表格中的一個分數,可能不是單個 checkpoint 的屬性,而是一整套 pipeline 的輸出。
第二,計算預算差異巨大。許多預訓練論文無法被普通實驗室完整復現。可復現訓練不等於重訓千億參數模型,而是要明確選擇復現層級:復現模型加載與評測、復現小規模訓練曲線、復現關鍵 ablation、復現數據處理、復現推理行為,還是復現完整訓練 recipe。研究訓練的重點是讓 claim 可審計,而不是盲目追求同等 GPU 規模。
第三,隨機性和數值細節被放大。PyTorch 官方文檔明確說明,完全可復現結果不保證跨 PyTorch release、commit、平臺、CPU/GPU;vLLM 文檔也說明默認為了性能並不保證結果可復現,在線 serving 調度尤其難做到完全確定。2025 年關於 reasoning reproducibility 的研究進一步指出,batch size、GPU 數量、GPU 型號和精度設置都可能讓推理輸出分歧,尤其在長鏈式推理中,早期 token 的微小差異會級聯到最終答案。
第四,評測本身越來越像系統工程。ReproEvalCard 在 ACL 2026 中強調,LLM pipeline 的復現不僅需要模型權重和數據,還需要 prompt、judge 配置、檢索快照和中間執行 trace。對 agent、RAG、tool-use、reasoning model 來說,沒有 trace 的評測結果只能部分複核,很難完整復現。
因此,復現 LLM 論文不是“我能不能跑出同一個數字”,而是“我能不能說明這個數字在什麼條件下成立,以及我的復現證據支持或削弱了論文的哪些主張”。
復現前先定義目標:claim、範圍和成功標準
開始寫代碼前,先把論文主張改寫成可測試對象。建議使用下面這個句式:
在數據集 D、split S、metric M、模型/權重 W、推理或訓練預算 B、環境 E、隨機性控制 R 下,論文聲稱方法 A 相對 baseline C 產生差異 X,並用這個差異支持機制假設 H。
如果你填不完整,說明覆現目標還不清楚。不要急著搭環境,先回到論文的 method、experiment、appendix、repo issue 和 model card。
復現範圍通常分為五級:
| 級別 | 目標 | 適合資源 | 成功標準 |
|---|---|---|---|
| L0 sanity check | 確認代碼、模型和數據能加載 | 單卡或 CPU | 能執行最小樣例,無 shape / dtype / tokenizer 錯誤 |
| L1 evaluation reproduction | 復現論文某個評測表格 | 單卡到多卡 | 同一 checkpoint、同一數據和 metric 下結果接近 |
| L2 component reproduction | 復現關鍵模塊或 ablation | 單卡到小集群 | 模塊開關產生與論文一致的方向性差異 |
| L3 scaled-down training | 小規模復現訓練趨勢 | 小集群 | loss 曲線、驗證趨勢和失敗模式可解釋 |
| L4 full recipe reproduction | 儘量復現完整訓練或系統 | 大集群 | 結果、成本、日誌和模型工件可審計 |
研究生訓練一般從 L1-L3 開始。L4 很有價值,但不應成為唯一目標。許多好復現報告的貢獻恰恰在於:在可承受資源下,拆出論文最關鍵的假設,並說明它在什麼設定下成立、變弱或失敗。
Artifact Audit:環境、數據、權重、Seed、日誌
1. 環境不是 requirements.txt,而是可執行邊界
最低限度要記錄:
- 操作系統、CUDA / ROCm、驅動版本、GPU 型號和顯存;
- Python、PyTorch、Transformers、Datasets、Accelerate、vLLM、PEFT、bitsandbytes、flash-attn 等關鍵依賴版本;
- 編譯相關變量,例如
TORCH_CUDA_ARCH_LIST、NCCL、cuDNN、編譯器版本; - 是否使用 Docker、Conda、uv、pip-tools、Poetry 或 Nix;
- 運行入口命令、環境變量、配置文件和提交哈希。
不要只保存 requirements.txt。它可能沒有鎖住 transitive dependencies,也不能說明系統庫、驅動和硬件。復現報告至少應包含 env.lock、run_command.sh、hardware.md 和 git_commit.txt。如果論文倉庫沒有 lockfile,你可以自己生成一個,但要註明“復現者生成,非作者提供”。
2. 數據要從“名字”變成 manifest
LLM 論文裡寫 “we use GSM8K” 或 “we evaluate on MMLU” 遠遠不夠。你需要記錄:
- 數據集來源 URL、版本、revision、下載時間;
- train / validation / test split;
- preprocessing、filtering、dedup、packing、shuffle 規則;
- prompt template 和 few-shot examples;
- 是否使用 streaming、cache、私有數據或人工標註;
- 數據 license 和訪問限制;
- 文件校驗和或樣本計數。
Hugging Face Datasets 官方文檔支持用 revision 指定 Hub 數據集版本,這是復現中很容易被忽視的細節。只寫 dataset name,相當於把未來的版本漂移留給讀者。
3. 權重必須可定位到不可變標識
記錄模型名不夠。至少需要:
- Hugging Face repo / ModelScope repo / GitHub release / DOI;
- checkpoint revision、commit hash 或 release tag;
- tokenizer revision;
config.json、generation config、chat template;- 是否使用 safetensors;
- adapter 與 base model 的對應關係;
- 量化格式和參數,例如 GPTQ、AWQ、bitsandbytes 4-bit/8-bit、GGUF;
- 權重 license 和 gated access 狀態。
Transformers 文檔提醒,from_pretrained() 會優先加載 safetensors,加載 custom model 時若用 trust_remote_code=True,最好綁定具體 revision。PEFT 文檔也說明 adapter checkpoint 通常只包含 adapter 權重和配置,不包含 base model。復現報告必須把 base 和 adapter 的配對關係寫清楚,否則幾個月後很難重建同一個模型。
4. Seed 不是魔法按鈕
常見 seed 記錄包括 random、numpy、torch、torch.cuda、DataLoader worker、dataset shuffle、generation sampling seed、vLLM seed、distributed sampler seed。Accelerate 文檔建議用 set_seed() 統一設置分佈式訓練中的隨機源;PyTorch 文檔同時提醒,即使設置隨機種子,跨 release、平臺和設備也不能保證完全一致。
因此,復現報告要區分三種結論:
- deterministic within setup:同一機器、同一依賴、同一命令可重複;
- statistically stable:多 seed 下均值和方差支持同一方向;
- cross-system reproducible:換硬件或框架仍基本一致。
很多 LLM 論文只能達到前兩種。不要把它們誤寫成第三種。
5. 日誌是復現報告的證據鏈
建議記錄四類日誌:
- config log:完整配置、命令行參數、環境變量;
- data log:樣本數、過濾數、shuffle seed、數據 hash;
- runtime log:loss、learning rate、grad norm、throughput、GPU memory、checkpoint step;
- evaluation log:原始輸出、解析結果、metric、失敗樣本、judge prompt、judge model、統計腳本。
如果做 LLM 評測,保存 raw generations 比保存最終分數更重要。沒有原始輸出,你無法區分模型不會、prompt 錯、解析器錯、metric 錯,還是 judge 偏。
五階段復現工作流
階段一:Paper Claim
只選一個主 claim。不要一上來復現整篇論文。先定位論文中最能支撐貢獻的表格、圖或 ablation,並寫下:
- 我復現的是哪個 claim?
- 需要哪些工件?
- 成功閾值是什麼?
- 哪些差異可以接受,哪些會推翻 claim?
- 資源預算是多少?
對於大模型論文,一個合理目標可能是“復現某個 open-weight checkpoint 在指定 benchmark 上的評測”,而不是“重訓完整模型”。
階段二:Artifact Audit
建立 artifacts/ 表:
| 類別 | 需要記錄 | 缺失時處理 |
|---|---|---|
| 代碼 | repo、commit、branch、patch | fork 並記錄 diff |
| 環境 | lockfile、Dockerfile、GPU、CUDA | 用復現者環境替代並標註 |
| 數據 | URL、revision、split、hash、preprocess | 無法取得則降級為 partial reproduction |
| 權重 | checkpoint、tokenizer、adapter、quantization | 綁定 commit 或寫待人工核驗 |
| 評測 | prompt、metric、parser、judge、raw output | 先復現 scorer,再跑模型 |
| 日誌 | train/eval logs、config、seed | 自建日誌模板 |
這一步的產物不是論文摘要,而是一張“復現可行性地圖”。如果關鍵數據或權重不可得,儘早調整目標。
階段三:Minimal Run
先跑最小閉環,不要直接跑完整實驗:
- 加載 tokenizer 和模型;
- 取 3-10 條樣本;
- 運行同一個 prompt;
- 保存 raw outputs;
- 跑 scorer;
- 生成一個最小 metrics 文件。
Minimal run 的目的不是追分,而是暴露 pipeline 錯誤。常見問題包括 tokenizer 不匹配、chat template 變更、EOS 處理錯誤、max tokens 截斷、bf16/fp16 dtype 不一致、metric parser 對格式過度敏感、dataset split 加載錯、few-shot 樣例順序錯。
階段四:Controlled Reproduction
最小閉環通過後,才進入受控復現。推薦順序是:
- 固定模型、數據、prompt、metric,只改變 seed,估計方差;
- 固定 seed,比較 batch size、GPU 數、dtype、serving backend;
- 固定推理預算,比較 baseline 與方法;
- 復現論文主表中的一個小子集;
- 再擴展到完整表格或關鍵 ablation。
對於推理論文,特別要記錄 decoding 參數:temperature、top_p、top_k、max_new_tokens、stop tokens、repetition penalty、num_return_sequences、beam search、best-of、self-consistency samples。對於訓練或微調論文,要記錄 effective batch size、gradient accumulation、learning rate schedule、warmup、weight decay、optimizer、LoRA rank、target modules、packing、sequence length、checkpoint selection 規則。
階段五:Reproduction Report
復現報告建議分成四段:
- 目標:復現哪個 claim,為什麼選擇它;
- 工件:哪些來自作者,哪些由復現者補充,哪些不可得;
- 結果:主結果、方差、失敗樣本、與論文差異;
- 解釋:確認、部分確認、未能復現或無法判斷,並說明原因。
好的復現報告不必把所有數字做成“論文同款表格”。它應該讓讀者知道:如果要繼續研究這篇論文,哪些部分可信,哪些部分脆弱,哪些地方可能孕育 follow-up idea。
代表論文與工件路線圖
經典復現框架:從 checklist 到 reproducibility science
JMLR 2021 的 NeurIPS 2019 reproducibility program 報告把 code policy、reproducibility challenge 和 checklist 聯繫起來,說明覆現不是單點工程任務,而是會議制度、作者規範和社區挑戰共同推動的結果。2026 年 MLRC 成為 NeurIPS 官方 track,進一步確認復現、復現失敗、泛化測試、元復現研究都可以成為正式科研貢獻。
LLM pipeline:ReproEvalCard
ReproEvalCard 針對 2022-2025 年 pipeline-based LLM 論文做審計,強調 prompt、judge 配置、retrieval snapshot 和 intermediate traces 的必要性。它對研究生最重要的啟發是:復現 LLM 系統時,不要只盯模型權重。一個 RAG 或 agent 論文的評測結果,可能主要由檢索庫版本、工具返回、judge prompt 和軌跡解析決定。
論文復現 benchmark:PaperBench
OpenAI 在 2025 年發佈 PaperBench,把 AI 論文復現拆成 rubric-based grading。官方頁面說明任務要求 agent 理解論文貢獻、構建代碼庫並執行實驗;GitHub README 進一步把運行分成 agent rollout、reproduction 和 grading 三階段。這裡可以借鑑的不是分數,而是“把復現任務拆成可評分子任務”的思想。研究生寫復現計劃時,也應把大目標拆成 artifact、implementation、experiment、analysis 四類 checklist。
開源模型報告:OLMo 2、Qwen3、DeepSeek-V3
OLMo 2 在 OpenReview 頁面中強調 fully open artifacts:weights、training data、training code、recipes、logs 和 intermediate checkpoints。Ai2 / OLMo repo 還給出訓練配置、W&B 鏈接和不同階段 checkpoint。這類論文適合做高質量復現訓練,因為它暴露了足夠多的工件。
Qwen3 GitHub / technical report 提供模型系列、文檔、Hugging Face / ModelScope 鏈接、推理、部署、量化和訓練指引。DeepSeek-V3 repo 公開模型下載、運行方式、權重說明和技術報告引用,但完整預訓練數據並非完全可復刻。讀這類技術報告時,要區分“open weights evaluation reproduction”和“full training reproduction”。
數值與推理復現:2025 reasoning reproducibility
“Give Me FP32 or Give Me Death?” 和 “A Sober Look at Progress in Language Model Reasoning” 都提醒我們:reasoning benchmark 的分數可能受精度、硬件、prompt、seed、解碼參數和軟件框架影響。對研究生來說,這類論文適合訓練“負結果解釋”:當復現數字不一致時,不要馬上歸因於論文錯誤,先系統掃描數值和評測 pipeline。
方法與實驗對比表
| 復現對象 | 最容易缺的工件 | 最小可行復現 | 關鍵風險 | 建議日誌 |
|---|---|---|---|---|
| 開源模型評測 | checkpoint revision、chat template、scorer | 固定權重跑 100-500 條樣本 | 數據版本、解析器、decoding | raw output、metric json、config |
| LoRA / QLoRA 微調 | base-adapter 對應、數據處理 | 小數據跑通訓練並比較方向 | target modules、packing、seed | train loss、eval loss、adapter hash |
| RAG / Agent 論文 | 檢索快照、工具返回、trace | 復現 20-50 個樣本的完整軌跡 | 動態網頁、API 版本、judge 偏 | retrieval docs、tool traces、judge outputs |
| Reasoning 論文 | prompt、採樣數、精度、硬件 | 固定 prompt 跑多 seed | batch / dtype / GPU 引起分歧 | per-sample answer、token length、seed |
| 預訓練技術報告 | 數據混合、完整 compute、訓練日誌 | 小模型復現趨勢或 ablation | 資源不可比、數據不可得 | loss curve、throughput、checkpoint |
| Benchmark 論文 | hidden split、scoring code、汙染檢測 | 復現 scorer 和一組 baseline | leakage、選擇性報告 | scorer version、failure cases |
可操作檢查清單
開始前
- 是否只選擇了一個主 claim?
- 是否寫清了復現級別 L0-L4?
- 是否確認代碼、數據、權重 license 允許研究使用?
- 是否估算了 GPU、時間、存儲和 API 成本?
- 是否定義了成功閾值和失敗解釋標準?
環境
- 是否記錄 OS、GPU、driver、CUDA / ROCm?
- 是否鎖定 Python 和關鍵依賴版本?
- 是否保存 repo commit、patch、運行命令?
- 是否記錄
trust_remote_code、custom kernels、flash attention、serving backend? - 是否能在乾淨環境重跑 minimal run?
數據
- 是否固定 dataset revision 或文件 hash?
- 是否記錄 split、樣本數、過濾規則?
- 是否保存 prompt template 和 few-shot examples?
- 是否檢查測試集洩漏或近重複風險?
- 是否保留處理後的中間文件 manifest?
權重
- 是否固定 base model、tokenizer、adapter、quantization revision?
- 是否保存 model config 和 generation config?
- 是否記錄 checkpoint selection 規則?
- 是否區分 open weights、open data、open training code 和 fully open?
- 是否確認本地實際加載的是預期權重?
隨機性與評測
- 是否設置 Python、NumPy、PyTorch、CUDA、DataLoader、generation seed?
- 是否報告多 seed 方差,而不是隻報最好一次?
- 是否記錄 decoding 參數和 serving 調度?
- 是否保存 raw outputs、parser outputs 和 final metrics?
- 是否能解釋與論文數字的差異來源?
常見誤區
誤區一:跑通作者倉庫就等於復現。 跑通只是 L0。復現至少要把論文 claim、輸入工件、結果和差異解釋連起來。
誤區二:數字不一致就說明論文錯。 先檢查數據版本、權重 revision、prompt、dtype、batch size、GPU、依賴和 scorer。LLM 評測的脆弱性可能來自 pipeline,而不一定來自方法。
誤區三:只保存最終分數。 最終分數最不夠用。raw outputs、trace、config 和日誌才是分析失敗樣本的證據。
誤區四:把 seed 當作充分控制。 seed 只能控制一部分隨機源。跨硬件、跨框架、跨 serving backend 的差異需要單獨實驗。
誤區五:復現目標太大。 如果論文是千億模型預訓練,不要從完整重訓開始。先復現評測、數據處理、小模型趨勢或關鍵 ablation。
適合研究生繼續做的選題
- LLM evaluation artifact audit:選 30 篇 RAG / Agent / Reasoning 論文,統計 prompt、judge config、retrieval snapshot、trace、seed 和 raw outputs 的公開情況。
- Hardware-sensitive reasoning reproduction:固定模型和數據,系統比較 GPU 型號、batch size、dtype、serving backend 對 reasoning benchmark 的影響。
- Model card to reproduction checklist:把開源模型技術報告中的 model card、repo、docs 轉成自動化復現清單,評估信息缺口。
- Minimal reproduction templates:為 LoRA、RAG、agent、reasoning eval 分別構建最小復現模板,要求自動產出 env/data/model/log manifest。
- Reproduction report rubric:參考 PaperBench,把一篇論文復現報告拆成可評分 rubric,用於課程作業或實驗室 reading group。
- Negative reproduction taxonomy:整理復現失敗案例,區分環境失敗、數據失敗、實現失敗、數值失敗、統計失敗和 claim failure。
總結
復現 LLM 論文的核心不是“把代碼跑起來”,而是把論文主張變成可審計證據。你要固定環境,凍結數據版本,定位權重和 tokenizer,控制隨機性,保存 raw outputs 和日誌,再把結果寫成 reproduction report。
對於科研新人,最有訓練價值的動作是:小範圍、強控制、完整記錄。不要一開始就追求復現整篇大模型技術報告。先選一個 claim,跑一個 minimal run,建立 artifact manifest,再逐步擴展到關鍵 ablation 或完整評測。長期堅持下來,你會形成一種比“讀懂論文”更紮實的能力:判斷一篇論文的證據鏈在哪裡堅固,在哪裡脆弱,以及哪裡可以發展成自己的研究問題。
參考資料
檢索日期:2026-07-28。以下優先列出官方頁面、會議頁面、論文頁、項目倉庫和工具文檔;模型、榜單、依賴版本和倉庫狀態可能變化,正式發佈前建議重新核驗。
- NeurIPS Blog, “MLRC 2026: Reproducibility as an Official Track at NeurIPS”, 2026-05-04. https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- ML Reproducibility Challenge official site, MLRC 2026. https://reproml.org/
- NeurIPS 2026 Main Track Handbook, Paper Checklist and Data Guidelines. https://neurips.cc/Conferences/2026/MainTrackHandbook
- ICLR 2026 Reviewer Guide, reproducibility and evidence assessment guidance. https://iclr.cc/Conferences/2026/ReviewerGuide
- Priyaranjan Pattnayak and Apoorv Bhatia, “ReproEvalCard: A Reporting Standard for Reproducible Evaluation of LLM Pipelines”, ACL 2026. https://aclanthology.org/2026.acl-short.22/
- Joelle Pineau et al., “Improving Reproducibility in Machine Learning Research”, JMLR 2021. https://www.jmlr.org/papers/v22/20-303.html
- OpenAI, “PaperBench: Evaluating AI’s Ability to Replicate AI Research”, 2025-04-02. https://openai.com/index/paperbench/
- OpenAI PaperBench GitHub README. https://github.com/openai/preparedness/blob/main/project/paperbench/README.md
- PyTorch Documentation, “Reproducibility”, last updated 2025-10-03. https://docs.pytorch.org/docs/stable/notes/randomness
- vLLM Documentation, “Reproducibility”. https://docs.vllm.ai/en/v0.9.1/usage/reproducibility.html
- Hugging Face Datasets Documentation, “Load”. https://huggingface.co/docs/datasets/loading
- Hugging Face Transformers Documentation, “Loading models”. https://huggingface.co/docs/transformers/models
- Hugging Face Transformers Documentation, “Parameter-efficient fine-tuning”. https://huggingface.co/docs/transformers/peft
- Evan Pete Walsh et al., “2 OLMo 2 Furious (COLM’s Version)”, OpenReview / COLM 2025. https://openreview.net/forum?id=2ezugTT9kU
- Ai2, “OLMo 2 32B: First fully open model to outperform GPT 3.5 and GPT 4o mini”, 2025. https://allenai.org/blog/olmo2-32b
- AllenAI OLMo GitHub repository. https://github.com/allenai/olmo
- QwenLM Qwen3 GitHub repository and technical report links. https://github.com/QwenLM/Qwen3
- DeepSeek-AI DeepSeek-V3 GitHub repository. https://github.com/deepseek-ai/DeepSeek-V3
- DeepSeek-AI, “DeepSeek-V3 Technical Report”, arXiv:2412.19437. https://arxiv.org/abs/2412.19437
- Jiayi Yuan et al., “Give Me FP32 or Give Me Death? Challenges and Solutions for Reproducible Reasoning”, arXiv:2506.09501. https://arxiv.org/abs/2506.09501
- Andreas Hochlehnert et al., “A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility”, arXiv:2504.07086. https://arxiv.org/abs/2504.07086