日期:2026-07-27
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
本篇目標:學會把論文裡的 benchmark 結果從“排行榜數字”拆成可審計證據,判斷它是否真的支持論文主張。
摘要
AI 論文裡的 benchmark 很容易給人一種確定感:一個表格、幾個粗體數字、一句 “outperforms previous methods”,似乎就能說明方法有效。但對科研訓練來說,benchmark 不是結論本身,而是一套有前提的測量系統。數據是否洩漏,測試集是否已經進入預訓練語料,baseline 是否調參充分,metric 是否對應真實能力,負結果是否被隱藏,代碼和日誌是否足以復現,都會改變我們對結果的解釋。
本篇不把重點放在“哪個榜單最權威”,而是訓練一種讀論文的動作:當你看到實驗表格時,先問它測的是什麼、沒有測什麼、誰可能被這個測量方式偏愛,以及如果自己復現,最先會在哪一步失敗。2025-2026 年的評測研究已經把這個問題推到臺前:LiveBench、LiveCodeBench、AntiLeakBench、Kernel Divergence Score、benchmark watermarking、Preference Leakage、PaperBench、REPRO-Bench 以及 NeurIPS 2026 E&D / MLRC 對透明性和復現的強調,都說明 benchmark 本身已經成為研究對象。
目錄
- 為什麼 benchmark 陷阱值得單獨訓練
- 三類核心陷阱:洩漏、報告、復現
- 代表論文與評測路線圖
- 精讀 benchmark 論文的審計流程
- 方法與實驗對比表
- 復現建議與日誌模板
- 常見誤區
- 可繼續做的研究生選題
- 總結
- 參考資料
為什麼這個主題重要
Benchmark 的原始功能是讓方法比較變得可重複:同一數據集、同一 metric、同一 split、同一約束下,方法 A 和方法 B 的差距才有解釋意義。但大模型時代改變了這個前提。
第一,訓練數據邊界變模糊。閉源模型通常不公開完整預訓練語料,開源模型也可能只公開高層數據混合比例。一個公開多年的測試集可能已經在網頁、代碼倉庫、數據鏡像、教學材料、榜單提交記錄中反覆傳播。即使論文作者沒有主動作弊,模型也可能在預訓練或指令微調階段間接見過測試樣本。
第二,評測對象變複雜。過去一個分類模型輸出一個標籤,現在 LLM 會生成自由文本、調用工具、寫代碼、搜索網頁、運行實驗。metric 可能來自規則、人工、另一個 LLM judge,或者一套執行環境。每增加一個環節,就多一個偏差來源:提示詞、採樣參數、解析器、judge 模型、超時設置、依賴版本、隱藏測試、緩存策略。
第三,排行榜激勵會放大選擇性報告。論文不一定展示所有試過的 benchmark、所有 prompt、所有 seed、所有失敗 baseline。讀者看到的是壓縮後的證據,而不是完整實驗軌跡。科研新人如果只看粗體數字,很容易把“在某個設定下更高”誤讀成“方法機制更強”。
因此,識別 benchmark 陷阱不是懷疑一切,而是把論文結果恢復成可檢查的科學聲明:在什麼數據、什麼協議、什麼成本、什麼隨機性、什麼對照下,某個方法表現出什麼差異。
三類核心陷阱:洩漏、報告、復現
1. 數據洩漏:測試集不再是“未見數據”
數據洩漏至少有四種層級。
樣本級洩漏:測試樣本原文或近重複樣本進入訓練集。典型風險來自公開 benchmark、網頁鏡像、GitHub 數據集倉庫、榜單討論帖、論文附錄和教學材料。
答案級洩漏:模型未必見過題目原文,但見過題解、標準答案、解析或相關討論。數學、代碼和問答 benchmark 都容易出現這種情況。
模板級洩漏:模型沒有記住具體題目,卻學會了 benchmark 的構造模板。多項選擇題、指令遵循任務、合成推理題特別需要檢查這一層。
反饋級洩漏:在 LLM-as-a-judge、偏好優化和合成數據循環中,訓練模型、數據生成器和評審模型來自同一模型家族或繼承鏈,評測可能偏向某些輸出風格。Preference Leakage 把這種關係定義為 judge 與 generator / student 的相關性問題,而不是傳統意義上的 train-test overlap。
讀論文時,先找三類證據:數據發佈時間是否晚於模型訓練截止時間;作者是否檢查了近重複和答案洩漏;benchmark 是否有 live 更新、私有測試或可驗證自動評分機制。如果這些證據缺失,不要立刻否定論文,但要把結論從“能力提升”降級為“在該公開測試協議上分數提升”。
2. 選擇性報告:表格展示了什麼,也隱藏了什麼
選擇性報告不一定是造假,更多時候是研究過程中的篩選偏差。論文篇幅有限,作者傾向於展示最能支持主張的設置。讀者要主動追問:
- 是否只報告了平均分,而沒有任務子類、難度分層和方差?
- 是否只比較了弱 baseline,避開了最新或更強但不方便復現的 baseline?
- 是否只展示最佳 prompt 或最佳 seed,而沒有說明搜索空間?
- 是否在多個 benchmark 中只突出有利結果,把不利結果放到附錄或完全省略?
- 是否使用了不同推理預算、工具權限、上下文長度、檢索庫或外部資源,卻在同一表格中橫向比較?
一個常見陷阱是“粗體數字敘事”:表格中某列高 0.5 到 1 個百分點,正文就把它解釋成機制突破。但如果沒有置信區間、重複運行、顯著性檢驗、成本約束和失敗案例,這個差距可能只是噪聲、prompt 搜索、採樣隨機性或 baseline 調參不足。
3. 不可復現:結果可能真實,但證據鏈不完整
不可復現不等於結果錯誤。很多 LLM 實驗確實依賴昂貴 API、非公開權重、動態網頁、隨時間變化的數據源和不可固定的服務端模型版本。但論文必須說明哪些部分可復現、哪些只能複核、哪些需要待人工核驗。
NeurIPS 2026 Evaluations & Datasets reviewing guidelines 明確把 responsible data practices、transparency 和 reproducibility 放在 E&D 軌道的核心位置;MLRC 2026 也把復現、部分復現失敗、泛化研究和元復現研究納入正式貢獻類型。這意味著“我復現不了”不再只是工程抱怨,而是可以被系統化研究的問題。
對讀者來說,最低限度的復現證據包括:數據下載與版本、預處理腳本、模型 checkpoint 或 API 版本、prompt、採樣參數、seed、硬件與依賴環境、原始輸出、打分腳本、統計彙總腳本、失敗樣本、運行日誌。如果缺少這些材料,你仍然可以讀方法,但不要把實驗表格當成穩固事實。
代表論文與評測路線圖
經典基礎:先理解汙染與評測協議
早期 NLP 與機器學習已經長期討論 train-test contamination、dataset bias、leaderboard overfitting 和 reproducibility crisis。大模型時代的新問題不是“洩漏第一次出現”,而是洩漏更難觀察、影響更大、傳播更快。公開 benchmark 一旦被模型訓練管線吸收,後來者幾乎無法知道模型是否見過樣本。
2024:live benchmark 和可驗證評分成為主線
LiveCodeBench 提出面向代碼能力的 contamination-free evaluation,通過持續收集 LeetCode、AtCoder、Codeforces 等競賽平臺的新題,減少老 benchmark 被預訓練汙染的風險,並把評測範圍從代碼生成擴展到 self-repair、code execution、test output prediction 等能力。
LiveBench 則把 live 更新與 objective ground-truth scoring 結合起來。它的官方站點在 2026-07-27 檢索時顯示最新 release 為 2026-06-25,覆蓋 23 個 objective tasks 和 7 個類別。這裡的訓練意義是:一個好 benchmark 不只是題目難,還要說明題目如何更新、如何評分、如何降低 judge bias。
2025:汙染檢測與抗洩漏構造方法細化
AntiLeakBench 關注“新收集數據也可能包含舊知識”的問題,提出用 explicitly new knowledge 構造自動更新的 anti-leakage benchmark。Kernel Divergence Score 從模型在 fine-tuning 前後樣本表示變化的角度檢測 dataset leakage。Benchmark watermarking 則嘗試在 benchmark 發佈前植入可統計檢測的“radioactivity”,用於判斷訓練過程是否吸收了測試集。
這些工作共同說明:僅僅把測試題改寫、打亂選項或換成新問法,不一定能消除汙染。ICML 2025 的 “The Emperor’s New Clothes in Benchmarking?” 系統評估了多種 benchmark data contamination mitigation 策略,指出很多語義保持改寫難以提高抗汙染性,而語義改變又會犧牲原 benchmark 的保真度。讀論文時要特別警惕“我們 paraphrase 了測試集,所以無汙染”這種過強表述。
2025-2026:復現能力本身成為 benchmark
PaperBench 要求 AI agent 從頭復現 ICML 2024 Spotlight / Oral 論文,並把任務拆成可評分 rubrics。REPRO-Bench 則面向社會科學論文復現包,讓 agent 判斷論文與 reproduction package 的一致性。它們都把“能不能復現研究”從論文附屬材料提升為評測對象。
這對研究生很有啟發:復現不是跑通倉庫,而是驗證論文聲明和證據鏈是否一致。你復現失敗時,也要區分是環境問題、數據問題、實現問題、隨機性問題、計算預算問題,還是論文主張本身不穩。
精讀 benchmark 論文的審計流程
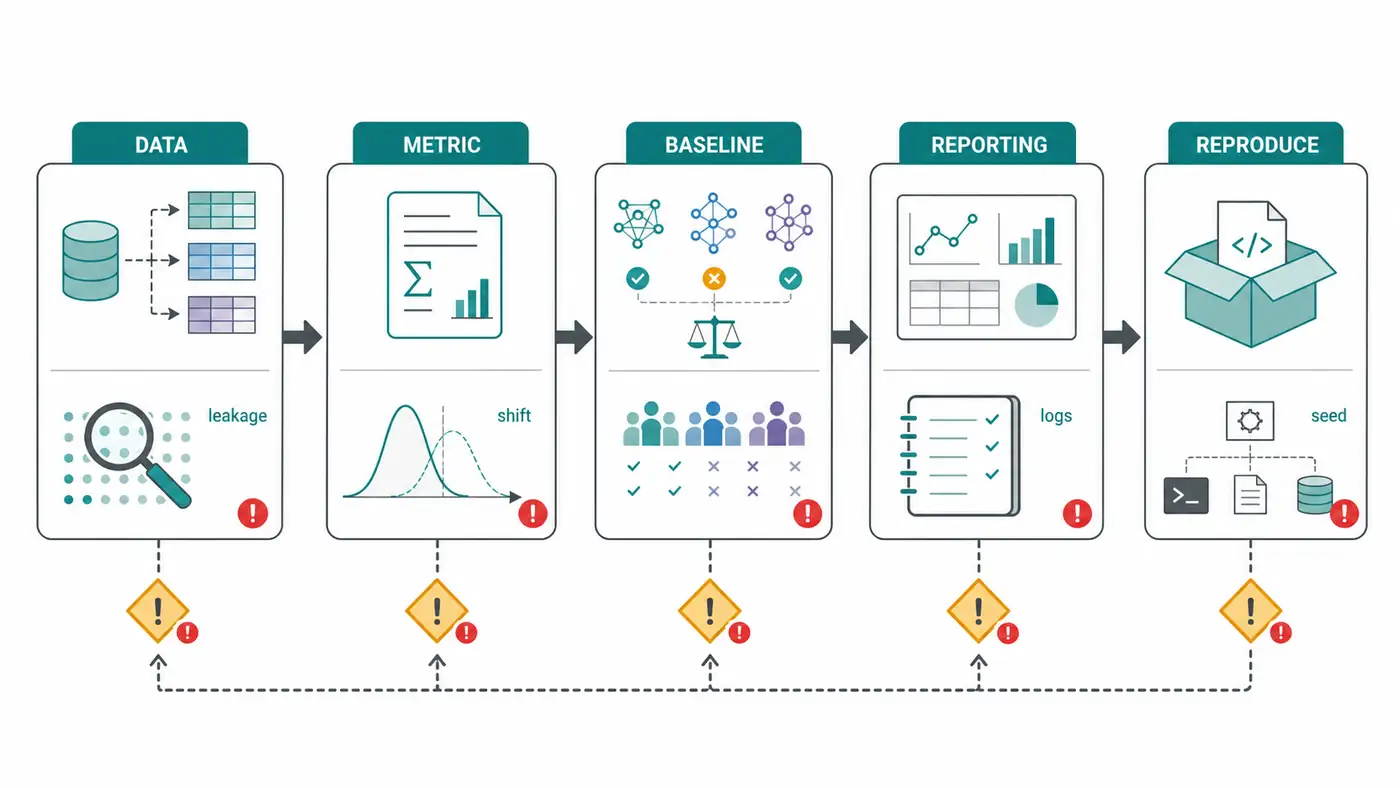
第一步:把 claim 改寫成可測試語句
不要停在“我們的方法更好”。把它改寫成:
在 dataset D 的 split S 上,在 metric M 下,在推理預算 B、模型規模 P、訓練數據 T、prompt 方案 R、隨機種子集合 Z 中,方法 A 相對 baseline C 提升了 X,並且該提升支持機制假設 H。
如果論文不能填完這句話,說明結果解釋邊界不清。
第二步:檢查數據邊界
數據審計至少包含:
- 數據集發佈時間、版本號、license、下載地址;
- train / validation / test split 是否固定;
- 是否存在 near-duplicate、答案洩漏或模板洩漏;
- 是否可能被目標模型預訓練、SFT、RLHF、tool logs 或 benchmark tuning 接觸;
- 是否有私有測試、live 更新、canary、watermark 或 held-out audit set;
- 是否公開了去重腳本或汙染檢測腳本。
如果作者只寫“we follow the standard benchmark setting”,這不是充分說明。標準設置可能已經過期。
第三步:檢查 metric 是否測到了 claim
一個 benchmark 可能測的是格式服從,而不是推理;測的是檢索命中,而不是知識綜合;測的是 judge 偏好,而不是事實正確;測的是 pass@1,而不是調試能力。讀 metric 時要問:
- 輸出空間是什麼:選擇題、短答案、自由文本、代碼、工具軌跡?
- scorer 是規則、執行器、人類、LLM judge,還是混合?
- scorer 是否公開、穩定、可離線運行?
- metric 是否對長度、風格、拒答、格式錯誤、部分正確有偏置?
- 是否報告了成本、延遲、token、工具調用次數等約束指標?
第四步:檢查 baseline 是否公平
Baseline 不是表格裡的陪跑。它決定論文的證據強度。優先看這些細節:
- baseline 是否使用同等模型規模、數據、訓練步數、上下文長度和推理預算;
- baseline 是否使用官方實現或作者重跑;
- baseline 是否被重新調參;
- 新方法是否獲得了額外工具、檢索庫、外部 API 或更長 chain-of-thought;
- 是否存在“新方法 full setting 對舊方法 cheap setting”的比較。
如果 baseline 是過時版本,或者沒有說明調參預算,論文的新意可能被誇大。
第五步:檢查報告完整性
可靠論文會讓讀者看到結構化證據,而不只是最高分。建議檢查:
- 主表之外是否有 per-task、per-category、difficulty bucket;
- 是否報告平均值、標準差或置信區間;
- 是否說明 prompt 搜索、超參搜索和 checkpoint selection;
- 是否展示失敗案例和負結果;
- 是否把 ablation 對應到機制假設;
- 是否公開原始預測、打分日誌、錯誤樣本和統計腳本。
第六步:檢查復現路徑
你可以用“24 小時復現預案”測試論文透明度:如果今天開始復現,能否在一天內完成最小子集?
最小子集不要求全量訓練。它可以是 100 個樣本、一個模型、一個 seed、一個 benchmark 子任務。但它必須覆蓋完整鏈路:數據加載、推理、打分、彙總、生成表格。如果連這個路徑都搭不起來,論文的復現材料就不夠成熟。
方法與實驗對比表
| 代表工作 / 規範 | 年份 | 主要解決的問題 | 對讀論文的啟發 | 復現時優先檢查 |
|---|---|---|---|---|
| LiveCodeBench | 2024 | 代碼 benchmark 汙染和能力覆蓋不足 | 新題、時間窗口和任務多樣性比單一 pass@1 更重要 | 題目時間窗口、autograder 版本、執行環境 |
| LiveBench | 2025,站點 2026-06-25 release | 通用 LLM benchmark 的汙染與 judge bias | live 更新 + objective scoring 是更穩的評測方向 | release 版本、公開題目範圍、scoring script |
| AntiLeakBench | 2025 ACL | 新收集數據仍可能含舊知識 | “新數據”不等於“無洩漏” | 新知識定義、自動構造流程、知識截止假設 |
| Kernel Divergence Score | 2025 ICML | 測量 benchmark dataset leakage | 汙染檢測可以是獨立實驗,不只是聲明 | controlled contamination 設置、代碼倉庫、消融 |
| Benchmark Watermarking | 2025 arXiv | 發佈前為 benchmark 加入可檢測痕跡 | 未來 benchmark 可能需要審計機制 | watermark 是否影響任務效用、統計檢驗條件 |
| Preference Leakage | 2025 arXiv,ICLR 2026 accepted | LLM judge 與生成器/學生模型相關導致偏置 | judge 不是中立測量儀器 | judge 模型家族、訓練數據來源、blind judge |
| PaperBench | 2025 ICML / OpenAI | 評測 AI agent 復現 AI 論文的能力 | 復現任務可以拆成 rubric,而非只看最終分 | rubric、原論文集合、judge 校準 |
| REPRO-Bench | 2025 ACL Findings | 評測 agent 審核論文復現包 | 復現質量包括“結果是否和論文一致” | reproduction package、任務實例、人工標籤 |
| NeurIPS 2026 E&D / MLRC | 2026 | 評測、數據集和復現研究的評審規範 | benchmark 本身是科研貢獻,需要透明性 | 數據文檔、代碼可用性、負結果記錄 |
復現建議與日誌模板
復現 benchmark 論文時,不要一開始追求完整排行榜。先做一個小而可靠的審計包。
最小復現目標
- 選擇 1 個主要 benchmark 子集;
- 選擇 1 個代表 baseline 和 1 個論文方法;
- 固定 1 到 3 個 seed;
- 固定模型版本、依賴版本、prompt、max tokens、temperature、top-p;
- 保存 raw output,不只保存最終分數;
- 用論文腳本和自己寫的獨立腳本各彙總一次;
- 對 20 到 50 個錯誤樣本做人工分類。
日誌字段模板
run_id:
paper:
benchmark_name:
benchmark_version_or_release:
dataset_url:
dataset_download_time:
model_name:
model_checkpoint_or_api_version:
prompt_template_hash:
decoding_params:
seed:
hardware:
dependency_lockfile:
scorer_commit:
num_examples:
num_failed_or_timeout:
main_metric:
confidence_interval_or_std:
raw_outputs_path:
score_script_path:
known_deviations_from_paper:
復現判斷
- 如果分數接近論文,但失敗分佈不同,優先檢查 prompt、post-processing 和 scorer。
- 如果 baseline 明顯低於論文報告,優先檢查 baseline 是否被正確調參。
- 如果只有某些 task 差異很大,優先查數據版本、split、題目過濾和 judge。
- 如果 API 模型結果漂移,記錄調用日期和模型版本;不要把漂移直接解釋為方法錯誤。
- 如果無法下載數據或代碼,標註“不可獨立復現”,並把論文結論限制在作者報告範圍內。
常見誤區
誤區一:公開 benchmark 分數高就說明能力強。
公開 benchmark 可以被汙染、過擬合或模板化。分數高說明模型適應該協議,不自動說明泛化能力強。
誤區二:新 benchmark 一定無洩漏。
如果新 benchmark 基於已有網頁知識、已公開題庫、舊數據改寫或 LLM 合成,它仍可能包含預訓練前知識或模板洩漏。
誤區三:LLM judge 比人工更客觀。
LLM judge 更便宜、更一致,但會受到位置偏差、長度偏差、風格偏好、模型家族相關性和 prompt 設計影響。
誤區四:復現失敗就是論文錯。
復現失敗可能來自依賴版本、隨機性、硬件、數據下載、API 更新、隱藏預處理或文檔缺失。科研訓練要把失敗原因分類,而不是隻寫“failed”。
誤區五:ablation 表越多越可靠。
如果 ablation 沒有控制變量,或者每個模塊改變了訓練預算、參數量、數據量和推理成本,它只是多組實驗,不是機制證據。
適合研究生繼續做的選題
- 面向中文 LLM benchmark 的近重複與答案洩漏審計:收集公開題庫、榜單樣例、GitHub 鏡像和網頁緩存,構建可複用 contamination audit pipeline。
- LLM judge 家族相關性實驗:系統比較同家族、繼承關係、不同機構 judge 對同一模型輸出的評分偏差。
- Benchmark 改寫策略的 fidelity-resistance trade-off:復現 ICML 2025 相關思路,在中文問答、代碼或數學任務上比較 paraphrase、變量替換、語義重構和新知識構造。
- 論文排行榜的選擇性報告檢測:從 OpenReview / arXiv / GitHub release 中追蹤同一方法在多個 benchmark 上的報告差異,分析哪些結果更容易被主文強調。
- 小型復現包評分 rubric:為某一類 LLM 論文設計 reproduction report rubric,包括環境、數據、日誌、失敗樣本和統計檢驗。
- 動態 benchmark 的版本漂移研究:比較 LiveBench / LiveCodeBench 不同 release 下模型排名變化,區分真實能力變化、題目難度變化和評測協議變化。
總結
讀 benchmark 表格時,最重要的動作不是找最高分,而是恢復實驗的測量條件。一個可信結果至少要回答:數據是否乾淨,metric 是否對應 claim,baseline 是否公平,報告是否完整,復現路徑是否存在,失敗案例是否解釋了邊界。
對科研新人來說,benchmark 陷阱識別是一種很實用的訓練:它會逼你從“相信表格”轉向“審計證據”。當你能指出一篇論文的洩漏風險、報告偏差和復現缺口時,你也就更容易提出自己的 follow-up idea:改進 benchmark、構建審計工具、復現實驗、做負結果分析,或者重新定義一個更可靠的任務協議。
參考資料
檢索日期:2026-07-27。以下優先列出論文主頁、會議/期刊頁面、官方項目頁和官方規範;易變化的 leaderboard、release、模型版本信息以檢索日頁面為準。
- ICLR 2026 Reviewer Guide. https://iclr.cc/Conferences/2026/ReviewerGuide
- NeurIPS Evaluations & Datasets 2026 Reviewing Guidelines. https://nips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines
- MLRC 2026: Reproducibility as an Official Track at NeurIPS. https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- LiveBench official leaderboard, latest release shown as 2026-06-25 on 2026-07-27. https://livebench.ai/
- LiveBench GitHub repository. https://github.com/LiveBench/LiveBench
- Colin White et al. “LiveBench: A Challenging, Contamination-Limited LLM Benchmark.” ICLR 2025. https://mlanthology.org/iclr/2025/white2025iclr-livebench/
- Naman Jain et al. “LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code.” arXiv:2403.07974. https://arxiv.org/abs/2403.07974
- Xiaobao Wu et al. “AntiLeakBench: Preventing Data Contamination by Automatically Constructing Benchmarks with Updated Real-World Knowledge.” ACL 2025. https://aclanthology.org/2025.acl-long.901/
- Hyeong Kyu Choi et al. “How Contaminated Is Your Benchmark? Measuring Dataset Leakage in Large Language Models with Kernel Divergence.” ICML 2025 / PMLR 267. https://proceedings.mlr.press/v267/choi25b.html
- Yifan Sun et al. “The Emperor’s New Clothes in Benchmarking? A Rigorous Examination of Mitigation Strategies for LLM Benchmark Data Contamination.” ICML 2025 / PMLR 267. https://proceedings.mlr.press/v267/sun25t.html
- Tom Sander et al. “Detecting Benchmark Contamination Through Watermarking.” arXiv:2502.17259, v2 revised 2025-07-21. https://arxiv.org/abs/2502.17259
- Dawei Li et al. “Preference Leakage: A Contamination Problem in LLM-as-a-judge.” arXiv:2502.01534, ICLR 2026 accepted. https://arxiv.org/abs/2502.01534
- OpenAI. “PaperBench: Evaluating AI’s Ability to Replicate AI Research.” 2025. https://openai.com/index/paperbench/
- Giulio Starace et al. “PaperBench: Evaluating AI’s Ability to Replicate AI Research.” ICML 2025 / PMLR 267. https://proceedings.mlr.press/v267/starace25a.html
- Chuxuan Hu et al. “REPRO-Bench: Can Agentic AI Systems Assess the Reproducibility of Social Science Research?” arXiv:2507.18901, ACL 2025 Findings. https://arxiv.org/abs/2507.18901
- Stanford CRFM. “HELM Capabilities: Evaluating LMs Capability by Capability.” 2025. https://crfm.stanford.edu/2025/03/20/helm-capabilities.html