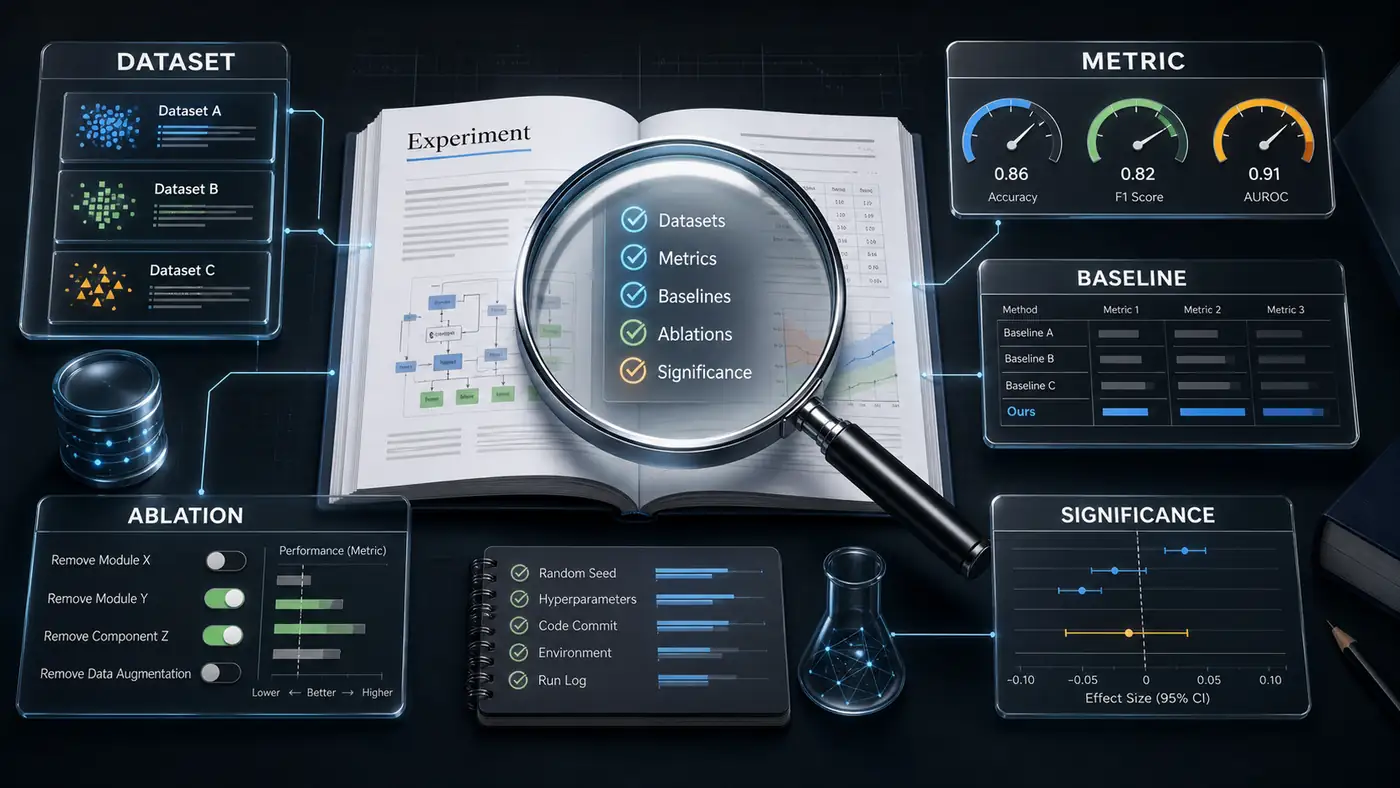
日期:2026-07-26
適合讀者:AI、NLP、機器學習方向研究生;正在準備論文精讀、復現報告、組會彙報或開題選題的科研新人;有工程背景、希望把“看分數”升級為“判斷證據強度”的技術讀者
檢索日期:2026-07-26
摘要
AI 論文的實驗部分經常被讀成“誰的分數最高”。這是一種危險的讀法。實驗表格不是排行榜截圖,而是論文用來支撐研究 claim 的證據鏈:數據集是否對應問題,指標是否測到了作者聲稱的能力,baseline 是否公平,ablation 是否真的隔離了變量,統計顯著性是否足以排除隨機波動。只要其中一環斷裂,主表裡的加粗數字就可能失去解釋力。
這篇文章給出一套面向科研訓練的實驗部分讀法。我們不從“表格第幾行最高”開始,而從“作者到底要證明什麼”開始,再按 dataset、metric、baseline、ablation、statistical significance 五層檢查證據。文章會結合 NeurIPS / ICLR / AAAI 近年審稿與復現規範、Datasheets for Datasets、Model Cards、HELM、Dror 等關於 NLP 顯著性檢驗的論文、Reimers 與 Gurevych 關於多 seed 分佈報告的實驗、Henderson 等關於深度強化學習可復現性的研究,說明如何把實驗部分讀成一個可復現、可質疑、可延展的研究對象。
目錄
- 為什麼實驗部分不能只看最高分
- 實驗部分的五層證據鏈
- Dataset:先判斷數據是否承載了問題
- Metric:指標測量的是能力,還是代理變量
- Baseline:公平比較比強 baseline 更重要
- Ablation:不是“刪模塊”,而是控制變量
- 統計顯著性:從單點分數轉向分佈和不確定性
- 方法 / 實驗審讀表
- 復現建議:把實驗部分變成 reproduction plan
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼實驗部分不能只看最高分
很多論文讀者會先翻到實驗表格,看 proposed method 是否超過 baseline,再回去讀方法。這個習慣可以快速判斷論文大意,但不能判斷論文質量。因為實驗部分真正要回答的不是“分數有沒有漲”,而是“這個分數是否足以支持作者的研究 claim”。
例如,一篇論文聲稱提出了更好的 reasoning 方法。如果它只在一個容易被訓練數據汙染的 benchmark 上提升一點點,且沒有報告採樣策略、seed、推理預算、題目版本和錯誤分析,那麼分數提升很難說明機制有效。又比如一篇論文聲稱模型更魯棒,但只報告平均 accuracy,沒有分佈外數據、子群體指標或擾動測試,那麼實驗實際上沒有覆蓋“魯棒性”這個 claim。
實驗部分的難點在於,dataset、metric、baseline、ablation 和統計檢驗會互相影響。數據集決定任務邊界,指標決定什麼行為會被獎勵,baseline 決定比較對象,ablation 決定機制解釋,顯著性檢驗決定差異是否可靠。只要一個環節設置不當,讀者就可能把偶然的、局部的或不可比的差異誤讀為方法貢獻。
這也是為什麼 2025-2026 年的主流會議越來越強調實驗披露和可復現性。AAAI-26 reproducibility checklist 明確要求作者說明數據集選擇動機、指標定義、seed、硬件軟件環境、運行次數、變異性信息和統計檢驗。ICLR 2026 reviewer guide 也要求評審判斷論文是否有實驗嚴謹性、可復現性,以及結果是否支撐 claim。NeurIPS 2026 Evaluations & Datasets reviewer guidelines 對評測工具、benchmark、數據集和負結果提出更明確的審查標準。換句話說,讀實驗部分不只是讀論文技巧,也是進入現代 AI 研究共同體的一套基本訓練。
實驗部分的五層證據鏈
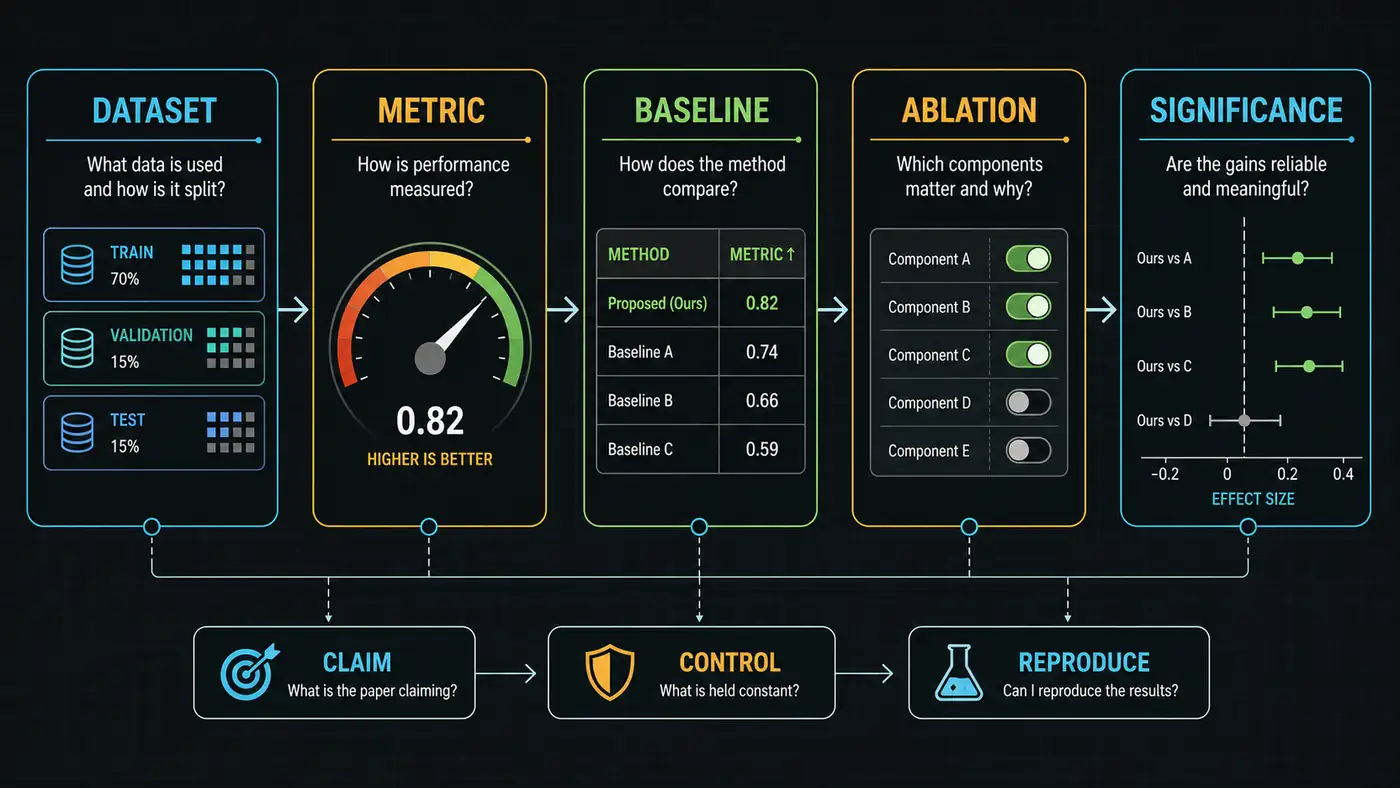
精讀實驗部分時,建議先寫下論文的中心 claim,再沿五層證據鏈檢查。
第一層是 dataset:數據是否真的代表論文要解決的問題,訓練 / 驗證 / 測試劃分是否合理,是否存在洩漏或選擇性使用。數據集不是背景材料,而是實驗結論的適用邊界。
第二層是 metric:指標是否對應作者聲稱的能力。accuracy、F1、BLEU、ROUGE、pass@k、win rate、human preference、LLM-as-judge 分數、calibration、robustness、latency、memory footprint 都測量不同對象。指標選錯,分數越高越容易誤導。
第三層是 baseline:比較對象是否公平。強 baseline 很重要,但更重要的是同數據、同預算、同調參強度、同推理設置、同評測腳本。否則主表是在比較系統配置,而不是比較方法。
第四層是 ablation:消融是否隔離了核心變量。真正的 ablation 應該回答“哪個組件通過什麼機制帶來了什麼變化”,而不是簡單地把模塊逐個刪掉。
第五層是 statistical significance:差異是否大到超過隨機波動、實現噪聲和數據抽樣誤差。對於深度學習和 LLM 研究,單次運行的一個數字往往不夠;更好的證據包括多 seed、置信區間、bootstrap、paired tests、效果量和錯誤分佈分析。
這五層可以反過來形成你的讀論文順序:不要從表格最高分開始,而是從 claim 開始;不要只問“提升了多少”,而要問“在什麼數據、什麼指標、什麼 baseline、什麼控制變量和什麼不確定性下提升”。
Dataset:先判斷數據是否承載了問題
讀 dataset 時,第一步是把數據集寫成一句完整的話:數據從哪裡來,包含什麼樣本,標註如何產生,訓練 / 驗證 / 測試如何劃分,論文為什麼選擇它,它的侷限是什麼。
以傳統分類任務為例,數據集問題包括類別分佈、樣本去重、標註一致性、訓練測試來源是否獨立、預處理是否只在訓練集上擬合。以 LLM benchmark 為例,還要額外檢查題目版本、prompt 格式、是否允許 few-shot、是否有 chain-of-thought、是否可能出現在預訓練語料、是否使用隱藏測試集、是否存在 benchmark contamination。下一篇會專門討論 benchmark 陷阱,本篇先強調一個原則:數據集不是“論文用了哪些 benchmark”的清單,而是每個結論的適用範圍。
Datasheets for Datasets 的核心價值在於,它把數據集從“可下載文件”變成需要說明動機、收集過程、組成、預處理、用途、分發和維護的研究對象。Hugging Face Dataset Cards 也延續了類似思想,要求數據卡說明數據內容、上下文、偏差、用途和元數據。讀論文實驗時,你可以把這些文檔反過來當檢查清單:如果論文用的是公開數據集,是否引用了正確版本;如果論文構造了新數據,是否說明採樣來源、過濾規則、許可、標註流程和失敗案例;如果論文用私有數據,是否解釋為什麼公開數據不夠,以及結果如何可審查。
研究生讀 dataset 時最常漏掉的是 split。訓練集、驗證集、測試集不僅是三個文件名,而是防止研究者把調參信息洩漏到最終評測的實驗制度。對於小數據、醫學數據、多主體數據、時間序列、代碼數據和多模態數據,split 方式更關鍵:按樣本隨機劃分可能會讓同一患者、同一倉庫、同一視頻、同一文檔或相近題目同時出現在訓練和測試中,從而高估泛化。
讀 dataset 可以用這個檢查清單:
- 數據來源是否可追溯,是否有官方鏈接、版本號和許可說明。
- 訓練、驗證、測試劃分是否與論文 claim 匹配。
- 預處理、去重、過濾、增強是否只使用允許的信息。
- 類別、語言、領域、難度、長度、模態分佈是否報告。
- 新數據集是否有數據卡、標註協議、標註質量和倫理 / 隱私說明。
- 私有數據或隱藏測試集是否提供足夠審查路徑。
如果這些問題沒有答案,實驗結果仍然可以作為線索,但不應被當作強證據。
Metric:指標測量的是能力,還是代理變量
Metric 的作用是把研究問題變成可比較數字。但指標永遠只是代理變量。讀實驗部分時,你要問:這個指標到底獎勵什麼行為,忽略什麼行為,會不會鼓勵模型走捷徑。
分類任務中,accuracy 在類別均衡時直觀,但在類別極不均衡時可能掩蓋少數類失敗。F1 更關注 precision 與 recall 的平衡,但 micro / macro / weighted F1 的含義不同。檢索任務中,Recall@k、MRR、nDCG 關注排序位置和候選集合。代碼任務中,pass@k 會隨採樣數量和測試用例質量變化。生成任務中,BLEU、ROUGE 這類 n-gram 指標容易低估語義等價表達,也可能高估模板化輸出。開放式 LLM 評測中的 win rate、human preference 和 LLM-as-judge 又會引入評審偏好、順序偏差、長度偏差和 judge 模型穩定性問題。
HELM 的重要啟發是:大模型評測不應只看單一準確率,而應跨場景、多指標衡量模型,包括準確性、魯棒性、校準、效率、公平性等維度。讀論文時,這意味著你不能只看作者最強調的指標,還要檢查是否存在代價指標和反向指標。例如一個方法提升了推理正確率,但顯著增加推理 token、延遲和成本;一個模型提高平均分,但在安全、校準或少數群體上退化;一個檢索增強方法提高問答準確率,但引用忠實性下降。
Metric 還要和 claim 對齊。如果論文 claim 是“更高效”,主表就不能只報 accuracy,還應報告訓練成本、推理延遲、顯存、吞吐或能耗。若 claim 是“更可靠”,就應有置信度、校準、失敗率、壓力測試或分佈外評測。若 claim 是“更可解釋”,就不能只報告任務性能,還需要忠實性、穩定性、人工評估或干預實驗。
讀 metric 時,可以給每個指標標三類標籤:
- 目標能力:它試圖測什麼能力。
- 代理風險:模型可能通過什麼捷徑提高該指標。
- 遺漏維度:它不測什麼重要屬性。
這三個標籤能讓你從“分數閱讀”進入“證據閱讀”。
Baseline:公平比較比強 baseline 更重要
Baseline 是實驗部分最容易製造錯覺的地方。一個論文可以通過選擇弱 baseline 獲得漂亮提升,也可以通過給自己方法更多數據、更多調參、更多推理預算而獲得不可比優勢。讀 baseline 的核心不是問“baseline 是否有名”,而是問“比較是否公平”。
公平 baseline 至少要檢查六件事。
第一,任務是否相同。輸入輸出、數據劃分、prompt、上下文長度、工具權限、檢索庫、訓練標籤都應一致。如果本文方法使用額外檢索文檔,而 baseline 不允許檢索,比較就不再是模型本身的比較。
第二,數據是否相同。特別是 LLM 後訓練、偏好優化、reasoning 和多模態論文,額外合成數據、過濾數據、distillation teacher 和私有數據往往比方法模塊本身更影響結果。
第三,模型規模和預訓練背景是否可比。小模型方法超過老 baseline 不等於方法機制強,可能只是 backbone 更強。
第四,訓練預算是否可比。steps、tokens、batch size、GPU、調參次數、early stopping 標準都應披露。AAAI-26 checklist 中關於超參數搜索範圍、選擇標準、最終參數、計算環境和 seed 的條目,正是為了降低這類不可比。
第五,推理預算是否可比。Reasoning、agent、code generation 和 tool-use 論文尤其要注意:temperature、top-p、採樣次數、self-consistency、search、reranking、verifier、工具調用次數都會改變結果。如果 proposed method 用 pass@64 或多數投票,而 baseline 用 greedy decoding,主表必須明確說明。
第六,評測腳本是否一致。指標實現、tokenization、答案規範化、大小寫處理、invalid output 處理、重複樣本處理都可能改變分數。
強 baseline 值得鼓勵,但公平 baseline 更重要。ICLR 2026 reviewer guide 明確提到,不達到 SOTA 本身並不構成拒稿理由;論文真正需要證明的是它是否帶來新的、相關的、可信的知識。因此讀者也不應把“不是 SOTA”簡單等同於“沒價值”,而要看 baseline 設計是否足以支撐論文的特定 claim。
Ablation:不是“刪模塊”,而是控制變量
Ablation 常被誤解為“把每個模塊刪掉,看分數下降”。這只是最粗的形式。真正有研究價值的 ablation 應該服務於機制解釋:它要說明哪些組件重要,為什麼重要,在哪些條件下重要,以及是否存在替代解釋。
讀 ablation 時,先找論文的核心假設。假設是“檢索模塊減少幻覺”,消融就應包括無檢索、不同檢索質量、不同文檔數量、錯誤檢索、引用忠實性和答案正確率的聯合分析。假設是“低秩適配足以完成任務遷移”,消融就應包括不同 rank、不同插入層、凍結 / 解凍對照、參數量和訓練預算控制。假設是“過程監督改善推理”,消融就應區分最終答案監督、過程標籤、verifier、採樣數量和搜索策略。
好的 ablation 有三個特徵。
第一,單變量控制。每次改變一個關鍵變量,並儘量保持其他變量不變。如果刪掉模塊的同時改變參數量、訓練步數、輸入長度或推理預算,消融結論就不乾淨。
第二,方向性解釋。它不只告訴你“刪掉會降分”,還告訴你在哪些樣本、哪些指標、哪些錯誤類型上變化最大。否則它只能證明模塊有用,不能解釋機制。
第三,負結果透明。有些消融可能沒有提升,甚至揭示論文方法的侷限。NeurIPS 2026 MLRC 官方介紹強調,嚴謹記錄的負結果和部分復現失敗本身可以構成有價值的科學貢獻。讀論文時,如果作者只保留有利消融、沒有報告失敗嘗試,要降低對機制 claim 的信心。
作為讀者,你可以把 ablation 表格重寫成三列:作者想证明什么、消融是否隔离变量、还有什么替代解释。這比複製表格數字更有訓練價值。
統計顯著性:從單點分數轉向分佈和不確定性
深度學習論文常見的主表是一行一個方法、一列一個數據集、每格一個數字。問題在於,單點數字會掩蓋隨機 seed、數據採樣、評測樣本、訓練不穩定和實現細節帶來的波動。
Reimers 與 Gurevych 在 EMNLP 2017 的論文中展示了 sequence tagging 系統對隨機 seed 的敏感性,並主張報告 score distributions 而不是單次分數。Dror 等在 ACL 2018 系統討論了 NLP 中統計顯著性檢驗的選擇,強調不同任務設置、評價指標和樣本依賴關係會影響應使用的檢驗方法。Henderson 等在 AAAI 2018 的 Deep RL That Matters 則說明,深度強化學習中環境隨機性、算法方差和報告方式會讓結果很難解釋,除非作者提供更嚴格的實驗和統計報告。
讀統計顯著性時,不要把 p-value 當成萬能證書。你至少要看五個問題:
- 論文是否多 seed 運行,還是隻報告最好一次。
- 差異是否有置信區間、標準差、標準誤或 bootstrap 區間。
- 檢驗是否 paired。對於同一測試集上兩個系統的輸出,paired test 通常比獨立樣本假設更合適。
- 是否報告效果量。一個統計顯著但很小的提升,未必有研究意義。
- 是否進行了多重比較控制。大量 benchmark / metric / ablation 中,總會有一些偶然顯著。
對於 LLM 評測,還要額外注意 judge 的方差和評測重複性。如果是 human evaluation,要檢查標註人數、協議、盲評、inter-annotator agreement、樣本量和抽樣方式。如果是 LLM-as-judge,要檢查 judge 模型版本、prompt、順序隨機化、重複評測和人工校驗。模型名稱、版本和 API 行為屬於易變化信息,發表前應再次核對官方文檔或項目倉庫;本文僅按 2026-07-26 可訪問來源整理。
一個實用原則是:如果論文的提升小於常見 seed 方差或置信區間重疊嚴重,就不要把它讀成確定性勝利。更合理的表述是“在該實驗設置下有正向跡象,但證據強度有限”。
方法 / 實驗審讀表
讀完實驗部分後,建議強制輸出下面這張表。它能把論文從“結果好像不錯”拆成可審查證據。
| 審讀層 | 關鍵問題 | 強證據長什麼樣 | 風險信號 |
|---|---|---|---|
| Claim | 作者到底聲稱解決什麼問題 | claim 與實驗設置逐項對應 | 主表測的不是 claim |
| Dataset | 數據是否代表問題 | 版本、來源、split、預處理、侷限清楚 | 私有數據、洩漏風險、split 不明 |
| Metric | 指標是否測到目標能力 | 多指標覆蓋準確性、魯棒性、成本或安全 | 只報最有利指標 |
| Baseline | 比較是否公平 | 同數據、同預算、同推理設置、同評測腳本 | baseline 過舊或調參不足 |
| Ablation | 是否隔離核心變量 | 單變量控制、錯誤分析、負結果透明 | 刪模塊同時改變多個條件 |
| Significance | 差異是否可靠 | 多 seed、置信區間、paired tests、效果量 | 單次最好結果、無方差信息 |
| Reproducibility | 是否能復現主結果 | 代碼、配置、數據、權重、seed、日誌齊全 | 只有偽代碼或缺關鍵配置 |
這張表的最後一列尤其重要。它不是為了挑刺,而是為了訓練研究判斷:哪些結論可以相信,哪些只能作為啟發,哪些需要復現後再引用。
復現建議:把實驗部分變成 reproduction plan
實驗部分讀懂之後,下一步不是立刻完整復現,而是把它翻譯成 reproduction plan。
第一步,復現評測腳本。先不訓練模型,拿論文公開 checkpoint 或 baseline 輸出跑通評測,確認 dataset、preprocessing、metric 和結果格式一致。很多復現問題來自評測入口,而不是模型代碼。
第二步,復現最小 baseline。選擇一個成本可控的 baseline,固定 seed、環境、數據版本和日誌格式。這樣你有一個本地參照系,後面才知道 proposed method 的變化是否真實。
第三步,復現主表中的一個核心設置。不要一開始追全表。優先選擇最能支撐論文 claim 的 dataset 和 metric,記錄每次運行的配置、commit、硬件、顯存、訓練時間和中間指標。
第四步,做一個最小 ablation。只改變一個關鍵變量,並重復至少多個 seed 或多個數據子集。若預算有限,可以降低模型規模,但要清楚寫明這是 scale-down reproduction,不要把小規模結論直接外推到原論文規模。
第五步,寫不確定性。復現報告裡應包括成功結果、失敗結果、偏差來源和待核驗項。NeurIPS MLRC 2026 對復現、推廣、負結果和評測審計的重視,說明“認真失敗”也是科研訓練的一部分。
一個好的 reproduction plan 不一定能完全復現大模型論文,但必須讓別人知道你復現了什麼、沒有復現什麼、為什麼可信、哪裡還不可信。
常見誤區
誤區一:把 benchmark 平均分當成普適能力。 平均分會抹平任務差異、樣本難度和錯誤類型。讀者應查看分任務、分難度、分語言、分領域和分輸入長度結果。
誤區二:把 SOTA 當成唯一價值。 一篇論文可能沒有最高分,但提出了更清晰的評測協議、更穩定的訓練方法或更可復現的負結果。ICLR 2026 reviewer guide 中也強調,缺少 SOTA 結果本身不是拒絕理由。
誤區三:忽略推理預算。 在 reasoning、code、agent 和 tool-use 研究中,採樣次數、搜索、驗證器和工具調用會顯著改變結果。讀表格時必須確認 test-time compute。
誤區四:把 ablation 當成機制證明。 模塊刪除導致分數下降,只說明模塊相關,不自動說明作者給出的機制解釋正確。還需要替代解釋、錯誤分析和控制實驗。
誤區五:只看 statistical significance,不看效果量。 大樣本下很小差異也可能顯著,但未必有研究意義;小樣本下不顯著也可能是功效不足。科研判斷需要結合效果量、方差、成本和 claim。
誤區六:把開源倉庫等同於可復現。 代碼公開很重要,但還需要數據版本、環境、訓練命令、評測腳本、權重、日誌和隨機種子。Papers with Code 的研究代碼發佈建議中,依賴、訓練代碼、評測代碼、預訓練模型和結果復現命令是關鍵組成。
適合研究生繼續做的選題
多 seed 與多數據子集的結果穩定性研究:選擇一個熱門 LLM 或 multimodal benchmark,比較單 seed、三 seed、bootstrap 和不同測試子集下的排名變化。
指標敏感性分析:在同一任務上比較 accuracy、macro-F1、calibration、latency、token cost、human preference 或 LLM judge 指標,觀察結論如何變化。
baseline 公平性審計:選一組近期論文,檢查 baseline 是否同數據、同調參預算、同推理策略,並給出可復現審計表。
消融設計復現:復現一篇方法論文的關鍵 ablation,並補充作者未做的替代解釋控制實驗。
數據集文檔質量研究:用 Datasheets / Dataset Cards 的問題框架審查某一領域的數據集,分析哪些缺失信息最影響復現。
LLM-as-judge 方差研究:固定樣本和系統輸出,改變 judge prompt、順序、模型版本或重複次數,測量評測穩定性。涉及模型版本和 API 行為時,應在實驗日誌中記錄檢索與調用日期。
這些選題的共同特點是規模可控、訓練科研基本功、容易形成 reproduction report 或 workshop paper,也能幫助你從“讀論文”過渡到“評價證據”。
總結
讀實驗部分的核心,不是記住哪個方法在表格裡最高,而是判斷證據鏈是否支撐論文 claim。Dataset 決定問題邊界,metric 決定測量對象,baseline 決定比較是否公平,ablation 決定機制解釋是否成立,統計顯著性決定差異是否可靠。
對研究生來說,最有價值的訓練動作是把實驗部分重寫成三份材料:一張 evidence table,一份 reproduction plan,一組待核驗問題。這樣讀論文,你不僅能複述作者結論,還能知道結論在哪裡強、在哪裡弱、如何復現、如何進一步提出自己的研究問題。
下一篇將繼續向前推進:如何識別論文裡的 benchmark 陷阱,重點討論數據洩漏、選擇性報告和不可復現結果。
參考資料
檢索日期:2026-07-26。以下優先列出一手資料、官方頁面、論文頁面或項目主頁;會議規則、模型版本、代碼倉庫狀態、benchmark 結果和數據集版本均可能變化,正式發表前建議再次人工核驗。
- AAAI-26 Reproducibility Checklist, AAAI official page, 2025. https://aaai.org/conference/aaai/aaai-26/reproducibility-checklist/
- ICLR 2026 Reviewer Guide, ICLR official page. https://iclr.cc/Conferences/2026/ReviewerGuide
- NeurIPS 2026 Evaluations & Datasets Reviewing Guidelines, NeurIPS official page. https://neurips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines
- MLRC 2026: Reproducibility as an Official Track at NeurIPS, NeurIPS Blog, 2026-05-04. https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- Joelle Pineau et al. “Improving Reproducibility in Machine Learning Research: A Report from the NeurIPS 2019 Reproducibility Program.” JMLR, 2021. https://www.jmlr.org/papers/v22/20-303.html
- Timnit Gebru et al. “Datasheets for Datasets.” Communications of the ACM, 2021; arXiv version 2018. https://arxiv.org/abs/1803.09010
- Hugging Face Hub Documentation: Dataset Cards. https://huggingface.co/docs/hub/datasets-cards
- Margaret Mitchell et al. “Model Cards for Model Reporting.” FAT* 2019 / Google Research page. https://research.google/pubs/model-cards-for-model-reporting/
- Hugging Face Hub Documentation: Model Cards. https://huggingface.co/docs/hub/model-cards
- Percy Liang et al. “Holistic Evaluation of Language Models.” HELM project page. https://crfm.stanford.edu/helm/latest/
- Rotem Dror, Gili Baumer, Segev Shlomov, Roi Reichart. “The Hitchhiker’s Guide to Testing Statistical Significance in Natural Language Processing.” ACL 2018. https://aclanthology.org/P18-1128/
- Nils Reimers and Iryna Gurevych. “Reporting Score Distributions Makes a Difference: Performance Study of LSTM-networks for Sequence Tagging.” EMNLP 2017. https://aclanthology.org/D17-1035/
- Peter Henderson et al. “Deep Reinforcement Learning That Matters.” AAAI 2018. https://ojs.aaai.org/index.php/AAAI/article/view/11694
- Papers with Code: Tips for Publishing Research Code. https://github.com/paperswithcode/releasing-research-code
- OpenAI Evals repository. https://github.com/openai/evals