日期:2026-07-25
適合讀者:AI、NLP、機器學習方向研究生;準備復現方法論文、寫 reading note、做 ablation 或從論文侷限發展選題的科研新人;希望把“看懂論文”提升為“能拆、能復現、能質疑”的工程型讀者
檢索日期:2026-07-25
摘要
方法論文是 AI 研究訓練中最容易“讀懂表面、漏掉關鍵”的類型。你可能看完摘要,知道作者提出了一個新模塊、一個新訓練目標或一個新推理流程;也可能記住了實驗表格裡某幾個高分結果。但如果你不能回答四個問題,這篇論文其實還沒有被拆開:它到底定義了什麼任務,核心假設是什麼,方法由哪些模塊組成,訓練目標如何把假設變成可優化信號。
這篇文章給出一套面向復現和選題的拆解框架。它不把論文當成一段敘事,而是當成一個可運行、可替換、可反駁的研究系統:輸入、輸出、約束、模塊、loss、數據流、訓練流程、推理流程和證據鏈。我們會用 Transformer、LoRA、QLoRA、DPO、Mamba、DeepSeek-R1、Kimi K2 等代表性論文和技術報告作為參照,說明怎樣從論文文本、公式、算法框、實驗設置和開源代碼中還原方法的真實結構。重點不是背論文結論,而是訓練一種科研動作:把一篇方法論文拆成可以復現的最小單元,再從這些單元裡找到自己的 follow-up idea。
目錄
- 為什麼方法論文不能只讀“方法介紹”
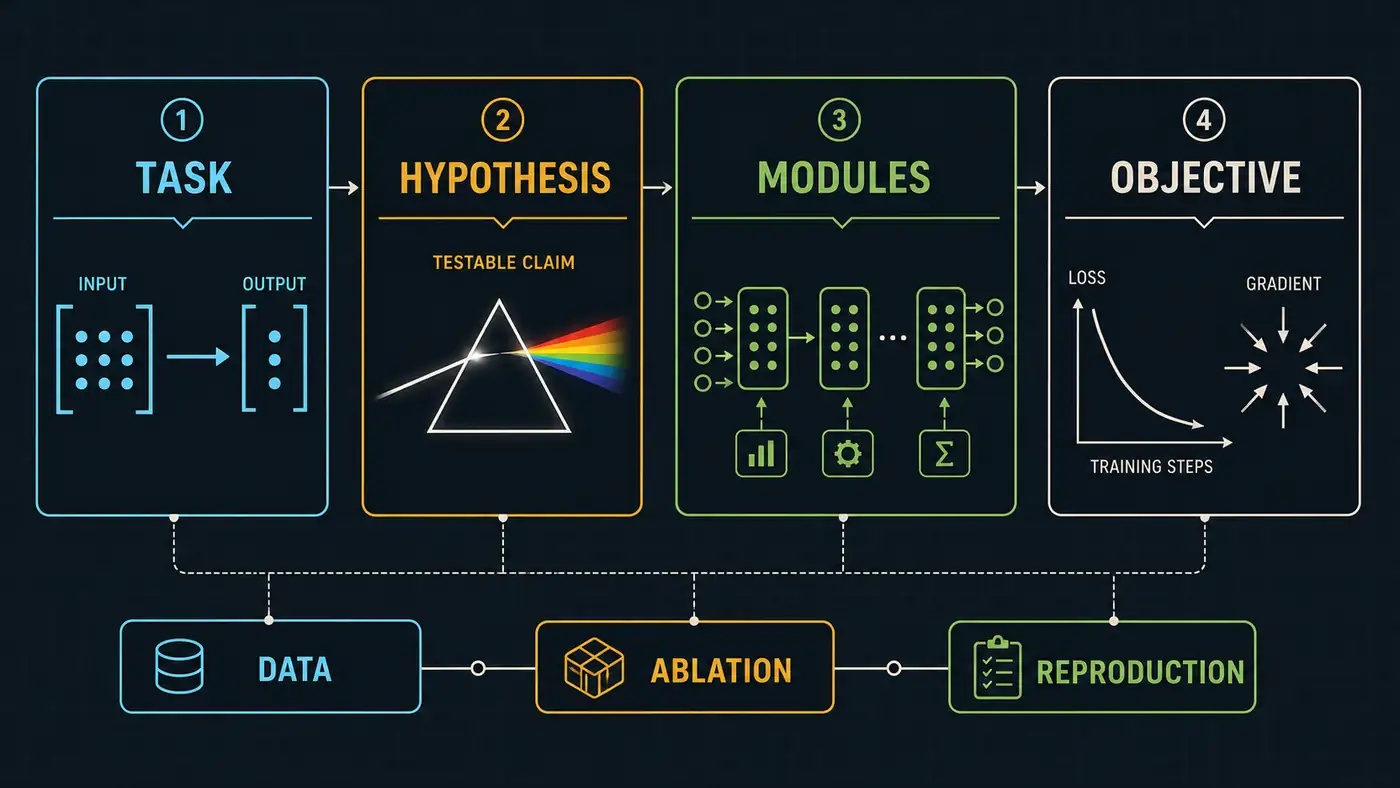
- 方法論文的四層骨架
- 第一步:重寫任務定義
- 第二步:找出核心假設
- 第三步:畫出模塊邊界和數據流
- 第四步:拆訓練目標和優化流程
- 代表論文路線圖
- 關鍵論文精讀示例
- 方法 / 實驗對比表
- 復現實操:從偽代碼到最小可運行版本
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼方法論文不能只讀“方法介紹”
很多研究生讀方法論文時,會自然地把注意力放在 Method section:作者提出什麼結構,公式長什麼樣,圖裡有哪些模塊,算法框寫了幾步。這當然重要,但只讀方法介紹會造成一個嚴重錯覺:你以為論文的貢獻在“新模塊”,實際上貢獻可能在任務定義、訓練數據構造、損失函數權重、推理時搜索策略、baseline 選擇或實驗協議裡。
方法論文通常有兩套結構。第一套是作者寫出來的結構:Introduction 講問題,Related Work 講背景,Method 講模型,Experiments 講結果。第二套是研究系統的結構:任務定義決定輸入輸出,假設決定為什麼這個方法可能有效,模塊決定信息如何流動,訓練目標決定模型被獎勵什麼,評測協議決定 claim 是否被證據支撐。精讀方法論文時,你要從第一套結構裡還原第二套結構。
這種能力在 2025-2026 年尤其重要。當前 AI 方法論文越來越像系統工程:一個大模型技術報告可能同時包含預訓練數據、MoE 架構、長上下文、強化學習、工具調用數據和安全評測;一篇 reasoning 論文可能同時改變數據、獎勵、採樣和驗證器;一篇 efficient training 論文可能把顯存優化、量化格式、低秩適配和實驗配置綁在一起。如果只問“作者提出了什麼模塊”,很容易把多個變量混成一個貢獻。
更實際地說,復現失敗經常不是因為你看不懂公式,而是因為你沒有拆清楚系統邊界:作者是否固定 backbone,是否用了額外數據,loss 是主目標還是 auxiliary objective,訓練分幾階段,推理時是否用了更高 compute budget,baseline 是否共享同樣的數據和調參預算。拆方法論文的目的,就是在動手之前把這些問題顯式化。
方法論文的四層骨架
拆一篇方法論文,可以從四層開始。
第一層是 任務定義。它回答“論文解決的到底是什麼問題”。這裡不要只抄任務名,而要寫成輸入、輸出、約束和成功標準。例如,machine translation 不是隻有“翻譯”,還包括輸入語言、輸出語言、訓練語料、解碼條件和評測指標;preference optimization 不是隻有“讓模型更符合偏好”,還包括偏好對的來源、reference model 是否固定、是否需要 reward model、優化目標是否穩定。
第二層是 核心假設。方法論文必然暗含一個假設:某種歸納偏置、訓練信號、數據組織方式或推理過程能帶來更好泛化。Transformer 的關鍵假設之一是 attention 可以替代循環和卷積來建模序列依賴;LoRA 的關鍵假設是大模型適配更新存在低內在秩;DPO 的關鍵假設是可以把偏好學習重寫為直接優化策略而不顯式訓練 reward model;Mamba 的關鍵假設是 selective state space 機制能在長序列建模中兼顧線性複雜度和內容選擇能力。你要把這些假設用自己的話寫出來,因為它們決定後續 ablation 應該測什麼。
第三層是 模塊邊界。方法論文裡的模塊不是圖上畫了幾個盒子,而是哪些參數被訓練,哪些參數被凍結,哪些信息流可微,哪些步驟只在訓練時存在,哪些步驟只在推理時存在。模塊邊界一旦拆錯,復現就會變成“看似實現了論文,實際實現的是另一個系統”。
第四層是 訓練目標。訓練目標不是公式裝飾,而是論文把假設轉化成優化壓力的地方。一個方法可能看起來是架構創新,真正起作用的是輔助 loss;也可能看起來是 RL 創新,真正敏感的是 reward normalization、KL 約束、採樣數量和數據過濾。拆訓練目標時,要問主 loss、輔助 loss、正則項、約束項、採樣策略和訓練階段分別在優化什麼。
這四層可以形成一張最小拆解表:
| 拆解層 | 你要重寫的問題 | 最終產物 |
|---|---|---|
| 任務定義 | 輸入是什麼,輸出是什麼,約束是什麼,成功標準是什麼 | 一段形式化 problem statement |
| 核心假設 | 作者認為哪個機制會改善哪個失敗模式 | 1-3 條可證偽 hypothesis |
| 模塊邊界 | 哪些組件產生、變換、篩選或驗證信息 | 模塊圖和數據流圖 |
| 訓練目標 | 每個 loss、reward 或 objective 在壓什麼行為 | objective 表和訓練階段表 |
第一步:重寫任務定義
拆方法論文時,第一步不是看公式,而是重寫任務定義。一個好的任務定義至少包含五個元素:輸入空間、輸出空間、訓練信號、約束條件和評測標準。
以 Transformer 為例,如果只說“做機器翻譯”,粒度太粗。更有效的寫法是:給定源語言 token 序列,模型通過 encoder-decoder attention 生成目標語言 token 序列;訓練使用並行語料上的 next-token maximum likelihood;推理使用自迴歸解碼;評測使用機器翻譯指標和速度 / 可並行性分析。這樣寫之後,你會立刻看到論文的關鍵不只是“attention”,還有“去掉循環結構後是否仍能保持翻譯質量,同時提升訓練並行度”。
以 DPO 為例,任務定義也不能寫成“對齊大模型”。它更具體:給定 prompt 和成對偏好回答,優化一個 policy,使其相對 reference policy 更偏向 chosen response 而遠離 rejected response;它試圖替代 RLHF 中先訓練 reward model、再做 policy optimization 的多階段流程。這樣重寫之後,後續問題就清楚了:reference model 如何選擇,偏好數據來自哪裡,chosen/rejected 的質量差是否足夠,beta 等超參數怎樣改變行為。
以 DeepSeek-R1 這類 reasoning 技術報告為例,任務定義還要區分“訓練任務”和“展示任務”。論文可能在數學、代碼和通用問答上展示能力,但訓練中涉及 cold-start data、reinforcement learning、rejection sampling、distillation 等階段。你不能把最終 benchmark 上的 reasoning ability 直接等同於某一個模塊的貢獻,而要追蹤每個訓練階段面向的行為:格式穩定性、長鏈推理、可讀性、答案正確性、對齊風格還是小模型蒸餾。
重寫任務定義時可以用這個檢查清單:
- 輸入是否明確到數據格式、上下文長度、模態和採樣來源。
- 輸出是否明確到生成對象、預測標籤、動作序列或檢索結果。
- 訓練信號是否明確到監督標籤、偏好對、reward、self-play 反饋或合成數據。
- 約束是否包括計算預算、參數凍結、數據可用性、推理時間和安全限制。
- 評測標準是否真的對應論文聲稱解決的問題。
如果這五項寫不清楚,先不要急著讀公式。因為公式只是在某個任務定義內部有意義。
第二步:找出核心假設
方法論文的假設通常不會用“Hypothesis”作為標題寫出來。它藏在 Introduction 的痛點、Method 的設計選擇和 Ablation 的對照組裡。找假設的方法是把作者的貢獻句改寫成因果句:
“如果我們引入 X,那麼 Y 會改善,因為 Z。”
例如,LoRA 可以改寫為:如果只訓練低秩矩陣來近似權重更新,那麼在凍結預訓練模型主體的情況下仍能高效適配下游任務,因為適配過程中的權重變化具有低內在秩。這個假設直接導出復現實驗:不同 rank 的表現如何,哪些層需要 LoRA,參數量和性能如何權衡,低秩更新是否在不同任務上都成立。
QLoRA 可以改寫為:如果用 4-bit 量化存儲凍結的大模型權重,並通過低秩適配訓練少量參數,就能在有限顯存上微調大模型,同時儘量保留全精度微調效果。這裡要檢查的不是“4-bit 很省顯存”這一句,而是量化格式、paged optimizer、rank、數據質量和任務規模如何共同影響結果。
Mamba 可以改寫為:如果 state space model 具備內容依賴的選擇機制,就能在長序列中保留線性時間推理優勢,同時改善傳統 SSM 對離散 token 內容選擇不足的問題。這個假設導出的問題是:優勢來自 selective scan、整體架構、訓練規模,還是比較對象的設置。
DPO 可以改寫為:如果偏好學習目標可以從 reward modeling 推導為一個直接的分類式 objective,那麼無需顯式 RL 訓練也能讓 policy 學會偏好方向。這個假設要通過與 RLHF、PPO、IPO、KTO 等方法在同等偏好數據和 reference 設置下比較,而不是隻看最終勝率。
假設拆解的關鍵是“可證偽”。一句“我們的方法更有效”不是假設;一句“模塊 X 在長依賴場景中通過 Y 機制降低 Z 誤差”才有可實驗檢驗的形狀。你在閱讀時可以用三色標註:
- 綠色:論文明確驗證過的假設。
- 黃色:論文部分驗證,但實驗設置不足以隔離變量。
- 紅色:論文聲稱了效果,但沒有直接證據或只有間接結果。
這種標註會自然變成你的 follow-up idea 來源。黃色和紅色區域,往往比作者強調的亮點更適合研究生繼續做。
第三步:畫出模塊邊界和數據流
方法論文裡的圖通常是“講故事的圖”,不是“復現用的圖”。復現需要你重畫一張更樸素的系統圖:數據從哪裡來,經過哪些可訓練模塊,產生哪些中間變量,loss 回傳到哪裡,推理時哪些模塊仍然存在。
你可以把模塊分成六類。
輸入處理模塊:tokenizer、視覺編碼器、檢索器、prompt template、數據過濾器、增強器。很多論文看起來是模型創新,實際敏感點在輸入構造。例如 instruction tuning 和 preference optimization 中,prompt 格式、system message、response 清洗和數據混合比例都會改變結果。
主體模型模塊:encoder、decoder、attention block、SSM block、MoE layer、adapter、router、memory bank、tool policy。這裡要標註哪些參數初始化自預訓練模型,哪些從零訓練,哪些凍結。
中間表示模塊:retrieved documents、latent state、scratchpad、chain-of-thought、program、tool call、reward feature、hidden activation。中間表示是否可見、是否可監督、是否被過濾,會影響復現和解釋。
訓練信號模塊:label、preference pair、reward model、verifier、self-consistency vote、teacher model、synthetic data generator。訓練信號模塊常被論文寫得很短,但它決定上限。
優化與調度模塊:optimizer、learning rate schedule、batching、gradient checkpointing、precision、seed、stage transition。工程實現不是論文的附屬物,在大模型方法中常常是方法有效性的前提。
推理策略模塊:greedy / beam / sampling、temperature、top-p、reranking、search、tool verification、majority vote、KV cache 或 speculative decoding。很多 reasoning、agent 和 code 論文的性能差異來自 inference-time compute,而不是訓練結構本身。
畫圖時,建議每個模塊旁邊寫三類標籤:trainable / frozen / external,train-only / inference-only / both,claimed contribution / support component / evaluation component。這三個標籤能幫你快速識別論文裡的核心變量和輔助變量。
第四步:拆訓練目標和優化流程
訓練目標是方法論文最值得慢讀的部分。公式不需要你一眼記住,但你要能回答它在獎勵什麼、懲罰什麼、約束什麼。
對於 supervised fine-tuning,主目標通常是 token-level maximum likelihood。但這不意味著所有 SFT 論文都一樣。數據來源、樣本權重、sequence packing、loss mask、assistant-only loss、multi-turn 格式和拒答樣本都會改變訓練壓力。
對於 preference optimization,要拆 chosen/rejected pair、reference model、KL 或隱式 KL、temperature / beta、response 長度偏差和偏好數據噪聲。DPO 的公式背後有一個重要研究問題:它把偏好學習變成了直接目標,但這個目標是否足以處理多輪偏好、過程偏好、verifier 反饋和分佈外 prompt,需要具體實驗支持。
對於 RL reasoning,要拆 reward 的可驗證性和採樣過程。數學和代碼任務常有相對明確的答案驗證器,開放式任務則困難得多。DeepSeek-R1 這類論文提示我們,reasoning 能力的訓練不是單一 loss,而是數據、冷啟動、RL、蒸餾和格式控制共同作用。閱讀時要把每個階段的目標寫成表格,而不是把它們合併成“用了 RL”。
對於架構論文,loss 可能看似普通,但訓練流程仍然關鍵。Transformer 原論文使用 sequence-to-sequence 翻譯任務驗證架構;Mamba 類論文通常會在語言建模、長序列任務和不同規模設置中驗證架構假設。你要問:如果 loss 沒變,為什麼結構變化會帶來收益;如果數據和規模也變了,實驗是否能隔離架構貢獻。
拆訓練目標可以用這張表:
| 項目 | 閱讀問題 | 復現記錄方式 |
|---|---|---|
| 主目標 | 最終優化的 loss / reward 是什麼 | 寫出公式和代碼入口 |
| 輔助目標 | 是否有 auxiliary loss、KL、entropy、router loss | 標註權重和啟停階段 |
| 數據採樣 | 每個 batch 如何構成 | 記錄數據混合比例和過濾規則 |
| 參數更新 | 哪些參數被更新 | 保存 trainable parameter list |
| 訓練階段 | 是否多階段訓練 | 每階段單獨記錄 checkpoint |
| 推理耦合 | 訓練目標是否依賴推理策略 | 固定 decoding / search 配置 |
代表論文路線圖
下面不是“必讀全集”,而是訓練拆解能力的一條路線。每類論文都適合練習不同拆法。
| 論文類型 | 代表論文 | 適合練什麼 |
|---|---|---|
| 架構方法 | Transformer、Mamba | 從模塊邊界和複雜度假設拆貢獻 |
| 參數高效微調 | LoRA、QLoRA | 從凍結參數、低秩假設和顯存預算拆貢獻 |
| 偏好優化 | RLHF 系列、DPO | 從 reward / preference objective 拆訓練信號 |
| 推理訓練 | DeepSeek-R1 等 reasoning 技術報告 | 從多階段訓練和可驗證 reward 拆系統 |
| 大模型技術報告 | Kimi K2 等 MoE / agentic LLM 報告 | 從架構、數據、後訓練、評測和代碼說明拆證據 |
| 復現規範 | NeurIPS、ICLR、AAAI、ACL checklist | 從實驗披露要求反推論文應提供的信息 |
這條路線的重點是橫向比較。不要把每篇論文孤立讀完,而要問:它改變的是任務定義、模塊、objective、數據,還是推理預算。相同 benchmark 上的分數只有在這些變量可比時才有解釋力。
關鍵論文精讀示例
Transformer:先拆任務,再拆架構
Transformer 最容易被讀成“Attention is All You Need,所以核心就是 self-attention”。這句話沒錯,但精讀時還要拆三個層次。
第一,任務背景是 sequence transduction,原論文主要通過機器翻譯實驗展示效果。第二,核心假設是 attention 機制可以替代 recurrent / convolutional 結構,並通過並行化改善訓練效率。第三,模塊包括 multi-head attention、position-wise feed-forward network、positional encoding、residual connection、layer normalization、encoder-decoder attention 和自迴歸 decoder。第四,訓練目標仍是常規序列生成目標,所以架構貢獻要通過與 RNN/CNN baseline、訓練成本和翻譯質量共同判斷。
復現時,你不需要一開始就重寫一個現代大模型。更好的訓練是用小規模 translation 或 language modeling 任務實現 minimal Transformer,然後逐項關掉 positional encoding、multi-head、feed-forward width、residual path,觀察 failure mode。這比直接跑大模型更能理解方法。
LoRA / QLoRA:模塊小,變量不少
LoRA 的論文很好練“參數邊界”。它的核心不是“加兩個矩陣”這麼簡單,而是凍結預訓練權重,只訓練低秩更新,並把可訓練參數插入到特定線性層。閱讀時要記錄 rank、alpha、插入層位置、dropout、任務類型、baseline、全量微調對照和訓練預算。
QLoRA 則進一步提醒我們:方法論文可能由多個工程變量組成。4-bit quantization、NF4、double quantization、paged optimizer、LoRA adapter、數據集選擇和指令微調設置都可能影響結果。你要把“顯存可行性”和“質量保持”分開記錄。前者可以通過峰值顯存和 batch size 復現,後者需要同數據、同模型、同評測的對照。
DPO:公式背後的數據和 reference
DPO 的吸引力在於把偏好優化寫成相對簡潔的目標。但拆解時要從公式外部開始:偏好數據怎樣構造,chosen/rejected 是否只差一個維度,reference policy 如何選擇,beta 如何控制偏離程度,訓練後是否出現長度偏差或安全行為變化。
對於研究生,DPO 的好訓練不是複述推導,而是做一個小實驗:固定基礎模型和偏好數據,比較 SFT-only、DPO、不同 beta、不同數據噪聲比例和不同 evaluation prompt。你會發現 preference optimization 的效果不只來自目標函數,還來自偏好數據的可學習性。
Mamba:複雜度 claim 要和任務 claim 分開
Mamba 類論文適合訓練“不要把效率 claim 和效果 claim 混在一起”。線性時間序列建模是複雜度 claim,語言建模或長上下文表現是任務 claim,selective state space 是機制 claim。三者相關,但不是同一件事。
閱讀時,先拆 selective mechanism 解決什麼失敗模式,再看實現是否需要特定 kernel 或硬件優化,最後看實驗是否覆蓋了足夠任務和規模。復現時可以先跑小模型的序列任務驗證功能正確,再比較吞吐和顯存,最後才談大規模結果。
DeepSeek-R1 / Kimi K2:技術報告要按階段拆
2025 年以來,大模型技術報告越來越重要,但它們常常不是單一方法論文。DeepSeek-R1 這類 reasoning 報告涉及強化學習、冷啟動數據、蒸餾和推理行為;Kimi K2 這類 MoE / agentic LLM 報告則會同時覆蓋模型結構、訓練系統、agentic 數據、工具調用和評測。
讀這種報告時,最危險的做法是把所有結果歸因到一個名字。更好的做法是按階段拆表:預訓練階段解決什麼,後訓練階段解決什麼,RL 階段優化什麼,蒸餾階段遷移什麼,推理設置又額外提供了什麼。對於代碼倉庫、模型權重、benchmark 數字和數據細節,要以論文官方頁面、arXiv 版本、項目主頁和倉庫當前狀態為準;本文檢索日期為 2026-07-25,後續發表版或倉庫內容可能已經變化,發表前應再次人工核驗。
方法 / 實驗對比表
讀完一篇方法論文後,建議強制輸出一張對比表。下面是一種模板。
| 維度 | 本文方法 | 關鍵 baseline | 需要核驗的問題 |
|---|---|---|---|
| 任務定義 | 輸入、輸出、約束是否改變 | baseline 是否同任務 | 是否存在任務定義漂移 |
| 數據 | 訓練數據、過濾、合成、偏好來源 | baseline 是否同數據 | 是否用了額外不可見數據 |
| 模型 | 新模塊、凍結模塊、外部模塊 | baseline 參數量和架構 | 參數量或計算量是否公平 |
| Objective | 主 loss、輔助 loss、reward | baseline objective | 是否多了額外訓練信號 |
| 訓練預算 | steps、tokens、GPU、precision | baseline 預算 | 是否調參預算不同 |
| 推理預算 | sampling、search、tools、rerank | baseline 推理設置 | 是否用了更多 test-time compute |
| 證據 | main table、ablation、analysis | 對照實驗 | 是否隔離核心變量 |
| 可復現性 | 代碼、數據、配置、seed、日誌 | baseline 復現實作 | 缺哪項會阻塞復現 |
這張表的作用不是整理得好看,而是暴露不可比項。只要你發現“本文方法多了額外數據”“baseline 沒有同等調參”“推理時用了更多采樣”“ablation 沒有單獨關掉核心模塊”,就應該在閱讀筆記裡標紅。
復現實操:從偽代碼到最小可運行版本
方法論文復現不要一開始追求完整規模。更穩的路線是四步。
第一步,建立 paper spec。把任務定義、數據、模塊、objective、訓練階段、推理設置寫成一頁 YAML 或 Markdown。不要寫感想,只寫可執行信息。凡是論文沒說清楚的地方,標成“待人工核驗”或“需要從代碼確認”。
第二步,做 minimal implementation。只實現核心變量,使用小數據、小模型和短訓練步數驗證代碼路徑。目標不是復現論文分數,而是確認 forward、loss、mask、梯度和日誌都正確。
第三步,做 single-factor ablation。一次只改一個變量:關掉模塊、換 objective、改變 rank、去掉 auxiliary loss、固定推理預算、替換數據過濾規則。每個實驗要有 seed、config、commit hash、硬件信息和日誌路徑。
第四步,做 claim-level reproduction。回到論文主 claim,判斷哪些 claim 被你復現,哪些只部分復現,哪些無法復現。復現報告應按 claim 寫,而不是按實驗編號寫。
一個實用的復現目錄可以這樣組織:
reproduce_paper_x/
  paper_spec.md
  configs/
    baseline.yaml
    method.yaml
    ablation_no_module_x.yaml
  scripts/
    train.py
    evaluate.py
  logs/
    2026-07-25_seed1_method/
  notes/
    implementation_questions.md
    reproduction_report.md
如果論文有官方代碼,不要急著魔改。先跑官方最小 demo,記錄環境、依賴版本、數據下載、checkpoint、默認參數和日誌格式。然後再把你自己的實驗改動控制在 config 層。很多復現失敗來自“還沒跑通原始實現就開始重構”。
常見誤區
誤區一:把論文圖當成實現圖。 論文圖常省略數據預處理、mask、loss 權重、訓練階段和推理策略。復現前必須重畫數據流圖。
誤區二:把新名字當成新貢獻。 一個模塊有新名稱,不代表它改變了核心機制。要追問它相對 baseline 改了什麼變量。
誤區三:只讀 main result table。 方法論文的可信度主要在 ablation、analysis、negative case 和實驗協議,而不只在最大表格。
誤區四:忽略訓練數據。 2025-2026 年很多模型能力差異來自數據篩選、合成、偏好標註、蒸餾和 rejection sampling。只看模型結構會誤判貢獻。
誤區五:把 test-time compute 當成訓練方法收益。 如果方法在推理時使用更多采樣、搜索、工具調用或 verifier,必須單獨記錄推理預算。
誤區六:復現時只追分數,不追機制。 分數接近不代表機制一致。你還要檢查中間行為、失敗案例和 ablation 是否支持同一解釋。
適合研究生繼續做的選題
- 方法論文拆解基準:選一個小領域,系統標註 30 篇論文的任務定義、模塊、objective、數據和推理預算,分析常見不可比變量。
- Objective 敏感性復現:選擇 DPO、IPO、KTO 或 GRPO 相關方法,在同一偏好數據上比較超參數、噪聲和 reference model 的影響。
- 模塊貢獻再評估:挑一篇架構或 adapter 論文,復現實驗並加入更嚴格的參數量、訓練 tokens 和推理預算控制。
- 技術報告證據審計:以 2025-2026 年大模型技術報告為對象,比較它們披露數據、訓練階段、評測和安全限制的粒度。
- 論文到代碼一致性檢查:構建工具或人工協議,檢查論文公式、算法框、配置文件和代碼實現之間的不一致。
- Ablation report 模板研究:提出一種面向方法論文的復現報告格式,強制按 claim、變量和證據組織,而不是按實驗流水賬組織。
這些題目都不要求一開始訓練大模型。真正有研究價值的是把變量拆清楚,把對照做乾淨,把結論寫得可證偽。
總結
拆解方法論文的核心,不是把 Method section 翻譯成中文,而是把一篇論文還原成研究系統。你要先重寫任務定義,再抽出核心假設,然後畫模塊邊界和數據流,最後拆訓練目標、訓練階段和推理設置。只有這樣,論文裡的 claim 才會變成可復現、可質疑、可擴展的對象。
對研究生來說,最重要的訓練不是“讀了多少篇”,而是每讀一篇都能產出四個文件:任務定義、假設清單、模塊圖、objective 表。一個月後,你會發現自己不再只是跟隨論文敘事,而是在主動審計論文。科研選題也會從“我想改一個模塊”變成“我知道哪個假設還沒有被充分驗證,以及怎樣設計實驗驗證它”。
參考資料
檢索日期:2026-07-25。以下鏈接優先選擇論文、會議官方頁面、arXiv、OpenReview 或項目主頁。模型權重、代碼倉庫狀態、benchmark 數字、數據集版本和會議規則可能隨時間變化,正式發佈前應再次人工核驗。
- Vaswani et al., “Attention Is All You Need”, arXiv, 2017. https://arxiv.org/abs/1706.03762
- Hu et al., “LoRA: Low-Rank Adaptation of Large Language Models”, arXiv, 2021. https://arxiv.org/abs/2106.09685
- Dettmers et al., “QLoRA: Efficient Finetuning of Quantized LLMs”, arXiv, 2023. https://arxiv.org/abs/2305.14314
- Rafailov et al., “Direct Preference Optimization: Your Language Model is Secretly a Reward Model”, arXiv, 2023. https://arxiv.org/abs/2305.18290
- Gu and Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces”, arXiv, 2023. https://arxiv.org/abs/2312.00752
- DeepSeek-AI, “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning”, arXiv, 2025. https://arxiv.org/abs/2501.12948
- Moonshot AI, “Kimi K2: Open Agentic Intelligence”, arXiv, 2025. https://arxiv.org/abs/2507.20534
- NeurIPS 2026 Reviewer Guidelines, official conference page. https://neurips.cc/Conferences/2026/ReviewerGuidelines
- ICLR 2026 Call for Papers, official conference page. https://iclr.cc/Conferences/2026/CallForPapers
- AAAI-26 Reproducibility Checklist, official conference page. https://aaai.org/conference/aaai/aaai-26/reproducibility-checklist/
- ACL 2026 Main Conference Calls and submission information, official conference page. https://2026.aclweb.org/
- OpenReview documentation and venue pages for ICLR-style peer review and paper metadata. https://openreview.net/