日期:2026-07-24
適合讀者:AI、NLP、機器學習方向研究生;準備寫 Related Work、開題報告、復現報告和 survey 的科研新人;希望把論文閱讀從“收藏列表”升級為“研究問題地圖”的工程型讀者
檢索日期:2026-07-24
摘要
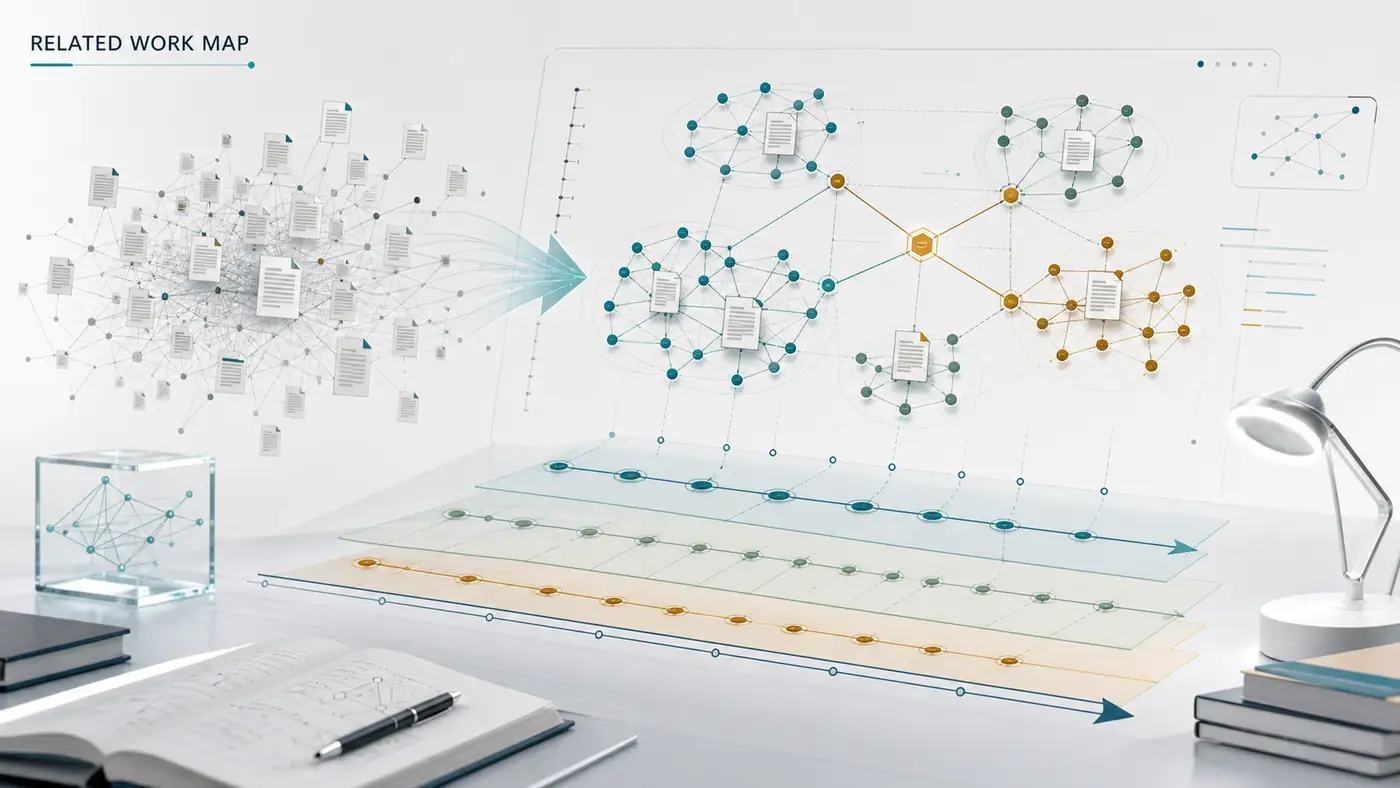
Related Work 不是論文裡的禮貌性背景介紹,而是研究訓練的骨架。它回答三個問題:這個問題從哪裡來,已有方法分別解決了什麼,當前論文或你的 proposal 準備改變哪一個環節。很多研究生讀論文的低效,根源不是讀得不夠多,而是沒有把論文之間的關係外顯出來:哪些是同一任務的直接競爭者,哪些是共享數據集的評測線,哪些是方法組件的來源,哪些只是名字相近但問題不同。
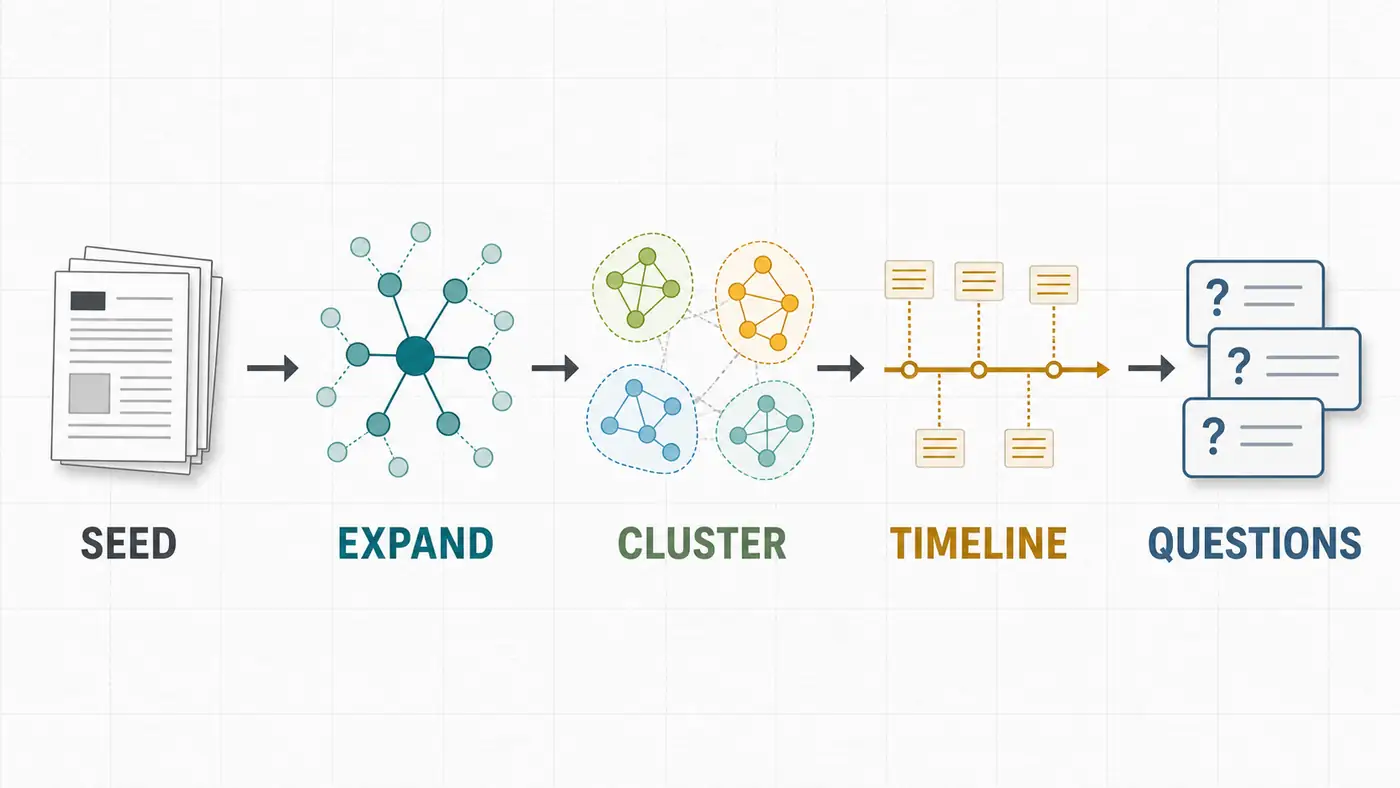
這篇文章給出一套“Related Work 地圖”的做法:從 3-5 篇種子論文出發,用引用網絡擴展候選文獻,用文本和引用信號聚類,用時間線整理技術分支,再把每個分支壓縮成可檢驗的研究問題。我們會結合經典文獻計量學方法,如 bibliographic coupling、co-citation、science mapping,也會討論 SPECTER、SciNCL、Semantic Scholar、OpenAlex、arXiv API、OpenScholar 和 2025 年 related work generation 論文給 AI 研究閱讀帶來的新工具。重點不是教你用某個軟件畫一張漂亮網絡圖,而是訓練一種科研能力:把文獻列表變成研究脈絡,把研究脈絡變成可復現、可質疑、可推進的選題。
目錄
- 為什麼 Related Work 地圖比文獻列表更重要
- 一張好地圖應回答什麼問題
- 五步工作流:Seed、Expand、Cluster、Timeline、Questions
- 引用網絡的三種邊:直接引用、共被引、文獻耦合
- 代表論文與工具路線圖
- 如何給聚類命名:從關鍵詞到 claim
- 方法 / 實驗對比表怎麼做
- 復現實操:用最小腳本構建自己的文獻圖
- LLM 可以幫什麼,不能替你做什麼
- 常見誤區
- 適合研究生繼續做的選題
- 總結
- 參考資料
為什麼 Related Work 地圖比文獻列表更重要
很多人的 Related Work 寫法是“按讀過的順序堆摘要”:A 做了什麼,B 做了什麼,C 做了什麼,最後說本文不同。這種寫法的問題是,它沒有解釋論文之間的關係。讀者看完只知道你讀過一些論文,卻不知道這個方向為什麼形成、爭議在哪裡、哪個變量決定了方法分叉。
真正有用的 Related Work 地圖至少有三層。第一層是 問題層:任務定義、輸入輸出、約束條件和評測目標如何變化。第二層是 方法層:模型結構、訓練目標、檢索機制、推理策略、數據構造或安全約束如何分叉。第三層是 證據層:哪些 dataset、metric、baseline、ablation 和復現材料支撐了這些分支。只寫論文摘要,最多覆蓋方法層的一小部分;做地圖,才會逼你同時檢查問題和證據。
這件事在 2025-2026 年的 AI 研究中尤其重要。論文數量增長很快,arXiv、OpenReview、ACL Anthology、NeurIPS、ICLR、ICML 等入口同時更新;同一個概念常被不同社區用不同名字討論;新模型技術報告、benchmark 論文和復現報告又不一定出現在同一渠道。只靠關鍵詞搜索,容易得到一堆“看起來相關”的論文;只靠引用次數,容易漏掉新近但關鍵的工作;只靠 LLM 總結,容易把相關性寫得很順,卻混淆任務邊界和引用來源。
所以 Related Work 地圖不是寫作最後一步,而應放在研究早期。它幫助你決定接下來精讀哪篇、復現哪條 claim、在哪個分支找 gap、是否已有論文回答了你的想法。對研究生來說,一張地圖比一百條收藏更接近開題能力。
一張好地圖應回答什麼問題
做地圖前,先明確地圖不是“全領域百科”。它是為了服務一個研究動作。不同動作需要不同粒度。
如果你準備精讀一篇方法論文,地圖要回答:這篇論文的直接前驅是誰,它和 baseline 的差異是否真實,它的模塊分別來自哪些工作,哪些實驗設置最能驗證它的核心假設。
如果你準備寫復現報告,地圖要回答:哪些論文共享數據集和評測腳本,哪些論文報告了可比 baseline,哪些後續工作質疑或複用了原論文結果,哪些代碼倉庫、issue、模型卡和配置文件可以交叉核對。
如果你準備開題,地圖要回答:方向裡有哪些穩定問題、哪些爭議、哪些尚未被充分測試的條件;你的 follow-up idea 是補一個缺失 baseline、改一個假設、換一個數據分佈,還是提出一個更好的評測協議。
一張好地圖通常能輸出五個具體產物:
| 產物 | 作用 | 最低要求 |
|---|---|---|
| 種子論文表 | 定義入口 | 3-5 篇,覆蓋任務、方法、評測或綜述 |
| 候選文獻池 | 避免只讀熟悉論文 | 標註來源:引用、被引、推薦、關鍵詞、會議 proceedings |
| 聚類圖 | 看技術分支 | 每個聚類有名字、代表論文和邊界 |
| 時間線 | 看問題演化 | 標註任務定義、數據集、模型假設和評測變化 |
| 研究問題清單 | 連接選題 | 每個問題對應可復現證據或可執行實驗 |
注意最後一項。Related Work 的終點不是“我知道了方向”,而是“我能提出一個有根據的問題”。如果地圖不能導出研究問題,它就只是視覺化收藏夾。
五步工作流:Seed、Expand、Cluster、Timeline、Questions
第一步:Seed,選擇種子論文
不要一開始就搜 100 篇。先選 3-5 篇種子論文,每篇代表一個不同角色。
任務定義論文:提出或標準化問題,例如一個 benchmark、dataset、evaluation protocol 或 problem formulation。它決定方向裡“什麼算成功”。
方法代表論文:提出被後續廣泛複用的結構、訓練目標或推理範式。它決定方向裡“怎麼做”。
綜述或路線論文:整理已有分支。它不一定最新,但能給你初始分類。
復現 / 負結果 / critique 論文:指出已有結論的限制。它決定你不會只沿著作者敘事讀。
最新論文或技術報告:代表近期變化。它幫助你檢查 2025-2026 年的新數據、新模型、新評測是否改變舊結論。
種子論文太少會偏,太多會亂。對一個訓練營專題,建議從 5 篇開始:1 篇經典基礎,1 篇近期綜述,1 篇強方法,1 篇評測或數據論文,1 篇 critique / 復現 / 最新系統。
第二步:Expand,擴展引用網絡
擴展不是隨便點“related papers”。你需要記錄每篇候選論文為什麼進池。
第一類是 backward citation:種子論文引用了誰。這能找到理論基礎、任務來源、baseline 和方法組件。第二類是 forward citation:誰引用了種子論文。這能找到後續改進、復現、爭議和替代路徑。第三類是 co-citation:哪些論文經常被後續論文一起引用。這常對應一個共同問題或方法家族。第四類是 bibliographic coupling:哪些論文引用了相似的參考文獻。這能發現同一時期、同一問題設定下的鄰近工作。第五類是 text / embedding similarity:標題摘要相似但引用關係不強的論文,適合補新論文和跨社區論文。
這裡可以組合使用 Semantic Scholar、OpenAlex、arXiv、ACL Anthology、OpenReview 和會議 proceedings。Semantic Scholar API 官方說明覆蓋論文、作者、引用、venue、SPECTER2 embeddings 與推薦服務;OpenAlex Works API 提供 works 的檢索、過濾、排序、referenced_works、related_works、cited_by_count 等字段;arXiv API 支持 search_query、id_list、分頁和按 submitted / updated date 排序。工具只負責擴大召回,研究者要負責篩選理由。
第三步:Cluster,聚類而不是分類
分類通常是你先有標籤,再把論文放進去;聚類是先看論文關係,再給關係命名。Related Work 地圖建議先聚類後命名,因為你一開始的分類很可能來自某篇綜述或作者話術,不一定適合你的問題。
聚類可以用三種信號疊加:
| 信號 | 適合發現 | 常見風險 |
|---|---|---|
| 引用關係 | 學術傳承、baseline、同一社區 | 新論文引用少,跨社區論文可能漏掉 |
| 文本相似 | 主題、任務、方法術語 | 容易被流行詞誤導 |
| 實驗設置 | dataset、metric、模型規模、推理預算 | 需要手工抽取,成本較高 |
建議先做粗粒度聚類:每個聚類 5-15 篇。超過 20 篇,說明標籤太寬;只有 1 篇,說明它可能是孤立論文、最新分支,或你召回不足。聚類命名不要用“方法 A 類”“方法 B 類”這種懶標籤,要用能表達研究問題的名字,例如“長上下文下的證據定位”“圖結構輔助的閱讀順序”“citation-backed scientific synthesis”“benchmark contamination 檢測”。
第四步:Timeline,畫技術時間線
同一聚類內部要按時間線讀。時間線不是發表年份排序,而是“問題定義和證據標準如何演化”的序列。
你可以為每個分支記錄五列:論文、年份 / venue、主問題、關鍵方法、證據材料。重點看變化點:什麼時候出現新數據集,什麼時候 baseline 從傳統模型換成 LLM,什麼時候評測從摘要級相似度轉向 citation-level correctness,什麼時候開源代碼或復現材料變成社區關注點。
以 automatic related work generation 為例,早期工作常把任務近似成多文檔摘要或 citation text generation;2024 年 EMNLP 的 Related Work and Citation Text Generation survey 系統整理了 RWG 的歷史任務定義和挑戰;2024 年 SDP 論文把結構化段落和 novelty statements 納入任務;2025 年 ACL Findings 的 Select, Read, and Write 則把全文閱讀、共享工作記憶和圖感知閱讀順序引入框架。這條時間線說明:方向的核心難點不是“生成一段流暢文字”,而是選擇文獻、理解關係、組織結構和證明 novelty。
第五步:Questions,把地圖轉成研究問題
最後一步最容易被忽略。每個聚類至少寫出一個問題,格式儘量可測試:
- 如果把 citation expansion 換成 embedding retrieval,候選文獻覆蓋率和噪聲如何變化?
- 如果只用摘要而不用全文,Related Work 中的方法差異和 novelty statement 會漏掉什麼?
- 如果使用 LLM 生成文獻綜述表,如何評估 citation correctness、coverage、contrastiveness 和 hallucination?
- 如果一個方向的新論文引用很少,怎樣避免引用網絡系統性低估它的重要性?
- 如果一個 benchmark 成為主流,後續論文是否過度圍繞該 benchmark 優化而忽視外部分佈?
這些問題可以直接變成復現實驗、數據標註任務、survey 小節或開題 proposal。地圖的價值就在這裡:它把閱讀從“理解已有結論”推進到“設計下一步證據”。
引用網絡的三種邊:直接引用、共被引、文獻耦合
做 Related Work 地圖時,最容易混淆三種關係。
直接引用 是有方向的邊:論文 A 引用論文 B。它常表示方法來源、背景、對比對象或證據支持,但不能簡單理解成“認可”。有些引用是批評,有些只是數據集或工具引用。
共被引 是後續文獻同時引用兩篇論文。Henry Small 在 1973 年提出 co-citation,用“兩篇文獻被一起引用的頻率”刻畫關係。它適合發現被社區共同理解為同一問題或同一基礎的論文組。缺點是它滯後:新論文需要時間積累被引。
文獻耦合 是兩篇論文引用了相似參考文獻。M. M. Kessler 在 1963 年提出 bibliographic coupling,用共享參考文獻衡量論文相近性。它適合發現同期同主題工作,因為一篇論文發表時參考文獻已經確定。缺點是如果作者遺漏或策略性引用,關係會被扭曲。
Derek de Solla Price 1965 年的 Networks of Scientific Papers 則把科學論文看作網絡結構,為後來的 science mapping 奠定了重要視角。後續 VOSviewer、CiteSpace、PageRank 類 ranking、Semantic Scholar literature graph、OpenAlex 等系統,都是在不同粒度上擴展這一思想。
對 AI 讀者來說,最重要的不是背這些術語,而是知道它們分別回答不同問題:
| 關係 | 問題 | 適合用途 |
|---|---|---|
| 直接引用 | A 從 B 借了什麼或回應了什麼 | 找方法來源、baseline、數據集 |
| 共被引 | 社區把哪些論文一起看 | 找經典基礎和穩定子領域 |
| 文獻耦合 | 哪些論文站在相似基礎上 | 找同期競爭工作和近鄰分支 |
| 文本相似 | 哪些論文談相似主題 | 補新論文、跨社區論文 |
| 實驗相似 | 哪些論文證據可比 | 做復現和實驗對照 |
一張可靠地圖不能只用一種邊。只用直接引用會錯過相似但互不引用的論文;只用 embedding 會把術語相近但任務不同的論文混在一起;只用引用次數會低估新論文和小社區工作。實踐中建議把引用邊作為骨架,把文本相似作為召回,把實驗相似作為最終篩選。
代表論文與工具路線圖
| 時間 | 資料 | 作用 |
|---|---|---|
| 1963 | Kessler, Bibliographic coupling between scientific papers | 用共享參考文獻識別論文關係 |
| 1973 | Small, Co-citation in the scientific literature | 用共同被引識別研究專題結構 |
| 1999 | PageRank technical report | 用鏈接結構估計重要性,啟發圖排序 |
| 2010 | VOSviewer, Scientometrics | 文獻計量地圖和可視化工具代表 |
| 2018 | Construction of the Literature Graph in Semantic Scholar | 大規模學術文獻圖構建實踐 |
| 2020 | SPECTER, ACL | citation-informed scientific paper embeddings |
| 2021 | PRISMA 2020 statement | 系統綜述報告規範和檢索流程透明化 |
| 2022 | SciNCL, EMNLP | 用 citation graph embedding 做科學文檔對比學習 |
| 2024 | Related Work and Citation Text Generation survey, EMNLP | RWG 任務歷史和挑戰綜述 |
| 2025 | Select, Read, and Write, ACL Findings | 全文 RWG、多 agent 閱讀和圖感知策略 |
| 2026 | OpenScholar, Nature / GitHub | 面向科學文獻合成的 retrieval-augmented LM 系統 |
這條路線說明,Related Work 地圖有兩條技術傳統。一條來自文獻計量學:引用網絡、聚類、可視化、科學地圖。另一條來自 NLP / LLM:論文表示學習、文獻檢索、citation-aware generation、長文獻合成。研究訓練要把兩條線合起來:用文獻計量學保證結構,用 NLP 工具提高召回和整理效率,用人工審讀確保問題邊界和證據解釋不被自動化工具替代。
如何給聚類命名:從關鍵詞到 claim
聚類之後,最關鍵的動作是命名。命名不是貼關鍵詞,而是壓縮研究脈絡。
差的命名是“RAG 類”“Agent 類”“LLM 類”。這些標籤太大,不能說明差異。更好的命名要包含 對象、機制、證據或爭議。例如:
- “citation-backed scientific synthesis”:對象是科學文獻合成,機制是檢索與引用支撐;
- “graph-aware reading order for RWG”:對象是 related work generation,機制是圖感知閱讀順序;
- “benchmark contamination detection”:對象是評測汙染,證據是檢測協議;
- “full-text vs abstract-only literature understanding”:爭議是全文信息是否必要。
命名時可以用三步。第一,列出聚類內 5 篇代表論文的主 claim。第二,找這些 claim 共享的變量:任務、數據、方法組件、評測指標或失敗條件。第三,把變量寫成一個可討論的問題,而不是一個名詞。例如不要寫“Scientific RAG”,而寫“科學文獻合成中檢索、reranking 和 citation verification 是否足以降低幻覺”。
如果一個聚類很難命名,通常有三種可能:候選論文太雜,需要拆分;你對論文理解還停留在摘要層;或者這個聚類本身是跨分支橋接點,值得單獨標註為 “bridge papers”。橋接論文很重要,因為好的 follow-up idea 經常來自兩個聚類之間:把一個分支的評測協議移到另一個分支,把一個分支的失敗案例變成另一個分支的數據構造。
方法 / 實驗對比表怎麼做
Related Work 地圖最終要落到表格。表格不是為了塞進論文,而是強迫你對齊變量。建議至少做兩張表。
第一張是 方法對比表:
| 論文 | 問題定義 | 輸入信息 | 核心機制 | 輸出 | 關鍵假設 |
|---|---|---|---|---|---|
| 論文 A | 生成 citation sentence | 摘要 + 引用上下文 | 多文檔摘要 | 單句或段落 | 摘要足夠代表論文 |
| 論文 B | 結構化 Related Work | 多篇參考論文 | 主題分段 + novelty statement | 多段落 | 好 RWS 應顯式說明 novelty |
| 論文 C | 全文 RWG | 全文 sections + graph | selector / reader / writer agents | RWS 草稿 | 閱讀順序和關係建模影響質量 |
第二張是 證據對比表:
| 論文 | 數據來源 | metric | baseline | 是否全文 | 是否開源 | 主要風險 |
|---|---|---|---|---|---|---|
| 論文 A | ACL / 引用句 | ROUGE 等 | 摘要模型 | 否 | 部分 | 指標偏向詞面相似 |
| 論文 B | 自建結構化數據 | 結構和 novelty 指標 | SOTA LM | 部分 | 需核驗 | novelty 判斷主觀 |
| 論文 C | 全文數據 | 自動 + 人工評估 | 多 base model | 是 | 代碼數據公開 | 成本高,圖結構依賴元數據質量 |
表格要服務判斷,不要追求列越多越好。每一列都應幫助你回答一個問題:這些論文真的在比較同一件事嗎?它們的證據是否支持主張?我如果要復現,最小可控變量是什麼?
復現實操:用最小腳本構建自己的文獻圖
對工程背景讀者,建議做一個最小可復現實驗:輸入 5 篇 arXiv / DOI / ACL Anthology ID,輸出一個 50-100 篇候選論文的 Related Work 地圖。
步驟如下:
- 準備種子表:
seed_id, title, year, venue, role, why_seed。不要只存標題,要存 DOI、arXiv ID、ACL ID 或 Semantic Scholar paperId。 - 拉取元數據:用 Semantic Scholar 或 OpenAlex 獲取 title、abstract、year、venue、authors、references、citations、citation count、open access PDF。API 返回字段會變化,腳本中保留原始 JSON。
- 擴展候選池:每篇 seed 取 backward citations、forward citations、recommended papers 和關鍵詞搜索結果。每條候選記錄
source_reason,例如cited_by_seed_1、shares_references_with_seed_2、s2_recommendation。 - 去重與過濾:按 DOI、arXiv ID、ACL ID、title fuzzy match 去重。過濾明顯無關領域、非論文頁面、缺摘要且無法訪問的記錄。
- 計算關係邊:直接引用邊來自元數據;文獻耦合邊用共享 references 的 Jaccard 或 overlap;文本邊用 title + abstract embedding;實驗相似邊先人工標註 dataset / metric。
- 聚類與可視化:用 NetworkX / igraph / Gephi / VOSviewer / Cytoscape 任選一種。節點大小可以用年內引用或人工重要性,顏色用聚類,邊類型用線型。
- 人工審讀 20 篇代表論文:每個聚類至少讀 2-3 篇,不要直接相信聚類標籤。
- 輸出地圖筆記:每個聚類寫一句 claim、一句證據、一句侷限、一句 follow-up。
這個最小實驗不需要追求全自動。恰恰相反,手工標註 20 篇代表論文是訓練價值最高的部分。自動化負責召回和可視化,研究者負責判斷哪些關係有解釋力。
LLM 可以幫什麼,不能替你做什麼
LLM 對 Related Work 地圖很有用,但要放在正確位置。
它適合做四類輔助:把論文標題摘要整理成初始標籤;從 PDF 中抽取 dataset、metric、baseline 和 claim;把一個聚類的論文壓縮成待核驗摘要;根據已有地圖生成遺漏檢查問題。OpenScholar 這類 retrieval-augmented scientific synthesis 系統說明,專門面向科學文獻的檢索、reranking、citation-backed generation 和 citation verification 可以顯著改善普通 LLM 在文獻合成中的覆蓋和引用可靠性。其 GitHub 倉庫也顯示了系統包含檢索、reranker、self-feedback、posthoc attribution 等組件,而不是單純讓模型憑記憶回答。
但 LLM 不適合替你做三件事。第一,不能替你決定論文是否真正相關。相關性取決於你的研究問題,而不是標題摘要相似度。第二,不能替你判斷 claim 是否被實驗支持。它可以抽取表格,但公平性、汙染、統計顯著性和 baseline 變量需要你核驗。第三,不能替你寫未經核查的引用敘事。2024 年 EMNLP 的 RWG survey 和 2025 年 ACL Findings 的全文 RWG 工作都強調,Related Work generation 的難點包括選擇、組織、關係建模和 novelty 表達;這些正是科研訓練要學習的部分。
實用原則是:LLM 生成的每一句 Related Work 敘述,都必須能追溯到你地圖裡的節點、邊和原文證據。沒有證據鏈,就只當草稿。
常見誤區
誤區一:地圖越大越好。 1000 個節點的圖通常沒有閱讀價值。訓練營階段建議控制在 50-100 篇候選、15-30 篇重點、5-8 篇精讀。地圖要可解釋,不要只追求全。
誤區二:引用次數等於重要性。 引用次數受年份、領域規模、工具屬性和綜述引用影響。新論文、負結果和跨領域論文可能引用少但很關鍵。可以用引用次數排序,但不能用它替代判斷。
誤區三:把相似論文當同一論文。 標題都寫 “agent memory” 或 “scientific discovery”,並不代表任務、輸入、metric 和失敗條件相同。Related Work 地圖必須標註問題定義。
誤區四:只看作者引用,不看後續引用。 作者引用告訴你論文從哪裡來,後續引用告訴你社區如何使用、改寫或質疑它。兩者缺一不可。
誤區五:把 Related Work 寫成“誰做了什麼”。 更好的寫法是“這個分支在解決什麼變量,代表工作如何處理,證據有什麼限制,本文為什麼需要新的問題或方法”。
誤區六:過度依賴自動綜述。 2026 年 OpenReview 上已有關於 LLM 生成 literature review tables 評估的工作,關注準確性、完整性和整體質量評價困難。它提醒我們:LLM 可以輔助製表,但表格質量本身也需要被評價。
適合研究生繼續做的選題
選題一:Related Work 地圖的召回評估。 選 3 個 AI 子方向,以專家 curated reading list 為近似 gold set,比較關鍵詞搜索、引用擴展、Semantic Scholar recommendations、OpenAlex related works 和 embedding retrieval 的召回率、噪聲率與新論文覆蓋。
選題二:全文信息對 Related Work 聚類的影響。 比較只用 title + abstract、加入 introduction、加入全文 sections 後,聚類標籤和代表論文是否變化。這個選題適合復現 2025 年全文 RWG 工作中的一個小模塊。
選題三:LLM 生成 Related Work 表格的核驗協議。 設計一個 rubric,評估 citation correctness、coverage、contrastiveness、novelty statement、遺漏關鍵工作和 hallucinated citation。不要只用 ROUGE 或 embedding similarity。
選題四:引用網絡中的新論文偏置。 分析 2024-2026 年某個 AI 方向的論文,比較 co-citation、bibliographic coupling 和 text similarity 對新論文的覆蓋差異,提出一個 hybrid ranking。
選題五:從 OpenReview 討論反推 Related Work 質量。 抽取 ICLR / NeurIPS / ACL 公開評審中關於 missing related work、novelty、baseline 和 positioning 的評論,構建一個“Related Work 缺陷分類表”。
這些選題都不需要訓練大模型,但都能訓練紮實科研能力:檢索協議、數據清洗、人工標註、評價指標、復現實驗和論證寫作。
總結
Related Work 地圖的核心不是畫圖,而是把論文關係變成研究判斷。你需要從少量種子論文開始,用引用網絡和文本檢索擴大候選池,用聚類和時間線整理分支,再把每個分支壓縮成 claim、證據、侷限和 follow-up。經典文獻計量學提供了直接引用、共被引和文獻耦合這些結構工具;SPECTER、SciNCL、Semantic Scholar、OpenAlex 和 OpenScholar 等現代系統提高了科學文獻檢索與表示能力;但最終的研究問題仍必須由人來定義和核驗。
對訓練營讀者,建議今天不要只讀一篇論文。請選擇你當前方向的 5 篇種子論文,做一張 50 篇以內的 Related Work 地圖,並寫出 5 個可測試問題。只要能完成這個動作,你的論文閱讀就已經從“吸收信息”進入“組織證據和生成選題”的階段。
參考資料
檢索日期:2026-07-24。以下鏈接優先使用論文主頁、官方文檔、ACL Anthology、Nature、OpenReview、arXiv、項目倉庫或工具官方頁面。部分預印本、API 字段、代碼倉庫狀態和模型 / 數據版本會變化,正式發佈前建議人工複核。
- M. M. Kessler. 1963. Bibliographic coupling between scientific papers. American Documentation. https://doi.org/10.1002/asi.5090140103
- Henry Small. 1973. Co-citation in the scientific literature: A new measure of the relationship between two documents. Journal of the American Society for Information Science. https://doi.org/10.1002/asi.4630240406
- Derek J. de Solla Price. 1965. Networks of Scientific Papers. Science. https://pubmed.ncbi.nlm.nih.gov/14325149/
- Lawrence Page, Sergey Brin, Rajeev Motwani, Terry Winograd. 1999. The PageRank Citation Ranking: Bringing Order to the Web. Stanford InfoLab. https://ilpubs.stanford.edu/422/
- Nees Jan van Eck, Ludo Waltman. 2010. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. https://doi.org/10.1007/s11192-009-0146-3
- Waleed Ammar et al. 2018. Construction of the Literature Graph in Semantic Scholar. NAACL. https://aclanthology.org/N18-3011/
- Arman Cohan et al. 2020. SPECTER: Document-level Representation Learning using Citation-informed Transformers. ACL. https://aclanthology.org/2020.acl-main.207/
- Malte Ostendorff et al. 2022. Neighborhood Contrastive Learning for Scientific Document Representations with Citation Embeddings. EMNLP. https://aclanthology.org/2022.emnlp-main.802/
- Page et al. 2021. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. https://www.bmj.com/content/372/bmj.n71
- PRISMA 2020 statement official site and checklist. https://www.prisma-statement.org/prisma-2020-statement
- Xiangci Li, Jessica Ouyang. 2024. Related Work and Citation Text Generation: A Survey. EMNLP. https://aclanthology.org/2024.emnlp-main.767/
- Kazuya Nishimura et al. 2024. Toward Structured Related Work Generation with Novelty Statements. SDP. https://aclanthology.org/2024.sdp-1.5/
- Xiaochuan Liu et al. 2025. Select, Read, and Write: A Multi-Agent Framework of Full-Text-based Related Work Generation. Findings of ACL. https://aclanthology.org/2025.findings-acl.366/
- Akari Asai et al. 2026. Synthesizing scientific literature with retrieval-augmented language models. Nature. https://www.nature.com/articles/s41586-025-10072-4
- OpenScholar official implementation. https://github.com/akariasai/openscholar
- Semantic Scholar Academic Graph API overview and documentation. https://www.semanticscholar.org/product/api
- Semantic Scholar Recommendations API documentation. https://api.semanticscholar.org/api-docs/recommendations
- OpenAlex Works API documentation. https://developers.openalex.org/api-reference/works/list-works
- arXiv API User Manual. https://info.arxiv.org/help/api/user-manual.html
- OpenReview documentation. https://docs.openreview.net/
- Evaluating LLM-Generated Literature Review Tables: A Survey and Preliminary Study. OpenReview, 2026 workshop submission. https://openreview.net/forum?id=3y7kBvvq32