日期:2026-07-23
適合讀者:AI、NLP、機器學習方向研究生;準備做論文精讀、復現報告、開題選題的科研新人;有工程背景但希望提高論文篩選效率的技術讀者
檢索日期:2026-07-23
摘要
AI 論文讀不完,真正困難的不是“理解每一篇”,而是判斷哪一篇值得進入深讀、復現和選題階段。一個月訓練營如果每天只按熱度、轉發量或標題新奇程度挑論文,很快會陷入兩個問題:讀了很多包裝很強但證據很弱的工作,或者錯過那些不夠熱鬧卻能改變研究問題定義的論文。
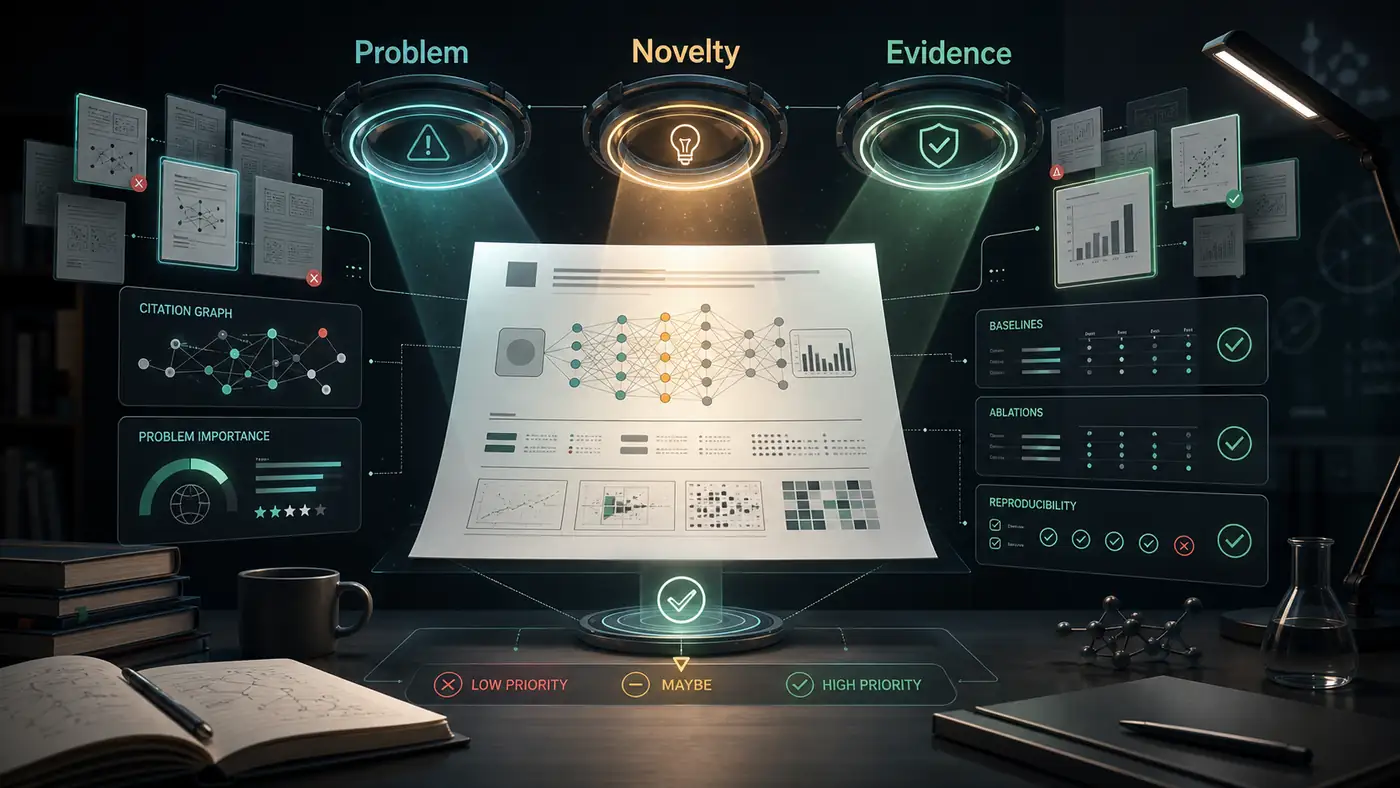
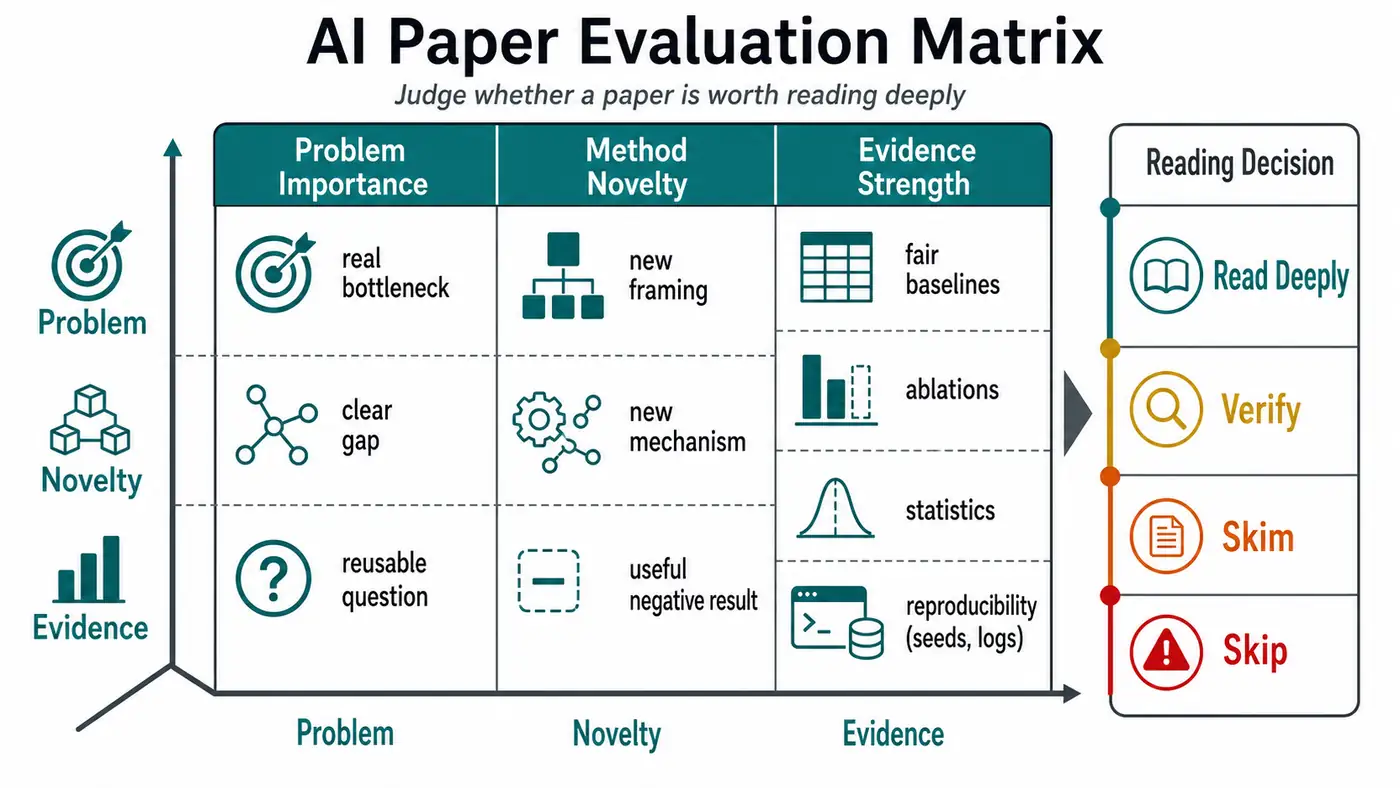
這篇文章給出一套適合研究生和工程型讀者的論文篩選方法:用 問題重要性、方法新意、證據強度 三個軸判斷一篇 AI 論文值不值得讀。它借鑑 ICLR 2026、NeurIPS 2026、ACL Rolling Review 和 AAAI-26 等一手審稿 / 可復現性材料中的評價維度,也結合 2025-2026 年 LLM benchmark、data contamination、reproducibility track 和 PaperBench 等最新研究線索。目標不是把自己訓練成“快速打分機器”,而是形成一個可複用的閱讀決策流程:哪些論文跳過,哪些論文粗讀,哪些論文需要核驗,哪些論文值得投入半天到幾天做精讀和復現。
目錄
- 為什麼“值不值得讀”本身是科研能力
- 15 分鐘 triage:先決定閱讀深度
- 第一軸:問題重要性
- 第二軸:方法新意
- 第三軸:證據強度
- 四檔閱讀決策:Skip、Skim、Verify、Read Deeply
- 代表資料路線圖:從審稿標準到 benchmark 論文
- 判斷矩陣與打分表
- 復現前的最低核驗
- 常見誤區
- 適合研究生繼續做的訓練題
- 總結
- 參考資料
為什麼“值不值得讀”本身是科研能力
科研新人常把論文閱讀理解成一個線性任務:找論文,下載 PDF,從摘要讀到結論,做筆記。但真實研究不是圖書館打卡,而是有限注意力下的選擇。一個方向每個月可能出現幾十篇 arXiv 預印本、若干頂會投稿、開源技術報告、benchmark 更新和復現評論。你不可能每篇都精讀,所以必須先學會判斷。
判斷一篇論文是否值得讀,本質上是在做小型 peer review。ICLR 2026 reviewer guide 要求審稿人回答四個核心問題:論文處理的具體問題是什麼,方法是否有充分動機並放在相關工作中,證據是否支持 claim,工作是否對社區貢獻了新的知識或價值。NeurIPS 2026 reviewer guidelines 也把 quality、clarity、significance、originality 作為核心維度,其中 significance 關注結果是否會被社區使用、是否推進理解,originality 不等同於發明一個全新模塊,也可以來自新的洞察、問題設定、指標或對已有方法性質的揭示。
這對讀者很有啟發:讀論文前,不要只問“它是不是 SOTA”,而要問“它是否值得佔用我的研究時間”。有些論文沒有最高分,但提出了一個後來會被反覆使用的任務、數據集、評測協議或負結果;有些論文表格漂亮,但問題很窄、baseline 不公平、實現不可復現。前者值得深讀,後者最多粗讀。
2026 年 NeurIPS 把 Datasets & Benchmarks Track 調整為 Evaluations & Datasets Track,並明確把 evaluation 視為可研究、可審計、可復現和可改進的科學對象。這說明 AI 研究的重心正在變化:模型結構之外,評測假設、數據構造、可復現性和 claim 的邊界,也在決定一篇論文的科學價值。判斷論文值不值得讀,就是在訓練自己識別這些邊界。
15 分鐘 triage:先決定閱讀深度
建議給每篇候選論文最多 15 分鐘做 triage。不要一開始就陷入公式、附錄和代碼。你要快速產出一個閱讀決策,而不是假裝已經讀懂。
第一步,看標題、摘要、引言末尾的 contribution list 和結論。寫下三個短句:它聲稱解決什麼問題;它聲稱新的地方在哪裡;它聲稱用什麼證據證明。只要這三句寫不出來,說明論文表達不清,或者你還缺背景,這篇暫時不適合精讀。
第二步,看主圖和主結果表。不要只看最高數字,要看列名、數據集、baseline、模型規模、推理預算和指標。若論文聲稱“更強推理能力”,但主表只報告一個容易被汙染的選擇題 benchmark;若論文聲稱“通用 agent 能力”,但只在幾個作者自建 demo 上測試;若論文聲稱“效率提升”,但沒有報告硬件、吞吐、延遲和質量損失,證據強度就要降級。
第三步,看 Related Work 和參考文獻。判斷論文是否知道自己站在哪裡。強論文通常能清楚地區分“已有工作已經解決了什麼”“本文真正改變了什麼”;弱論文常把相關工作寫成背景堆砌,或者只挑最方便比較的 baseline。
第四步,看可復現入口。有沒有代碼、數據、checkpoint、配置、訓練日誌、評測腳本、許可證和模型卡?NeurIPS checklist 說明,即使不強制所有論文開源代碼,也需要給出合理的可復現或可驗證路徑;對新算法、模型、數據集和實驗論文,這一路徑的形態會不同。讀者的判斷也應隨之變化:閉源不自動等於不值得讀,但閉源且實驗細節不足,通常不值得投入復現級精讀。
第一軸:問題重要性
問題重要性不是“題目大”,而是“這個問題是否真實限制了研究進展”。一個重要問題通常至少滿足下面三類條件之一。
第一,它卡住了一個高頻研究流程。例如長上下文模型能否在大量無關信息中穩定檢索證據,LLM-as-judge 是否有位置偏置和長度偏置,agent benchmark 是否可重複執行,偏好優化是否真的改善目標能力而不是優化評測器。這些問題不是某個論文自己的痛點,而是許多後續工作都必須面對的公共瓶頸。
第二,它改變了問題定義。很多好論文的貢獻不在於多加一個模塊,而在於重新定義任務、指標或實驗協議。LiveBench 在 ICLR 2025 中把 test set contamination 作為公平 LLM 評估的核心障礙之一,並採用頻繁更新問題、客觀 ground truth 和多任務覆蓋來降低汙染風險。你不一定要把它當成唯一 benchmark,但它提醒讀者:如果一個論文仍然只在老舊靜態 benchmark 上報告結果,它對“真實泛化能力”的證據可能不足。
第三,它能生成後續研究問題。NeurIPS 2026 ED track 指出,評測假設和報告實踐會塑造科學結論;這意味著一篇好的 evaluation 或 dataset 論文,價值不只是“給大家一個新榜單”,而是讓社區重新討論什麼可以被測量、什麼結論可以被支持。類似地,MLRC 2026 成為 NeurIPS 官方 track,也說明嚴謹復現、泛化測試、負結果和部分復現失敗正在獲得更正式的研究地位。
判斷問題重要性時可以用四個問題:
| 檢查項 | 高價值信號 | 低價值信號 |
|---|---|---|
| 真實瓶頸 | 多個方向反覆遇到,影響 claim 是否成立 | 只是為了讓一個模塊顯得必要 |
| 任務邊界 | 清楚說明輸入、輸出、約束和失敗條件 | 用大詞包裝很窄的實驗 |
| 社區複用 | 可能影響後續 benchmark、baseline、數據或方法 | 只能在作者設置中成立 |
| 選題潛力 | 能自然推出 follow-up、復現或負結果研究 | 讀完只能複述作者結論 |
一個實用規則是:如果你不能解釋“為什麼三個月後我還會關心這篇論文”,它通常不值得精讀。可以收藏、粗讀或放進 related work,但不要把它作為訓練營當天的主論文。
第二軸:方法新意
方法新意最容易被標題和命名誤導。AI 論文喜歡創造新縮寫、新 agent 框架、新 training recipe、新 benchmark 名稱,但新名字不等於新知識。NeurIPS 2026 reviewer guidelines 明確指出,originality 不必只來自全新方法,也可以來自新的洞察、對已有方法性質的揭示、效率或公平性改進、任務 / 指標 / framing 的創新。反過來,一個看起來復雜的新系統,如果只是把已有模塊換名組合,且沒有解釋為什麼這種組合會帶來新結果,新意就有限。
讀方法新意時,先把論文放進四個層次。
問題設定新意:論文是否提出了一個以前沒有被清楚形式化的問題?例如把“模型能回答問題”轉成“模型能否在汙染受限、客觀可評分、持續更新的問題中保持能力”;或者把“復現一篇論文”拆成可評分的子任務。PaperBench 在 2025 年提出讓 AI agents 從論文出發重建代碼和實驗,並把 20 篇 ICML 2024 Spotlight / Oral 論文的復現過程拆成 8,316 個可評分任務。對讀者來說,它的價值不只在一個分數,而在於把“復現研究能力”變成了可操作評測對象。
機制新意:論文是否改變了信息流、訓練目標、優化方式或推理過程?例如新的 verifier、retriever、planner、preference objective、routing 機制、memory 更新規則。這裡要警惕“模塊堆疊”:如果去掉名字後只剩常見組件串聯,就要看作者是否提供了充分機制解釋和消融。
證據新意:論文是否通過新的對照、負結果、誤差分析或 stress test 揭示了已有方法的性質?2025 年關於 data contamination detection 的 NAACL Findings 論文系統回顧了 50 篇汙染檢測研究,並指出多類檢測假設不一定在不同設置中成立;這類工作可能沒有提出更大的模型,卻能顯著影響我們如何解讀 benchmark 分數。
資源新意:論文是否發佈了可複用數據、代碼、評測腳本、rubric、日誌或模型權重?資源本身不是自動貢獻,NeurIPS ED track 對 benchmark 和 dataset 的要求強調:資源應說明它支持什麼 evaluative claim、依賴什麼假設、有什麼限制。一個數據集如果不能說明測量目標和限制,只是更大或更新,並不一定值得深讀。
方法新意可以用一個反事實問題檢驗:如果把論文裡的新名詞全部刪掉,只用通用術語描述,它還剩下什麼新的科學主張?如果答案是“一個可驗證的新假設”“一個更嚴謹的問題定義”“一個會改變結論的實驗設計”,值得繼續讀;如果答案只是“把 A、B、C 三個已有工具串起來”,就要把重點轉向證據強度,謹慎投入時間。
第三軸:證據強度
證據強度決定論文能不能支撐它的主張。對 AI 論文來說,證據通常包括主實驗、baseline、ablation、誤差分析、統計顯著性、人工評測、自動評測、代碼和復現材料。讀者不需要在 triage 階段複查所有細節,但必須識別紅旗。
第一,看 claim 與 metric 是否對齊。論文聲稱“更可靠”,但只報告平均準確率;聲稱“更安全”,但只測一個靜態 jailbreak 集;聲稱“更會科研”,但只展示幾個 cherry-picked case;這些都屬於證據與主張錯位。NeurIPS checklist 要求 abstract 和 introduction 中的主張與貢獻範圍、假設和限制一致,這可以直接變成讀者的檢查項。
第二,看 baseline 是否公平。公平不是“列了很多 baseline”,而是比較變量是否清楚。模型規模、訓練數據、prompt、context length、採樣次數、tool access、檢索語料、verifier、推理預算和硬件都可能影響結果。如果新方法多用了 test-time compute,卻把收益歸因於訓練目標;如果 baseline 沒調參,而本文方法調了大量超參;如果對閉源模型只用公開 API 默認設置,對自家模型使用定製 prompt,這些都會削弱證據。
第三,看 ablation 是否隔離機制。好的 ablation 回答“為什麼有效”,弱 ablation 只回答“刪掉模塊會變差”。例如一個 RAG 論文應該區分檢索器、reranker、context packing、prompt 和 generator 的作用;一個 agent 論文應該區分 planner、memory、tool validation 和 retry policy;一個 post-training 論文應該區分數據、獎勵 / 偏好目標、base model 和採樣策略。如果所有變化一次性出現,論文只能證明 recipe 有用,不能證明機制成立。
第四,看統計和可重複性。AAAI-26 reproducibility checklist 關注 seed、運行次數、硬件軟件環境、metric、統計顯著性和超參選擇;NeurIPS checklist 也要求說明實驗細節、error bars 或顯著性信息。對小幅提升,尤其是 0.x 個點的 benchmark 差異,如果沒有多 seed、方差或置信區間,就不要把它當成強結論。
第五,看汙染、選擇性報告和 judge 風險。2025 年 LiveBench、AntiLeakBench 以及 contamination detection survey 都說明,LLM 評測中的數據汙染不是邊角問題。AntiLeakBench 進一步強調,只是收集新數據不一定保證無汙染,因為新數據也可能含有模型預訓練中已見過的知識。讀論文時要問:測試集是否可能進入訓練語料?benchmark 是否已經被大量公開討論?是否只報告有利任務?LLM judge 的 prompt、模型版本和偏差是否有人工核驗?
四檔閱讀決策:Skip、Skim、Verify、Read Deeply
三軸判斷之後,不要只給一個“好 / 不好”的印象。建議把論文放入四檔。
Skip:問題不重要,方法只是包裝,證據明顯不足。跳過不等於否定作者,而是保護自己的研究時間。典型例子是:標題很大,實驗很窄;沒有明確任務;baseline 不可比;關鍵數據和評測設置缺失;與自己方向無關。
Skim:問題或材料有參考價值,但暫不值得深讀。適合用來補 related work、瞭解趨勢、記錄術語和參考文獻。例如一個新 benchmark 你暫時不用,但它整理了相關任務;一個方法論文證據一般,但引言把方向脈絡講得清楚。
Verify:論文可能重要,但關鍵 claim 需要核驗。比如結果依賴數據未汙染、閉源模型 API、LLM judge、複雜工程設置或高算力訓練。此時不要直接引用結論,可以先查 OpenReview、代碼 issue、復現報告、作者補充材料和社區討論。
Read Deeply:問題重要,方法或證據至少有一個維度明顯強,且與你的研究目標相關。進入這一檔的論文應產出結構化筆記:問題定義、核心假設、方法分解、主 claim、證據表、復現入口、侷限、可做 follow-up。
一個簡單經驗是:每天最多深讀 1 篇,核驗 2-3 篇,粗讀 5-10 篇,跳過大量論文。訓練營的價值不在於收藏數量,而在於每篇深讀論文都能變成復現計劃或選題素材。
代表資料路線圖:從審稿標準到 benchmark 論文
為了訓練判斷力,可以按下面路線讀一組“元論文”和官方材料。
| 類型 | 代表資料 | 讀它的目的 |
|---|---|---|
| 讀論文方法 | Keshav, How to Read a Paper, 2007 | 學三遍閱讀法和五個快速判斷問題 |
| 審稿標準 | ICLR 2026 Reviewer Guide;NeurIPS 2026 Reviewer Guidelines;ACL ARR Review Form | 把 problem、significance、originality、evidence、reproducibility 轉成讀者檢查表 |
| 可復現性 | NeurIPS Paper Checklist;AAAI-26 Reproducibility Checklist;Pineau et al. 2021 | 判斷實驗細節是否足以驗證 claim |
| 評測趨勢 | NeurIPS 2026 Evaluations & Datasets Track | 理解 benchmark、metric、audit、negative result 為什麼成為研究對象 |
| 汙染受限評測 | LiveBench, ICLR 2025;AntiLeakBench, ACL 2025;Fu et al., NAACL Findings 2025 | 訓練識別 benchmark contamination 和評測假設 |
| 復現能力評測 | PaperBench, OpenAI 2025;MLRC 2026 NeurIPS track | 把“論文是否可復現”變成具體任務、rubric 和日誌 |
這組資料的讀法不是逐篇背誦,而是抽取判斷維度。審稿標準告訴你什麼叫 contribution;checklist 告訴你什麼叫可驗證;benchmark 論文告訴你評測假設會怎樣改變結論;復現材料告訴你深讀最終要落到可執行實驗。
判斷矩陣與打分表
下面給出一個可直接放進閱讀筆記的打分表。每項 0-2 分,總分不是絕對排名,只用於決定閱讀深度。
| 維度 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 問題重要性 | 問題模糊或只服務包裝 | 有具體任務,但影響範圍有限 | 指向公共瓶頸或能改變研究問題 |
| 文獻定位 | 相關工作堆砌或遺漏明顯 | 基本覆蓋主線 | 清楚說明與關鍵工作的差異 |
| 方法新意 | 主要是換名或堆模塊 | 有局部機制或組合改進 | 新 framing、機制、目標或證據設計 |
| Claim 清晰度 | 主張過大或不可檢驗 | 有主張但邊界不清 | 主張具體、可測、有限定條件 |
| Baseline 公平性 | baseline 過弱或變量混雜 | 基本可比但細節不足 | 規模、數據、預算和協議清楚 |
| Ablation / 機制 | 沒有或只做表面刪除 | 有消融但解釋不足 | 能隔離關鍵變量和失敗條件 |
| 統計證據 | 單次結果,無方差 | 有部分方差或多任務驗證 | 多 seed、置信區間、顯著性或穩健性分析 |
| 可復現入口 | 無代碼 / 數據 / 配置,細節缺失 | 有部分材料 | 代碼、數據、配置、seed、日誌或 checkpoint 較完整 |
| 選題價值 | 難以推出後續問題 | 可作為背景材料 | 能自然形成復現、負結果或 follow-up |
建議閾值:
- 0-6 分:Skip,除非它是你導師指定或方向必讀。
- 7-10 分:Skim,記錄摘要、方法標籤和相關工作。
- 11-14 分:Verify,查附錄、代碼、OpenReview、復現報告。
- 15 分以上:Read Deeply,進入精讀和復現計劃。
不要機械相信總分。若論文在“問題重要性”或“證據強度”上為 0,即使其他項看起來不錯,也不應直接深讀。反過來,某些負結果、評測論文或理論論文可能沒有傳統 benchmark SOTA,但問題重要、證據嚴謹,仍然值得精讀。
復現前的最低核驗
當一篇論文進入 Verify 或 Read Deeply 檔,不要立刻開環境。先做最低核驗。
核驗 claim:把摘要裡的主 claim 改寫成 1-3 個可測試句子。例如“方法 X 在數據集 Y、指標 Z、同等推理預算下優於 baseline B”;或者“檢測方法 D 在分佈變化時不穩定”。不能改寫成可測試句子的 claim,不適合作為復現目標。
核驗數據:記錄數據集名稱、版本、split、許可證、下載入口、預處理、去重和是否可能汙染。對 LLM benchmark,尤其要檢查是否有動態更新、客觀答案、人工標註、LLM judge 或公開題庫洩漏風險。
核驗比較變量:列出 base model、參數量、訓練數據、上下文長度、採樣次數、工具權限、retriever、judge、硬件和預算。如果變量太多,先找最小可控實驗,不要試圖復現整篇。
核驗代碼狀態:檢查倉庫是否與論文版本對應,commit 是否標註,依賴是否固定,是否有運行命令、配置文件、checkpoint、日誌和評測腳本。若作者只給偽代碼,沒有代碼,也可以復現,但目標要改成“獨立實現一個最小 claim”,而不是“復現全部結果”。
核驗外部反饋:查 OpenReview 討論、issue、復現報告、後續引用和勘誤。ICLR author guide 說明 ICLR 2026 的評審、討論和修訂都通過 OpenReview 進行;對已經公開的會議論文,OpenReview 評論常能暴露 novelty、baseline、clarity 和 reproducibility 的爭議點。
最低核驗的產物應是一頁 reproduction pre-check,而不是一堆瀏覽器標籤。寫清楚:我準備復現哪個 claim,預計需要什麼數據和算力,最可能失敗在哪裡,失敗後如何判斷是論文問題、實現問題還是資源不足。
常見誤區
第一,把熱度當重要性。社交媒體熱度常偏向模型發佈、炫酷 demo 和大標題,但研究價值取決於問題、方法和證據是否能被後續工作使用。
第二,把 SOTA 當充分證據。SOTA 只在特定 benchmark 和設置下成立。若 benchmark 汙染、baseline 不公平或 judge 不可靠,最高分也不能自動支持論文的大 claim。
第三,把複雜度當新意。方法圖越複雜,越要還原成輸入、輸出、訓練目標和推理流程。複雜系統如果沒有隔離變量,只能說明 recipe 有效果,不能說明機制正確。
第四,只讀成功故事,不讀失敗和限制。NeurIPS 2026 reviewer guidelines 和 MLRC 2026 都明確給負結果和復現研究留出空間。對研究生來說,嚴謹的失敗分析往往比一個微小正結果更能產生選題。
第五,忽視計算成本。某些論文的問題重要、方法有趣,但復現成本超出你的訓練營預算。此時可以深讀方法和證據,但復現目標應縮小到一個最小 claim 或小規模 sanity check。
第六,被作者機構或會議標籤替代判斷。頂級機構和頂會接收能提高先驗,但不能替你檢查 claim、baseline、ablation 和可復現性。相反,小組、預印本或負結果論文也可能有高選題價值。
適合研究生繼續做的訓練題
從最近一個月 arXiv 或 OpenReview 中選 20 篇與你方向相關的論文,每篇只用 15 分鐘 triage,記錄 Skip / Skim / Verify / Read Deeply 決策和一句理由。
選 3 篇高熱度論文,用本文九項打分表評分。然後在一週後查它們的代碼、issue、OpenReview 或社區復現,檢查你的初判是否過於樂觀。
選一篇 benchmark 論文,寫出它測量的 construct、數據來源、汙染防護、指標、baseline、更新機制和限制說明。判斷它是否真的改變了你對領域進展的理解。
選一篇方法論文,把它的新意拆成問題設定、機制、證據、資源四類。若只能歸入“資源”或“系統組合”,進一步檢查證據是否足夠強。
選一篇你原本想跳過的負結果或復現論文,分析它為什麼可能有研究價值。嘗試從中提出一個小型 follow-up:換數據、換模型、換 metric、換假設或做邊界測試。
為自己的研究方向建立“必讀閾值”:哪些問題一齣現就值得深讀,哪些 benchmark 需要謹慎,哪些 baseline 必須出現,哪些復現材料缺失會直接降級。
總結
判斷一篇 AI 論文值不值得讀,不是憑感覺給論文貼標籤,而是把有限閱讀時間分配給最能訓練科研能力的對象。一個可靠判斷至少包含三問:問題是否重要,方法是否真的帶來新知識,證據是否足以支撐主張。
對研究生來說,最值得深讀的論文不一定是最火的,也不一定是分數最高的,而是能讓你學會一個清晰問題、一個可檢驗假設、一個嚴謹實驗設計或一個可執行 follow-up 的論文。把每次閱讀決策寫下來,持續校準自己的判斷,你會逐漸從“論文消費者”變成“研究問題構造者”。
參考資料
以下資料均於 2026-07-23 檢索。會議政策、審稿表、代碼倉庫狀態、benchmark 版本和模型結果可能變化,正式發佈前建議再次核驗。
- ICLR 2026 Reviewer Guide. https://iclr.cc/Conferences/2026/ReviewerGuide
- NeurIPS 2026 Reviewer Guidelines. https://neurips.cc/Conferences/2026/ReviewerGuidelines
- NeurIPS 2026 Evaluations & Datasets Reviewing Guidelines. https://neurips.cc/Conferences/2026/EvaluationsDatasetsReviewerGuidelines
- NeurIPS Paper Checklist Guidelines. https://neurips.cc/public/guides/PaperChecklist
- ACL Rolling Review Review Form. https://aclrollingreview.org/reviewform
- AAAI-26 Reproducibility Checklist. https://aaai.org/conference/aaai/aaai-26/reproducibility-checklist/
- NeurIPS Blog: Introducing the Evaluations & Datasets Track at NeurIPS 2026. https://blog.neurips.cc/2026/03/23/introducing-the-evaluations-datasets-track-at-neurips-2026/
- NeurIPS Blog: MLRC 2026: Reproducibility as an Official Track at NeurIPS. https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- Pineau et al. Improving Reproducibility in Machine Learning Research. JMLR 2021. https://www.jmlr.org/papers/v22/20-303.html
- Keshav, S. How to Read a Paper. ACM SIGCOMM Computer Communication Review, 2007. DOI: https://dl.acm.org/doi/10.1145/1273445.1273458
- White et al. LiveBench: A Challenging, Contamination-Limited LLM Benchmark. ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/e4a46394ba5378b3f9a186a5b4c650d1-Abstract-Conference.html
- Wu et al. AntiLeakBench: Preventing Data Contamination by Automatically Constructing Benchmarks with Updated Real-World Knowledge. ACL 2025. https://aclanthology.org/2025.acl-long.901/
- Fu et al. Does Data Contamination Detection Work (Well) for LLMs? A Survey and Evaluation on Detection Assumptions. NAACL Findings 2025. https://aclanthology.org/2025.findings-naacl.291/
- OpenReview: The Emperor's New Clothes in Benchmarking? A Rigorous Examination of Mitigation Strategies for LLM Benchmark Data Contamination. ICML 2025. https://openreview.net/forum?id=TuvDxubEfE
- OpenAI: PaperBench: Evaluating AI's Ability to Replicate AI Research. 2025. https://openai.com/index/paperbench/