日期:2026-07-22
適合讀者:AI、NLP、機器學習方向研究生;準備復現論文、寫讀書報告、做開題選題的科研新人;有工程背景但希望系統進入論文閱讀的技術讀者
檢索日期:2026-07-22
摘要
AI 論文越來越長,也越來越像一個壓縮包:摘要裡是結論,方法部分是算法假設,實驗表格是證據,附錄、代碼、OpenReview 討論和項目主頁才是很多關鍵細節。只把論文從頭讀到尾,往往會得到一種虛假的熟悉感:知道作者說了什麼,卻不知道它解決了什麼問題、證據是否足夠、自己能否復現、還能從哪裡繼續做。
這篇文章介紹“AI 論文精讀與復現訓練營”的基礎閱讀方法。它不盤點某個單一技術方向,而是給出一套適用於大多數 AI 方法論文的精讀流程:先用三遍閱讀法做時間管理,再把論文拆成問題、主張、方法、證據和復現入口,最後從實驗表格反推研究質量。讀完一篇論文的最低標準不是“我看懂了摘要”,而是能寫出一頁結構化筆記:這篇論文的核心假設是什麼,和 baseline 的公平比較在哪裡,最可能失敗的條件是什麼,我若復現應先驗證哪一個最小 claim。
目錄
- 為什麼精讀 AI 論文越來越難
- 三遍閱讀法:從過濾到重建
- 摘要與引言:先抓問題,不急著接受貢獻
- 方法部分:把論文還原成任務、假設、模塊和目標函數
- 實驗表格:dataset、metric、baseline、ablation 和統計證據
- 代表論文路線圖:怎樣選擇訓練樣本
- 精讀檢查清單
- 復現建議:從最小 claim 開始
- 常見誤區
- 適合研究生繼續做的訓練題
- 總結
- 參考資料
為什麼精讀 AI 論文越來越難
早期機器學習論文通常圍繞一個清晰算法展開:問題定義、模型、優化、實驗。如果讀者理解了模型結構和損失函數,基本就掌握了論文主體。今天的 AI 論文複雜得多。一篇 LLM、agent、multimodal 或 reasoning model 論文,可能同時包含預訓練數據、後訓練策略、提示模板、採樣參數、benchmark 選擇、人工評測、LLM-as-judge、代碼倉庫、模型卡、附錄中的失敗案例,以及發佈後不斷更新的項目主頁。
這帶來三個變化。
第一,論文正文不再包含全部可復現信息。ICLR 2026 作者指南仍強調 reproducibility statement,要求作者說明主文、附錄和補充材料中哪些部分支持復現;AAAI-26 reproducibility checklist 則明確詢問偽代碼、數據處理、代碼、seed、算力、軟件環境、metric、運行次數和統計顯著性等細節。讀者如果只讀 PDF 主文,很容易漏掉真正決定實驗是否可信的材料。
第二,實驗表格的解釋成本上升。大模型論文常同時比較模型規模、訓練數據、推理預算、prompt、工具、檢索器和 evaluator。一個表格裡的高分可能來自方法本身,也可能來自更強 base model、更長 context、更大的採樣預算、更寬鬆的 judge 或數據汙染。2025 年關於 AI benchmark 的綜述把數據質量、contamination、construct validity、gaming、選擇性報告等問題列為評測信任的核心風險。讀實驗表格時,讀者必須先問“這個 benchmark 真在測論文聲稱的能力嗎”。
第三,AI 輔助讀論文變得常見,但也更需要人工校驗。OpenScholar、PaperQA2 等科學文獻 RAG 系統說明,檢索增強模型可以幫助研究者查找和綜合論文;OpenScholar 的 Nature 論文和官方倉庫也強調 citation-backed synthesis、開放 datastore 和 ScholarQABench。它們適合做線索發現和交叉核對,但不應替代精讀。尤其當系統自動生成綜述、引用和結論時,讀者更要回到原文檢查 claim、證據和上下文。
三遍閱讀法:從過濾到重建
S. Keshav 在 2007 年的短文 How to Read a Paper 中提出三遍閱讀法。它的價值不是“快速閱讀技巧”,而是把閱讀目標分層:第一遍決定是否繼續,第二遍理解內容,第三遍像要復現一樣重建論文。AI 論文精讀可以沿用這個框架,但需要把第三遍擴展到代碼、數據、評測和復現實驗。
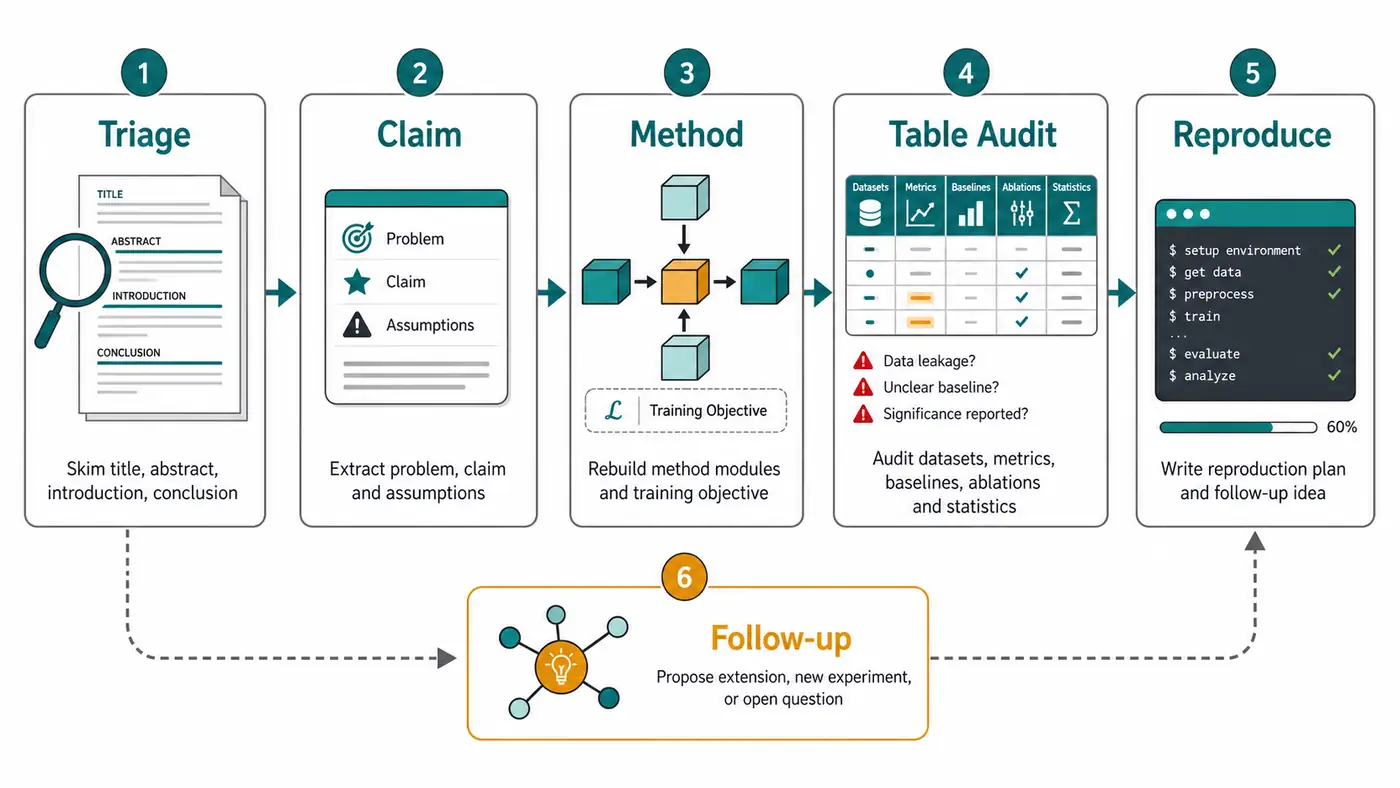
第一遍:10 分鐘過濾。 只看標題、摘要、引言、圖表標題、結論和參考文獻列表。目標是回答五個問題:它研究什麼任務?核心 claim 是什麼?相對已有工作的差異是什麼?用了哪些主要證據?我為什麼需要讀它?如果這五個問題答不上來,不要急著進入公式和實現。
第二遍:60-90 分鐘理解。 讀主文、關鍵圖、方法框架、實驗設置和主要表格,但暫時跳過複雜證明、長附錄和實現細節。目標是能用自己的話講出論文:輸入輸出是什麼,模型或算法改了哪裡,訓練目標是什麼,實驗如何支持 claim,作者承認了哪些侷限。
第三遍:半天到一天重建。 把論文當成你要復現、審稿或繼續擴展的對象。重畫方法圖,列出所有假設,檢查公式維度和訓練流程,打開代碼倉庫,找數據下載方式、配置文件、checkpoint、seed 和日誌。第三遍結束時,應產出一份 reproduction note,而不是一堆劃線的 PDF。
這三遍不一定連續完成。對“只需瞭解”的論文,第一遍加第二遍就夠;對你要復現、引用、投稿 rebuttal 或做 follow-up 的論文,第三遍才是精讀的核心。
摘要與引言:先抓問題,不急著接受貢獻
摘要通常壓縮了四類信息:問題背景、方法主張、實驗結論和意義包裝。讀摘要時不要逐句翻譯,而要把它改寫成四個字段。
第一是問題:論文試圖解決哪個具體任務或瓶頸?例如是提升數學推理、減少幻覺、改進長上下文檢索,還是提高模型壓縮後的性能?問題越具體,後面的證據越容易判斷。
第二是主張:作者聲稱自己的方法帶來了什麼變化?主張可以是性能提升、數據效率、可解釋性、魯棒性、可復現性、理論保證或新的 benchmark。這裡要把“方法名稱”與“科學 claim”分開。一個新模塊本身不是貢獻,除非它改變了某個可觀察結果。
第三是比較對象:作者把自己和誰比?如果摘要只說“outperforms strong baselines”,但沒有說明 baseline 類型、模型規模、數據和評測設置,就應在筆記裡標記為待核驗。
第四是證據形式:證據來自標準 benchmark、人工評測、消融、理論證明、案例分析,還是部署日誌?不同證據支撐不同結論。一個 leaderboard 分數只能說明在該數據集和評測協議下表現更好,不能自動推出“模型更會推理”。
引言部分要重點看動機鏈條是否成立。一個好的引言通常會從真實瓶頸出發,指出已有方法為什麼不夠,再提出本文的關鍵假設。一個弱引言常見的問題是:把“已有方法沒有用某個模塊”當成缺口,把“我們可以加入某個技巧”當成研究問題,或者用過大的願景掩蓋很窄的實驗設置。精讀時可以在引言旁寫一句反問:如果這篇論文的方法失敗,最可能是哪個假設錯了?
方法部分:把論文還原成任務、假設、模塊和目標函數
AI 方法論文的閱讀,不應從“模型看起來很複雜”開始,而應從任務定義開始。
第一步是寫出輸入、輸出和訓練信號。輸入是 prompt、圖像、文檔、工具狀態、歷史軌跡還是檢索結果?輸出是 token、action、embedding、reward、代碼補丁還是分類標籤?訓練信號來自人工標籤、偏好數據、自監督、環境反饋、verifier、合成數據還是蒸餾教師?如果輸入輸出說不清,後面所有模塊圖都只是裝飾。
第二步是拆模塊。把方法圖裡的每個模塊改寫成一句“它接收什麼,產生什麼,為什麼需要”。例如檢索器負責候選證據,reranker 負責排序,generator 負責生成,verifier 負責判分,memory 負責跨輪狀態。不要被作者命名迷惑:很多新名詞只是已有模塊的新組合。真正值得關注的是模塊之間的信息流和訓練目標是否改變。
第三步是定位目標函數。對 LLM 論文來說,關鍵不只是網絡結構,還包括 SFT、preference optimization、RLVR、distillation、contrastive learning、next-token loss、auxiliary loss 或 inference-time search。讀公式時至少檢查四件事:優化變量是什麼,梯度流過哪些模塊,哪些項只在訓練時存在,推理時是否還需要額外模型或工具。
第四步是列假設。每個方法都依賴隱含前提:檢索結果足夠相關,LLM judge 足夠可靠,合成數據分佈接近真實任務,base model 已有潛在能力,verifier 不容易被投機利用,ablation 能隔離變量。精讀不是把這些假設全盤否定,而是知道它們在哪裡。
第五步是重畫最小算法。不要照抄論文圖,而是用自己的符號寫出偽代碼:初始化什麼,循環什麼,調用哪些模型,保存哪些中間變量,最終用什麼指標評估。若論文沒有提供足夠細節,這就是復現風險,而不是讀者能力不足。
實驗表格:dataset、metric、baseline、ablation 和統計證據
實驗部分是 AI 論文最容易“看懂但誤讀”的部分。讀表格時建議按五層檢查。
第一層是 dataset。數據集版本、劃分、過濾、去重、語言、領域和洩漏風險都要記錄。很多論文引用同一個 benchmark 名稱,但實際使用的是不同 split、不同 prompt、不同 few-shot 示例或不同後處理。若論文沒有說明數據版本,應標記為待人工核驗。
第二層是 metric。accuracy、F1、BLEU、ROUGE、pass@k、win rate、judge score、human preference、success rate 測的不是同一種能力。尤其在生成任務中,metric 往往只覆蓋輸出的一部分屬性。讀表格時應問:這個指標是否直接對應摘要裡的 claim?有沒有報告方差、置信區間或多 seed?
第三層是 baseline。公平 baseline 至少要在模型規模、訓練數據、推理預算、檢索語料、工具權限和評測協議上可比。若新方法使用更強 base model 或更多 test-time compute,卻把提升歸因於某個小模塊,就要謹慎。
第四層是 ablation。消融不是把模塊一個個刪掉那麼簡單,而是要隔離變量。好的 ablation 應能回答“提升來自哪裡”;弱 ablation 只證明“刪掉東西會變差”。如果論文沒有報告負結果、失敗案例或對照實驗,讀者應降低對機制解釋的信任。
第五層是統計證據。AAAI reproducibility checklist 明確要求作者說明運行次數、隨機性、顯著性檢驗和結果分佈。AI 論文中小幅提升很常見,如果沒有多 seed、標準差或統計檢驗,0.2-0.5 個點的差異可能只是噪聲。對 LLM-as-judge 結果,還要檢查 judge prompt、模型版本、位置偏置、長度偏置和人工一致性。
可以把每個主結果表改寫成下面這張讀表模板。
| 檢查項 | 要記錄的問題 | 風險信號 |
|---|---|---|
| Dataset | 名稱、版本、split、過濾、去重、是否公開 | 只寫 benchmark 名,不寫版本和處理 |
| Metric | 指標定義、計算腳本、是否與 claim 對齊 | 用總體分數替代多維能力 |
| Baseline | 模型規模、數據、推理預算、工具權限 | baseline 過舊或設置更弱 |
| Ablation | 是否隔離變量,是否報告負結果 | 只刪模塊,不解釋機制 |
| Statistics | seed、運行次數、方差、顯著性 | 只報單次最好結果 |
| Reproducibility | 代碼、配置、checkpoint、日誌 | 代碼未發佈或與論文不匹配 |
代表論文路線圖:怎樣選擇訓練樣本
訓練精讀能力,最好不要隨機抓論文,而要構造“樣本梯度”。
基礎方法樣本。 從 Transformer、BERT、GPT、InstructGPT、DPO、LoRA、RAG 等經典論文中選 3-5 篇。它們適合練習任務定義、結構圖、目標函數和歷史位置。不要追求一次讀完所有經典,而要每篇產出一頁結構化筆記。
現代系統樣本。 選擇 DeepSeek-R1 技術報告、OpenScholar / ScholarQABench、PaperQA2、現代 agent 或 multimodal system paper。它們適合訓練“論文正文之外”的閱讀:技術報告、代碼倉庫、模型卡、數據說明、評測腳本和復現研究。2025 年 DeepSeek-R1 之後出現大量 replication studies,相關綜述說明當原始實現細節不完全公開時,社區會通過 SFT、RLVR、數據構造和訓練流程重建關鍵能力。這類論文很適合學習“復現不等於照跑代碼,而是檢驗 claim 的邊界”。
評測與復現樣本。 選擇 RewardBench、HarmBench、JailbreakBench、ScholarQABench、SciFact、AI benchmark meta-review、MLRC 復現論文等。它們適合訓練讀實驗:benchmark 的構造假設是什麼,標註者是誰,任務是否代表真實能力,leaderboard 是否可能被汙染。
開放評審樣本。 ICLR、TMLR、NeurIPS 部分論文有 OpenReview 討論。OpenReview 官方說明其平臺支持開放同行評審、開放討論和 API。讀公開 review 的價值在於看到審稿人如何質疑 novelty、evidence、baseline、clarity 和 reproducibility。對研究生來說,一篇論文的 OpenReview 頁面常常比一篇二手博客更能訓練判斷力。
精讀檢查清單
讀完一篇 AI 論文後,至少應能填完這份清單。
一句話總結:這篇論文解決什麼問題,用什麼核心方法,在哪些證據上支持了什麼 claim?
問題重要性:這個問題是否真實存在?是能力瓶頸、效率瓶頸、安全瓶頸、評測瓶頸,還是隻是 benchmark 上的局部優化?
方法新意:新意來自任務設定、模型結構、訓練目標、數據構造、推理策略、評測協議,還是系統集成?
關鍵假設:作者默認了哪些條件?這些條件在真實任務、不同模型規模、不同語言或不同數據分佈下是否仍成立?
證據強度:主實驗、消融、誤差分析、統計檢驗、人工評測和復現實驗是否共同支持摘要裡的 claim?
復現入口:代碼是否公開?依賴是否固定?數據是否可下載?是否有 checkpoint、配置、seed、訓練日誌和評測腳本?
失敗邊界:論文在哪些樣例、任務、規模、語言、硬件或數據條件下可能失敗?作者是否報告了這些失敗?
可延展問題:如果你要做 follow-up,應該改方法、改數據、改 benchmark、改理論解釋,還是做負結果復現?
復現建議:從最小 claim 開始
新手復現論文最常見的問題是目標過大:一上來想復現整篇論文所有表格。更可靠的路線是選擇一個最小 claim。
最小 claim 應滿足三個條件:它是論文核心結論的一部分;它有明確輸入、輸出和指標;它能在你的算力預算內完成。比如“某個 reranker 能提升文獻檢索引用準確性”“某個訓練目標在一個公開數學數據集上優於 SFT”“某個 ablation 刪除 memory 後性能下降”都可能是最小 claim。相反,“復現某閉源模型全部能力”通常不是合適目標。
復現前先建立環境矩陣:Python、CUDA、PyTorch、transformers、vLLM、數據下載腳本、checkpoint 版本、隨機 seed、GPU 型號和顯存。然後跑作者提供的最小 demo,確認代碼能執行;再跑一個小規模樣本,確認數據處理和 metric 計算一致;最後才擴展到論文表格。
記錄日誌時要保留失敗。MLRC 2026 成為 NeurIPS 官方 track 的消息說明,復現、複製、泛化測試、負結果和部分失敗正在被更正式地視為科學貢獻。復現報告不只寫“我跑出來了”,更要寫“我沒跑出來的地方是什麼,可能原因是什麼,論文 claim 在什麼條件下成立”。
常見誤區
第一,把摘要當結論。摘要是作者的最強表述,不是獨立證據。所有摘要 claim 都要回到表格、圖、附錄和代碼核對。
第二,只看方法圖。方法圖通常經過美化,隱藏了數據過濾、prompt、超參和失敗分支。真正的算法在偽代碼、訓練腳本和配置文件裡。
第三,把 benchmark 分數當能力證明。benchmark 是測量工具,不是能力本身。尤其對 2025-2026 年大模型論文,數據汙染、選擇性報告和 evaluator 偏差都必須檢查。
第四,只讀接受論文,不讀 review。公開評審能暴露論文的爭議點。即使論文最終被接收,review 中的弱點也可能是你做 follow-up 的入口。
第五,過度依賴 AI 總結。AI 工具可以幫你找論文、抽取引用、生成問題列表,但不能替你判斷實驗是否公平。對每個關鍵 claim,都應回到原文和一手鍊接。
第六,讀完沒有產物。沒有筆記、表格、偽代碼和復現計劃的閱讀,很快會退化成“感覺看過”。科研訓練的目標是把閱讀轉成可複用資產。
適合研究生繼續做的訓練題
選一篇近一年 LLM 方法論文,用三遍閱讀法寫 800 字結構化精讀筆記,只允許引用論文主文和附錄,不使用二手博客。
選一張主結果表,重建 dataset、metric、baseline、ablation 和統計證據清單。把每個不清楚的點標記為“已核驗 / 待核驗 / 不可核驗”。
選一篇有 OpenReview 討論的 ICLR 論文,把 reviewer 的主要質疑分類為 novelty、evidence、clarity、baseline、reproducibility 或 ethics。
選一篇開源論文,只復現一個最小 claim。要求提交命令、環境、seed、日誌、結果表和失敗分析。
選一篇 AI 輔助文獻綜述或 scientific RAG 論文,檢查它的 citation accuracy 評測方式,並人工抽查 10 條引用是否真的支持對應句子。
用 10 篇論文建立一個小領域地圖:每篇只寫問題、方法、證據、侷限和一個可能 follow-up。訓練目標不是“收集論文”,而是形成問題空間。
總結
精讀 AI 論文不是線性閱讀,而是證據審計。第一遍判斷值不值得繼續,第二遍理解主張和方法,第三遍像復現者一樣重建。摘要告訴你作者想讓你相信什麼;方法部分告訴你這個信念依賴哪些假設;實驗表格告訴你證據是否足夠;代碼、數據、附錄和公開評審告訴你這個 claim 能否被別人重新檢查。
對研究生來說,論文精讀能力本質上是研究能力的前置訓練。你不是為了記住更多模型名稱,而是為了形成判斷:什麼問題重要,什麼方法只是包裝,什麼實驗真的有說服力,什麼失敗值得繼續追。後續文章會把這套框架繼續展開到 Related Work 地圖、方法拆解、實驗閱讀、benchmark 陷阱、LLM 論文復現、ablation study 和 proposal 形成。
參考資料
檢索日期:2026-07-22。以下優先列出論文、官方指南、官方項目頁、arXiv / OpenReview / conference 頁面和開源倉庫。論文版本、代碼倉庫狀態、benchmark 數據、模型名稱、會議政策和評測結論可能變化,出版前建議再次人工核驗。
- S. Keshav, How to Read a Paper, ACM SIGCOMM Computer Communication Review, 2007. https://doi.org/10.1145/1273445.1273458
- ICLR, ICLR 2026 Author Guide, official conference guide, 2026. https://iclr.cc/Conferences/2026/AuthorGuide
- ICLR, ICLR 2026 Reviewer Guide, official conference guide, 2026. https://iclr.cc/Conferences/2026/ReviewerGuide
- AAAI, AAAI-26 Reproducibility Checklist, official author kit, 2025-2026. https://aaai.org/conference/aaai/aaai-26/reproducibility-checklist/
- NeurIPS Blog, MLRC 2026: Reproducibility as an Official Track at NeurIPS, official blog, 2026. https://blog.neurips.cc/2026/05/04/mlrc-2026-reproducibility-as-an-official-track-at-neurips/
- ML Reproducibility Challenge, MLRC 2026, official site, 2026. https://reproml.org/
- OpenReview, About OpenReview, official platform page. https://openreview.net/about
- Papers With Code, About Papers With Code, official page. https://cs.paperswithcode.com/about
- ACL Anthology, Anthology Identifiers, official documentation. https://aclanthology.org/info/ids/
- Asai et al., OpenScholar: Synthesizing Scientific Literature with Retrieval-Augmented Language Models, arXiv 2411.14199 / Nature 2026. https://arxiv.org/abs/2411.14199
- Asai et al., Synthesizing scientific literature with retrieval-augmented language models, Nature, 2026. https://www.nature.com/articles/s41586-025-10072-4
- AkariAsai / OpenScholar, official implementation repository, GitHub. https://github.com/akariasai/openscholar
- Future House, PaperQA2 repository, GitHub. https://github.com/Future-House/paper-qa
- Future House, Journey to superhuman performance on scientific tasks, official research blog, 2024. https://www.futurehouse.org/research/engineering-blog-journey-to-superhuman-performance-on-scientific-tasks
- Wadden et al., Fact or Fiction: Verifying Scientific Claims, EMNLP 2020 / arXiv 2004.14974. https://arxiv.org/abs/2004.14974
- allenai / scifact, SciFact data and models, GitHub. https://github.com/allenai/scifact
- Lo et al., S2ORC: The Semantic Scholar Open Research Corpus, ACL 2020 / official repository. https://github.com/allenai/s2orc
- Semantic Scholar, Open Data FAQ, official page. https://www.semanticscholar.org/faq/open-data
- Eriksson et al., Can We Trust AI Benchmarks? An Interdisciplinary Review of Current Issues in AI Evaluation, arXiv 2502.06559, 2025. https://arxiv.org/abs/2502.06559
- Zhang et al., 100 Days After DeepSeek-R1: A Survey on Replication Studies and More Directions for Reasoning Language Models, arXiv 2505.00551, 2025. https://arxiv.org/abs/2505.00551