日期:2026-07-31
適合讀者:研究生、科研新人、有工程背景的 AI 讀者
關鍵詞:follow-up idea、research proposal、論文侷限、可證偽假設、最小實驗
摘要
很多研究生讀完一篇好論文後,會停在兩個極端:要麼覺得作者已經把問題做完了,自己只能複述;要麼受到啟發,馬上想做一個很大的系統,把數據、模型、訓練目標、評測和應用場景都改一遍。前者沒有形成問題,後者很難執行。真正適合作為科研訓練的 follow-up idea,通常不是“再做一篇更大的論文”,而是一個小而可靠的研究問題:它來自原論文未解決的侷限,有清晰假設,能用有限計算和數據驗證,並且無論正結果還是負結果都能帶來信息。
這一篇討論如何把論文裡的 limitation、failure case、ablation 空白、benchmark 偏差和機制解釋不足,轉化為可執行的選題。2024-2026 年,圍繞 AI research ideation、idea evaluation、scientific forecasting 和 AI-assisted research 的論文迅速增加:從大規模人類研究檢驗 LLM 是否能產生新 idea,到 Chain-of-Ideas、GraphEval、AAAR-1.0、PreScience、Future-Aligned Proposal 等工作,都在提醒我們:idea 不是靈感閃現,而是一種可以被拆解、評估和訓練的科研能力。
本文的核心結論很簡單:一個好的 follow-up idea 至少要同時通過五個檢查:問題來自真實缺口,假設可證偽,實驗能在兩到四周內跑通,證據能區分多個解釋,失敗時仍能寫出有價值的分析。
目錄
- 為什麼 follow-up idea 比“大方向”更適合訓練
- 從論文侷限到研究問題:五類入口
- 小而可靠的 idea 應該長什麼樣
- 代表論文路線圖:AI 如何輔助科研構思
- 關鍵論文精讀:把 idea 當成可評估對象
- 方法/實驗對比表
- 最小復現實驗與 proposal 模板
- 常見誤區
- 適合研究生繼續做的選題
- 參考資料
為什麼這個主題重要
科研新人最容易低估的能力,不是讀論文,也不是跑代碼,而是“把一個模糊啟發壓縮成一個可執行問題”。讀論文時你會看到很多可能方向:作者說未來要擴展到多語言、長上下文、更多模態、更大模型、更真實環境、更強 benchmark;審稿意見裡會說 baseline 不夠、統計不充分、消融不足、數據集太窄;復現時你會發現代碼缺參數、結果對 seed 敏感、某個模塊實際沒貢獻。這些都可能成為 follow-up,但大多數還不是研究問題。
原因在於,研究問題必須能被證據支持或推翻。比如“讓 agent 更可靠”太大;“在 WebArena 類任務中,引入額外 verifier 是否能減少工具調用後的狀態誤讀”才接近一個問題。前者無法決定數據、baseline 和 metric,後者可以設計最小實驗:固定 agent 框架,比較 no-verifier、rule-verifier、LLM-verifier,分析失敗類型和額外 token 成本。
對研究生來說,follow-up idea 的價值不只是發論文。它更像一套訓練裝置:
- 訓練你判斷一篇論文的核心 claim 到底是什麼。
- 訓練你把 limitation 寫成假設,而不是寫成願望。
- 訓練你在資源有限時設計最小實驗。
- 訓練你面對負結果時仍然提煉機制和邊界條件。
- 訓練你把“讀過十篇論文”變成“知道下一步該測什麼”。
2026 年的科研環境也讓這件事更重要。ICLR 2026 作者指南要求如果 LLM 在研究構思或寫作中起到重要作用,作者需要說明其具體角色,並強調作者仍對內容、事實和科研誠信負責。換句話說,AI 可以幫你發散 idea、檢索文獻、檢查 novelty,但不能替你承擔研究判斷。一個成熟研究者必須能回答:這個 idea 為什麼值得做,最小證據是什麼,風險在哪裡,失敗後學到什麼。
從論文侷限到研究問題:五類入口
1. 明示 limitation:作者自己承認的邊界
論文的 limitation section 是最直接的入口,但不要照抄“未來工作”。作者寫“只在英文數據上評估”,並不等於你的 follow-up 就是“擴展到中文”。你要繼續追問:跨語言後哪個機制可能失效?是 tokenizer、訓練數據、文化常識、檢索庫覆蓋率,還是 evaluation rubric?如果不能指出機制,擴展數據集往往只是工程補充。
一個更好的寫法是:原方法在英文 instruction-following 上依賴高質量人工偏好數據;假設遷移到低資源語言時,偏好模型更容易獎勵流暢性而不是事實正確性;最小實驗是在兩個語言子集上固定模型和任務,比較偏好評分與人工 factuality 標註的一致性。
2. Failure case:錯誤樣例裡的規律
很多論文會展示失敗案例,但讀者常常只把它當成附錄。真正有用的做法是把 failure case 重新編碼:錯誤發生在長輸入、稀有實體、多跳推理、工具返回衝突、視覺遮擋、分佈外格式,還是 benchmark 指令歧義?如果你能把錯誤分成三到五類,並找到其中一類穩定出現,就已經接近 follow-up。
注意,failure case 不是“挑一個失敗例子講故事”。你至少要驗證它不是偶然樣本。可以抽取 50-100 個錯誤樣例,手動標註錯誤類型,或用模型輔助標註後人工複核。小規模但清楚的錯誤分類,常常比盲目跑一個更大 benchmark 更有研究價值。
3. Ablation 空白:該測但沒測的變量
上一篇講過 ablation study。對 follow-up 來說,最常見機會來自“論文聲稱 A 有用,但沒有排除 B 的解釋”。比如作者引入複雜 planner 後性能提升,但沒有控制 test-time token 預算;引入新數據合成流程後提升,但沒有和同等規模隨機採樣數據比較;提出 memory 模塊後變好,但沒有檢查模型是否只是從更長上下文獲益。
這類 follow-up 的優點是小而硬:你不需要提出全新系統,只需要設計一個更公平的對照,驗證原 claim 的邊界。缺點是要非常嚴謹,否則容易變成“復現實驗沒跑齊”。你的目標不是拆臺,而是回答一個可重複的問題:在控制變量後,原方法的哪一部分仍然成立?
4. Benchmark 偏差:任務定義和指標不匹配
AI 論文裡很多爭議來自 benchmark。一個方法可能在 leaderboard 上提升,但提升來自數據洩漏、格式適配、prompt tuning、judge 偏差、長答案偏好或測試集過窄。follow-up 可以從 benchmark 的測量對象入手:當前指標到底測的是能力、風格、成本,還是對數據集分佈的適配?
例如,開放式評測中 LLM-as-a-judge 可能偏好更長、更自信或更像參考答案的輸出。一個小 follow-up 可以固定候選答案內容,系統擾動長度、語氣和引用格式,測試 judge 排名是否變化。這樣的研究不一定需要訓練模型,但能直接影響後續論文的證據質量。
5. 機制解釋不足:分數上漲但原因不明
很多方法論文會給出直覺:檢索增強減少幻覺,process supervision 改善推理,self-consistency 提升可靠性,tool use 擴展能力邊界。但直覺不是機制。follow-up 可以把“為什麼有效”變成可測信號:檢索是否提高了證據覆蓋率?process supervision 是否減少中間步驟錯誤?self-consistency 是否只是在多數投票裡過濾隨機噪聲?工具調用是否真的解決了知識缺口,還是隻是提供了更長上下文?
機制型 follow-up 通常更適合研究訓練,因為它不依賴大規模 compute,而依賴實驗設計。你可以用小模型、小數據、小任務做清楚的診斷,只要問題定義足夠鋒利。
小而可靠的 idea 應該長什麼樣
一個可執行 follow-up idea 可以寫成一句話:
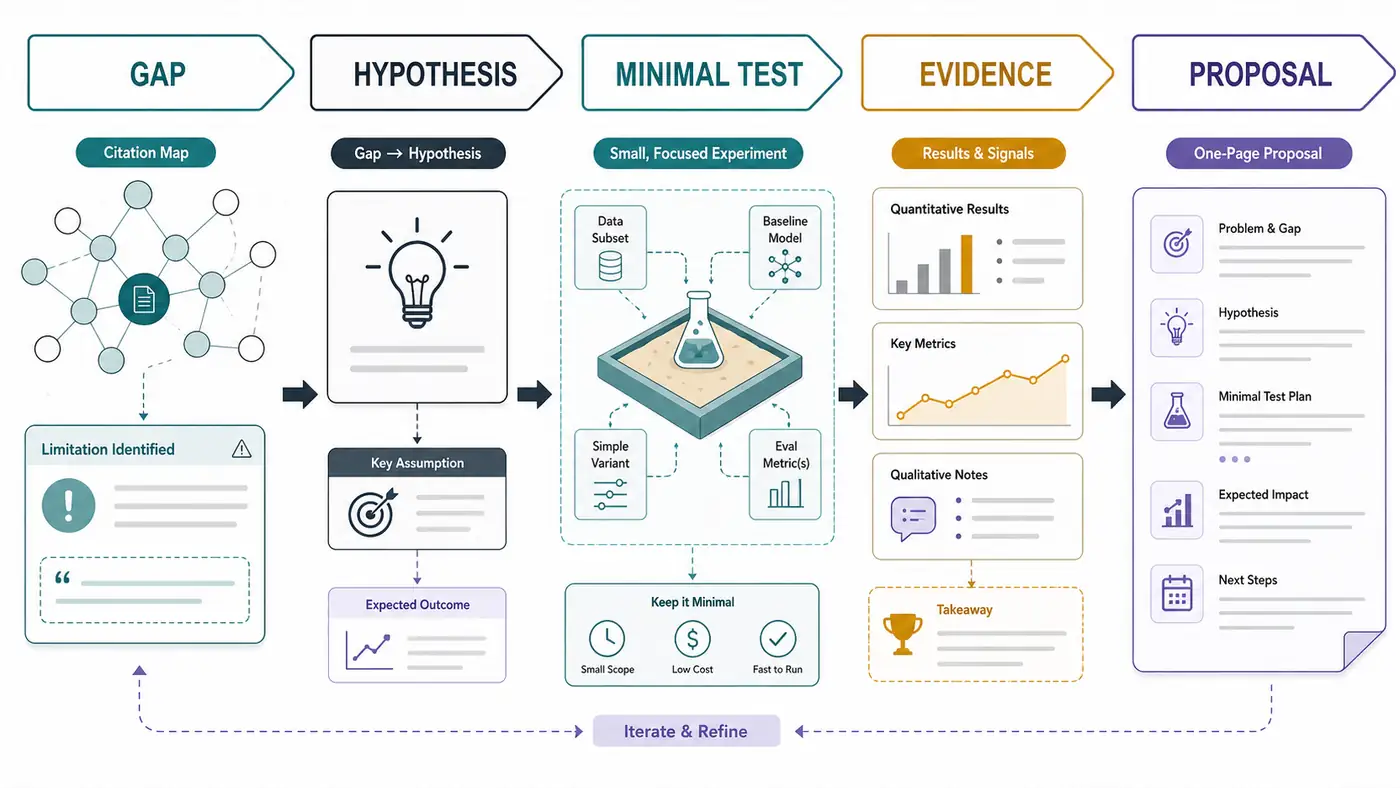
針對論文 P 中 claim C 在條件 S 下證據不足的問題,我假設機制 M 是關鍵瓶頸;在固定 A、B、C 變量後,通過最小實驗 E 比較 baseline 和 variant,並用指標 Y 與診斷信號 Z 判斷假設是否成立。
這句話裡有六個要素:
- 來源:idea 來自哪篇論文、哪張表、哪個失敗樣例或哪條審稿意見。
- 缺口:原論文證據缺了什麼,不是泛泛說“還有提升空間”。
- 假設:你相信什麼機制導致問題,且這個機制可能被推翻。
- 最小實驗:兩到四周內可以完成的實驗,不依賴未知資源。
- 判據:成功和失敗分別意味著什麼。
- 退出條件:如果跑不出預期,怎樣判斷是實現問題、假設問題還是數據問題。
這裡的“小”不是指沒有野心,而是指變量少。一個可靠的 follow-up 最好只改變一個主變量,最多帶一個輔助變量。比如:
| 不可靠寫法 | 更可靠寫法 |
|---|---|
| 做一個更強的 RAG agent | 固定生成器和檢索庫,只比較 reranker 是否改善衝突證據場景下的 factuality |
| 把方法擴展到多模態 | 先測原方法在視覺遮擋、OCR 噪聲、跨圖指代三類失敗上的退化曲線 |
| 用強化學習提升推理 | 先驗證 process reward 是否比 outcome reward 更能定位中間步驟錯誤 |
| 設計新 benchmark | 先構造 200 個反事實樣例,證明現有 benchmark 無法區分兩類能力 |
| 用 AI 自動生成研究 idea | 先評估生成 idea 的 novelty、feasibility 和 expected effectiveness 是否能被專家穩定區分 |
一個實用標準是“最小可發表單元”。它不一定能獨立成為頂會長文,但應該可以成為 workshop paper、reproduction report、短博客、附錄實驗或 proposal 的核心。更重要的是,它應該能讓你學到某個確定結論:原 claim 的邊界、某個機制的證據、某個 benchmark 的缺陷,或某類負結果的解釋。
代表論文路線圖:AI 如何輔助科研構思
近兩年關於科研構思的論文越來越多,它們本身也提供了 follow-up 訓練的參照系。可以按四條線閱讀:
| 方向 | 代表資料 | 關注問題 | 對研究生的啟發 |
|---|---|---|---|
| 人類 vs LLM idea generation | Can LLMs Generate Novel Research Ideas?(arXiv 2024) | LLM 生成 idea 是否新穎、可行、多樣 | 不要把 novelty 和 feasibility 混為一談 |
| 文獻結構化生成 | Chain of Ideas(arXiv 2024) | 用文獻發展鏈幫助 LLM 構思 | idea 應來自研究脈絡,而不是孤立 prompt |
| 研究任務 benchmark | AAAR-1.0(arXiv 2024,2025 修訂;ICML 2025 註釋見 arXiv) | 方程判斷、實驗設計、論文弱點評估、review critique | 實驗設計和找弱點本身可以被評估 |
| idea evaluation | GraphEval(arXiv 2025)、Literature-Grounded Novelty Assessment(arXiv 2025) | 如何評估 idea 質量和 novelty | novelty 需要文獻證據,不能只靠模型自評 |
| empirical outcome prediction | Predicting Empirical AI Research Outcomes with Language Models(NeurIPS 2025) | 預測兩個研究 idea 哪個會在 benchmark 上更好 | idea 可行性可以轉化為“可預測結果”的問題 |
| scientific forecasting | PreScience(arXiv 2026)、Future-Aligned Research Proposals(arXiv 2026) | 用時間切片預測未來論文貢獻 | 好 proposal 應能連接已有證據和未來發展 |
| 自動化科研流水線 | The AI Scientist / Towards end-to-end automation of AI research(Nature 2026) | 從 idea 到實驗、論文、評審的端到端自動化 | 自動化能放大效率,也會放大錯誤假設 |
這條路線的共同點是:它們都不再把 research idea 當作無法分析的靈感,而是把它拆成 novelty、feasibility、significance、expected effectiveness、experimental design、weakness detection 和 future alignment 等可討論維度。對科研新人來說,這比“讓 LLM 給我十個創新點”有用得多。
關鍵論文精讀:把 idea 當成可評估對象
Can LLMs Generate Novel Research Ideas?
這篇 2024 年 arXiv 論文招募 100 多位 NLP 研究者,比較專家 idea 和 LLM ideation agent 生成 idea 的盲審評價。它的關鍵不在於“LLM 是否贏過人類”這個單點結論,而在於它把 idea 評價拆成了 novelty、feasibility 等維度,並指出 LLM 自評、多樣性和最終研究結果驗證仍是開放問題。讀這篇時要重點看實驗設計:如何控制作者身份、如何組織 blind review、如何處理主觀評價。
對 follow-up 訓練的啟發是:不要只問“我的 idea 新不新”,還要問“專家會不會認為它可行”“它是否只是換了術語”“它是否和已有論文重複”。如果 novelty 高但 feasibility 低,你得到的不是好選題,而是一個需要繼續壓縮的假設。
Chain of Ideas
Chain-of-Ideas 的核心思想是把相關文獻組織成發展鏈,再讓 LLM 基於鏈條生成 idea 和實驗設計。它提醒我們,很多 idea 的質量取決於文獻結構:你是否知道這個方向從哪個限制走到哪個改進,哪些方法被證明無效,哪些任務定義發生過變化。對人類讀者來說,這等價於 Related Work 地圖的實踐版。
做 follow-up 時,可以借鑑這種鏈式方法:選一篇目標論文,往前追三篇被它解決的工作,往後看三篇引用或同主題新論文,然後寫出“舊限制 -> 當前方法 -> 新限制”的鏈條。如果鏈條寫不出來,說明 idea 還停留在孤立靈感。
AAAR-1.0
AAAR-1.0 把研究者日常任務做成 benchmark,包括 ExperimentDesign 和 PaperWeakness。項目頁說明數據構建中有資深 AI 研究者參與標註,並通過多輪檢查過濾;它也顯示,即使強模型在研究弱點識別、實驗設計等任務上仍有明顯侷限。這裡不要只看模型分數,而要看任務定義:什麼樣的輸出才算好的實驗設計,什麼樣的 weakness 不是泛泛而談。
這對研究生非常實用。你可以把自己的 follow-up idea 當作 AAAR 風格任務來檢查:如果讓另一位同學只看論文和你的 idea,他能否寫出同樣的實驗計劃?如果不能,說明你的問題定義還不夠清楚。
GraphEval 與 Literature-Grounded Novelty Assessment
GraphEval 把複雜 idea 拆成 viewpoint graph,用圖結構輔助評價;Literature-Grounded Novelty Assessment 則提出基於檢索和 rerank 的 novelty checker,強調 novelty 判斷必須 grounded in literature。兩者共同指出一個問題:idea 評價不是一句“看起來很新”,而是要分解觀點、找相關論文、比較差異,並給出基於文獻的理由。
實踐上,你可以為每個候選 idea 寫一張 novelty card:最近三篇最相近論文是什麼?你的差異是任務、數據、方法、理論解釋、評測協議,還是應用場景?如果差異只能寫成“我們也試一下 X”,novelty 很弱;如果差異能寫成“已有工作沒有控制變量 V,因此無法區分機制 M1/M2”,就更像研究問題。
Predicting Empirical AI Research Outcomes
NeurIPS 2025 的這篇論文把 idea 評價轉化為 pairwise prediction:給定兩個研究 idea,預測哪個會在 benchmark 上表現更好。論文報告了由會議論文中抽取的 idea pair 和實驗結果,並比較模型系統與專家判斷。它的意義不是讓我們盲信模型預測,而是提出一個很好的訓練問題:在真正跑實驗前,你能否說清楚哪個 idea 更可能成功,理由是什麼?
做 follow-up 時,可以把候選 idea 兩兩比較:A 更有 novelty,但實驗風險高;B novelty 較低,但能驗證關鍵機制;C 需要額外數據,不適合當前週期。用 pairwise ranking 逼自己取捨,比讓模型生成十個方向更有效。
PreScience 與 Future-Aligned Research Proposals
2026 年的 PreScience 把科學預測做成時間切片 benchmark,圍繞近年 AI 論文和引用信息構造任務;Future-Aligned Research Proposals 則把 proposal 質量與未來論文方向對齊起來,用 cutoff 前資料生成 proposal,再看它是否預示 cutoff 後出現的研究貢獻。這些工作給 follow-up idea 一個新視角:好 idea 不只是和過去不同,還應該能解釋“為什麼下一步可能發生在這裡”。
對訓練營讀者來說,不需要復現完整 benchmark,但可以借鑑時間切片思路:讀論文時只使用某個時間點之前的資料,寫出當時合理的 follow-up,再用之後半年或一年的論文檢查它是否被別人做了、哪裡判斷錯了。這個練習能快速提高研究嗅覺。
方法/實驗對比表
下面是一張可直接用於選題篩選的對比表。每個候選 follow-up 都應至少填一行。
| 維度 | 低質量候選 | 高質量候選 | 檢查問題 |
|---|---|---|---|
| 來源 | “我覺得可以改進” | 來自具體論文表格、failure case、limitation 或 reviewer concern | 能定位到哪一頁、哪張表、哪段 claim 嗎 |
| 缺口 | 論文沒做 X | 論文缺少能區分 M1/M2 的證據 | 原論文為什麼無法回答這個問題 |
| 假設 | X 會更好 | 在條件 S 下,機制 M 會影響指標 Y 和診斷信號 Z | 什麼結果會推翻假設 |
| 實驗 | 訓練一個更大模型 | 固定主系統,只改變一個變量 | 兩到四周能完成嗎 |
| baseline | 只和原論文比 | 包含簡單替代、強 baseline、隨機或預算控制 | 是否排除便宜解釋 |
| 指標 | 只看 leaderboard 分數 | 主指標 + 成本 + 錯誤類型 + 方差 | 是否能解釋為什麼 |
| 風險 | 沒有風險 | 明確數據、算力、代碼、評估偏差風險 | 卡住後有什麼降級方案 |
| 產出 | 必須正結果 | 正負結果都能寫出邊界或機制 | 失敗後是否仍有信息 |
最小復現實驗與 proposal 模板
一個適合訓練營的 follow-up idea,最好先寫成一頁 proposal,再開始跑實驗。模板如下:
1. 目標論文
寫清楚論文標題、版本、鏈接、核心 claim、你依賴的表格或段落。不要只寫“某篇 RAG 論文”。
2. 缺口定義
用兩到三句話說明原論文沒有回答什麼。建議用這種格式:
原論文證明了 A 在 benchmark B 上提升,但沒有控制變量 C,因此無法判斷提升來自機制 M1 還是 M2。
3. 可證偽假設
寫出正反兩種結果的解釋:
如果 M1 成立,則在控制 token budget 後,variant V 應仍提升 factuality,並減少錯誤類型 Z;如果提升消失,則原增益可能主要來自更長上下文或解碼預算。
4. 最小實驗設計
列出數據、模型、baseline、變量、指標、seed、日誌字段。這裡要具體到能開 issue 的程度:
- 數據:使用哪個公開數據集、哪個 split、是否抽樣、抽樣 seed。
- 模型:base checkpoint、推理框架、是否量化。
- 變量:只改一個主變量,例如 retriever、verifier、prompt step、reranker、top-k。
- baseline:原方法、簡單替代、no-op 或預算匹配版本。
- 指標:主指標、成本指標、錯誤分類、置信區間或至少多 seed 均值。
- 日誌:保存輸入、輸出、中間證據、隨機 seed、版本 hash、失敗原因。
5. 預期貢獻
不要寫“提升性能”。寫你要貢獻什麼類型的知識:
- 證明某模塊在控制預算後仍有效。
- 找到原方法只在某類數據上有效。
- 給出一個 benchmark 偏差診斷。
- 說明某個直覺機制不成立。
- 提供可復現的負結果和錯誤分析。
6. 停止條件
給自己設定退出線:兩週內無法復現主結果,轉為 reproduction report;三組 seed 方差過大,優先做穩定性分析;數據構建成本超出預期,縮小到診斷子集;核心假設失敗,寫邊界條件而不是繼續堆模塊。
常見誤區
誤區一:把 future work 當成題目
論文說 future work 可以擴展到多模態,你就寫“我要做多模態版本”。這只是任務擴展,不是研究問題。你需要指出多模態引入了什麼新矛盾:視覺證據和文本證據衝突?圖像編碼器凍結導致細粒度 grounding 不足?評測指標無法區分視覺理解和語言先驗?
誤區二:idea 太大,導致沒有第一步
“構建一個自動科研 agent”很吸引人,但第一步是什麼?如果第一步都說不清,說明題目太大。把它壓縮成一個模塊問題:agent 生成的實驗設計是否覆蓋必要 baseline?LLM self-review 是否能發現缺失消融?idea ranking 是否受論文熱度偏置影響?
誤區三:只追 novelty,不追 feasibility
2024 年的人類研究已經提醒我們,LLM idea 可能被認為更 novel,但 feasibility 較弱。研究生選題不能只看新穎度,因為你還要把實驗跑出來。可行性不是保守,而是把風險顯式化:數據是否能拿到,代碼是否能跑,GPU 是否夠,評估是否可信。
誤區四:把 AI 生成結果當成證據
LLM 可以幫你列 limitation、找相關論文、生成實驗計劃,但它的輸出不是 novelty 證明,也不是實驗結果。ICLR 2026 對重要 LLM 使用要求披露,正說明科研責任仍在作者。使用 AI 輔助構思時,至少要記錄 prompt、檢索來源、人工篩選標準和最終人工判斷。
誤區五:失敗後繼續加模塊
如果最小實驗失敗,最差的反應是繼續加複雜模塊,直到某個 benchmark 上漲。更好的做法是回到假設:是機制錯了,變量沒控制好,數據太小,還是 metric 不敏感?一個清楚的負結果,往往比一個解釋不了的正結果更能訓練研究能力。
適合研究生繼續做的選題
1. Follow-up idea rubric 的小規模人類一致性研究
收集 30-50 個來自近期 LLM 論文的候選 follow-up idea,請 3-5 位研究生按 novelty、feasibility、significance、evidence strength 打分,分析一致性和分歧原因。目標不是訓練模型,而是建立本組的選題評審標準。
2. LLM 輔助 limitation mining 的可靠性評估
給定論文全文,讓 LLM 抽取 limitation、missing ablation、benchmark risk,再由人工核驗。比較不同提示方式:直接抽取、先構建 claim table、先做 related work map、先做 reviewer-style critique。指標可以是人工確認率、具體性和可執行性。
3. 從 ablation 空白生成最小實驗計劃
選取一個方向的 10 篇論文,人工標出缺失消融,再讓模型生成最小實驗計劃。分析模型是否能控制變量、是否遺漏 baseline、是否提出不可執行實驗。這個題目可以和 AAAR-1.0 的 ExperimentDesign 思路呼應。
4. Novelty checker 在中文 AI 論文閱讀中的適配
基於 Literature-Grounded Novelty Assessment 的思路,做一個輕量流程:中文問題描述 -> 英文關鍵詞擴展 -> arXiv / Semantic Scholar 檢索 -> 相似工作分面比較 -> novelty card。重點評估它能否幫助中文讀者避免重複造題。
5. Research proposal 的時間切片復盤
選 2024 年某個方向的論文,只允許使用當時之前的文獻寫 follow-up proposal,再用 2025-2026 年論文檢查 proposal 是否命中真實趨勢。這個練習可以借鑑 PreScience 和 Future-Aligned Proposal 的時間切片思想,但規模可以很小。
總結
設計 follow-up idea 的關鍵,不是想一個宏大方向,而是把論文裡未被充分證明的地方,壓縮成一個可證偽、可復現、可解釋的小問題。讀論文時,你要從 limitation、failure case、ablation 空白、benchmark 偏差和機制解釋不足裡找入口;寫 proposal 時,你要明確來源、缺口、假設、最小實驗、判據和停止條件;跑實驗時,你要保證即使結果為負,也能回答“我們學到了什麼”。
這一篇可以作為後續文章“如何從 10 篇論文形成一個 research proposal”的前置訓練。本文關注單篇論文後的最小 follow-up;關於 research proposal 的文章會進一步討論如何把多個 follow-up 串成完整 proposal。真正的科研閱讀系統,就是從一篇論文的一處縫隙開始,逐步建立自己的問題地圖。
參考資料
檢索日期:2026-07-31。
- Chenglei Si, Diyi Yang, Tatsunori Hashimoto. Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers. arXiv:2409.04109, submitted 2024-09-06. https://arxiv.org/abs/2409.04109
- Long Li et al. Chain of Ideas: Revolutionizing Research Via Novel Idea Development with LLM Agents. arXiv:2410.13185, submitted 2024-10-17, v5 2024-10-30. https://arxiv.org/abs/2410.13185
- Renze Lou et al. AAAR-1.0: Assessing AI's Potential to Assist Research. arXiv:2410.22394, submitted 2024-10-29, v4 2025-05-25; arXiv comments note ICML 2025. https://arxiv.org/abs/2410.22394
- AAAR-1.0 project page. https://renzelou.github.io/AAAR-1.0/
- Tao Feng, Yihang Sun, Jiaxuan You. GraphEval: A Lightweight Graph-Based LLM Framework for Idea Evaluation. arXiv:2503.12600, submitted 2025-03-16, v2 2025-05-28. https://arxiv.org/abs/2503.12600
- Simra Shahid et al. Literature-Grounded Novelty Assessment of Scientific Ideas. arXiv:2506.22026, submitted 2025-06-27. https://arxiv.org/abs/2506.22026
- Jiaxin Wen, Chenglei Si, Yueh-Han Chen, He He, Shi Feng. Predicting Empirical AI Research Outcomes with Language Models. NeurIPS 2025 Main Conference Track; arXiv:2506.00794 submitted 2025-06-01. https://proceedings.neurips.cc/paper_files/paper/2025/hash/03f99ca79b87c513d0b502e737a41a41-Abstract-Conference.html
- Anirudh Ajith et al. PreScience: A Dataset and Benchmark for Scientific Forecasting. arXiv:2602.20459, submitted 2026-02-24, v2 2026-07-02. https://arxiv.org/abs/2602.20459
- Heng Wang et al. Learning to Predict Future-Aligned Research Proposals with Language Models. arXiv:2603.27146, submitted 2026-03-28, v3 2026-05-26. https://arxiv.org/abs/2603.27146
- Chris Lu et al. Towards end-to-end automation of AI research. Nature 651, 914-919, 2026. https://ideas.repec.org/a/nat/nature/v651y2026i8107d10.1038_s41586-026-10265-5.html
- DARPA. The Heilmeier Catechism. https://www.darpa.mil/about/heilmeier-catechism
- ICLR 2026 Author Guide. https://iclr.cc/Conferences/2026/AuthorGuide
- NeurIPS 2026 Main Track Handbook. https://neurips.cc/Conferences/2026/MainTrackHandbook
- Papers with Code. Tips for Publishing Research Code. https://github.com/paperswithcode/releasing-research-code