日期:2026-07-14
適合讀者:機器學習、NLP、程序語言、知識表示方向研究生;關注可靠推理和可解釋模型的工程讀者
檢索日期:2026-07-14
摘要
Neuro-Symbolic AI(神經符號 AI,以下簡稱 NeSy)在 2025-2026 年重新變得重要,不是因為“符號主義復興”這種口號,而是因為大模型推理暴露了幾個很具體的問題:自然語言鏈式推理難以保證中間步驟正確;長鏈搜索的計算成本高;模型可以給出流暢解釋,卻未必能給出可驗證證明;視覺、機器人和科學任務裡的概念、關係、約束很難只靠 token 統計穩定泛化。
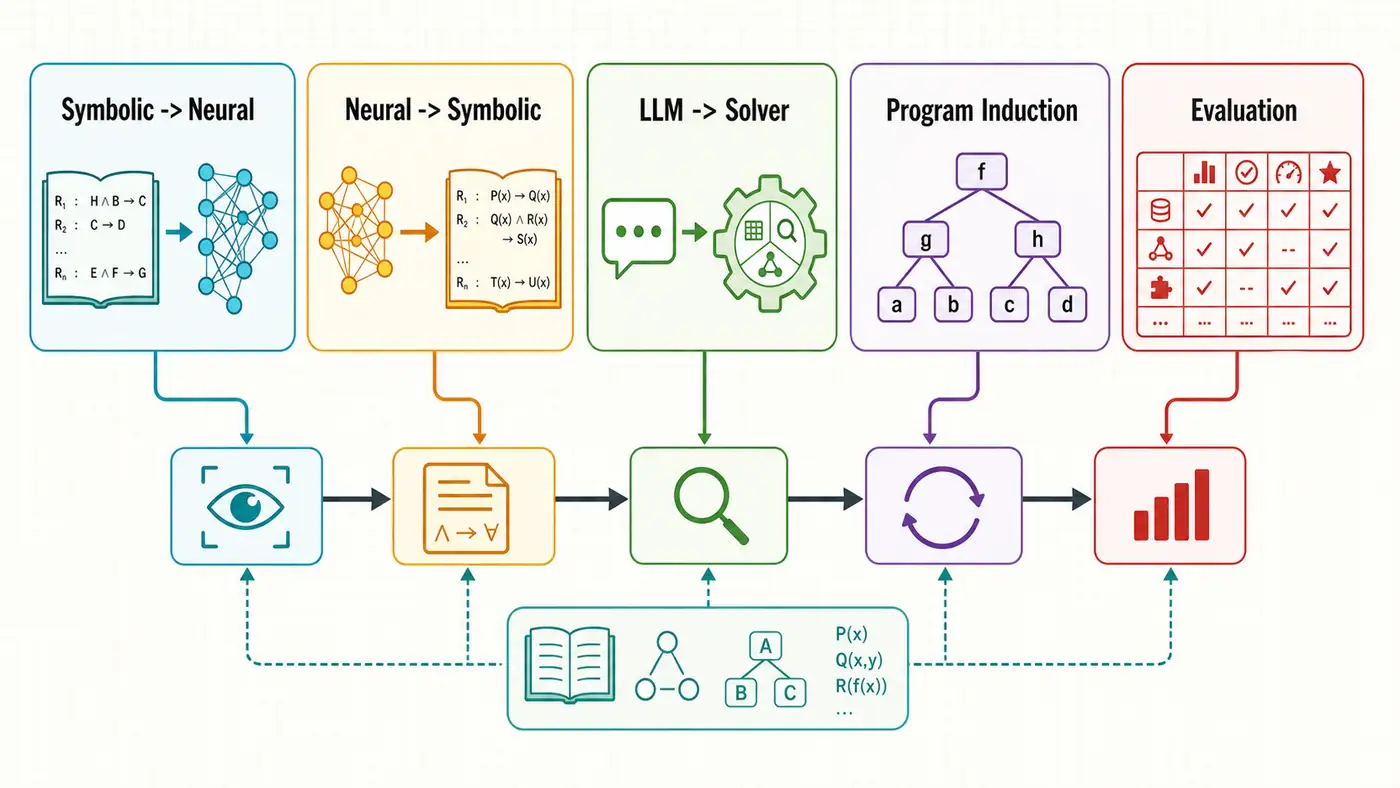
這篇文章把近年的 NeSy 研究拆成五條路線:符號系統生成數據或約束神經模型;神經模型把感知輸入翻譯成符號結構;LLM 調用 SAT/SMT/一階邏輯證明器/規劃器;程序歸納和庫學習把“會做題”變成“學到可複用概念”;以及以 ARC-AGI、FOLIO、ProofWriter、CLEVR、ConceptARC 等 benchmark 為代表的評測範式。結論先說在前面:NeSy 最有價值的地方不是替代 LLM,而是把“猜測、形式化、搜索、驗證、反饋”拆成可審計模塊。
目錄
- 研究背景:為什麼 NeSy 又回來了
- 核心科學問題
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:為什麼 NeSy 又回來了
傳統符號 AI 擅長邏輯、規則、約束滿足和程序搜索,但在感知噪聲、開放世界語義和大規模數據上脆弱;深度學習擅長從數據中學習表示,卻很難保證組合泛化、證明正確性和可解釋結構。NeSy 試圖把這兩類能力放進同一個系統:神經網絡負責從圖像、語言、軌跡中學習概念或啟發式,符號模塊負責約束、搜索、證明、執行和審計。
過去幾年,NeSy 的應用語境發生了變化。早期代表工作如 DeepProbLog、Logic Tensor Networks、Neuro-Symbolic Concept Learner 更關注“可微邏輯 + 感知”的統一學習;現在的熱點則常常圍繞 LLM:讓 LLM 把自然語言問題翻譯成一階邏輯、SMT-LIB、PDDL 或 Python;讓求解器返回可驗證結果;再把錯誤信息反饋給 LLM 修正形式化過程。2025 年的綜述《Neuro-Symbolic Artificial Intelligence: Towards Improving the Reasoning Abilities of Large Language Models》把 LLM 時代的 NeSy 歸納為 Symbolic→LLM、LLM→Symbolic、LLM+Symbolic 三類,這個劃分非常適合用來讀近年的論文。
核心科學問題
NeSy 不是一個單一模型族,而是一組研究問題。
第一,符號如何接地?如果一個系統在圖像中識別“紅色方塊在藍色圓左邊”,這些符號是人工標註的、神經網絡預測的、還是從任務監督中誘導出來的?NS-CL 一類工作強調從圖像-問題-答案中學習對象、屬性和程序,但真實開放場景裡概念邊界更模糊,錯誤會沿著後續推理傳播。
第二,形式化是否可靠?LLM→Solver 方法通常把自然語言翻譯成邏輯表達式,再交給 Prover9、Z3、SAT/SMT、規劃器或解釋器。瓶頸不在求解器,而在 autoformalization:變量綁定、量詞範圍、否定、例外條件、單位和隱含前提一旦翻譯錯,求解器會忠實地給出錯誤形式化下的正確答案。
第三,符號結構能否學習?程序歸納路線關心的不只是求出一個程序,而是能否壓縮出可複用庫、概念層次和人能理解的抽象。DreamCoder 用 wake-sleep 循環學習領域語言;LILO 則把 LLM 引導的程序合成、Stitch 式符號壓縮和自動文檔結合起來,嘗試讓學到的庫既可用又可讀。
第四,評測如何避免“看起來會推理”?NeSy 論文常在 FOLIO、ProofWriter、PrOntoQA、CLEVR、ARC、ConceptARC、程序合成任務上報告結果。真正需要看的不是單點準確率,而是:符號表達是否可執行,錯誤能否定位,分佈外組合是否成立,是否依賴訓練集洩漏或人工規則工程。
近一年論文路線圖
1. NeSy for LLM reasoning。 2025 年以後,很多工作把 LLM 看作語義解析器、策略生成器或啟發式搜索器,而把嚴格推理交給外部模塊。Logic-LM 和 LINC 是早期代表:前者把自然語言邏輯題轉換成符號形式並調用求解器,後者把邏輯推理改寫成一階邏輯證明任務。2025 年的 NeSy 綜述進一步把這條線擴展到數據生成、求解器調用、程序執行、搜索增強和符號反饋。
2. 程序歸納與庫學習。 DreamCoder 仍是理解該方向的基礎論文:它通過程序搜索、庫壓縮和神經引導搜索逐步形成抽象。LILO 的新意是引入 LLM 對庫函數命名和寫文檔,讓符號壓縮出來的抽象更容易被後續合成器使用。2025 年的 Active Learning for Neurosymbolic Program Synthesis 則把注意力放到交互式標註:神經組件會誤判,因此詢問用戶哪些例子最有信息量,需要顯式考慮神經誤差。
3. 抽象推理 benchmark。 ARC-AGI-2 和 ARC Prize 2025 技術報告把“每題搜索、程序優化、反饋循環”推到前臺。ARC-AGI-2 仍保持少樣例輸入輸出網格任務,但更強調高階抽象。2026 年發佈的 ARC Prize 2025 技術報告顯示,2025 競賽的核心趨勢是 refinement loop:針對每個任務迭代生成、驗證、修正程序或候選解,而不是隻靠一次前向推理。
4. 概念中心的 NeSy agent。 2025 年《Neuro-Symbolic Concepts》提出“概念詞表”視角:對象、關係、動作概念既有神經表徵,又有符號程序結構,可在圖像、視頻、3D 場景和機器人任務中組合複用。這條線重要在於它把 NeSy 從邏輯題擴展到持續學習和行動系統。
代表論文分組解讀
A. 可微邏輯與概率邏輯:從 DeepProbLog 到 Scallop
DeepProbLog 把神經謂詞接入概率邏輯程序:圖像識別等感知模塊輸出概率,邏輯程序負責組合和查詢。它適合說明 NeSy 的經典優點:神經網絡處理不確定感知,邏輯程序處理組合規則,訓練可以基於最終任務監督進行。
Scallop 更像一門面向 NeSy 的聲明式語言。它基於關係數據模型和 Datalog,支持遞歸、聚合、否定,並用 provenance semiring 做可微推理。對工程讀者來說,Scallop 的意義在於把“寫一堆 Python glue code 連接模型和規則”提升為“用語言表達可訓練的邏輯結構”。這類系統的難點是編譯和推理效率,以及如何讓普通 ML 研究者願意學習邏輯語言。
B. LLM + 符號求解器:把自然語言推理變成可執行問題
Logic-LM 的基本流程是:LLM 讀取自然語言邏輯題,生成可被符號求解器處理的形式化表達,再由求解器推理。論文還加入 self-refinement,讓求解器錯誤信息反過來幫助修正形式化。LINC 類似,但更強調一階邏輯證明器,把 LLM 當語義解析器,把演繹推理交給證明器。
這條路線的優勢是清晰:答案不是“模型覺得如此”,而是“某個形式系統下可推出”。但它也很容易被誤讀。求解器只能保證形式化之後的推理,不保證自然語言到邏輯的翻譯。好的論文應該報告解析失敗率、語義等價錯誤、求解器報錯類型、人工核驗樣例,而不只報告最終 accuracy。
C. 程序歸納、庫學習與抽象壓縮
程序歸納把任務解表示成程序。相較於直接預測答案,程序有三個優勢:可執行、可組合、可檢查。DreamCoder 的 wake-sleep 機制把已解任務壓縮成新庫函數,再用這些庫函數指導未來搜索;LILO 則把 LLM 帶入這個循環,用語言幫助發現、命名和複用抽象。
這條線和“LLM 寫代碼”不同。它關心的是領域語言、搜索空間、可複用抽象和樣本效率。一個 NeSy 程序歸納系統可以在字符串編輯、圖形生成、場景推理、ARC 網格任務中學到小型 DSL 的組合結構;LLM 則提供候選生成、自然語言先驗和文檔化能力。
D. ARC 與概念泛化:不是刷榜,而是看機制
ARC 系列的價值在於任務小、規則新、訓練樣例少,迫使系統做抽象、搜索和組合。NSA: Neuro-symbolic ARC Challenge 用 transformer 提議搜索方向,再用 DSL 的組合搜索找解;2025 年 ARC Prize 技術報告則強調 refinement loop 的普遍性。這裡的“神經”不是萬能求解器,而是把搜索從指數爆炸中拉回來;“符號”不是人工規則集,而是可執行候選空間。
ConceptARC 補充了 ARC 的一個短板:原始 ARC 很難判斷模型究竟掌握了哪個概念。ConceptARC 按概念組組織任務,用來測試系統是否真的學會了空間和語義概念,而不是隻在某些 puzzle 上碰巧成功。
E. 概念中心與可解釋結構
《Neuro-Symbolic Concepts》把對象、關係、動作都看成 neuro-symbolic concept:它們既可以由神經網絡接地,也可以被符號程序組合。這個視角對機器人和 embodied agent 很關鍵,因為智能體需要把感知、語言、動作和長期概念庫聯繫起來。它也提示我們:可解釋性不只是事後畫 attention heatmap,而是讓模型內部或外部維護可命名、可組合、可測試的結構。
方法對比表
| 路線 | 神經模塊做什麼 | 符號模塊做什麼 | 代表工作 | 主要風險 |
|---|---|---|---|---|
| 可微邏輯 / 概率邏輯 | 感知、謂詞概率、表示學習 | 邏輯組合、概率推理、規則約束 | DeepProbLog, Logic Tensor Networks, Scallop | 推理複雜度高,規則工程重 |
| LLM→Solver | 自然語言理解、形式化生成、錯誤修正 | SAT/SMT/一階證明/規劃/執行 | Logic-LM, LINC, LLM+P | autoformalization 錯誤被隱藏 |
| Symbolic→LLM | 生成證明軌跡、搜索軌跡、合成數據 | 保證數據邏輯一致性 | AlphaGeometry, LoGiPT, DualFormer | 只學到 solver imitation,遷移有限 |
| 程序歸納 | 候選生成、啟發式搜索、自然語言先驗 | DSL 搜索、庫壓縮、程序執行 | DreamCoder, LILO, NSA | DSL 覆蓋不足,搜索成本高 |
| 概念中心 agent | 接地圖像/視頻/動作概念 | 組合概念、關係和動作程序 | NS-CL, Neuro-Symbolic Concepts | 開放世界概念邊界難定義 |
實驗與 benchmark 如何看
讀 NeSy 論文時,建議至少問六個問題。
第一,任務是否真的需要符號結構?如果 benchmark 只測模板化文本分類,NeSy 可能只是增加複雜度。適合 NeSy 的任務通常有明確組合規則、可執行中間表示或可驗證約束。
第二,形式化錯誤如何統計?Logic-LM、LINC 一類系統必須區分語義解析錯誤、語法錯誤、求解器失敗和最終答案錯誤。只看最終準確率會掩蓋真正瓶頸。
第三,符號模塊是否可替換?一個可靠的系統應說明用 Z3、Prover9、Fast Downward、Python interpreter 或自定義 DSL 的原因,並報告外部工具版本。否則復現實驗時很難定位差異。
第四,benchmark 是否存在數據洩漏或過擬合?ARC Prize 2025 技術報告已經明確提醒 benchmark contamination 和知識覆蓋約束。對於 LLM 時代的 NeSy,測試集是否公開、是否被訓練語料覆蓋、是否允許多次試錯,都會改變結論。
第五,是否評估分佈外組合?CLEVR、ConceptARC、ARC、程序合成任務比普通 QA 更適合觀察組合泛化,但也要看訓練/測試概念是否真正分離。
第六,解釋是否可執行?可解釋結構最好能被執行、驗證或反事實測試。只有自然語言解釋而沒有程序、證明、規則或約束,仍然可能是“解釋型幻覺”。
可復現性與數據問題
NeSy 系統的復現難點通常不在模型權重,而在整個管線。一個 LLM→Solver 系統需要 prompt、解析模板、求解器版本、超時設置、錯誤重試策略;一個程序歸納系統需要 DSL 定義、搜索預算、候選排序、任務生成器;一個可微邏輯系統需要 grounding 方式、規則庫、推理近似和訓練穩定性設置。
因此,最值得信任的論文通常會開源三類內容:數據和任務生成腳本;符號中間表示和失敗樣例;完整評測 harness。只給自然語言 prompt 或只給最終表格,復現價值有限。對於 2025-2026 的新論文,如果代碼倉庫尚未公開或仍在快速變化,本文參考資料中統一標註為“以論文/主頁為準”,不把倉庫狀態寫成穩定事實。
侷限與爭議
NeSy 的第一類爭議是可擴展性。符號搜索和邏輯推理往往有組合爆炸;神經啟發式可以剪枝,但不能消除最壞情況複雜度。
第二類爭議是接口脆弱性。自然語言到邏輯、圖像到對象、軌跡到動作符號,這些邊界模塊都會犯錯。模塊化讓錯誤更容易定位,也讓誤差傳播更明顯。
第三類爭議是“符號到底從哪裡來”。人工 DSL 和規則庫可解釋但成本高;從數據中學習符號結構更優雅,但常常需要強歸納偏置和複雜搜索。
第四類爭議是評測激勵。ARC、ProofWriter、FOLIO 等任務推動了方法進展,但如果研究只圍繞固定 benchmark 調 prompt 或調 DSL,就會回到“更聰明地刷題”。真正有價值的 NeSy 應該能遷移到新概念、新工具、新約束和新環境。
適合研究生繼續做的選題
Autoformalization 的錯誤診斷數據集:收集自然語言到 FOL/SMT/PDDL 的翻譯錯誤,按量詞、否定、指代、隱含條件、單位換算分類,而不是隻給最終答案。
帶不確定感知的 solver 調用:把視覺或傳感器輸出的置信度傳給約束求解器,研究 probabilistic constraint solving 與 LLM 形式化的接口。
ARC 風格的可解釋程序庫學習:在 ConceptARC 或自建小型 DSL 上比較 LLM 生成、符號搜索、庫壓縮和 refinement loop 的貢獻。
可執行解釋評測:要求模型輸出解釋、程序或證明,並用執行器檢查解釋是否真的推出答案。
低資源領域的符號數據增強:用規則、知識圖譜或模擬器生成小規模但邏輯一致的數據,再研究 LLM 是否學到可遷移推理。
NeSy 管線的失敗恢復策略:比較 solver error feedback、self-refinement、反例生成、active learning 和人機交互標註在真實任務中的成本。
總結
Neuro-Symbolic AI 的新進展可以用一句話概括:神經模型負責提出可能性,符號系統負責約束可能性,程序和證明負責讓可能性可執行、可檢查、可複用。2025-2026 年值得關注的不是“NeSy 是否會取代大模型”,而是它是否能把大模型推理從流暢文本變成可驗證計算。
對研究生來說,這個方向的機會恰恰在接口處:如何把自然語言、感知輸入、程序、邏輯、搜索和反饋接成一個可復現系統。接口越清楚,失敗越可分析;失敗越可分析,研究就越能積累。
參考資料
以下鏈接均於 2026-07-14 檢索。
- Xiao-Wen Yang et al., Neuro-Symbolic Artificial Intelligence: Towards Improving the Reasoning Abilities of Large Language Models, arXiv, 2025. https://arxiv.org/abs/2508.13678
- LAMDA-NeSy, Awesome-LLM-Reasoning-with-NeSy, GitHub 項目頁. https://github.com/LAMDASZ-ML/Awesome-LLM-Reasoning-with-NeSy
- Robin Manhaeve et al., DeepProbLog: Neural Probabilistic Logic Programming, arXiv, 2018. https://arxiv.org/abs/1805.10872
- Ziyang Li, Jiani Huang, Mayur Naik, Scallop: A Language for Neurosymbolic Programming, arXiv, 2023. https://arxiv.org/abs/2304.04812
- Jiayuan Mao et al., The Neuro-Symbolic Concept Learner: Interpreting Scenes, Words, and Sentences From Natural Supervision, arXiv, 2019. https://arxiv.org/abs/1904.12584
- Jiayuan Mao, Joshua B. Tenenbaum, Jiajun Wu, Neuro-Symbolic Concepts, arXiv, 2025. https://arxiv.org/abs/2505.06191
- Liangming Pan et al., Logic-LM: Empowering Large Language Models with Symbolic Solvers for Faithful Logical Reasoning, arXiv, 2023. https://arxiv.org/abs/2305.12295
- Theo X. Olausson et al., LINC: A Neurosymbolic Approach for Logical Reasoning by Combining Language Models with First-Order Logic Provers, arXiv, 2023. https://arxiv.org/abs/2310.15164
- Kevin Ellis et al., DreamCoder: Growing generalizable, interpretable knowledge with wake-sleep Bayesian program learning, arXiv, 2020. https://arxiv.org/abs/2006.08381
- Gabriel Grand et al., LILO: Learning Interpretable Libraries by Compressing and Documenting Code, arXiv, 2023. https://arxiv.org/abs/2310.19791
- Celeste Barnaby et al., Active Learning for Neurosymbolic Program Synthesis, arXiv, 2025. https://arxiv.org/abs/2508.15750
- Paweł Batorski, Jannik Brinkmann, Paul Swoboda, NSA: Neuro-symbolic ARC Challenge, arXiv, 2025. https://arxiv.org/abs/2501.04424
- François Chollet et al., ARC-AGI-2: A New Challenge for Frontier AI Reasoning Systems, arXiv, 2025. https://arxiv.org/abs/2505.11831
- François Chollet et al., ARC Prize 2025: Technical Report, arXiv, 2026. https://arxiv.org/abs/2601.10904
- Arseny Moskvichev, Victor Vikram Odouard, Melanie Mitchell, The ConceptARC Benchmark: Evaluating Understanding and Generalization in the ARC Domain, arXiv, 2023. https://arxiv.org/abs/2305.07141