日期:2026-07-13
適合讀者:研究生、具身智能與機器人研究者、多模態生成與強化學習方向讀者、有工程背景的技術讀者
檢索日期:2026-07-13
摘要
World Models 正在從強化學習裡的“環境動力學模型”,擴展為面向物理世界、機器人和交互式視頻環境的基礎設施。早期 World Models、PlaNet、Dreamer 系列證明,agent 可以在潛空間裡想像未來並訓練策略;2024 年的 Genie、GameNGen 把路線推進到“從視頻學習可控制環境”;2025-2026 年的 Genie 3、V-JEPA 2、Cosmos、DreamGen、Qwen-RobotWorld、OSCAR 和相關綜述,則把研究焦點推向長時一致性、動作條件控制、物理可解釋性、機器人策略評估和虛實遷移。
這條線的核心問題不是“視頻生成得像不像”,而是:如果 agent 執行某個動作,世界會怎樣變化?變化是否守恆、因果一致、足夠快到能閉環控制,並且能否幫助真實機器人少試錯?
目錄
- 研究背景
- 核心科學問題
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景
“世界模型”並不是新概念。Ha 和 Schmidhuber 2018 年的 World Models 把視覺觀測壓縮成潛變量,用循環模型預測未來,再讓控制器在“夢境”中訓練策略。PlaNet 和 Dreamer 系列進一步把模型化強化學習做成從像素到潛空間規劃的路線:先學環境動力學,再在模型內部 rollout,最後把想像軌跡轉化為行動策略。
過去兩年概念明顯擴張:視頻生成模型讓研究者重新思考“視頻預測是否可以成為世界模擬”;機器人 foundation model 需要大量交互數據,而真實採集昂貴、慢且有安全風險;LLM/VLM 能處理語言和高層語義,但對接觸、遮擋、慣性、空間約束和長時因果仍不穩定。因此,world model 正成為“語言智能如何落到物理世界”的關鍵補塊。
核心科學問題
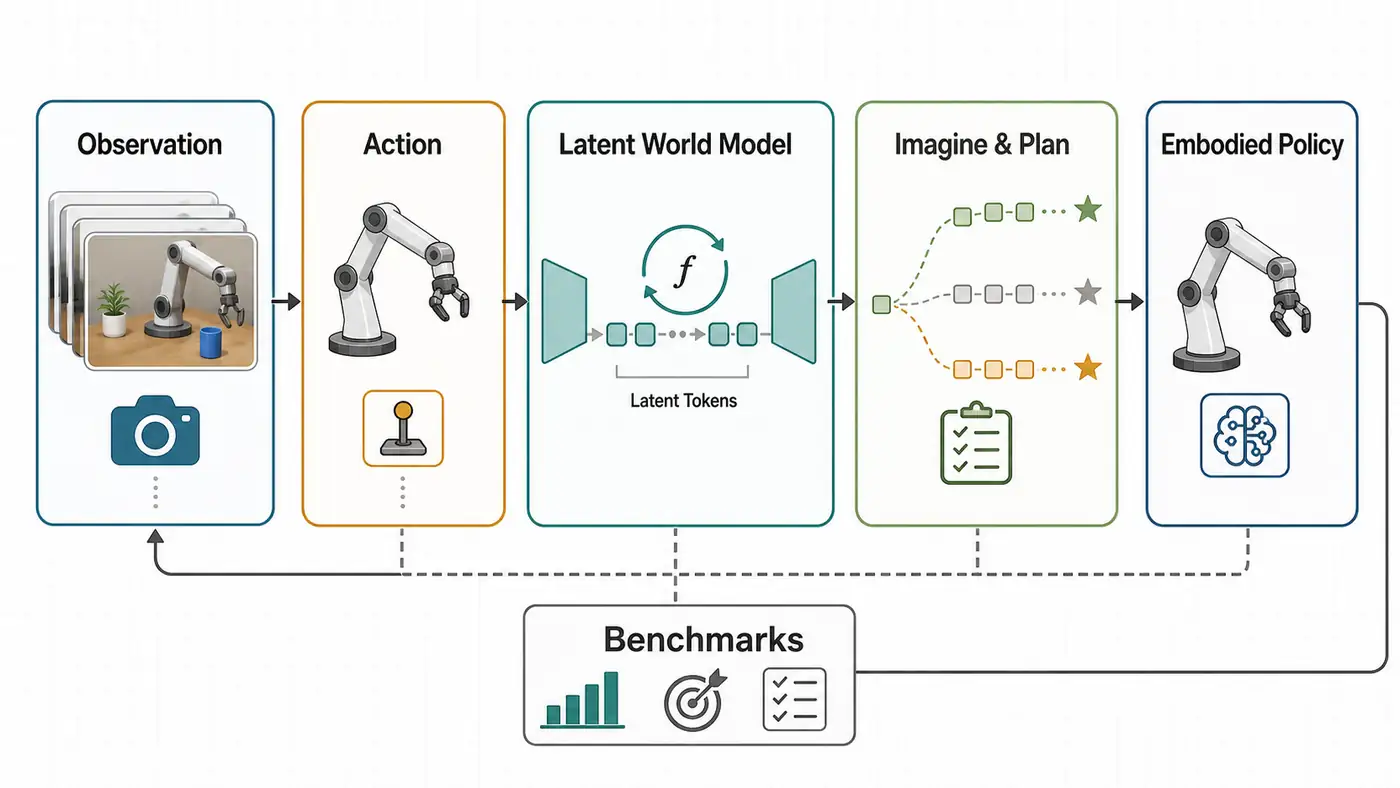
第一,預測什麼才算理解世界。像素級預測能產生漂亮畫面,但可能不守恆、不因果;表示空間預測更高效,卻難以直接檢查細節。研究者需要區分視覺逼真、動力學正確、任務有用三件事。
第二,動作如何進入模型。傳統 RL 的動作由 simulator 定義;真實機器人有高維關節、末端執行器、相機視角、語言指令和人類示範。2026 年關於 world action model 的討論,本質上是在追問:世界模型怎樣連接到可執行動作?
第三,長時一致性如何評估。交互式世界模型比普通視頻生成更難,因為每一步誤差都會被下一步繼承。Genie 3 官方頁面強調實時交互、幾分鐘一致性和一分鐘尺度視覺記憶;這些能力關鍵,但獨立復現仍有限。
第四,仿真是否真的幫助真實機器人。如果合成軌跡只是視覺多樣,策略可能學到錯誤接觸動力學;如果仿真太保守,又無法覆蓋真實長尾。DreamGen、Cosmos、OSCAR 的價值,是開始把“生成視頻”與下游策略收益聯繫起來。
近一年論文路線圖
交互式視頻世界模型 是最熱主線。GameNGen 證明擴散模型可以在 DOOM 中做實時 next-frame simulation;Genie 用無動作標籤視頻、latent action 和可控環境生成建立範式;Genie 3 官方介紹則把目標推進到文本提示生成可實時導航、長期一致的動態世界。2026 年綜述把難點歸納為動作可控、長時記憶和實時響應。
具身世界模型與機器人規劃 是第二條主線。V-JEPA 2 用大規模視頻自監督學習,再用少量 DROID 機器人視頻訓練動作條件模型。Lifting Embodied World Models 關注高維動作難以搜索的問題,用高層 waypoint 作為低維接口。World Action Models 教程則整理 observation-space、state-space、imagine-then-execute、joint video-action modeling 等範式。
Physical AI 平臺 是第三條主線。NVIDIA Cosmos 把 world foundation model 定義為可後訓練的通用平臺;Cosmos-Predict2.5 報告把 Text2World、Image2World、Video2World 統一到物理 AI 場景。GR00T N1 雖更接近 VLA 策略模型,但“視覺語言理解 + 實時動作擴散”的雙系統架構,代表了高層推理與低層控制結合的趨勢。
機器人合成數據與虛擬評估 是第四條主線。DreamGen 生成 synthetic neural trajectories 並恢復偽動作訓練策略;OSCAR 用 skeleton-conditioned world action model 統一不同 embodiment 的動作條件;Qwen-RobotWorld 以語言作為動作接口,覆蓋操作、駕駛、導航和 human-to-robot transfer。其排名和數據細節發表前應再次核驗。
代表論文分組解讀
1. 模型化強化學習傳統
World Models、PlaNet、DreamerV3 的共同範式是:壓縮觀測、學習動態、在潛空間預測未來、用預測訓練策略。優點是目標清晰,可看任務回報和樣本效率;侷限是環境受控,開放世界多樣性遠低於互聯網視頻和真實機器人。
2. 生成式交互環境
Genie 的關鍵是 latent action model:沒有真實動作標籤時,模型仍要發現視頻中可被控制的變化方向。GameNGen 走強約束場景,先用 RL agent 玩 DOOM 收集軌跡,再訓練擴散模型預測下一幀。Genie 3 展示了 general purpose world model 的目標,但科研寫作應區分官方演示、技術報告和第三方復現。
3. 表示預測路線
V-JEPA 2 代表 JEPA 思路:預測抽象表示而不是每個像素,避免把算力花在無關細節上。它連接了大規模視頻理解、物理推理 benchmark 和機器人 image-goal planning。開放問題是可解釋性:規劃失敗時,很難判斷是表徵、動作條件、搜索還是控制器出錯。
4. 合成數據與 world action model
Cosmos、DreamGen、OSCAR、Qwen-RobotWorld 都在處理“世界模型如何變成機器人研究工具”。關鍵不再是生成好看視頻,而是能否產生可信 rollout、可恢復動作、跨 embodiment 泛化,並在真實策略訓練或評估中帶來收益。
方法對比表
| 路線 | 典型工作 | 預測對象 | 動作條件 | 主要用途 | 主要風險 |
|---|---|---|---|---|---|
| 模型化 RL | World Models、PlaNet、DreamerV3 | 潛狀態、reward、未來觀測 | simulator 動作 | 樣本高效 RL、潛空間規劃 | 開放世界泛化弱 |
| 交互式視頻生成 | Genie、GameNGen、Genie 3 | 下一幀或視頻潛變量 | latent action、用戶動作、文本 | 可交互環境、agent training | 物理不守恆、長時漂移 |
| 表示預測 | V-JEPA 2 | 視頻表徵、未來 embedding | 少量機器人後訓練 | 視頻理解、機器人規劃 | 錯誤不直觀 |
| Physical AI 平臺 | Cosmos、Cosmos-Predict2.5 | Text/Image/Video-to-World | 文本、圖像、視頻條件 | 合成數據、policy evaluation | 數據許可、算力、sim-to-real 偏差 |
| World action model | DreamGen、OSCAR、Qwen-RobotWorld | 未來視頻 + 動作表示 | 語言、骨架、waypoint、robot state | 策略訓練、跨 embodiment 評估 | 動作真實性、評價相關性 |
實驗與 benchmark 如何看
不要只看視頻質量指標。FVD、CLIPScore、人工偏好能說明視覺質量,但 world model 更應看動作響應、物體持久性、遮擋後恢復、因果乾預、物理約束、長時一致性和下游策略收益。
WorldModelBench 的價值在於把視頻生成模型當作世界模型審視,加入指令遵從和物理遵從維度。DreamGen Bench 試圖驗證視頻生成質量與機器人策略成功率的相關性。DROID、Open X-Embodiment、RoboMIND 等數據集是重要基礎,但相機標定、控制頻率、硬件差異、接觸動力學和失敗恢復仍會造成偏差。
對 Genie 3 這類閉源系統,應區分三層證據:官方演示、技術報告或論文、第三方可復現實驗。官方博客可以說明方向和能力邊界,但不能直接替代開放 benchmark。
可復現性與數據問題
World model 的數據問題比 LLM 更復雜。視頻數據涉及版權、隱私、地點和平臺許可;機器人數據還涉及硬件配置、標定參數、控制器、遙操作質量和失敗軌跡。論文只寫“使用若干小時機器人視頻”並不足以復現,研究者還需要知道採集頻率、動作空間、相機佈置、任務分佈和過濾規則。
對於研究生,更現實的復現路線不是從頭訓練通用世界模型,而是選擇小型環境或公開機器人數據集,固定動作接口,比較像素預測、表示預測和狀態預測在控制收益上的差異。
侷限與爭議
第一,視頻模型是否真的理解物理仍有爭議,尤其在接觸、守恆、液體、遮擋和多 agent 交互上。第二,機器人策略從合成視頻獲益的機制還不清楚:是學到了動力學,還是獲得了視覺增強和任務先驗?第三,閉源演示正在拉高預期,但社區缺少統一、開放、抗 cherry-picking 的交互式 benchmark。
適合研究生繼續做的選題
- 動作響應評測:測同一初始觀測下不同動作是否產生可區分、物理合理的未來。
- 遮擋與物體持久性:構造長時交互場景,測試模型是否記得離開視野的物體和狀態改變。
- World model 與 VLA 接口:研究 rollout 如何作為 VLA 策略的 verifier、planner 或 data augmenter。
- 合成軌跡可信度:比較 latent action、inverse dynamics 和真實動作標籤對 synthetic trajectory 質量的影響。
- 小算力復現:基於 DROID 子集、RoboMIND 子集或簡單模擬器,系統比較不同預測目標的控制收益。
總結
World Models 與 Embodied AI 的交匯點,是讓 AI 不只描述世界,而能在內部模擬“行動之後會發生什麼”。2025-2026 年的進展說明,視頻生成、機器人策略、仿真平臺和 VLA 控制正在匯合。但開放評測不足、閉源演示難復現、物理一致性難量化、合成數據收益不穩定。下一步應把 world model 放進可驗證的感知-預測-規劃-行動閉環裡檢驗。
參考資料
檢索日期:2026-07-13。以下優先列出論文、官方項目頁、arXiv 和機構官方說明;快速變化的模型開放狀態、benchmark 排名、數據規模和代碼倉庫鏈接,發表前建議再次人工核驗。
- David Ha, Jürgen Schmidhuber. World Models. arXiv, 2018. https://arxiv.org/abs/1803.10122
- Danijar Hafner et al. Learning Latent Dynamics for Planning from Pixels. arXiv, 2018. https://arxiv.org/abs/1811.04551
- Danijar Hafner et al. Mastering Diverse Domains through World Models. arXiv, 2023. https://arxiv.org/abs/2301.04104
- Jake Bruce et al. Genie: Generative Interactive Environments. arXiv, 2024. https://arxiv.org/abs/2402.15391
- Dani Valevski et al. Diffusion Models Are Real-Time Game Engines. arXiv, 2024. https://arxiv.org/abs/2408.14837
- Google DeepMind. Genie 2: A large-scale foundation world model. Official blog, 2024. https://deepmind.google/blog/genie-2-a-large-scale-foundation-world-model/
- Google DeepMind. Genie 3: A new frontier for world models. Official blog, 2025. https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/
- Mido Assran et al. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv, 2025. https://arxiv.org/abs/2506.09985
- Meta AI. Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning. Official blog, 2025. https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks/
- NVIDIA et al. Cosmos World Foundation Model Platform for Physical AI. arXiv, 2025. https://arxiv.org/abs/2501.03575
- NVIDIA et al. GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv, 2025. https://arxiv.org/abs/2503.14734
- Joel Jang et al. DreamGen: Unlocking Generalization in Robot Learning through Neural Trajectories. arXiv, 2025. https://arxiv.org/abs/2505.12705
- Dacheng Li et al. WorldModelBench: Judging Video Generation Models As World Models. arXiv, 2025. https://arxiv.org/abs/2502.20694
- Jiuming Liu et al. Towards Interactive Video World Modeling. arXiv, 2026. https://arxiv.org/abs/2606.01164
- Xiaoxiong Zhang et al. From World Models to World Action Models. arXiv, 2026. https://arxiv.org/abs/2607.00836
- Alex N. Wang et al. Lifting Embodied World Models for Planning and Control. arXiv, 2026. https://arxiv.org/abs/2604.26182
- Jie Zhang et al. Qwen-RobotWorld Technical Report. arXiv, 2026. https://arxiv.org/abs/2606.17030
- Zhuoyuan Wu, Jun Gao. OSCAR: Omni-Embodiment Skeleton-Conditioned World Action Model for Robotics. arXiv, 2026. https://arxiv.org/abs/2606.04463
- Google DeepMind. Gemini Robotics brings AI into the physical world. Official blog, 2025. https://deepmind.google/blog/gemini-robotics-brings-ai-into-the-physical-world/
- Alexander Khazatsky et al. DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset. arXiv, 2024. https://arxiv.org/abs/2403.12945
- Kun Wu et al. RoboMIND: Benchmark on Multi-embodiment Intelligence Normative Data for Robot Manipulation. arXiv, 2024. https://arxiv.org/abs/2412.13877