日期:2026-07-12
適合讀者:研究生、程序語言與軟件工程研究者、LLM 評測研究者、有工程背景的技術讀者
檢索日期:2026-07-12
摘要
LLM for Code 正在從“寫一個函數”轉向“理解一個倉庫、定位一個問題、生成補丁、運行測試並解釋失敗”。HumanEval、MBPP、APPS 和 AlphaCode 奠定了自然語言到程序的基礎範式;2025-2026 年更關鍵的變化,是 BigCodeBench、LiveCodeBench、CodeElo、ICPC-Eval、KernelBench、RealBench、SecRepoBench、SWE-bench Live、Multi-SWE-bench、SWE-bench Pro 和 SWE-Lancer 等 benchmark 把評測推向多庫 API 調用、實時競賽題、倉庫級上下文、多語言 issue 修復、安全代碼、GPU kernel 性能和長週期軟件工程任務。
代碼研究的特殊價值在於:模型輸出可以被編譯器、解釋器、單元測試、靜態分析器、fuzzer、profile 和 CI 環境反覆檢查。但這不等於評測簡單。測試通過不等於需求滿足,公開 GitHub issue 容易被汙染,長上下文不等於有效定位,agent 軌跡也常常把錯誤藏在工具調用和環境差異裡。未來的核心問題不是單純刷新排行榜,而是建立可復現、抗汙染、跨語言、能暴露失敗模式的代碼研究範式。
目錄
- 研究背景:為什麼代碼是 LLM 的天然實驗場
- 核心科學問題
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:為什麼代碼是 LLM 的天然實驗場
代碼任務有一個其他文本任務很難同時具備的優勢:輸出可以執行。問答、摘要和寫作常需要人工判斷事實性、完整性和風格;代碼生成至少可以通過語法檢查、類型檢查、單元測試、集成測試和性能測試獲得明確反饋。這使得 LLM for Code 很早就成為“模型能力是否可被自動驗證”的核心場景。
早期研究主要集中在函數級程序合成。OpenAI Codex 論文提出 HumanEval,用 164 個 Python 函數題檢驗模型能否從 docstring 生成可通過測試的實現;Program Synthesis with Large Language Models 引入 MBPP,包含 974 個小型 Python 編程任務;APPS 把難度推進到 1 萬道來自 Codewars、AtCoder、Kattis 和 Codeforces 的編程題;AlphaCode 則把大規模採樣、過濾和競賽平臺評測結合起來,展示了模型在算法題上的潛力。
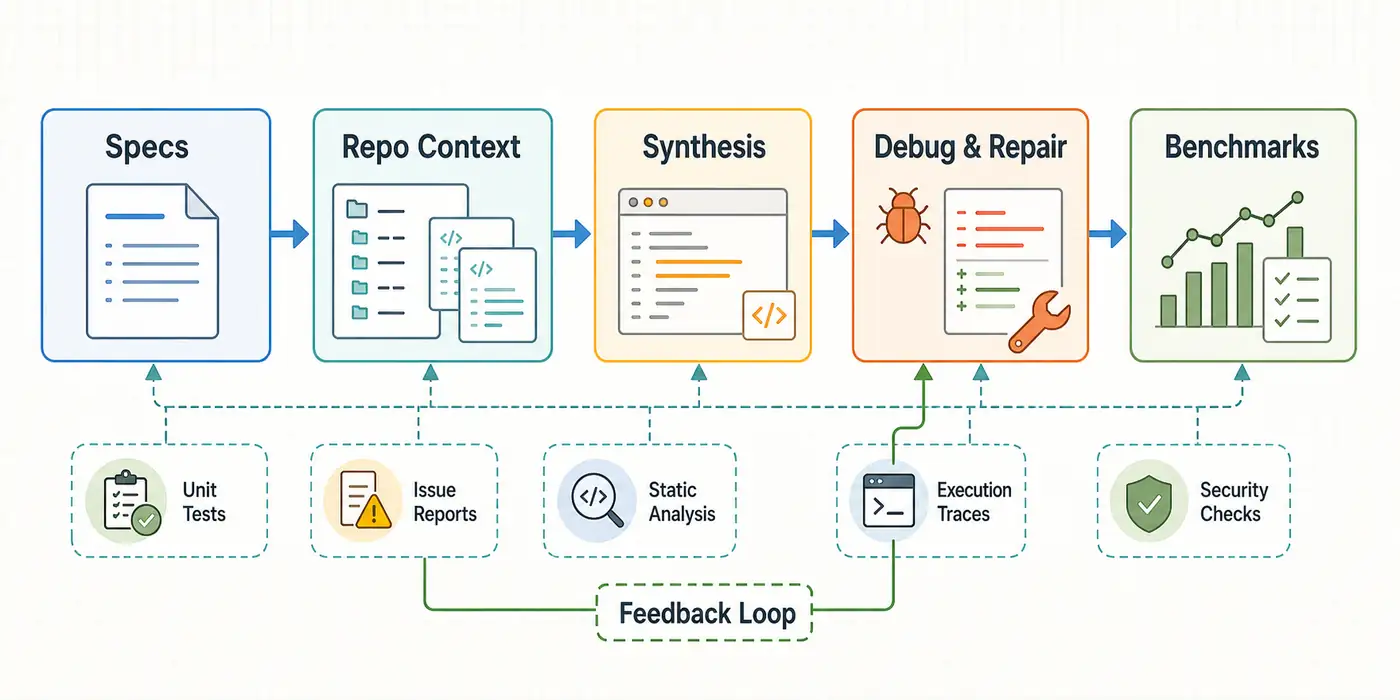
這些工作建立了基本範式:給定規格,生成多個候選程序,用測試或在線判題篩選。但真實開發不是隻寫一個無依賴函數,而是要讀倉庫、理解接口、修改多個文件、處理歷史設計、運行失敗測試、避免安全漏洞,並在不完全規格下做工程判斷。於是研究問題從“模型會不會寫代碼”轉向“模型能否在軟件系統裡可靠工作”。
核心科學問題
第一,規格理解是否真實。短函數題的輸入輸出邊界通常很清楚;真實需求可能來自 issue、PR 討論、UML、日誌、截圖、失敗測試和用戶描述。模型需要分辨必須滿足的約束、可忽略的背景和隱含的不變量。
第二,倉庫上下文如何選擇。長上下文模型可以塞入更多文件,但有效代碼修改依賴精準定位:哪些函數相關,哪些測試能暴露問題,哪些調用鏈不能破壞。Agentless、AutoCodeRover、SWE-agent 和 OpenHands 代表了不同路線:結構化檢索、補丁驗證、agent-computer interface 或通用開發者工作臺。
第三,執行反饋如何變成修復信號。編譯錯誤、棧追蹤、單測失敗、靜態分析告警、覆蓋率和性能 profile 都能告訴模型哪裡錯了。但模型也可能過擬合測試、刪除斷言、繞過錯誤、引入隱藏迴歸,或者在多輪修復中把上下文汙染得越來越嚴重。
第四,benchmark 是否可信。SWE-bench 讓 GitHub issue 修復成為標準任務,但公開 issue、公開倉庫和公開 leaderboard 會帶來訓練數據汙染、記憶、測試脆弱性和提交選擇偏差。LiveCodeBench、SWE-bench Live、Multi-SWE-bench、SWE-bench Pro 和 SWE-Lancer 的出現,本質上是在修補這個問題。
第五,正確性之外還要評什麼。軟件工程不只關心“能不能跑”。安全性、可維護性、性能、最小改動、測試質量、架構一致性、依賴風險和代碼審查可讀性都很重要。KernelBench 和 CUDA-LLM 把目標推向 GPU kernel 性能;SecRepoBench 把研究焦點放到 C/C++ 倉庫裡的安全代碼補全;RealBench 則強調團隊開發常從結構化設計和 UML 出發,而不是一句自然語言 prompt。
近一年論文路線圖
第一條主線是 repo-level 與真實軟件工程評測。SWE-bench 原始版本包含 2,294 個來自 12 個 Python 倉庫的真實 GitHub issue,推動了“給模型一個倉庫和 issue,讓它生成補丁”的研究範式。Multi-SWE-bench 把 issue resolving 擴展到 Java、TypeScript、JavaScript、Go、Rust、C 和 C++,包含 1,632 個高質量實例,並提出多語言 RL 數據建設方向。SWE-bench Live 使用 2024 年以來的新 issue,初始版本包含 1,319 個任務、93 個倉庫和可執行 Docker 環境,目標是減少靜態基準的過擬合與汙染。SWE-bench Pro 進一步強調長週期任務,論文稱其包含 1,865 個來自 41 個活躍倉庫的問題。
第二條主線是 從競賽題到實時、抗汙染代碼評測。LiveCodeBench 持續收集 LeetCode、AtCoder 和 Codeforces 的新題,並覆蓋代碼生成、自修復、代碼執行和測試輸出預測。CodeElo 直接把模型提交到 Codeforces 平臺,用更接近人類競賽的 Elo 方式衡量表現。ICPC-Eval 選取近年 ICPC 區域賽問題,並提出 Refine@K 來觀察模型在執行反饋下迭代修復的能力。這些工作共同說明:pass@k 仍重要,但單次生成分數已經不足以解釋 reasoning model 的代碼能力。
第三條主線是 程序合成從短函數走向多庫、多工具和結構化設計。BigCodeBench 包含 1,140 個 Python 任務,覆蓋 139 個庫、7 個領域和 723 個函數調用,強調複雜指令和多 API 組合。RealBench 在 2026 年提出從自然語言需求加 UML 設計出發的倉庫級代碼生成,指出很多現有 benchmark 與團隊開發裡的規格輸入方式不一致。
第四條主線是 自動調試、程序修復和 agent 工作流對比。SWE-agent 提出 agent-computer interface,強調給模型設計適合導航、編輯和測試的交互界面。AutoCodeRover 更偏軟件工程視角,用 AST、代碼搜索和測試輔助 fault localization 幫助定位修改點。Agentless 反過來質疑複雜 agent 是否必要,用定位、修復、補丁驗證的三階段流程建立強基線。OpenHands 提供通用平臺,把命令行、代碼編輯、瀏覽器和 sandbox 組織為可擴展的開發 agent 環境。
第五條主線是 性能、安全和專門領域代碼。KernelBench 用 250 個 PyTorch ML workload 檢驗模型能否寫出又快又正確的 GPU kernel,並用 fast_p 衡量超過基線速度閾值的正確生成比例。CUDA-LLM 把執行、編譯和性能反饋納入迭代優化,探索自動生成 CUDA 程序。SecRepoBench 則把問題放在 C/C++ 真實倉庫中,覆蓋 27 個倉庫、318 個任務和 15 類 CWE,關注正確性與安全性的聯合約束。
代表論文分組解讀
1. 基礎程序合成:HumanEval、MBPP、APPS、AlphaCode
HumanEval 的貢獻不是題量大,而是把“功能正確性”推到代碼模型評測中心:模型輸出必須通過隱藏測試,而不是僅憑 BLEU 或文本相似度。MBPP 證明小規模自然語言編程任務可以系統化構造,並用於 few-shot 與微調比較。APPS 把評測難度擴展到競賽式問題,題目數量和難度跨度更大,也更接近算法訓練平臺。
AlphaCode 的關鍵思想是大規模候選生成加行為過濾。它不是讓模型一次寫出完美程序,而是生成大量候選、聚類、運行樣例、過濾再提交。這一範式後來影響了 test-time scaling、self-repair、verifier reranking 和 execution-guided decoding。侷限也很清楚:大量採樣需要算力,公開競賽題有汙染風險,而且算法題不等於軟件工程。
2. 多庫與複雜指令:BigCodeBench、DS-1000、RealBench
BigCodeBench 明確指出,短函數題已被新模型逐漸飽和,真實編程常常需要調用多個庫、處理文件、網絡、數據結構和異常條件。它的價值不是簡單“更難”,而是更接近“用代碼完成任務”:模型需要選擇 API、組合調用、遵守自然語言細節,並通過比較嚴格的測試。
DS-1000 代表數據科學代碼生成路線,關注 NumPy、Pandas、Sklearn 等庫的真實使用。RealBench 的價值在於把規格輸入變成“需求 + UML 設計”,提醒研究者不要默認所有開發任務都來自自然語言 prompt。一個值得繼續研究的問題是:代碼模型是否真正理解設計結構,還是隻是在從文本描述裡補全常見模塊?
3. 自動調試與程序修復:從 APR 到 SWE issue resolving
傳統 automated program repair 研究很早就關注補丁生成、測試通過和過擬合補丁。LLM 加入後,修復流程從模板搜索擴展到自然語言 issue 理解、跨文件定位和補丁解釋。2025 年關於 LLM automated program repair 的實證研究也提醒我們,不同語言、不同 bug 場景、不同 prompt 策略會顯著影響結果,模型規模與修復能力並不總是線性相關。
SWE-bench 把這個方向推到真實 GitHub issue。與函數題相比,issue resolving 要求模型讀倉庫、理解用戶報告、編輯代碼並通過倉庫測試。SWE-agent、AutoCodeRover、MASAI、Agentless 和 OpenHands 的分歧,正好構成研究譜系:交互式 agent、結構化檢索、模塊化子 agent、非 agent 三階段流程、通用開發平臺。比較這些系統時,不應只看榜單名次,還要看成本、軌跡長度、工具權限、是否開源、是否能復現實驗環境。
4. 軟件工程 benchmark 擴展:Multi-SWE、Live、Pro、Lancer
Multi-SWE-bench 的重要性在於打破 Python 中心化。Java、TypeScript、Go、Rust、C/C++ 的構建系統、測試框架、包管理和慣用設計都不同,模型在 Python issue 上的策略不能直接遷移。SWE-bench Multimodal 進一步把前端、可視化和 JavaScript 軟件納入評測,要求模型處理圖片或視覺問題陳述。
SWE-bench Live 和 SWE-bench Pro 代表抗汙染和長週期方向。Live benchmark 用新 issue 和自動化環境構建減少靜態題庫失效;Pro benchmark 試圖覆蓋更復雜、更接近企業開發的問題。SWE-Lancer 的角度更獨特:它把任務來自 Upwork 的真實軟件工程工作,並把任務價值與測試驗證聯繫起來。金額指標不應被簡單理解為“模型創造經濟價值”,但它確實提供了另一種任務難度標尺。
5. 性能、安全與系統代碼:KernelBench、CUDA-LLM、SecRepoBench
代碼生成研究如果只看測試通過,會漏掉大量工程核心指標。一個排序函數可以正確但很慢,一個網絡服務可以通過單測但存在注入漏洞,一個 CUDA kernel 可以編譯但比 PyTorch baseline 更慢。KernelBench 因此把“正確且更快”作為聯合目標,CUDA-LLM 則探索用編譯和 profile 反饋做特徵搜索與強化。
SecRepoBench 關注安全代碼補全,尤其是 C/C++ 真實倉庫和 CWE 類漏洞。這類任務更難,因為模型需要同時滿足功能、上下文風格、內存安全和漏洞規避。安全 benchmark 也更容易暴露“測試通過但有危險實現”的問題,適合作為代碼模型可靠性研究的下一步。
方法對比表
| 路線 | 代表工作 | 核心機制 | 適合問題 | 主要風險 |
|---|---|---|---|---|
| 函數級程序合成 | HumanEval、MBPP | 從 docstring / 短規格生成函數,用單測評分 | 基礎代碼生成、模型橫向比較 | 題目短、易汙染、不能代表倉庫級開發 |
| 競賽代碼生成 | APPS、AlphaCode、LiveCodeBench、CodeElo、ICPC-Eval | 多采樣、在線判題、執行反饋、Elo 或 Refine@K | 算法推理、複雜約束、實時新題 | 算法題和工程任務差異大,採樣預算影響大 |
| 多庫任務合成 | BigCodeBench、DS-1000 | API 選擇、多庫組合、複雜自然語言指令 | 工具化編程、數據科學、腳本自動化 | 測試覆蓋與真實需求仍有差距 |
| 倉庫級生成 | RealBench、MRG-Bench | 需求、設計圖、跨文件上下文和項目測試 | 團隊開發、模塊生成、架構一致性 | 環境重建難,規格忠實性難判 |
| 自動修復 / issue resolving | SWE-bench、SWE-agent、AutoCodeRover、Agentless、OpenHands | 定位、補丁生成、測試執行、軌跡反饋 | Bug 修復、維護、真實 GitHub issue | 公開 issue 汙染、過擬合測試、leaderboard 不穩定 |
| 多語言與長週期評測 | Multi-SWE-bench、SWE-bench Live、SWE-bench Pro、SWE-Lancer | 多語言倉庫、新近 issue、複雜任務、真實交付 | 抗汙染和真實軟件工程 | 評測成本高,部分集合不可公開 |
| 安全與性能代碼 | SecRepoBench、KernelBench、CUDA-LLM | 靜態分析、CWE、編譯、profile、速度閾值 | 安全補全、系統代碼、GPU kernel | 硬件和工具鏈依賴強,可復現難 |
實驗與 benchmark 如何看
讀代碼論文時,第一步是區分任務粒度。函數級、文件級、倉庫級、issue resolving、競賽題、性能 kernel、安全補全是不同問題。把 HumanEval 高分直接外推到真實工程是不成立的。
第二,看測試是否足夠強。單元測試少、樣例測試公開、斷言弱,都可能讓模型碰巧通過。對於修復任務,要看是否有迴歸測試、是否運行完整測試套件、是否檢測過擬合補丁,是否有人類驗證 issue 可解決。
第三,看上下文與工具權限。一個 agent 能否搜索文件、運行測試、安裝依賴、訪問網絡、編輯多個文件,會顯著改變結果。論文應報告 scaffold、工具、超時、token 預算、候選數量、模型版本和重試策略。
第四,看汙染風險。LiveCodeBench、SWE-bench Live 和 CodeElo 的共同動機就是固定公開 benchmark 會老化。若論文只報告舊公開題庫高分,應額外檢查題目發佈時間、訓練數據 cutoff、是否做過近似重複檢測,以及是否報告 held-out 或 live split。
第五,看成本和軌跡。軟件工程 agent 的性能常常來自大量 token、長軌跡和多次執行。一個方法如果準確但成本過高、失敗時難以診斷,研究價值仍然有限。Agentless 這類強基線提醒我們:簡單、可解釋、低成本流程應作為複雜 agent 的對照組。
可復現性與數據問題
代碼研究的可復現性高度依賴環境。Python 版本、包版本、系統庫、編譯器、GPU、Docker 鏡像、測試順序、隨機種子、網絡可用性都會影響結果。SWE-bench 類任務還涉及倉庫歷史版本、issue 文本、PR patch、測試選擇和環境構建腳本。一個小的依賴漂移就可能讓“模型失敗”變成“環境失敗”。
數據汙染也更復雜。GitHub 是代碼模型訓練的重要來源,公開 issue、PR、CI 日誌、Stack Overflow 解答、競賽題解都可能進入訓練語料。模型知道文件路徑、函數名或歷史 patch,並不等於它能推理。2025 年關於 SWE-bench 記憶與 benchmark mutation 的研究提醒我們,評測應加入新倉庫、新 issue、變形題、私有 held-out、行為等價測試和失敗模式分析。
另一個問題是 ground truth 並不唯一。軟件修復常有多種合理補丁,官方 PR 不一定是唯一正確答案;測試通過也可能隱藏更好的設計。未來 benchmark 需要更強的語義判定:屬性測試、差分測試、fuzzing、靜態分析、人類代碼審查和規格一致性檢查應結合起來,而不是隻依賴一個 test suite。
侷限與爭議
第一,代碼模型容易把“會寫代碼”誤讀成“會做軟件工程”。軟件工程包含需求澄清、風險評估、架構權衡、長期維護和團隊協作,這些很難被單次補丁評測覆蓋。
第二,agent 軌跡看似自主,實際高度依賴 scaffold。提示詞、工具封裝、文件搜索 API、測試命令選擇、錯誤摘要方式和補丁驗證策略,都可能比底層模型更影響結果。論文若不公開 scaffold,結果很難科學比較。
第三,benchmark 正在追趕模型,但也被模型追趕。公開 leaderboard 會激勵針對性優化,固定測試集會被訓練,熱門題庫會被題解汙染。Live benchmark 和 held-out split 只是緩解,不是徹底解決。
第四,安全風險不能只在最後檢查。代碼模型可能生成脆弱依賴、硬編碼密鑰、危險命令、越權文件訪問和不安全輸入處理。安全代碼生成需要從數據、訓練、工具權限、靜態分析和審查流程一起設計。
適合研究生繼續做的選題
倉庫級上下文選擇的可解釋評測:比較長上下文、RAG、AST 檢索、調用圖和測試覆蓋信息對修復成功率的影響,並報告錯誤定位而非只報告最終通過率。
執行反饋的學習信號建模:把編譯錯誤、單測失敗、棧追蹤、coverage 和靜態分析告警轉成結構化狀態,研究哪些反饋最能幫助模型修復。
抗汙染 benchmark mutation:對公開 issue 或競賽題進行語義保持變形,檢測模型是記憶路徑和 patch,還是理解需求。
多語言 SWE agent 對比:以 Multi-SWE-bench 為基礎,分析不同語言生態中失敗模式的差異,例如 Rust borrow checker、Go module、Java build system、TypeScript 類型系統。
安全補丁生成與審查閉環:結合 SecRepoBench、CWE、靜態分析和人工審查,研究模型是否能同時最小化功能迴歸和安全風險。
性能代碼的 test-time optimization:在 KernelBench 或 CUDA kernel 任務上研究採樣、profile feedback、局部搜索和 verifier 排序的組合策略。
總結
LLM for Code 的研究價值不在於“AI 會不會替代程序員”這種寬泛敘事,而在於它提供了一個可以執行、可以驗證、可以迭代的智能實驗場。從 HumanEval 到 SWE-bench,從 BigCodeBench 到 RealBench,從 KernelBench 到 SecRepoBench,研究邊界正在從短函數生成擴展到複雜軟件系統。
未來幾年更有意義的工作會集中在三件事上:第一,把代碼生成、調試、測試和審查做成可復現的閉環;第二,用 live、多語言、長週期和安全/性能約束 benchmark 抵抗虛假進步;第三,把模型、檢索、工具、執行環境和 verifier 看成一個系統,而不是把所有成功或失敗都歸因於模型本身。
參考資料
檢索日期:2026-07-12。以下優先列出 arXiv、OpenReview、項目主頁或官方倉庫等可訪問一手資料;模型榜單、代碼倉庫狀態、benchmark leaderboard、具體 SOTA 分數和 2026 年仍在更新的版本信息,建議發佈前再次人工核驗。
- Mark Chen et al. Evaluating Large Language Models Trained on Code. arXiv, 2021. https://arxiv.org/abs/2107.03374
- Jacob Austin et al. Program Synthesis with Large Language Models. arXiv, 2021. https://arxiv.org/abs/2108.07732
- Dan Hendrycks et al. Measuring Coding Challenge Competence With APPS. arXiv, 2021. https://arxiv.org/abs/2105.09938
- Yujia Li et al. Competition-Level Code Generation with AlphaCode. arXiv, 2022. https://arxiv.org/abs/2203.07814
- Hung Le et al. CodeRL: Mastering Code Generation through Pretrained Models and Deep Reinforcement Learning. arXiv, 2022. https://arxiv.org/abs/2207.01780
- Naman Jain et al. LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code. arXiv, 2024. https://arxiv.org/abs/2403.07974
- Terry Yue Zhuo et al. BigCodeBench: Benchmarking Code Generation with Diverse Function Calls and Complex Instructions. arXiv / ICLR 2025, 2024. https://arxiv.org/abs/2406.15877
- Carlos E. Jimenez et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? arXiv, 2023. https://arxiv.org/abs/2310.06770
- John Yang et al. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv, 2024. https://arxiv.org/abs/2405.15793
- Yuntong Zhang et al. AutoCodeRover: Autonomous Program Improvement. arXiv, 2024. https://arxiv.org/abs/2404.05427
- Chunqiu Steven Xia et al. Agentless: Demystifying LLM-based Software Engineering Agents. arXiv, 2024. https://arxiv.org/abs/2407.01489
- Xingyao Wang et al. OpenHands: An Open Platform for AI Software Developers as Generalist Agents. arXiv, 2024. https://arxiv.org/abs/2407.16741
- Daoguang Zan et al. Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving. arXiv, 2025. https://arxiv.org/abs/2504.02605
- Linghao Zhang et al. SWE-bench Goes Live! arXiv, 2025. https://arxiv.org/abs/2505.23419
- Xiang Deng et al. SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks? arXiv, 2025. https://arxiv.org/abs/2509.16941
- Samuel Miserendino et al. SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering? arXiv, 2025. https://arxiv.org/abs/2502.12115
- Shanghaoran Quan et al. CodeElo: Benchmarking Competition-level Code Generation of LLMs with Human-comparable Elo Ratings. arXiv, 2025. https://arxiv.org/abs/2501.01257
- Shiyi Xu et al. ICPC-Eval: Probing the Frontiers of LLM Reasoning with Competitive Programming Contests. arXiv, 2025. https://arxiv.org/abs/2506.04894
- Anne Ouyang et al. KernelBench: Can LLMs Write Efficient GPU Kernels? arXiv, 2025. https://arxiv.org/abs/2502.10517
- Wentao Chen et al. CUDA-LLM: LLMs Can Write Efficient CUDA Kernels. arXiv, 2025. https://arxiv.org/abs/2506.09092
- Chihao Shen et al. SecRepoBench: Benchmarking Code Agents for Secure Code Completion in Real-World Repositories. arXiv, 2025/2026 revision. https://arxiv.org/abs/2504.21205
- Jia Li et al. RealBench: A Repo-Level Code Generation Benchmark Aligned with Real-World Software Development Practices. arXiv, 2026. https://arxiv.org/abs/2604.22659
- Matias Martinez and Xavier Franch. What's in a Benchmark? The Case of SWE-Bench in Automated Program Repair. arXiv, 2026. https://arxiv.org/abs/2602.04449
- Shanchao Liang et al. The SWE-Bench Illusion: When State-of-the-Art LLMs Remember Instead of Reason. arXiv, 2025. https://arxiv.org/abs/2506.12286
- Jiajun Sun et al. Empirical Evaluation of Large Language Models in Automated Program Repair. arXiv, 2025. https://arxiv.org/abs/2506.13186