日期:2026-07-11
適合讀者:研究生、數學推理與形式化方法研究者、LLM 評測研究者、有工程背景的技術讀者
檢索日期:2026-07-11
摘要
LLM 數學推理在 2024-2026 年進入了一個新階段:研究焦點不再只是“模型能不能算出答案”,而是“推理過程能不能被檢查、復現和擴展到真正困難的問題”。從 MATH、GSM8K、Minerva 和過程監督,到 LeanDojo、ProofNet、miniF2F、DeepSeek-Prover-V2、Kimina-Prover、LEAP,再到 AlphaGeometry2、Gemini Deep Think 的 IMO 2025 表現和 IMO-Bench、MathArena 等實時評測,前沿路線正在向三個方向收斂:更長的自然語言探索、更強的形式化證明器反饋、更嚴格的去汙染 benchmark。
這篇文章的核心判斷是:數學推理正在成為 LLM 研究裡最接近“可驗證智能”的試驗場。答案題能給出便宜的獎勵信號,形式化證明能給出機器可檢查的正確性,奧賽和研究級 benchmark 又能持續製造新問題。真正困難的地方在於,數學創造力並不等於大量採樣,Lean 證明通過也不等於自然語言理解,競賽得分也不等於研究級數學能力。
目錄
- 研究背景:為什麼數學推理突然成為主戰場
- 核心科學問題:答案、證明與形式化之間的斷層
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:為什麼數學推理突然成為主戰場
早期 LLM 數學能力常被 GSM8K、MATH、AIME 子集這類題目衡量。GSM8K 證明了小學應用題也需要多步推理;MATH 把題目難度推進到競賽數學,並提供逐步解答;Minerva 則說明在科學論文、LaTeX 和技術文本上繼續預訓練,可以顯著增強定量推理。隨後,self-consistency、verifier、process reward model 和 test-time scaling 讓“多采樣、再篩選”成為數學任務的常用範式。
但這個階段有兩個結構性問題。第一,最終答案正確不代表證明正確。模型可能用錯誤步驟碰巧得到正確數值,也可能給出看似嚴謹但存在斷裂的推導。第二,公開 benchmark 很快被訓練數據、題庫講解、解析視頻和模型蒸餾汙染。越是熱門的 AIME、MATH 和 Olympiad 題,越難分辨模型是在推理,還是在回憶題型與解法模板。
因此,數學推理研究開始向“可驗證”遷移。Lean、Isabelle、Coq/Rocq、Metamath 等 proof assistant 提供了小內核檢查機制:只要形式化命題和證明被系統接受,證明的局部正確性就不再依賴 LLM 自述。Lean 4 和 mathlib 的擴張尤其重要,因為它們把形式化數學、程序驗證和 LLM 工具交互放到同一個可執行環境裡。Lean 官方網站強調,Lean 是開源編程語言和證明助手,能用於可維護代碼與形式化證明;mathlib 則提供跨代數、分析、拓撲、概率和計算機科學的大規模數學庫。
核心科學問題:答案、證明與形式化之間的斷層
這條路線至少有五個核心問題。
第一,自然語言推理是否可靠。長鏈 CoT、反思、樹搜索和多樣化採樣能提高命中率,但也會放大幻覺。數學文本很容易“局部合理、全局錯誤”,尤其是組合、數論和幾何構造題。
第二,證明是否可機器檢查。形式化證明把“看起來對”變成“編譯器接受”。問題是,從自然語言題面到 Lean 命題、從人類草稿到完整 proof script,本身就是困難的 autoformalization 任務。
第三,搜索空間如何壓縮。形式化證明不是簡單生成一段代碼。模型需要選擇引理、展開定義、調用 tactic、處理類型錯誤、讀懂 proof state,並在大量失敗分支裡回溯。
第四,評測是否抗汙染。固定公開題庫會迅速失效。MathArena 這類實時競賽評測,以及 FrontierMath、IMO-Bench、VAR-MATH 等更難或可變形 benchmark,試圖把評價從“歷史題庫”推向“新鮮題、原創題、參數化題、證明題”。
第五,數學能力是否能遷移到科研。IMO gold-level 結果很吸引眼球,但競賽數學和研究數學不同。競賽題短、邊界清楚、通常有優雅解;研究數學可能需要定義新對象、構建理論、處理長依賴鏈和多年協作。
近一年論文路線圖
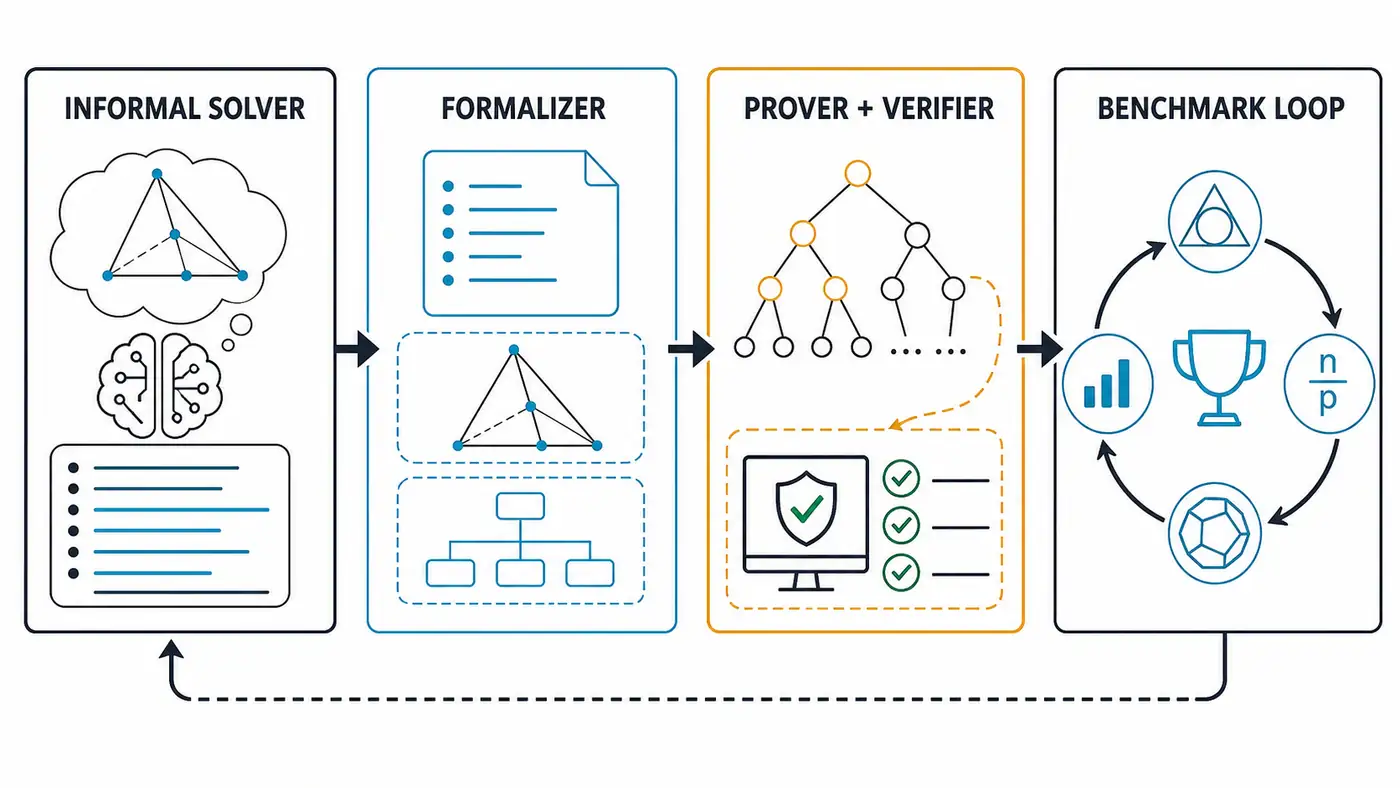
2025-2026 年最明顯的變化是形式化證明模型的快速上升。DeepSeek-Prover-V2 把 DeepSeek-V3 的自然語言分解能力接入 Lean 4 證明生成,通過子目標分解和強化學習縮小 informal 與 formal 的差距。Kimina-Prover Preview 從 Qwen2.5-72B 出發,強調“formal reasoning pattern”和大規模 RL,在 miniF2F 上報告了強 pass@8192 表現,並開源蒸餾模型。Leanabell-Prover-V2 繼續沿著 verifier-integrated RL 走,把 Lean 編譯器反饋作為多輪交互信號。2026 年的 LEAP 則把 general-purpose LLM 變成 agentic formal math 框架:先形成非形式化藍圖,再與 Lean 編譯器持續交互、分解子問題、修正 proof state。
第二條線是自然語言奧賽推理。Google DeepMind 在 2025 年發佈的官方博客稱,Gemini Deep Think 的高級版本在 IMO 2025 達到金牌標準,提交解答經 IMO 確認為完整正確;同一頁面也註明,IMO 的確認不等於驗證系統、流程或底層模型。這個 caveat 很關鍵:數學解答可被判分,系統實驗條件是否等同人類競賽、是否可復現、是否使用未公開後處理,仍需要獨立審查。同期 IMO-Bench 提供 AnswerBench、ProofBench 和 GradingBench,目標是評估短答案、長證明和自動評分。
第三條線是幾何與 neuro-symbolic。AlphaGeometry2 在 2025 年 arXiv 論文中報告,其語言覆蓋從 IMO 2000-2024 幾何題的 66% 提升到 88%,整體解決率提升到 84%。它不是通用聊天模型,而是 Gemini 架構語言模型、幾何表示語言、符號引擎、合成數據和搜索機制的組合。這說明:在幾何這種結構化強、構造關鍵的領域,神經模型和符號系統的耦合仍然非常有競爭力。
第四條線是 benchmark 反擊。Omni-MATH 提供 4428 道奧賽級數學題;FrontierMath 由專家設計未公開新題,避免公開題庫汙染;MathArena 使用最新競賽題進行實時評測;VAR-MATH 把固定數值題改造成參數化多實例題,以測試模型是否真正掌握結構。論文之間的共同信號是:舊 benchmark 的高分越來越不夠用。
代表論文分組解讀
1. 從答案題到 verifier:MATH、GSM8K、Minerva、過程監督
MATH 和 GSM8K 是這條路線的基礎設施。MATH 的價值在於提供競賽級題目和逐步解答;GSM8K 則使“訓練 verifier、從多候選答案中選擇”成為數學推理的早期成功範式。Minerva 進一步證明,技術語料和 LaTeX 結構對數學能力有直接幫助。
過程監督論文《Let's Verify Step by Step》把監督信號從最終答案移動到中間步驟,釋放了一個重要思想:數學推理訓練不能只獎勵結論,還要獎勵可檢查的局部進展。後來的 PRM、ORM、self-consistency、best-of-N 和 test-time compute 都圍繞這個思想展開。侷限也很明顯:人類標註步驟昂貴,LLM judge 容易偏好流暢文本,最終仍無法替代形式化檢查。
2. Autoformalization:把自然語言數學翻譯到 Lean
ProofNet 是 autoformalization 研究的重要 benchmark:它包含本科數學的自然語言陳述、自然語言證明和 Lean 形式化陳述。LeanDojo 則進一步提供可交互環境、前提檢索、proof state 數據和 ReProver,使研究者可以在開源環境裡訓練 Lean prover。
2024 年的“Improving Autoformalization using Type Checking”提出用類型檢查和 self-consistency 過濾形式化結果,並指出評測本身也需要修正。這個方向的關鍵不是讓 LLM 寫出漂亮的 Lean 代碼,而是判斷形式化命題是否忠實表達原題。形式化命題寫錯時,即使證明通過,也只是在證明另一個問題。
3. Neural theorem proving:檢索、搜索、RL 與編譯器反饋
DeepSeek-Prover-V1 用大規模合成 Lean 4 數據訓練證明模型,DeepSeek-Prover-V1.5 加入 proof assistant feedback、RLPAF 和 RMaxTS 搜索;DeepSeek-Prover-V2 再進一步使用強模型做遞歸子目標分解,合成 cold-start 數據,再用強化學習提升證明能力。它報告在 miniF2F-test 上達到很高 pass ratio,並引入 ProverBench;這些數字應按論文設置理解,不能直接等價於“自動證明任意數學”。
Kimina-Prover Preview 的啟發在於,它把證明過程視為一種顯式的 formal reasoning pattern:模型不只輸出 tactic,而是圍繞 proof state 做規劃、試錯和修正。Leanabell-Prover-V2 則更強調 verifier-integrated long CoT,讓模型在 Lean 錯誤信息中學習自我修正。LEAP 的貢獻是把 agentic framework 引入正式數學:一般 LLM 可以先寫藍圖,再不斷調用 Lean 編譯器反饋,逐步壓縮證明空間。
這條線的工程瓶頸非常具體:Lean 環境版本、mathlib commit、依賴索引、proof state 序列化、premise retrieval、tactic 超時、並行採樣預算,都會顯著影響結果。論文裡的 pass@k 不是單一模型能力,而是模型、搜索器、檢索器、編譯器和計算預算的組合指標。
4. 幾何路線:AlphaGeometry2 與符號引擎仍然重要
AlphaGeometry 和 AlphaGeometry2 提醒我們,不要把數學推理簡化成“更大 LLM + 更長 CoT”。幾何題的關鍵經常是構造輔助點、線、圓或發現隱藏相似關係。純自然語言模型可能知道很多定理,但缺少系統搜索構造的機制。
AlphaGeometry2 通過擴展幾何語言、改進符號引擎、知識共享搜索樹和合成數據,把覆蓋率和解題率推高。它的強項也正是侷限:系統依賴領域表示語言和專門符號引擎,遷移到代數、數論、組合或研究數學時需要重新設計結構。
5. 奧賽與前沿 benchmark:高分之後更需要謹慎
Gemini Deep Think 在 IMO 2025 的表現說明,自然語言 reasoning model 已經能在極高難度的短題上給出可判分證明。Google DeepMind 官方博客寫明其方法基於自然語言,而非 2024 年 AlphaProof/AlphaGeometry 那樣的形式化翻譯流程;同時也說明,未來更有價值的系統可能結合自然語言流暢性和形式化驗證。
但評測解釋必須剋制。IMO 題每年只有 6 道,統計樣本很小;公開聲明通常無法完全復現實驗條件;證明評分需要專家;模型可能經過大量 test-time compute、專門提示和人工流程設計。MathArena 的發現也說明,在 USAMO 這類 proof-writing 任務上,頂級模型與答案題表現之間仍有明顯落差。
方法對比表
| 路線 | 代表工作 | 核心機制 | 適合問題 | 主要風險 |
|---|---|---|---|---|
| 答案題 + 多采樣 | GSM8K、MATH、Minerva、self-consistency | 生成多個候選,按答案或 verifier 選擇 | 算術、代數、AIME 類短答案 | 碰巧答對、題庫汙染、步驟不可查 |
| 過程監督 / PRM | Let's Verify Step by Step、PRM800K | 對中間步驟給反饋 | 長鏈推理訓練、候選排序 | 標註昂貴,judge 偏差,不能保證證明正確 |
| Autoformalization | ProofNet、type-check filtering | 自然語言陳述到 Lean 命題 | 本科數學、定理庫建設 | 命題不忠實、等價性難判 |
| Lean prover | LeanDojo、DeepSeek-Prover、Kimina-Prover、LEAP | 檢索前提、搜索 proof state、編譯器反饋、RL | 機器可檢查證明 | 依賴版本與算力,pass@k 難比較 |
| Neuro-symbolic geometry | AlphaGeometry2 | LLM 提議構造,符號引擎證明 | IMO 幾何 | 領域專用,遷移成本高 |
| 實時與前沿 benchmark | MathArena、FrontierMath、IMO-Bench、VAR-MATH | 新鮮題、原創題、參數化題、證明評分 | 抗汙染評測 | 成本高、樣本少、評分一致性難 |
實驗與 benchmark 如何看
讀數學推理論文時,建議先看任務類型。短答案題、證明題、形式化證明題和研究級開放題不能混在一起比較。AIME 可能只需要一個整數答案;USAMO 需要完整證明;miniF2F 需要 proof assistant 接受;FrontierMath 則試圖逼近專業數學家數小時到數天的工作量。
第二,看是否區分 pass@1、pass@k、best-of-N 和搜索預算。一個模型 pass@1 強,說明單次生成質量高;pass@8192 強,可能說明大規模採樣和驗證器很有效。兩者都重要,但研究含義不同。
第三,看形式化環境是否固定。Lean 4 版本、mathlib commit、允許使用的 tactic、超時設置、檢索庫和是否允許 sorry 都會改變結果。沒有這些信息,形式化證明實驗很難復現。
第四,看 benchmark 是否新鮮。MathArena 的思路值得關注,因為它在競賽題發佈後儘快評測,減少數據汙染。VAR-MATH 的參數化多實例也很重要,因為它測試的是結構泛化,而不是記住某個數值題。
第五,看 human grading 與 auto-grading 的關係。IMO-Bench 的 GradingBench 試圖評估自動評分與人工評分的一致性,這是長證明評測必須面對的問題。一個 AI 解答“看起來像證明”,不等於在競賽規則下能拿滿分。
可復現性與數據問題
數學推理的可復現性比普通 NLP 更復雜。對於自然語言模型,研究者需要公佈提示、採樣溫度、候選數、工具權限、是否使用搜索、是否使用人工篩選。對於 Lean prover,還要公佈 Lean 版本、mathlib commit、依賴安裝方式、編譯緩存、搜索器配置和硬件預算。
數據汙染是最大隱患之一。MATH、GSM8K、AIME、IMO 歷史題、ProofNet、miniF2F 的題面和解答都高度公開,許多模型訓練集可能已經間接包含。即使題目本身沒進入訓練集,講義、論壇、解析視頻和模型生成數據也可能包含類似解法。未來更可信的評測會依賴三類設計:未公開原創題、實時競賽題、參數化變體題。
另一個被低估的問題是“形式化命題忠實性”。如果 autoformalizer 把自然語言題面翻譯成更弱命題,prover 很容易通過;如果翻譯成更強命題,模型可能被不公平懲罰。因此,autoformalization 評測需要人工或符號等價檢查,而不能只看 type-check。
侷限與爭議
第一,奧賽表現不等於研究數學。IMO 題很難,但通常是短程、封閉、可判分問題。研究數學需要定義新概念、整合長文獻、構建理論框架和寫出可複用引理庫。
第二,形式化證明不等於數學理解。Lean 接受一個 proof script,說明它在給定形式系統中成立;但模型是否理解證明的關鍵想法、能否遷移到相鄰定理、能否解釋給數學家,仍需額外評測。
第三,test-time scaling 有成本問題。大量採樣、樹搜索、編譯器交互和 verifier reranking 可以顯著提升得分,但也會帶來算力不可比、延遲過高和不可復現實驗設置。
第四,自動評分會被優化。只要 benchmark 與 judge 固定,模型就可能學會迎合評分器,而不是提升數學能力。證明任務尤其需要獨立專家抽查和 adversarial grading。
第五,公開代碼與模型仍不充分。DeepSeek、Kimina、LeanDojo 等開放路線很有價值,但許多最強系統只發布博客或有限技術細節。對學術研究者來說,可復現系統比 headline 更重要。
適合研究生繼續做的選題
- 忠實 autoformalization 評測:構建自然語言命題、Lean 命題和人工等價標籤,研究“證明通過但題意錯”的檢測方法。
- Lean proof state 診斷數據集:收集失敗 proof state、錯誤信息、修復動作和人類解釋,訓練更可靠的 verifier-aware prover。
- 參數化奧賽 benchmark:把 AIME/AMC/USAMO 風格題改造成可生成族,評估模型是否掌握不變量而非記憶數字。
- 低預算 theorem proving:研究 pass@1、pass@8 或單 GPU 條件下的證明策略,避免只靠海量採樣。
- 自然語言證明到 Lean 藍圖:讓模型先生成結構化 proof plan,再由專門 prover 填 tactic,分析藍圖質量與最終通過率關係。
- 幾何構造的可解釋搜索:復現或改造 AlphaGeometry 式思路,比較神經構造、Wu 方法、DDAR 和人類輔助構造。
- 長證明自動評分:圍繞 IMO-Bench/MathArena 風格任務,研究 rubric-aware grading、局部錯誤定位和人機一致性。
總結
LLM 數學推理的前沿正在從“會做題”轉向“會證明、會驗證、會在新題上穩定泛化”。自然語言 reasoning model 給出了強探索能力,Lean 和 mathlib 提供了機器可檢查的正確性,實時競賽和原創 benchmark 正在修補汙染問題。未來最值得關注的系統,可能不是單獨的聊天模型或單獨的證明器,而是能夠在自然語言想法、形式化命題、編譯器反饋、搜索預算和專家評審之間來回切換的數學研究助手。
對研究者而言,下一步不要只追逐更高 AIME 或 miniF2F 分數。更有價值的問題是:模型證明的到底是不是原題?它為什麼選擇某個引理?失敗時能不能定位錯誤?在新鮮題、變體題和研究級定理上是否仍然有效?這些問題決定了數學推理能否從競賽展示走向真正可靠的科研工具。
參考資料
檢索日期:2026-07-11。以下鏈接優先使用論文、官方博客、官方項目頁或 benchmark 頁面;快速變化的模型可用性、榜單分數、代碼倉庫狀態和未同行評議預印本結論,發佈前建議人工複核。
- Dan Hendrycks et al., “Measuring Mathematical Problem Solving With the MATH Dataset”, arXiv, 2021. https://arxiv.org/abs/2103.03874
- Karl Cobbe et al., “Training Verifiers to Solve Math Word Problems”, arXiv, 2021. https://arxiv.org/abs/2110.14168
- Aitor Lewkowycz et al., “Solving Quantitative Reasoning Problems with Language Models”, arXiv, 2022. https://arxiv.org/abs/2206.14858
- Hunter Lightman et al., “Let’s Verify Step by Step”, arXiv, 2023. https://arxiv.org/abs/2305.20050
- Kunhao Zheng, Jesse Michael Han, Stanislas Polu, “MiniF2F: a cross-system benchmark for formal Olympiad-level mathematics”, arXiv, 2021. https://arxiv.org/abs/2109.00110
- Zhangir Azerbayev et al., “ProofNet: Autoformalizing and Formally Proving Undergraduate-Level Mathematics”, arXiv, 2023. https://arxiv.org/abs/2302.12433
- Kaiyu Yang et al., “LeanDojo: Theorem Proving with Retrieval-Augmented Language Models”, arXiv, 2023. https://arxiv.org/abs/2306.15626
- Lean official website, “Lean Programming Language”. https://lean-lang.org/
- Lean community, “A mathlib overview”. https://leanprover-community.github.io/mathlib-overview.html
- Huajian Xin et al., “DeepSeek-Prover: Advancing Theorem Proving in LLMs through Large-Scale Synthetic Data”, arXiv, 2024. https://arxiv.org/abs/2405.14333
- Huajian Xin et al., “DeepSeek-Prover-V1.5: Harnessing Proof Assistant Feedback for Reinforcement Learning and Monte-Carlo Tree Search”, arXiv, 2024. https://arxiv.org/abs/2408.08152
- Z. Z. Ren et al., “DeepSeek-Prover-V2: Advancing Formal Mathematical Reasoning via Reinforcement Learning for Subgoal Decomposition”, arXiv, 2025. https://arxiv.org/abs/2504.21801
- Haiming Wang et al., “Kimina-Prover Preview: Towards Large Formal Reasoning Models with Reinforcement Learning”, arXiv, 2025. https://arxiv.org/abs/2504.11354
- Xingguang Ji et al., “Leanabell-Prover-V2: Verifier-integrated Reasoning for Formal Theorem Proving via Reinforcement Learning”, arXiv, 2025. https://arxiv.org/abs/2507.08649
- Po-Nien Kung et al., “LEAP: Supercharging LLMs for Formal Mathematics with Agentic Frameworks”, arXiv, 2026. https://arxiv.org/abs/2606.03303
- Yuri Chervonyi et al., “Gold-medalist Performance in Solving Olympiad Geometry with AlphaGeometry2”, arXiv, 2025. https://arxiv.org/abs/2502.03544
- Google DeepMind, “AI achieves silver-medal standard solving International Mathematical Olympiad problems”, 2024. https://deepmind.google/blog/ai-solves-imo-problems-at-silver-medal-level/
- Google DeepMind, “Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad”, 2025. https://deepmind.google/blog/advanced-version-of-gemini-with-deep-think-officially-achieves-gold-medal-standard-at-the-international-mathematical-olympiad/
- Thang Luong et al., “Towards Robust Mathematical Reasoning”, arXiv, 2025. https://arxiv.org/abs/2511.01846
- Mislav Balunović et al., “MathArena: Evaluating LLMs on Uncontaminated Math Competitions”, arXiv, 2025. https://arxiv.org/abs/2505.23281
- Bofei Gao et al., “Omni-MATH: A Universal Olympiad Level Mathematic Benchmark For Large Language Models”, arXiv, 2024. https://arxiv.org/abs/2410.07985
- Elliot Glazer et al., “FrontierMath: A Benchmark for Evaluating Advanced Mathematical Reasoning in AI”, arXiv, 2024. https://arxiv.org/abs/2411.04872
- Jian Yao, Ran Cheng, Kay Chen Tan, “VAR-MATH: Probing True Mathematical Reasoning in LLMs via Symbolic Multi-Instance Benchmarks”, arXiv, 2025. https://arxiv.org/abs/2507.12885
- Auguste Poiroux, Gail Weiss, Viktor Kunčak, Antoine Bosselut, “Improving Autoformalization using Type Checking”, arXiv, 2024. https://arxiv.org/abs/2406.07222