日期:2026-07-10
適合讀者:研究生、AI4Science 研究者、科學計算與實驗自動化方向讀者、有工程背景的技術讀者
檢索日期:2026-07-10
摘要
AI for Science 正在從“給科學家提供模型和工具”,走向“參與科學流程本身”。AlphaFold、GNoME、AlphaGenome 等基礎模型說明,深度學習可以在蛋白結構、材料穩定性、基因調控等高價值問題上形成新的預測層;Coscientist、AI co-scientist、Robin、The AI Scientist-v2、AlphaEvolve、AutoLabs 和 2026 年若干 self-driving lab 預印本則把問題推進到另一層:AI 能否提出假設、設計實驗、調用仿真或儀器、分析結果,再把證據反饋給下一輪搜索?
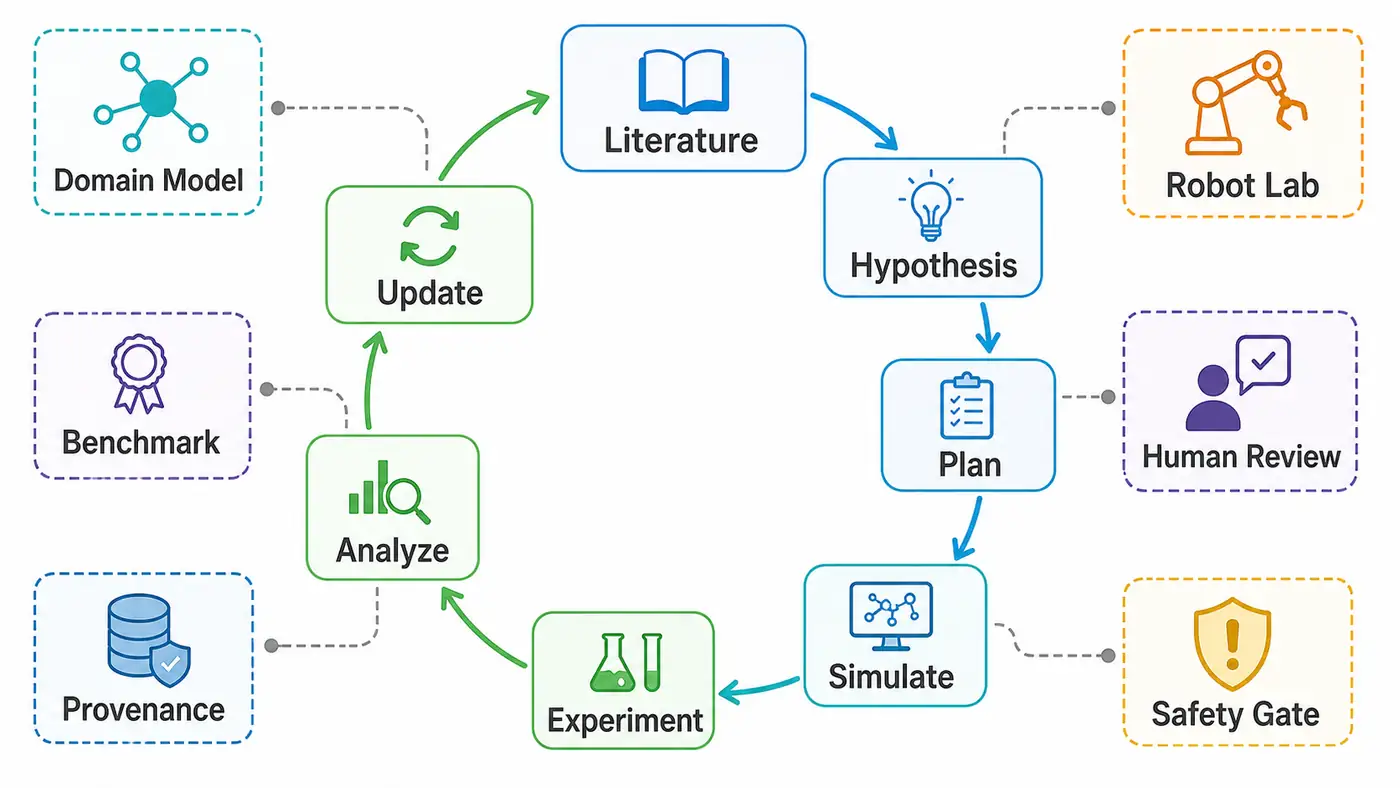
這篇文章的核心判斷是:AI for Science 的前沿不再只是“模型精度”,而是科學工作流的閉環能力。真正困難的地方包括假設是否新穎且可證偽、實驗是否可執行、數據和代碼是否可復現、自動評價是否可靠、失敗實驗是否被記錄,以及人類專家如何在安全邊界內接入系統。
目錄
- 研究背景:從科學預測模型到科研閉環
- 核心科學問題:AI 到底在科學流程中做什麼
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:從科學預測模型到科研閉環
過去十年,AI for Science 最成功的範式是“用機器學習替代或加速科學流程中的一個昂貴環節”。在蛋白結構預測中,AlphaFold 系列把氨基酸序列到三維結構的預測推到接近實驗可用的水平;在材料科學中,GNoME 用圖神經網絡和 DFT 驗證擴大候選晶體空間;在基因組學中,AlphaGenome 把長 DNA 序列映射到多種調控屬性和變異效應。這些工作都很重要,但它們通常仍處在科學流程的某個局部環節:預測結構、篩選候選、解釋變異或優化算法。
2024-2026 年的變化,是 LLM、工具調用、多 Agent、自動化實驗室和科學基礎模型開始被拼成更完整的工作流。系統不只回答“這個分子可能是什麼結構”,而是嘗試回答“下一步應該提出什麼假設、做哪個實驗、用什麼指標驗收、如果失敗如何改計劃”。這使 AI for Science 從單點模型問題,變成一個包含知識檢索、因果解釋、實驗設計、執行控制、數據治理和人機協作的系統問題。
需要先劃清邊界:本文討論的“閉環”不等於完全無人科學家。多數系統仍有強人工邊界,例如人類定義目標、審查假設、提供溼實驗資源、批准危險操作、解釋異常結果。更準確的說法是,AI 正在承擔越來越多可形式化、可執行、可評價的科研子流程。
核心科學問題:AI 到底在科學流程中做什麼
AI for Science 的研究問題可以拆成六層。
第一層是科學表徵:蛋白、材料、基因組、細胞圖像、物理場、實驗譜圖如何被編碼?這對應 AlphaFold、GNoME、AlphaGenome、神經算子、擴散生成模型和多模態科學模型。
第二層是知識綜合:系統是否能從論文、數據庫、專利、實驗記錄和負結果中抽取可用事實?這不是普通 RAG,因為科學知識有單位、條件、劑量、儀器參數、統計顯著性和反例。
第三層是假設生成:AI 生成的不是“聽起來合理”的文字,而是可測試、可證偽、有機制解釋、能和已有證據區分開的研究假設。Google Research 的 AI co-scientist、FutureHouse 的 Robin 和 Sakana AI 的 The AI Scientist 系列都在這一層發力。
第四層是實驗設計與執行:從自然語言目標到實驗 protocol、仿真腳本、機器人 API、雲實驗室指令或高通量篩選方案。Coscientist、ChemCrow、AutoLabs 和 self-driving labs 屬於這一類。
第五層是結果解釋與更新:實驗數據不能只被模型總結成“成功/失敗”。閉環系統需要把譜圖、圖像、RNA-seq、性能曲線和負結果轉化為下一輪決策。
第六層是評測與治理:科學任務常常沒有短期標準答案。系統必須說明證據來源、實驗條件、失敗路徑、潛在汙染、人工干預點和安全邊界。
近一年論文路線圖
2025 年的主線之一是“科研 Agent 化”。Google Research 發佈 AI co-scientist,把 Gemini 2.0、多 Agent、生成-辯論-演化和 test-time compute 結合起來,用於藥物再利用、肝纖維化靶點和抗微生物耐藥機制等生物醫學任務。FutureHouse 的 Robin 把文獻 Agent 與數據分析 Agent 串起來,圍繞乾性年齡相關性黃斑變性提出治療策略,並在 lab-in-the-loop 框架中驗證候選藥物。Sakana AI 的 The AI Scientist-v2 進一步把 ML 研究中的想法生成、實驗、寫作和自動審稿做成端到端樹搜索系統,並宣稱有 AI 生成論文通過 ICLR workshop 評審;這一點有標誌意義,但質量、審稿標準和可復現性仍應謹慎看待。
第二條主線是“可驗證發現”。AlphaEvolve 用 LLM 生成和修改代碼,再由自動評價器篩選候選程序,適合數學、算法和計算基礎設施這類可以明確打分的科學問題。它比普通科研聊天助手更接近科學閉環,因為每個候選解都必須運行、計分、進入演化數據庫,再影響下一輪搜索。
第三條主線是“自動實驗室”。Coscientist 早在 2023 年已經展示 GPT-4 驅動的化學實驗規劃和液體處理器控制;2025-2026 年的 AutoLabs、A-Lab GPSS、SARA-H、AHOIS 等工作繼續把 LLM、多 Agent、自校正、主動學習和機器人實驗結合起來。這裡的新信號不是機器人能做實驗,而是系統開始把“異常觀測、失敗樣本、專家反饋、代理測量和中間觀測”納入決策。
第四條主線是“評測體系跟上”。PaperBench、MLE-bench、MLRC-Bench、FML-bench、ScienceAgentBench、AInsteinBench 等 benchmark 試圖分別評估論文復現、機器學習工程、研究競賽、基礎 ML 研究探索、科學數據分析和科學代碼倉庫任務。它們共同說明一個事實:如果沒有可執行任務、專家 rubric 和新鮮數據,科研 Agent 的能力很容易被 LLM-as-a-judge 或漂亮報告高估。
代表論文分組解讀
1. 科學基礎模型:把自然對象變成可計算表徵
AlphaFold 3 將結構預測從單鏈蛋白擴展到蛋白、DNA、RNA、小分子配體、離子和修飾之間的相互作用;AlphaGenome 則面向基因調控,輸入長達百萬鹼基的 DNA 序列,輸出多種分子屬性和變異效應預測;GNoME 用圖網絡和主動學習擴大材料候選空間,並把穩定材料候選交給 Materials Project 這樣的開放數據庫。
這些模型的共同價值是給科學流程提供“可調用的預測器”。但它們本身不等於閉環發現。預測結果還要經過實驗驗證、誤差分析、適用域判斷和下游目標函數設計。以材料發現為例,熱力學穩定性不等於可合成、可加工、可規模化,也不等於具備目標應用所需的全部性質。
2. 科研 Agent:從文獻綜述走向假設競爭
AI co-scientist 的關鍵不是“幫忙查論文”,而是把科學方法拆成若干角色:生成、反思、排序、演化、鄰近性檢查和元審查。系統用 tournament 和 Elo 式自動評價推動假設迭代,並允許科學家提供 seed idea 或自然語言反饋。官方博客和 arXiv 論文都強調它是協作工具,而不是替代科學家。
Robin 的特點是更貼近生物醫學發現循環:文獻搜索、假設生成、實驗建議、數據分析和新假設更新被整合到一個多 Agent 流程中。它的強處是把溼實驗結果納入下一輪推理;需要謹慎的地方是,單個疾病案例的成功不能直接外推到所有生物醫學問題。
The AI Scientist-v2 代表“AI 研究自動化”的激進路線。它針對機器學習研究,讓系統自動提出方法、寫代碼、跑實驗、畫圖、寫論文並響應審稿反饋。獨立評估已經指出早期版本存在新穎性誤判、實驗失敗、引用不足和幻覺數字等問題。因此,這條線最值得研究的不是“AI 是否會寫論文”,而是怎樣設計嚴謹的 novelty check、實驗 oracle、審稿協議和失敗追蹤。
3. 可驗證算法發現:當科學問題有明確評價器
AlphaEvolve、FunSearch、AlphaDev 和 AlphaTensor 屬於更容易閉環的科學發現路線:候選解可以寫成程序,程序可以被運行,結果可以被自動評價。AlphaEvolve 的官方資料顯示,它把 Gemini 模型、程序數據庫、提示採樣和演化選擇結合起來,用自動評價器驗證候選算法。
這類系統的重要啟發是:科研 Agent 最先可靠突破的場景,往往不是最開放的假設空間,而是存在清晰 objective、可執行驗證器和大量廉價試錯的空間。數學構造、算法優化、編譯器優化、科學計算 kernel、模擬器參數搜索,可能會比“泛化到所有科學假設”更早成熟。
4. 自動實驗室:把 AI 決策接到儀器和樣本
Coscientist 展示了 LLM 如何調用網絡搜索、文檔檢索、代碼執行和實驗自動化 API,完成合成規劃、液體處理器控制和交叉偶聯反應設計。ChemCrow 則把化學工具接入 LLM,強調分子性質、反應規劃和外部工具的組合。
Self-driving lab 的傳統核心是主動學習或貝葉斯優化:模型根據已有實驗選擇下一批最有信息量的實驗。2025-2026 年的新工作開始引入更復雜的多階段決策和 LLM 推理,例如 A-Lab GPSS 面向空氣敏感鋰鹵化物尖晶石導體,SARA-H 結合自動相識別和人類反饋,AutoLabs 評估多 Agent 自校正在實驗 protocol 生成中的作用,AHOIS 則嘗試讓物理 critic 通過蘇格拉底式追問修正假設。這些預印本的具體數值和結論需要發佈前再次核驗,但方向很清楚:實驗閉環正在從“優化一個黑箱函數”走向“解釋異常、提出機制、調整流程”。
方法對比表
| 路線 | 代表工作 | 核心能力 | 適合任務 | 主要風險 |
|---|---|---|---|---|
| 科學基礎模型 | AlphaFold 3、AlphaGenome、GNoME | 從科學對象到預測表徵 | 結構、材料、基因調控、物理場預測 | 適用域、實驗驗證、數據偏差 |
| 假設生成 Agent | AI co-scientist、Robin | 文獻綜合、假設生成、排序和更新 | 生物醫學靶點、藥物再利用、機制解釋 | 幻覺、新穎性誤判、證據鏈薄弱 |
| 自動科研流水線 | The AI Scientist-v2 | 想法、實驗、寫作、審稿閉環 | 機器學習研究原型 | 論文質量、引用、結果可復現性 |
| 可驗證算法發現 | AlphaEvolve、FunSearch | 生成程序並用評價器篩選 | 數學、算法、科學計算優化 | 目標函數過窄、過擬合評價器 |
| 自驅實驗室 | Coscientist、AutoLabs、A-Lab GPSS、SARA-H | protocol 生成、機器人執行、主動學習 | 化學、材料、高通量實驗 | 儀器安全、樣本汙染、數據質量 |
| 科研評測 | PaperBench、MLE-bench、MLRC-Bench、ScienceAgentBench | 用可執行任務和 rubric 測能力 | 論文復現、ML 工程、科學數據分析 | 評測汙染、成本高、覆蓋不全 |
實驗與 benchmark 如何看
讀 AI for Science 論文時,不要只看 headline。至少要問六個問題。
第一,任務是否有真實科學價值?在 Kaggle、合成 benchmark 或 toy lab 上成功,不等於能產生可發表的新科學發現。相反,真實科研任務通常目標模糊、實驗昂貴、負結果多、評價慢。
第二,評價器是否獨立可靠?AlphaEvolve 這類系統之所以有說服力,是因為候選程序可以被自動運行和驗證。開放假設生成更難,因為 LLM 自評、Elo 排名或 AI reviewer 可能獎勵流暢性和常識一致性,而不是科學新穎性。
第三,有沒有人類專家基線?PaperBench 和 MLRC-Bench 的價值在於把任務拆成可評分子目標,並儘量引入人類專家或競賽成績作為參照。沒有基線的“AI 發現”容易被高估。
第四,失敗樣本是否公開?科研閉環最有價值的數據往往是失敗實驗、錯誤假設和被否定的路線。如果論文只展示成功案例,很難判斷系統是否真正會科學推理。
第五,數據是否可能洩漏?文獻、代碼、benchmark、競賽榜單和實驗 protocol 都可能進入模型訓練集。越接近公開論文復現和已知競賽,越需要新鮮任務和去汙染設計。
第六,實驗資源是否可復現?溼實驗依賴儀器、試劑批次、環境控制和操作細節;計算實驗依賴隨機種子、GPU、依賴版本和隱藏 prompt。沒有完整 provenance,閉環很難被獨立驗證。
可復現性與數據問題
AI for Science 比普通 LLM 應用更怕“看起來合理”。科學輸出如果不可復現,代價不是用戶體驗下降,而是浪費實驗資源,甚至誤導後續研究。一個可靠系統至少要保存四類記錄:輸入知識來源、模型和 prompt 版本、實驗或仿真執行日誌、以及所有成功和失敗結果。
材料科學中的 GNoME/A-Lab 爭議提醒我們,自動化系統的瓶頸常常不在生成候選,而在候選是否真的是新結構、是否被正確表徵、是否有足夠證據支持“合成成功”。生物醫學中的藥物再利用也類似:細胞實驗陽性只是早期信號,不等於機制確認、動物實驗有效或臨床可行。
因此,未來 AI for Science 的數據基礎設施會和模型同等重要。負結果數據庫、實驗 protocol 標準、機器可讀論文、樣本元數據、儀器日誌、可執行 notebook、代碼容器和開放 benchmark,都會決定閉環系統能否真正學習。
侷限與爭議
第一,自動假設生成容易產生“合理但平庸”的想法。許多系統善於組合公開文獻,但真正新穎的科學問題往往來自反常現象、隱性實驗經驗和長期領域直覺。
第二,自動評價可能獎勵錯誤目標。一個假設在 LLM 評審中得分高,不代表它可驗證;一個程序在 benchmark 上表現好,也可能只是對評價器過擬合。
第三,實驗自動化帶來安全邊界。化學、生物、材料實驗涉及危險試劑、汙染、雙用途知識和昂貴設備。Agent 不能直接擁有無限制儀器權限,必須有 safety gate、權限分層和人工審批。
第四,跨學科合作仍是瓶頸。AI 研究者常低估實驗誤差、樣本製備和數據標註成本;領域科學家也可能低估模型適用域和評測汙染。真正可用的系統需要兩邊共同定義 objective 和 failure mode。
第五,2026 年新預印本變化很快。本文納入的 AutoScientists、AHOIS、A-Lab GPSS 等工作應被視為趨勢信號,涉及 benchmark 分數、實驗規模和系統能力的數字在正式發佈前需要人工複核。
適合研究生繼續做的選題
- 科學假設的 novelty check:結合文獻圖譜、知識圖譜、時間切分數據庫和專家標註,評價一個假設是否只是舊知識重述。
- 負結果驅動的科研 Agent:讓失敗實驗進入記憶和規劃,而不是隻保留成功軌跡。
- 科學 protocol 到可執行代碼:面向某一類儀器或仿真軟件,構建可驗證的自然語言到 protocol 編譯器。
- 實驗閉環的 provenance 標準:為 Agent 生成的假設、實驗、數據和圖表設計機器可讀審計日誌。
- 跨模態科學數據評測:把譜圖、顯微圖、表格、代碼和文本放在同一任務中,避免只評測純文本問答。
- LLM 與貝葉斯優化融合:讓 LLM 負責機制解釋、約束生成和異常診斷,讓 BO 負責數據高效搜索。
- AI reviewer 的校準:研究自動審稿系統何時和人類專家一致,何時偏好流暢敘述而非真實貢獻。
總結
AI for Science 的第三階段正在形成:第一階段是科學預測模型,第二階段是科研助手和工具增強,第三階段是能在受控範圍內循環“讀文獻、提假設、做實驗、看結果、再更新”的閉環系統。短期內,最可靠的突破會出現在評價器清晰、實驗可自動化、失敗可記錄的領域,例如算法發現、科學計算優化、高通量材料篩選和特定生物醫學假設驗證。
更長遠看,科研 Agent 的價值不在於寫出更多論文,而在於把科學探索變得更可審計、更數據高效、更能積累失敗經驗。真正值得期待的不是無人科學家神話,而是人類科學家和 AI 系統共同維護一個可驗證、可復現、可持續更新的發現循環。
參考資料
檢索日期:2026-07-10。
- Hengjie Yu, Yaochu Jin, “AI for Science: Current progress and pathways forward.” arXiv, 2025. https://arxiv.org/abs/2503.05822
- Jiaqi Wei et al., “From AI for Science to Agentic Science: A Survey on Autonomous Scientific Discovery.” arXiv, 2025. https://arxiv.org/abs/2508.14111
- Fan Liu et al., “Foundation Models for Scientific Discovery: From Paradigm Enhancement to Paradigm Transition.” arXiv, 2025. https://arxiv.org/abs/2510.15280
- Josh Abramson et al., “Accurate structure prediction of biomolecular interactions with AlphaFold 3.” Nature, 2024. https://www.nature.com/articles/s41586-024-07487-w
- Google DeepMind, “AlphaGenome: AI for better understanding the genome.” 2025-06-25, updated 2026-01. https://deepmind.google/blog/alphagenome-ai-for-better-understanding-the-genome/
- Amil Merchant et al., “Scaling deep learning for materials discovery.” Nature, 2023. https://www.nature.com/articles/s41586-023-06735-9
- Google DeepMind, “Millions of new materials discovered with deep learning.” 2023-11-29. https://deepmind.google/blog/millions-of-new-materials-discovered-with-deep-learning/
- Daniil A. Boiko et al., “Autonomous chemical research with large language models.” Nature, 2023. https://www.nature.com/articles/s41586-023-06792-0
- Andres M. Bran et al., “ChemCrow: Augmenting large-language models with chemistry tools.” arXiv, 2023. https://arxiv.org/abs/2304.05376
- Juraj Gottweis et al., “Towards an AI co-scientist.” arXiv, 2025. https://arxiv.org/abs/2502.18864
- Google Research, “Accelerating scientific breakthroughs with an AI co-scientist.” 2025-02-19. https://research.google/blog/accelerating-scientific-breakthroughs-with-an-ai-co-scientist/
- Ali Essam Ghareeb et al., “Robin: A multi-agent system for automating scientific discovery.” arXiv, 2025. https://arxiv.org/abs/2505.13400
- Chris Lu et al., “The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery.” arXiv, 2024. https://arxiv.org/abs/2408.06292
- Yutaro Yamada et al., “The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search.” arXiv, 2025. https://arxiv.org/abs/2504.08066
- Sakana AI, “The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery.” 2024-08-13. https://sakana.ai/ai-scientist/
- Joeran Beel, Min-Yen Kan, Moritz Baumgart, “Evaluating Sakana's AI Scientist for Autonomous Research.” arXiv, 2025. https://arxiv.org/abs/2502.14297
- Alexander Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery.” arXiv, 2025. https://arxiv.org/abs/2506.13131
- Google DeepMind, “AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms.” 2025-05-14. https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
- Nathan J. Szymanski et al., “An autonomous laboratory for the accelerated synthesis of inorganic materials.” Nature, 2023. https://www.nature.com/articles/s41586-023-06734-w
- Adedire D. Adesiji et al., “Benchmarking Self-Driving Labs.” arXiv, 2025. https://arxiv.org/abs/2508.06642
- Luca Torresi, Pascal Friederich, “Multi-stage Bayesian optimisation for dynamic decision-making in self-driving labs.” arXiv, 2025. https://arxiv.org/abs/2512.15483
- Gihan Panapitiya et al., “AutoLabs: Cognitive Multi-Agent Systems with Self-Correction for Autonomous Chemical Experimentation.” arXiv, 2025. https://arxiv.org/abs/2509.25651
- Yuxing Fei et al., “Agentic LLM Reasoning in a Self-Driving Laboratory for Air-Sensitive Lithium Halide Spinel Conductors.” arXiv, 2026. https://arxiv.org/abs/2604.11957
- Xianrui Zeng et al., “Socratic agents for autonomous scientific discovery in high-dimensional physical systems.” arXiv, 2026. https://arxiv.org/abs/2606.26722
- Giulio Starace et al., “PaperBench: Evaluating AI's Ability to Replicate AI Research.” arXiv, 2025. https://arxiv.org/abs/2504.01848
- Jun Shern Chan et al., “MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering.” arXiv, 2024. https://arxiv.org/abs/2410.07095
- Yunxiang Zhang et al., “MLRC-Bench: Can Language Agents Solve Machine Learning Research Challenges?” arXiv, 2025. https://arxiv.org/abs/2504.09702
- Qiran Zou et al., “FML-bench: A Benchmark for Automatic ML Research Agents.” arXiv, 2025. https://arxiv.org/abs/2510.10472
- Titouan Duston et al., “AInsteinBench: Benchmarking Coding Agents on Scientific Repositories.” arXiv, 2025. https://arxiv.org/abs/2512.21373
- Ziru Chen et al., “ScienceAgentBench: Toward Rigorous Assessment of Language Agents for Data-Driven Scientific Discovery.” arXiv, 2024. https://arxiv.org/abs/2410.05080
- Shanghua Gao, Ada Fang, Marinka Zitnik, “AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation.” arXiv, 2026. https://arxiv.org/abs/2605.28655