日期:2026-07-07
適合讀者:研究生、軟件工程與 AI 系統方向研究者、有工程背景的技術讀者
檢索日期:2026-07-07
摘要
2024 年以前,代碼大模型的主戰場主要是“補全一個函數”“通過若干單元測試”“在競賽題上寫出答案”。2024-2026 年,研究焦點明顯轉向 Software Engineering Agents:模型不再只輸出代碼片段,而是讀取真實倉庫、定位 bug、編輯多個文件、運行測試、解釋失敗、提交補丁,甚至以異步方式參與 issue、pull request 和代碼評審流程。SWE-bench、SWE-agent、AutoCodeRover、OpenHands、Agentless、SWE-Lancer、Multi-SWE-bench、SWE-smith、Terminal-Bench 等工作共同推動了這一轉向。
這篇文章的核心判斷是:軟件工程 Agent 的進展不只是“模型更會寫代碼”,而是模型、倉庫上下文、工具接口、沙箱執行、測試 oracle、評測數據和人類審查流程的共同演化。下一階段的瓶頸也會從單點代碼生成,轉向長程任務可靠性、評測汙染、跨語言生態、權限治理、成本控制和組織級落地。
目錄
- 研究背景:從代碼補全到倉庫級任務
- 近一年路線圖:真實任務、長程任務、組織採用
- 代表論文分組解讀
- 方法對比表
- 技術趨勢:定位、補丁、驗證、沙箱和人審
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 參考資料
研究背景:為什麼軟件工程 Agent 成為系統問題
代碼生成曾經是一個相對清晰的 NLP/PL 任務:給定 docstring 或函數簽名,模型生成一個函數,通過隱藏測試即算成功。HumanEval、MBPP、APPS、CodeContests 等基準讓研究者快速比較模型的編碼能力。但真實軟件開發並不是這樣發生的。工程師面對的是不完整的 issue 描述、歷史設計約束、隱含風格、跨文件依賴、測試不充分、CI 環境差異、兼容性要求和代碼審查意見。
SWE-bench 的重要性就在於把問題從“寫代碼題”拉回真實 GitHub issue。模型需要在一個已有 Python 倉庫裡修改代碼,使原本來自真實 pull request 的問題通過測試。早期模型在 SWE-bench 上表現很弱,這不是偶然:真實倉庫任務要求模型先理解問題,再定位相關文件,隨後提出最小補丁,最後用測試反饋修正錯誤。每一步都可能失敗。
從這個角度看,Software Engineering Agents 的研究對象並不是單個 LLM,而是一套閉環系統:
- 上下文系統:如何索引倉庫、檢索相關文件、壓縮歷史信息、避免把整個倉庫塞進上下文窗口。
- 工具接口:如何讓模型安全使用 shell、編輯器、測試框架、靜態分析器、包管理器和版本控制。
- 任務循環:如何計劃、定位、修改、運行測試、解釋失敗並回滾。
- 評測體系:如何構造不被訓練集汙染、能自動執行、又接近真實工作價值的 benchmark。
- 協作邊界:什麼時候由模型自主推進,什麼時候必須交給人類審查、產品決策或安全審批。
近一年路線圖:從“能修 bug”到“能參與工程組織”
2024 年的關鍵節點是 SWE-bench、SWE-agent、AutoCodeRover、Agentless、MASAI 和 OpenHands。這一年主要回答兩個問題:真實倉庫任務能否標準化評測?Agent scaffold 是否真的必要?結果很有意思:SWE-agent 強調 Agent-Computer Interface,AutoCodeRover 強調結構化代碼搜索和 fault localization,Agentless 則指出簡單的“定位-修復-驗證”管線可以成為強基線。也就是說,複雜 Agent 不是天然勝利,好的上下文工程和驗證流程同樣重要。
2025 年的變化更像“數據和評測工業化”。Multi-SWE-bench 將 issue resolving 擴展到 Java、TypeScript、JavaScript、Go、Rust、C、C++ 等語言;SWE-smith 試圖自動合成大規模訓練任務;SWE-rebench 和 SWE-Bench++ 開始關注持續抽取新任務、降低汙染、擴大語言和倉庫覆蓋;SWE-Lancer 則把任務映射到真實 freelance 軟件工程工作價值,提醒大家“解決 benchmark”不等於“創造經濟價值”。
2026 年截至本次檢索,研究繼續向兩個方向延伸。第一是通用終端/長程任務評測,例如 Terminal-Bench 和 TUA-Bench,把軟件工程 Agent 放到更寬的命令行環境裡考察。第二是組織採用研究,例如關於 GitHub 上 agent-authored PR 的大規模數據集與採用率研究,以及命令行 coding agents 在企業內部 rollout 的實證研究。這些 2026 年論文和產品信息仍處於快速變化期,本文只把它們作為趨勢信號,具體數字需要發佈前人工複核。
代表論文分組解讀
1. 倉庫級評測:SWE-bench 家族
SWE-bench 提供了一個清晰範式:給定 issue 和倉庫快照,模型必須提交 patch,並由測試判定是否解決問題。它讓“真實 GitHub issue”成為可重複評測對象。隨後 SWE-bench Verified 由人工過濾出更可靠的子集;SWE-bench Multimodal 引入前端、圖形和用戶界面相關的視覺問題;Multi-SWE-bench 擴展到多語言生態。SWE-bench 官方站點到 2026 年仍維護 Verified、Multilingual、Lite、Full、Multimodal 等 leaderboard,並明確說明不同子集的實例數量和 resolved 指標。
但 SWE-bench 家族也暴露出評測難題。真實 issue 可能描述不完整,原始測試可能只覆蓋部分行為;benchmark 一旦長期公開,模型訓練、prompt 調參和 scaffold 適配都會帶來汙染風險;leaderboard 的“resolved”也不等價於補丁可維護、可讀、無副作用。對研究者來說,SWE-bench 更適合作為一類系統能力測試,而不是最終工程質量的唯一代理指標。
2. Agent scaffold:SWE-agent、OpenHands、MASAI
SWE-agent 的貢獻不是簡單“讓模型調用 shell”,而是提出 Agent-Computer Interface 的觀點:LLM agent 是一種新的計算機用戶,需要專門設計的查看文件、編輯文件、執行命令、解析反饋的接口。它說明同一個模型在不同接口下會表現出不同能力。
OpenHands 則把軟件開發 Agent 做成開放平臺,強調沙箱執行、多 Agent 協作、瀏覽器和命令行工具、benchmark 集成等工程要素。這類平臺對研究很關鍵:如果每篇論文都從零搭 scaffold,就很難比較模型本身、檢索策略和工具策略的貢獻。
MASAI 代表另一條路線:把軟件工程任務拆成多個有明確職責的子 Agent。定位、編輯、驗證、總結可以使用不同提示、不同上下文和不同策略。它符合工程直覺,但也帶來成本、狀態同步和錯誤傳播問題。對於生產系統,多 Agent 不是越多越好,關鍵是任務邊界是否可驗證。
3. “少即是多”的反例:Agentless
Agentless 的價值在於給複雜 Agent 降溫。它不用讓模型自由規劃長動作序列,而是把任務固定為三階段:localization、repair、patch validation。論文在 SWE-bench Lite 上展示了強競爭力,說明很多問題並不需要完全自主的長程探索,反而需要高質量定位、候選補丁生成和嚴格驗證。
這對工程落地尤其重要。企業接入 coding agent 時,第一版往往不應該追求“全自動工程師”,而應該把 agent 限制在可觀察、可回滾、可測試的管線裡。例如只允許它修 lint、補測試、升級小依賴、生成遷移草案,而不是一開始就讓它改核心架構。
4. 數據飛輪:SWE-smith、SWE-rebench、SWE-Bench++
軟件工程 Agent 的訓練數據比聊天數據難得多,因為每個樣本不只是“輸入-輸出文本”,還需要可復現環境、依賴安裝、測試 oracle、失敗軌跡和可執行補丁。SWE-smith 從 Python 倉庫自動合成會破壞測試的任務,併發布大規模訓練實例、軌跡和模型資產。SWE-rebench 強調持續從 GitHub 抽取新任務,關注去汙染評測。SWE-Bench++ 則嘗試從開源 PR 自動生成多語言倉庫級任務。
這條線很可能決定開源 software agents 的上限。沒有大規模、可執行、去汙染、跨語言的數據,研究只能圍繞少數公開 benchmark 反覆調 scaffold。未來更有價值的不是“又一個 leaderboard 結果”,而是可審計的數據生成管線、環境構建器、測試 oracle 質量控制和失敗軌跡標註。
5. 真實價值和長程能力:SWE-Lancer、HCAST、Terminal-Bench
SWE-Lancer 把任務從 GitHub issue 推向 freelance 軟件工程工作,並用真實 payout 估計任務價值。這能緩解 benchmark 與經濟價值脫節的問題,但也更難完全開放,且任務分佈可能受平臺、時間和客戶需求影響。
HCAST 和 METR 的 long-task 研究提供了另一種視角:不要只問“通過率是多少”,還要問“這個任務人類專家通常要花多久,模型在這個時間尺度上有多可靠”。Terminal-Bench 進一步把 agent 放在真實命令行環境中,考察安裝、運行、調試、數據處理等更雜的任務。這類評測對 software engineering agents 很重要,因為真正的工程工作經常失敗在環境和流程,而不是失敗在某一行代碼。
方法對比表
| 路線 | 代表工作 | 核心思想 | 優勢 | 風險 |
|---|---|---|---|---|
| 倉庫級 benchmark | SWE-bench、SWE-bench Verified、Multi-SWE-bench | 真實 issue + 可執行測試 | 任務接近真實開發,便於橫向比較 | 測試不完備、汙染、語言覆蓋不足 |
| 交互式 Agent | SWE-agent、OpenHands | 讓模型使用 shell、編輯器、測試工具 | 可閉環調試,適合複雜任務 | 軌跡長、成本高、權限風險高 |
| 結構化 SE 管線 | AutoCodeRover、Agentless | 先定位,再修復,再驗證 | 可解釋、可控、成本較低 | 對複雜跨模塊任務彈性不足 |
| 模塊化 / 多 Agent | MASAI 等 | 子 Agent 分工處理定位、編輯、驗證 | 任務邊界清晰,可替換模塊 | 協調成本和錯誤傳播 |
| 數據合成與持續抽取 | SWE-smith、SWE-rebench、SWE-Bench++ | 擴大可執行訓練和評測任務 | 支持訓練、RL、去汙染 | 任務質量控制困難 |
| 產品化異步協作 | Codex、Claude Code、GitHub Copilot cloud agent、Jules | 從 issue/任務到 branch/PR 的工作流 | 貼近日常開發流程 | 可用性、計費、權限和審查需治理 |
技術趨勢:真正的護城河在系統閉環
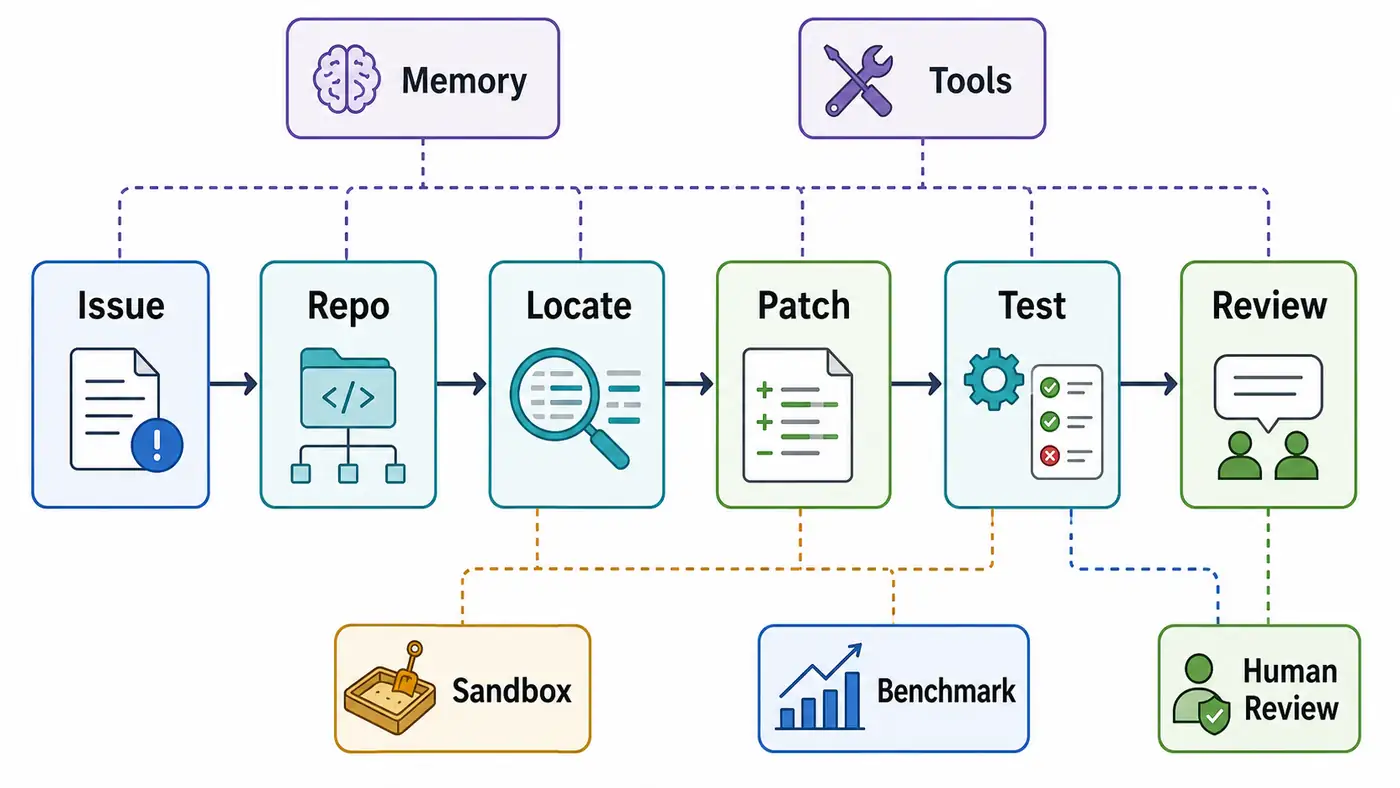
第一,代碼定位比生成更關鍵。 很多失敗不是模型不會寫 patch,而是改錯文件、漏掉隱含調用鏈、沒有理解測試意圖。未來系統會更依賴 LSP、AST、調用圖、測試覆蓋率、歷史 commit、issue 討論和運行時 trace,而不是隻靠向量檢索。
第二,測試執行正在成為 Agent 的核心感官。 Software agents 必須把 pytest、go test、npm test、mypy、eslint、CI log、benchmark script 變成可解析反饋。單純“讓模型看報錯”不夠,系統需要結構化提取失敗測試、堆棧、最近改動、環境缺失和 flaky 跡象。
第三,異步多任務會成為產品默認形態。 OpenAI Codex、GitHub Copilot cloud agent、Claude Code 和 Jules 的官方資料都在強調雲沙箱、並行任務、分支/PR、日誌和人類 review。未來開發者可能不再只和一個聊天窗口互動,而是管理多個正在跑的 agent session。
第四,評測會從靜態題庫轉向新鮮任務和組織指標。 SWE-rebench、SWE-Bench++、Terminal-Bench、AIDev 和 2026 年採用研究說明,研究社區正在把目光從“模型在公開題庫上拿多少分”轉向“真實倉庫裡 agent 產生了什麼 PR、是否被合併、有沒有引入迴歸、成本是多少”。這些指標更接近生產,但也更難開放復現。
第五,安全從 prompt policy 進入工程權限治理。 Coding agent 能讀源碼、跑命令、安裝依賴、訪問 issue、創建 PR,權限面明顯大於聊天助手。沙箱、網絡訪問、secret 隔離、審計日誌、命令 allowlist、dependency pinning、代碼所有權規則,會成為企業接入的基礎設施。
工程落地啟發
對團隊來說,最穩妥的落地路徑不是“買一個 Agent 替代工程師”,而是把任務分層。
第一層是低風險、強驗證任務:補測試、修格式、改文檔、升級小版本依賴、生成遷移草案、解釋 CI 失敗。這類任務有明確驗收條件,適合異步 agent 批量處理。
第二層是中等風險的 bug fix 和小 feature:要求 agent 先輸出計劃,說明要改哪些文件、跑哪些測試,再由人批准執行。關鍵不是讓模型一次做對,而是讓它產生可審查、可回滾的 diff。
第三層是架構級變更、核心安全邏輯和跨服務改造:目前仍應以人類主導,Agent 做代碼搜索、影響面分析、測試補全和備選方案生成。把這類任務完全交給 agent,往往會在需求理解、隱含約束和長期維護性上出問題。
工具上,團隊至少要準備四件事:
- 可復現開發環境:容器、setup script、鎖定依賴和測試命令,比 prompt 更重要。
- 倉庫級說明文件:類似 AGENTS.md、CLAUDE.md、Copilot custom instructions,明確代碼風格、測試命令、禁止事項和 review 標準。
- 權限和審計:默認無 secret、最小網絡訪問、所有命令和測試輸出留痕。
- 質量指標:不要只看生成行數,要看通過測試、review 返工率、回滾率、線上缺陷、token/算力成本和人類節省時間。
侷限與爭議
第一,benchmark resolved 不等於真實質量。一個 patch 可以通過測試但破壞未覆蓋行為;也可以寫出過擬合測試的補丁。真實工程還關心可讀性、可維護性、性能、兼容性和安全。
第二,公開 benchmark 的汙染問題會越來越嚴重。模型訓練集、檢索增強、手工 prompt 調參都可能間接看過題目或答案。持續抽取新任務、held-out 倉庫和商業閉源評測會變重要,但也會降低開放復現性。
第三,Agent 成本和可靠性仍然不穩定。長軌跡會放大 token 成本、工具調用成本和環境等待時間;一次失敗的自主探索可能比人類手動修復更貴。2026 年關於企業 rollout 和命令行 agent 的研究數字仍需發佈前人工核驗,不能把單一組織的結果直接推廣到所有團隊。
第四,安全邊界尚未成熟。Coding agent 可能誤刪文件、洩露上下文、執行惡意依賴、把 prompt injection 當成倉庫說明,或在 PR 中引入供應鏈風險。前一輪系列已經討論過 Prompt Injection 與 Agent Security;在軟件工程場景中,這些風險會更具體地落到 shell、CI、secret 和依賴系統上。
接下來值得關注的問題
- 跨語言和跨生態能力:Python 以外的構建系統、包管理器、測試框架和靜態類型系統會改變 agent 設計。
- 真實新鮮任務評測:如何在開放復現和去汙染之間取得平衡。
- 補丁質量評價:能否超越 pass/fail,自動評估可維護性、最小性、安全性和 review 成本。
- Agent 訓練數據飛輪:失敗軌跡、人工 review 評論、CI 日誌能否成為高質量 post-training 數據。
- 組織協作模式:未來工程經理需要管理的可能不是“是否使用 AI”,而是 agent session 隊列、權限、預算和審查 SLA。
總結
Software Engineering Agents 是 2026 年 AI 系統與 Agent 基礎設施中最值得長期跟蹤的主題之一。它把 LLM 能力、真實軟件工程流程、執行環境、評測體系和組織治理綁在一起。短期內,最有價值的應用不是全自動替代工程師,而是讓 agent 接管可驗證、可回滾、可審查的工程子任務。長期看,如果數據生成、去汙染評測、沙箱權限、長程可靠性和人機協作機制持續改進,軟件開發會從“人寫代碼、AI 補全”走向“人定義目標和邊界,Agent 在受控環境中提出、驗證並提交可審查變更”。
需要保守看待的是:leaderboard 會快速變化,產品能力和定價會快速變化,2026 年新論文中的組織採用數字也可能受樣本和制度強烈影響。發佈前建議再次核對官方文檔、arXiv 版本、代碼倉庫狀態和 leaderboard 數據。
參考資料
檢索日期:2026-07-07。
- Carlos E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” arXiv, 2023. https://arxiv.org/abs/2310.06770
- SWE-bench Official Leaderboards. https://www.swebench.com/
- John Yang et al., “SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.” arXiv, 2024. https://arxiv.org/abs/2405.15793
- Yuntong Zhang et al., “AutoCodeRover: Autonomous Program Improvement.” arXiv, 2024. https://arxiv.org/abs/2404.05427
- Chunqiu Steven Xia et al., “Agentless: Demystifying LLM-based Software Engineering Agents.” arXiv, 2024. https://arxiv.org/abs/2407.01489
- Daman Arora et al., “MASAI: Modular Architecture for Software-engineering AI Agents.” arXiv, 2024. https://arxiv.org/abs/2406.11638
- Xingyao Wang et al., “OpenHands: An Open Platform for AI Software Developers as Generalist Agents.” arXiv, 2024. https://arxiv.org/abs/2407.16741
- John Yang et al., “SWE-bench Multimodal: Do AI Systems Generalize to Visual Software Domains?” arXiv, 2024. https://arxiv.org/abs/2410.03859
- Daoguang Zan et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving.” arXiv, 2025. https://arxiv.org/abs/2504.02605
- Samuel Miserendino et al., “SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering?” arXiv, 2025. https://arxiv.org/abs/2502.12115
- openai/SWELancer-Benchmark. https://github.com/openai/SWELancer-Benchmark
- John Yang et al., “SWE-smith: Scaling Data for Software Engineering Agents.” arXiv, 2025. https://arxiv.org/abs/2504.21798
- Ibragim Badertdinov et al., “SWE-rebench: An Automated Pipeline for Task Collection and Decontaminated Evaluation of Software Engineering Agents.” arXiv, 2025. https://arxiv.org/abs/2505.20411
- Lilin Wang et al., “SWE-Bench++: A Framework for the Scalable Generation of Software Engineering Benchmarks from Open-Source Repositories.” arXiv, 2025. https://arxiv.org/abs/2512.17419
- Xiang Deng et al., “SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?” arXiv, 2025. https://arxiv.org/abs/2509.16941
- David Rein et al., “HCAST: Human-Calibrated Autonomy Software Tasks.” arXiv, 2025. https://arxiv.org/abs/2503.17354
- Thomas Kwa et al., “Measuring AI Ability to Complete Long Tasks.” arXiv, 2025. https://arxiv.org/abs/2503.14499
- Mike A. Merrill et al., “Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces.” arXiv, 2026. https://arxiv.org/abs/2601.11868
- Shoufa Chen et al., “TUA-Bench: A Benchmark for General-Purpose Terminal-Use Agents.” arXiv, 2026. https://arxiv.org/abs/2606.28480
- Romain Robbes et al., “Agentic Much? Adoption of Coding Agents on GitHub.” arXiv, 2026. https://arxiv.org/abs/2601.18341
- Hao Li et al., “AIDev: Studying AI Coding Agents on GitHub.” arXiv, 2026. https://arxiv.org/abs/2602.09185
- Emerson Murphy-Hill et al., “Adoption and Impact of Command-Line AI Coding Agents: A Study of Microsoft's Early 2026 Rollout of Claude Code and GitHub Copilot CLI.” arXiv, 2026. https://arxiv.org/abs/2607.01418
- OpenAI, “Introducing Codex.” 2025-05-16. https://openai.com/index/introducing-codex/
- GitHub Docs, “About GitHub Copilot cloud agent.” https://docs.github.com/en/copilot/concepts/agents/cloud-agent/about-cloud-agent
- Anthropic Docs, “Claude Code overview.” https://docs.anthropic.com/en/docs/claude-code/overview
- Google Jules official site. https://jules.google/
注:2026 年論文、產品可用性、leaderboard 排名、模型名稱和組織採用數字變化較快,本文已按 2026-07-07 檢索結果寫作,正式發佈前建議再次人工核驗。