日期:2026-07-06
適合讀者:研究生、端側 AI/推理系統工程師、關注小模型產品化的技術讀者
檢索日期:2026-07-06
摘要
2025 到 2026 年,小語言模型(Small Language Models, SLM)和端側 AI 的討論明顯從“能不能把大模型塞進手機”轉向“如何設計一套可治理、可更新、可評測的本地智能系統”。這背後有三個同時發生的變化:第一,Gemma、Qwen、Llama、Phi、SmolLM 等模型家族持續發佈 0.5B 到 4B 級別的密集模型或稀疏激活模型,強調蒸餾、多語言、長上下文和設備側適配;第二,INT8/INT4、weight-only quantization、KV cache 優化、1-bit/低比特研究和專用運行時把“參數量”之外的瓶頸暴露出來;第三,Apple Foundation Models、ExecuTorch、ONNX Runtime GenAI、llama.cpp、MLC/WebLLM、MLX 等框架讓本地推理從研究 demo 進入應用棧。
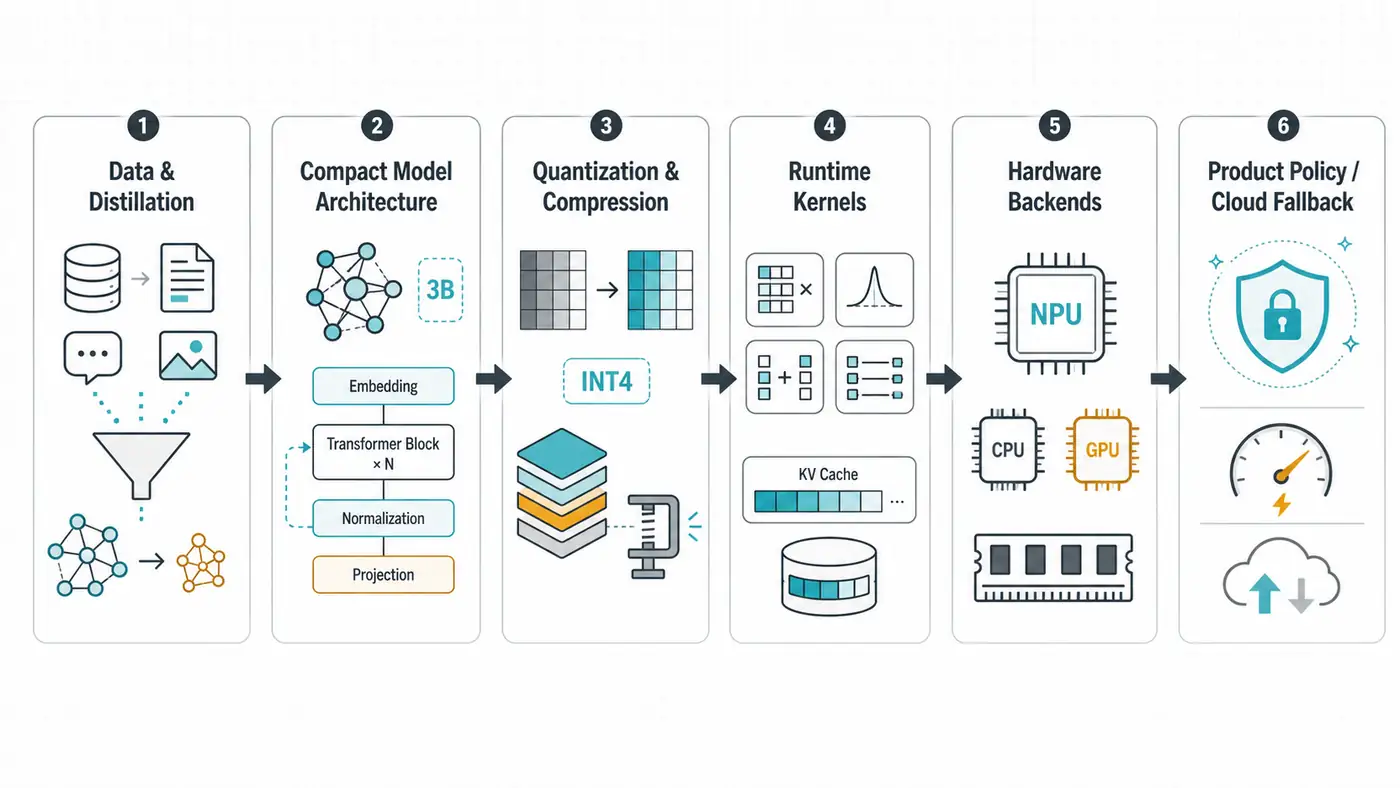
這篇文章的核心判斷是:SLM 不是大模型的廉價替代品,而是另一種系統形態。它的價值不只來自低成本,還來自低延遲、離線可用、隱私邊界、個性化、邊緣實時控制和雲端兜底策略。真正的競爭點也不只是某個小模型在公開榜單上的分數,而是模型、數據蒸餾、量化格式、runtime kernel、硬件後端、更新機制、權限隔離和評測回放能否組成穩定閉環。
目錄
- 研究背景:為什麼小模型重新變成主線
- 近一年路線圖:從 compact LLM 到本地 Agent
- 代表論文與系統分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
1. 研究背景:為什麼小模型重新變成主線
過去兩年,大模型能力躍遷主要由更大參數、更大數據和更長訓練推動。但當 LLM 進入真實產品後,單純擴大模型並不能解決所有問題。移動端鍵盤補全、會議摘要、照片檢索、離線翻譯、可穿戴助手、車載交互、瀏覽器內 AI、企業內網工具、工業邊緣設備等場景,對延遲、功耗、隱私、網絡可用性和單位成本有硬約束。一個 70B 或 400B 級別模型即使能力更強,也不可能在所有交互裡被實時調用。
SLM 的機會來自這個約束面。它把“更強”拆成“足夠強、足夠快、足夠便宜、足夠私密、足夠可控”。對很多任務,用戶並不需要通用研究級推理,只需要穩定完成少數高頻動作:抽取日程、總結通知、生成短回覆、改寫語氣、解釋頁面、執行本地快捷指令、在設備文件中檢索、把語音轉成結構化操作。小模型如果能在 100-300 ms 級別啟動或流式返回,並且不上傳原始隱私數據,產品價值會非常直接。
另一個變化是數據蒸餾和 post-training 讓小模型不再只是“訓練不夠大的模型”。Phi 系列、Gemma/Qwen/Llama 的小尺寸版本、SmolLM、MobileLLM 等工作都說明,小模型能力越來越依賴高質量數據、teacher 模型、合成指令、推理軌跡和任務配方。換句話說,SLM 的核心問題不是“參數少所以能力差”,而是“參數預算有限時,哪些知識和行為最值得被壓進去”。
同時,端側 AI 把推理系統問題放大了。雲端服務可以用批處理、張量並行、PagedAttention、連續 batching 和大 GPU 內存攤薄成本;設備側則要面對幾 GB 內存、NPU/GPU/CPU 後端差異、熱 throttling、電池、應用沙箱、模型下載包體、增量更新、不同操作系統 API 和隱私合規。SLM 的研究脈絡因此必須同時看模型結構、壓縮、運行時和產品策略。
2. 近一年路線圖:從 compact LLM 到本地 Agent
2023-2024:小模型從“參數壓縮”變成“數據配方”。 Phi-2/Phi-3、MobileLLM、TinyLlama、DistilGPT 類工作強調高質量數據、架構選擇和訓練預算。Meta 在 Llama 3.2 官方發佈中把 1B/3B 文本模型定位為 edge/mobile 場景;Microsoft 的 Phi-3 技術報告標題就強調“locally on your phone”。這一階段的關鍵詞是:小模型可以在局部任務上達到可用,但必須通過嚴格數據選擇和 post-training 獲得行為能力。
2024-2025:端側運行時和量化成為基礎設施。 llama.cpp/GGUF、MLC/WebLLM、ExecuTorch、ONNX Runtime GenAI、Apple MLX 等項目把模型分發、低比特權重、kernel、KV cache 和硬件後端做成開發者能用的工具鏈。研究側則繼續推進 SmoothQuant、AWQ、GPTQ、QLoRA、KIVI、1-bit LLM 等壓縮路線。這個階段的重點不是“能跑一次”,而是“能在不同設備上穩定、可測、可升級地跑”。
2025:小模型家族開始和大模型家族同步發佈。 Qwen3 官方博客列出從 0.6B 到 235B-A22B 的 dense/MoE 系列,強調 thinking/non-thinking 模式與多語言;Gemma 3 發佈 1B/4B/12B/27B,其中 1B 明確是輕量文本模型;Gemma 3n 文檔進一步面向移動端,提到 MatFormer、Per-Layer Embeddings 和 2B/4B 有效參數規模。SmolLM3 則展示 3B 級開源模型在長上下文、多語言和 reasoning 上的定位。
2026:端側模型開始從“本地問答”走向“本地 Agent 基礎設施”。 Google AI for Developers 頁面已經列出 Gemma 4 1B/4B/12B/27B 與 Gemma 4n E2B/E4B 等新一代模型信息;Apple Foundation Models framework 把本地模型能力暴露給應用開發者;瀏覽器、本地 IDE、隱私敏感企業應用和消費電子設備開始把小模型用作 intent router、local planner、隱私過濾器、草稿生成器和雲端調用前的預處理器。這裡許多產品可用性和區域限制變化很快,發佈前應以官方文檔再次核驗。
3. 代表論文與系統分組解讀
3.1 小模型家族:能力來自參數、數據和蒸餾的共同設計
Phi 系列是理解 SLM 的經典入口。Phi-3 技術報告認為,通過高質量網絡數據和合成數據訓練,小尺寸模型可以在移動設備可部署的約束下獲得較強語言能力。Phi-4-mini-reasoning 則把目標進一步收窄到數學推理,強調從 Phi-4 中蒸餾高質量數學推理軌跡,並面向教育和移動場景。這裡的工程啟發是:小模型通常不該追求“什麼都還不錯”,而應圍繞目標任務分佈做數據配方。
Llama 3.2 的 1B/3B 模型代表了另一路徑:大模型家族把小模型作為邊緣和移動設備成員同步維護。Meta 官方發佈稱 1B/3B 模型支持本地 summarization、instruction following 和改寫類任務,並與移動硬件夥伴合作優化。它的意義在於,小模型不再是社區二次裁剪的副產品,而是模型家族設計中的正式部署目標。
Qwen3 則展示了更寬的尺寸梯度。官方博客列出 0.6B、1.7B、4B、8B、14B、32B 等 dense 模型,以及 30B-A3B、235B-A22B 等 MoE 模型。對端側 AI 而言,0.6B-4B 區間特別重要,因為它們允許產品在“本地快速處理”和“雲端高質量處理”之間做路由。Qwen3 還強調 thinking mode 和 non-thinking mode 的切換,這對邊緣系統很關鍵:不是所有請求都值得花推理時計算。
Gemma 3/Gemma 3n/Gemma 4 的官方文檔把“設備側”放到更顯眼位置。Gemma 3 發佈頁稱 1B 模型可在低資源環境運行;Gemma 3n 文檔明確面向 mobile/edge,使用 MatFormer 和 Per-Layer Embeddings,讓 E2B/E4B 模型在內存佔用上接近 2B/4B 有效參數;Gemma 4 文檔截至 2026-07-06 列出 1B 到 27B 的模型卡和 4n 版本。這裡值得關注的不是單個 benchmark,而是 Google 把小模型、移動端和多模態能力放在同一條產品線上維護。
SmolLM3 是 2025 年開源社區值得看的 3B 級模型。Hugging Face 官方博客把它描述為 smol、multilingual、long-context reasoner,並提供開放權重。它提醒我們:3B 級模型不是隻能做 toy demo,如果數據、訓練 recipe 和評測足夠認真,它可以成為本地開發者、瀏覽器和輕量 Agent 的默認候選之一。
3.2 架構與訓練:小模型不是均勻縮小的大模型
MobileLLM 的貢獻在於系統研究 sub-billion 參數模型如何為 on-device use cases 優化。論文強調,直接縮放大模型架構並不一定適合小參數區間,需要重新權衡 depth、width、attention、embedding 和 FFN 配置。對工程讀者來說,這說明“同樣 1B 參數”並不等價;架構分配會顯著影響延遲、內存和準確率。
MatFormer 是另一個有代表性的思路:在同一個訓練好的模型中嵌入多個粒度的子模型,從而按設備能力或請求難度選擇不同計算路徑。Gemma 3n 文檔提到使用 MatFormer 架構,這說明可彈性縮放的模型結構開始進入官方端側模型。未來的端側系統可能不再只下載一個固定模型,而是下載一個可按功耗/延遲/質量動態裁剪的模型家族。
MoE 對小模型也有啟發,但要謹慎。Qwen3 的 MoE 版本和許多前沿大模型都使用稀疏激活來提高參數效率;在端側,MoE 可以讓“總參數較大、每 token 激活較少”成為可能。但它也引入 expert routing、權重分頁、存儲包體和冷啟動問題。對手機或嵌入式設備來說,active parameters 低並不自動等於體驗好,權重加載和內存帶寬往往更致命。
訓練數據方面,小模型越來越依賴 teacher model 和合成數據。Phi、DeepSeek-R1 distill、Qwen/Gemma 的小尺寸版本都說明,大模型可以把推理軌跡、工具格式、對話風格和領域知識壓縮給學生模型。但這也帶來一個隱患:小模型會繼承 teacher 的錯誤、拒答邊界、語言偏好和幻覺模式。因此小模型必須單獨做端側任務評測,而不能只引用 teacher 的能力敘述。
3.3 量化與壓縮:真正的瓶頸常常是內存帶寬
端側部署首先遇到的是內存。一個 3B 參數模型即使用 FP16 也需要約 6GB 權重內存,還不包括 KV cache、runtime buffer、tokenizer、應用本身和操作系統壓力。INT8/INT4 weight-only quantization 能顯著降低包體和內存帶寬,是端側 LLM 的基本工具。
GPTQ、AWQ、SmoothQuant、QLoRA 等路線分別從訓練後量化、activation-aware 權重保護、激活平滑和低秩適配角度推進低比特部署。對產品團隊來說,問題不是“哪種量化論文最優”,而是:目標設備後端是否有對應 kernel,量化格式是否能被 runtime 支持,長上下文下 KV cache 是否爆內存,低比特是否破壞結構化輸出、函數調用和安全策略。
KV cache 是另一個經常被低估的端側瓶頸。權重量化只壓縮模型參數,長對話、多輪 Agent、RAG 和本地文件檢索會快速拉高 KV cache。KIVI 等工作把 KV cache 量化作為重點,說明在長上下文和流式交互裡,內存管理與權重量化同樣重要。端側 Agent 如果需要保留多輪狀態,必須設計摘要、截斷、緩存複用和雲端兜底,而不是無限堆上下文。
1-bit/極低比特 LLM 是 2024-2026 年很活躍的方向。BitNet b1.58 論文提出把 LLM 權重壓到三值/1.58 bit 表示,目標是顯著降低內存和能耗;Microsoft 的 BitNet.cpp 項目則嘗試給 1-bit LLM 提供高效 CPU 推理框架。需要注意的是,這類路線仍在快速演進,不同模型、任務和硬件上的收益需要實測,不能把論文中的理想吞吐直接當作產品承諾。
3.4 運行時:端側 AI 的“模型能力”很大一部分在 runtime
llama.cpp 和 GGUF 的影響力在於把本地 LLM 推理變成了廣大開發者可操作的事情。它支持多種量化格式和 CPU/GPU 後端,社區模型分發也圍繞 GGUF 形成生態。對於研究生和工程團隊,它是快速驗證“某個模型在本機是否可用”的常用基線。
ExecuTorch 代表 PyTorch 生態對 edge/on-device inference 的系統化投入。它面向移動和邊緣設備,把模型導出、圖優化、delegate/backend 和運行時整合起來。對企業團隊而言,這類官方運行時的價值在於長期維護、設備覆蓋和與訓練框架的銜接,而不只是單次性能。
ONNX Runtime GenAI 提供了另一條跨平臺路徑,強調使用 ONNX Runtime 運行 generative AI 模型,並支持多硬件後端。它適合已有 ONNX/Windows/Azure/企業部署生態的團隊。MLC LLM/WebLLM 則把瀏覽器和 WebGPU 納入端側 AI 視野,使“無需安裝本地應用的私有推理”成為可能。Apple MLX 和 Core ML/Apple Foundation Models 則更偏 Apple 設備棧。
這裡的現實判斷是:端側 LLM 沒有一個統一 runtime 會贏下所有場景。瀏覽器、iOS、Android、macOS、Windows、嵌入式 Linux、車載系統、NPU SDK 都有不同約束。工程上更穩妥的做法是定義模型中間格式、量化策略、評測集和 fallback contract,再按目標平臺選擇 runtime。
3.5 產品形態:本地模型常常是雲端模型的前置層
端側 AI 並不意味著“所有事情都離線完成”。更現實的產品形態是分層:本地小模型負責低風險、高頻、隱私敏感、低延遲任務;雲端大模型負責複雜推理、跨文檔綜合、長鏈工具執行和高風險輸出;中間用 policy router 決定是否上傳、上傳什麼摘要、是否需要用戶確認。
Apple Foundation Models framework 是這種趨勢的代表。官方文檔把 on-device foundation model 能力開放給應用,使開發者可以在設備內調用模型完成文本生成、結構化輸出等任務。Apple 研究頁也介紹了 Apple Intelligence 的 server 與 on-device foundation language models,強調適配設備約束。由於地區、系統版本和 API 可用性變化很快,具體調用能力需要以最新開發者文檔為準。
本地 Agent 還需要權限治理。一個能讀剪貼板、郵件、相冊、文件和日曆的本地模型,並不因為“沒有上傳雲端”就天然安全。它需要最小權限、用戶可見的工具調用、數據保留策略、可撤銷記憶、敏感信息過濾和 prompt injection 防護。端側 AI 的隱私價值來自系統設計,而不是模型位置本身。
4. 方法對比表
| 路線 | 代表工作/系統 | 適合場景 | 優勢 | 風險與注意點 |
|---|---|---|---|---|
| 0.5B-4B dense SLM | Phi、Qwen3 0.6B/1.7B/4B、Gemma 1B/4B、SmolLM3 | 本地摘要、改寫、分類、輕量問答 | 包體小、延遲低、易部署 | 複雜推理和長上下文上限有限 |
| 小尺寸 MoE/稀疏激活 | Qwen3 MoE、端側可變計算設想 | 雲邊協同、可變算力設備 | 參數效率高,能力/成本可調 | 權重加載、路由和內存管理複雜 |
| 蒸餾小模型 | Phi-4-mini-reasoning、DeepSeek-R1 distill 類路線 | 數學、代碼、格式化任務、垂直領域 | 能把 teacher 行為壓到小模型 | 繼承 teacher 錯誤和偏見 |
| INT8/INT4 量化 | GPTQ、AWQ、SmoothQuant、GGUF 量化 | 大多數端側 LLM 部署 | 降低內存和帶寬,生態成熟 | 結構化輸出、安全邊界需重測 |
| KV cache 量化/管理 | KIVI、長上下文 runtime 優化 | 多輪對話、本地 RAG、Agent | 緩解長上下文內存壓力 | 可能影響長程一致性 |
| 1-bit/極低比特 | BitNet b1.58、BitNet.cpp | CPU/低功耗探索、未來硬件協同 | 潛在能耗和帶寬收益大 | 生態和模型覆蓋仍需實測 |
| 瀏覽器/本地運行時 | WebLLM、MLC LLM、llama.cpp、ExecuTorch、ONNX Runtime GenAI、MLX | 跨平臺本地推理 | 降低雲依賴,便於隱私場景 | 後端碎片化,性能差異大 |
| 雲邊協同 router | Apple/Google/企業私有架構 | 產品級 AI 助手 | 兼顧隱私、質量和成本 | 策略、權限、日誌治理複雜 |
5. 關鍵技術趨勢
趨勢一:小模型家族化。 領先模型提供方不再只發佈一個最大模型,而是同時維護 1B、3B、7B、30B、MoE、端側多模態等多個點位。產品團隊未來選型會更像選擇數據庫或搜索引擎:看生態、license、runtime、更新頻率和穩定性,而不是隻看排行榜。
趨勢二:端側 AI 走向“任務專用小腦”。 一個設備上可能同時存在 intent classifier、隱私過濾器、摘要模型、embedding 模型、視覺編碼器、語音模型和雲端 router。它們未必共享同一個大模型,而是由多個小模型組成 pipeline。
趨勢三:量化格式成為事實接口。 GGUF、ONNX、Core ML、ExecuTorch export、MLX checkpoint 等格式會影響模型能否流通。研究論文如果只給 FP16 權重,而沒有主流量化版本和端側評測,離真實部署還有距離。
趨勢四:NPU/CPU/GPU 後端差異決定體驗。 設備側不是一個抽象 GPU 集群。某些 NPU 對特定 op、shape、精度和 batch size 很敏感;CPU 可能更穩定但功耗高;GPU 可能與 UI 渲染爭資源。模型設計必須和 kernel/backend 一起看。
趨勢五:本地記憶和個性化會成為 SLM 的主要賣點。 小模型未必能回答世界知識難題,但它可以在本地理解用戶習慣、文件、日程和上下文。這個能力必須和可刪除、可查看、可導出、可隔離的記憶系統一起設計。
趨勢六:評測從通用榜單轉向設備回放。 一個模型在 MMLU 或 GSM8K 上高几分,不一定能在某款手機上低延遲、低功耗、穩定輸出 JSON。端側 AI 更需要固定設備、固定量化、固定 runtime、固定溫度和真實任務日誌回放。
6. 工程落地啟發
第一,從任務定義開始,而不是從模型大小開始。先把任務分成本地必做、本地優先、雲端優先和禁止自動化四類。比如通知摘要、短文本改寫、隱私過濾和簡單 intent routing 適合本地;跨文檔複雜推理、醫療法律建議和高風險決策更適合雲端或人工確認。
第二,為端側建立獨立 eval harness。評測輸入應來自真實設備日誌的脫敏樣本、常見 UI 狀態、離線模式、弱網、長對話、低電量和熱限制場景。指標至少包括首 token 延遲、tokens/s、峰值內存、能耗、崩潰率、結構化輸出有效率、拒答率和雲端 fallback 比例。
第三,不要只評估 FP16 模型。最終產品如果使用 INT4/GGUF/Core ML/ONNX 版本,就必須在該版本上評測安全、格式、工具調用、長上下文和多語言表現。量化可能不會顯著影響平均分,但會破壞邊界案例。
第四,把模型包體和更新機制當作產品問題。移動應用需要考慮首次下載、增量更新、弱網恢復、版本回滾、用戶存儲空間和地區合規。對於企業內網設備,還要考慮模型簽名、供應鏈掃描和離線分發。
第五,設計明確的 cloud fallback contract。本地模型應該知道什麼時候“不確定”“需要更多上下文”“必須請求用戶同意上傳”。上傳給雲端的也不一定是原始數據,可以是本地抽取的摘要、特徵、候選草稿或用戶確認後的片段。
第六,把權限和審計做進 Agent 工具層。本地模型調用日曆、文件、相冊、剪貼板、瀏覽器歷史和郵件時,需要可見的權限邊界。Prompt injection 攻擊在本地同樣存在,特別是模型讀取網頁、PDF、郵件和共享文檔時。
第七,給小模型配“窄而硬”的工具。SLM 在自由生成上可能不如大模型,但如果配合模板、schema、檢索、規則驗證、輕量排序器和有限工具,它可以在垂直任務上非常可靠。工程重點是約束輸出空間,而不是讓小模型裸聊。
7. 侷限與爭議
小模型不會自動更安全。 本地運行降低了數據外傳風險,但也可能讓錯誤輸出更難被服務端監控。安全策略、紅隊樣本、敏感信息檢測和權限控制仍然必要。
端側 benchmark 很難橫向比較。 模型、量化、runtime、設備溫度、系統負載、prompt 長度和採樣參數都會影響結果。論文或博客中的速度數字往往不可直接遷移到你的產品。
壓縮會改變模型行為。 低比特量化、剪枝、蒸餾和 KV cache 壓縮可能只在平均指標上損失很小,卻在結構化輸出、罕見語言、長尾安全請求上出現異常。發佈前必須做任務級迴歸。
小模型與雲模型的邊界會引發隱私爭議。 用戶可能以為“AI 在本地運行”意味著所有數據都不出設備,但產品實際可能在複雜請求時調用雲端。界面、隱私政策和技術架構需要保持一致。
開源權重不等於可商用部署。 License、訓練數據來源、模型使用條款、專利和第三方 runtime license 都要核驗。本文只做技術盤點,不構成法律意見。
8. 接下來值得關注的問題
- 端側多模態小模型會不會成為默認入口?文本小模型已經可用,下一步是本地視覺、語音、屏幕理解和多模態工具調用。
- 可變計算模型能否成熟?MatFormer、early exit、speculative decoding 和 dynamic routing 都指向“按任務難度花不同算力”。
- 小模型如何做長期個性化?本地 LoRA、adapter、memory store、用戶反饋和隱私刪除機制可能成為新基礎設施。
- 瀏覽器內 AI 會不會改變 Web 應用架構?WebGPU/WebNN 與 WebLLM 類項目讓輕量 AI 功能無需服務端推理,但也帶來模型下載和設備差異問題。
- 端側 Agent 如何防 prompt injection?當本地模型讀取郵件、網頁和文件並能調用系統工具時,安全邊界比普通聊天更復雜。
- 1-bit/極低比特路線能否和硬件協同落地?如果模型、kernel 和芯片一起優化,SLM 的能耗曲線可能出現新的斷點。
9. 總結
Small Language Models 和 On-device AI 的價值,不在於證明“小模型也能打敗大模型”,而在於把 AI 能力放到雲端大模型到本地設備之間的完整系統裡重新分工。小模型負責快速、私密、低成本、可離線的高頻任務;大模型負責複雜推理和高風險任務;運行時、量化、硬件後端和策略 router 決定這套系統能否穩定工作。
對研究者來說,值得關注的是小模型架構、蒸餾數據、低比特表示、KV cache 管理和設備級評測。對工程團隊來說,最務實的路徑是從一個高頻、低風險、可驗證的本地任務開始,選一個小模型、一個量化格式、一個 runtime、一個真實設備評測集,然後把雲端 fallback 和權限治理補齊。只有當這些組件一起被驗證,小模型才真正從“縮小版 LLM”變成可交付的端側智能基礎設施。
參考資料
檢索日期均為 2026-07-06。模型可用性、官方文檔版本、license、benchmark 排名、硬件支持矩陣和 API 區域限制變化較快,發佈前建議再次人工核驗。
- Microsoft Research. “Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone.” arXiv, 2024. https://arxiv.org/abs/2404.14219
- Microsoft. “Phi-4-Mini-Reasoning: Exploring the Limits of Small Reasoning Language Models in Math.” arXiv, 2025. https://arxiv.org/abs/2504.21233
- Meta AI. “Llama 3.2: Revolutionizing edge AI and vision with open, customizable models.” Official blog, 2024-09-25. https://ai.meta.com/blog/llama-3-2-connect-2024-vision-edge-mobile-devices/
- An Yang et al. “Qwen3 Technical Report.” arXiv, 2025. https://arxiv.org/abs/2505.09388
- Qwen Team. “Qwen3: Think Deeper, Act Faster.” Official blog, 2025-04-28. https://qwenlm.github.io/blog/qwen3/
- Google. “Gemma 3: Google’s most capable open AI model.” Official blog, 2025-03-12. https://blog.google/technology/developers/gemma-3/
- Google AI for Developers. “Gemma 3n model overview.” Official documentation, accessed 2026-07-06. https://ai.google.dev/gemma/docs/gemma-3n
- Google AI for Developers. “Gemma 4 model card.” Official documentation, accessed 2026-07-06. https://ai.google.dev/gemma/docs/core/model_card_4
- Hugging Face. “SmolLM3: smol, multilingual, long-context reasoner.” Official blog, 2025. https://huggingface.co/blog/smollm3
- Jianwei Yang et al. “MobileLLM: Optimizing Sub-billion Parameter Language Models for On-Device Use Cases.” arXiv, 2024. https://arxiv.org/abs/2402.14905
- Han Lab et al. “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration.” arXiv, 2023. https://arxiv.org/abs/2306.00978
- Elias Frantar et al. “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.” arXiv, 2022. https://arxiv.org/abs/2210.17323
- Guangxuan Xiao et al. “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models.” arXiv, 2022. https://arxiv.org/abs/2211.10438
- Tim Dettmers et al. “QLoRA: Efficient Finetuning of Quantized LLMs.” arXiv, 2023. https://arxiv.org/abs/2305.14314
- Zirui Liu et al. “KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache.” arXiv, 2024. https://arxiv.org/abs/2402.02750
- Shuming Ma et al. “The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits.” arXiv, 2024. https://arxiv.org/abs/2402.17764
- Microsoft Research. “BitNet.cpp: Efficient Edge Inference for Ternary LLMs.” GitHub repository, accessed 2026-07-06. https://github.com/microsoft/BitNet
- ggml-org. “llama.cpp.” GitHub repository, accessed 2026-07-06. https://github.com/ggml-org/llama.cpp
- PyTorch. “ExecuTorch documentation.” Official documentation, accessed 2026-07-06. https://pytorch.org/executorch/stable/
- Microsoft. “ONNX Runtime GenAI.” Official documentation, accessed 2026-07-06. https://onnxruntime.ai/docs/genai/
- MLC AI. “MLC LLM documentation.” Official documentation, accessed 2026-07-06. https://llm.mlc.ai/docs/
- Apple. “Apple Intelligence Foundation Language Models.” Machine Learning Research, accessed 2026-07-06. https://machinelearning.apple.com/research/apple-intelligence-foundation-language-models
- Apple Developer Documentation. “Foundation Models framework.” Official documentation, accessed 2026-07-06. https://developer.apple.com/documentation/foundationmodels