日期:2026-07-05
適合讀者:研究生、做模型訓練/評測的工程師、關注開源 LLM recipe 的技術讀者
檢索日期:2026-07-05
摘要
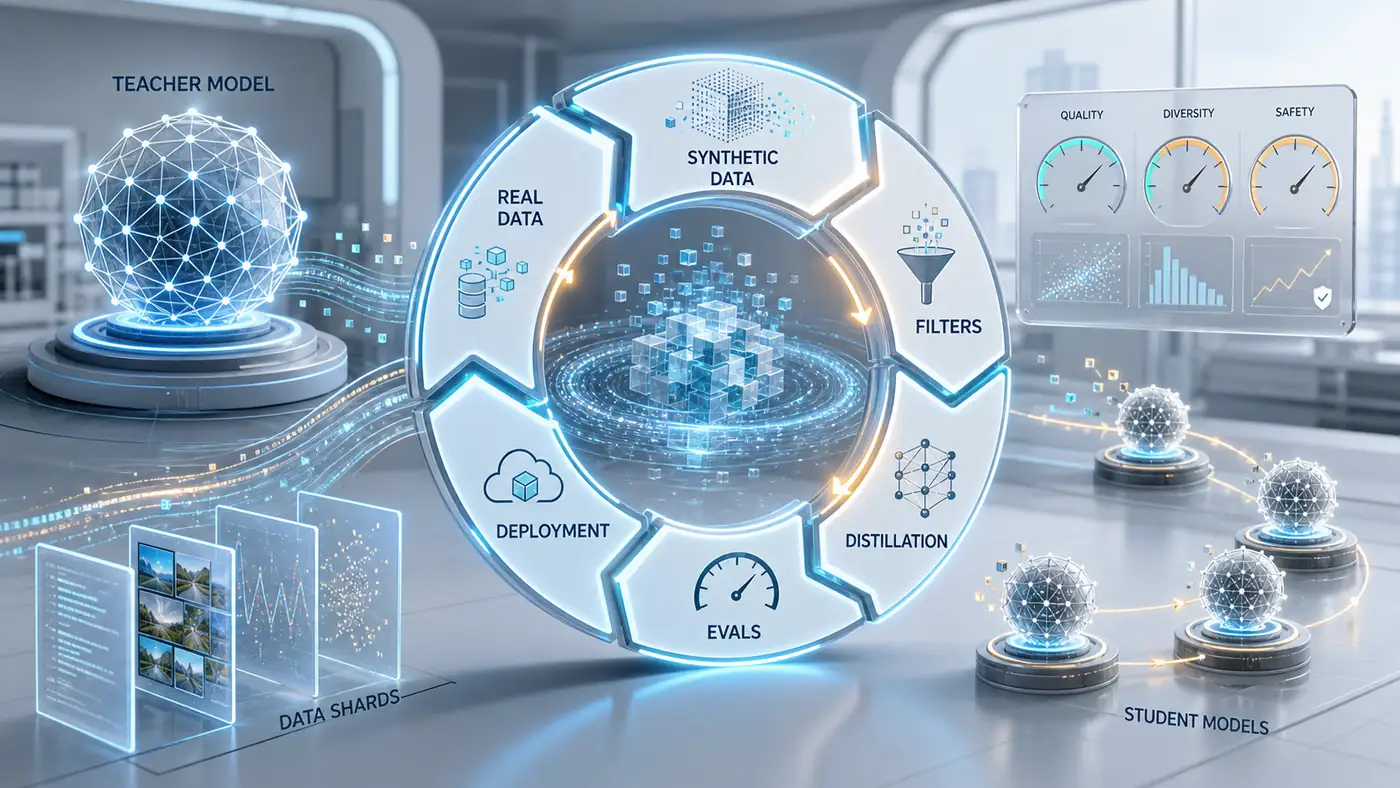
2025 到 2026 年,合成數據不再只是“缺標註時的補丁”,而正在成為 post-training 的核心生產資料。過去的經典路線是知識蒸餾:用大模型或模型集成的輸出訓練更小、更便宜的學生模型。LLM 時代把這個思路擴展成更復雜的數據飛輪:生產系統日誌、人工偏好、公開題庫、工具執行結果和模型自我生成的軌跡,被組織成 SFT、DPO、RLHF/RLAIF、RLVR、拒絕採樣、驗證器過濾和蒸餾數據,持續餵給下一代模型。
這篇文章的核心判斷是:合成數據真正有價值的地方不在於“無限生成”,而在於“可驗證、可追溯、可迭代”。DeepSeek-R1、Tulu 3、Llama 4、Qwen3、Magpie、UltraFeedback、OpenThoughts 等工作都說明,前沿能力越來越依賴數據管線本身:誰能定義任務分佈、構造難例、過濾低質量樣本、控制汙染、把評測反饋迴流到訓練,誰就能把一次模型發佈變成持續改進的工程系統。
目錄
- 研究背景:為什麼後訓練開始圍繞數據飛輪重組
- 近一年路線圖:從 instruction data 到 reasoning data
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
1. 研究背景:為什麼後訓練開始圍繞數據飛輪重組
預訓練階段解決的是“把世界壓進參數”,post-training 解決的是“讓模型按人和任務需要工作”。在 GPT-3、InstructGPT、ChatGPT 之後,大家熟悉的流程大致是:先用人工示範做 supervised fine-tuning,再收集偏好數據訓練獎勵模型,最後用 PPO 之類的強化學習優化策略。這個範式證明了一個重要事實:模型規模並不自動等於可用產品,行為對齊和任務能力很大一部分來自訓練後的數據與反饋。
合成數據切入的是這個瓶頸。人工寫 prompt、寫高質量回答、標 preference、標安全邊界,成本高、速度慢、覆蓋範圍有限。Self-Instruct 的貢獻在於把“生成指令、生成輸入輸出、過濾、再微調”做成自動流程;UltraFeedback 把人類反饋替換為大模型反饋,強調 scale 和 diversity;Magpie 進一步利用已對齊模型的聊天模板,從“空上下文”中抽取用戶問題和回答。到 2025 年,DeepSeek-R1 和一批 reasoning dataset 工作把這條路推進到推理軌跡、可驗證答案、代碼執行和多輪難例篩選。
但“模型生成數據訓練模型”不是免費的午餐。合成數據會帶來分佈收縮、模式坍縮、風格同質化、錯誤自我強化、benchmark 汙染和版權/許可風險。2024 年 Nature 關於 model collapse 的工作提醒我們,如果新數據只是遞歸替換真實數據,尾部分佈和稀有模式可能逐步丟失;後續也有工作指出,如果真實數據持續累積、合成數據經過驗證,風險並非不可控。工程上更合理的表述不是“用 AI 數據替代人類數據”,而是“用模型把昂貴的人類信號放大,並用驗證和審計約束放大過程”。
2. 近一年路線圖:從 instruction data 到 reasoning data
2022-2023:指令生成和偏好學習成為基礎設施。 InstructGPT 建立了 SFT + preference + RLHF 的產品化路徑;Self-Instruct 證明少量種子任務可以引導模型合成大量指令數據;DPO 把偏好優化改寫成更易訓練的分類式目標;UltraFeedback 用 GPT-4 級別反饋構造大規模 AI preference 數據。這個階段的關鍵詞是“對齊聊天行為”。
2024:數據合成開始關注多樣性、角色和評測汙染。 Magpie、Persona Hub、instruction backtranslation 等工作把 synthetic instruction 的問題從“生成更多”推進到“覆蓋更多任務視角”。Tulu 3 的開放 recipe 尤其重要,它把數據集、代碼、訓練 recipe、評測和去汙染放到一起討論,說明 post-training 不是單一算法,而是數據治理工程。
2025:reasoning data 與 verifiable reward 成為主線。 DeepSeek-R1 把大規模 RL、冷啟動數據、拒絕採樣、規則獎勵和蒸餾小模型連成一條路線。Tulu 3 使用 SFT、DPO 和 RLVR,強調可驗證獎勵;LIMO 反過來挑戰“數據越多越好”的直覺,認為在強 base model 上,少量高質量認知模板也可能激發推理能力;OpenThoughts 系列把公開 reasoning data recipe 做成可復現實驗對象。
2026:數據飛輪開始與產品日誌、Agent 環境和工具驗證合流。 這部分仍在快速變化,許多 proprietary 系統不公開細節,以下判斷標註為“待人工核驗”:前沿系統傾向於把線上失敗案例、工具調用日誌、自動 red team、代碼執行結果、搜索/瀏覽軌跡和用戶反饋迴流到訓練與評測。合成數據的重點從“文本樣本”擴展為“帶環境、帶工具、帶驗證器的經驗樣本”。
3. 代表論文分組解讀
3.1 知識蒸餾:從壓縮模型到遷移推理行為
Hinton、Vinyals 和 Dean 在 2015 年系統化了知識蒸餾:把多個模型或大模型的預測分佈壓縮到單個模型中,以降低部署成本。LLM 時代的蒸餾不再只是 soft label 壓縮,還包括指令風格、推理軌跡、工具調用格式、拒絕策略和偏好排序的遷移。
DeepSeek-R1 是 2025 年最有代表性的案例之一。arXiv 頁面顯示,該論文 2025-01-22 首次提交,2026-01-04 修訂,並發表在 Nature 2025。摘要強調純 RL 可激發 self-reflection、verification 和 dynamic strategy adaptation,並且這些推理模式可以用於增強小模型。這裡重要的不是某個單點 benchmark,而是“強 reasoning teacher -> 合成 reasoning traces -> 小模型 SFT/蒸餾”的可複製產業路徑。
Meta 在 Llama 4 官方博客中也把 teacher model 放到核心位置:Llama 4 Behemoth 被描述為 Scout/Maverick 的教師模型,Maverick 通過 co-distillation 獲得質量提升;博客還提到動態權重的蒸餾 loss、輕量 SFT、online RL、輕量 DPO,以及用模型 judge 移除容易樣本。這些細節說明,現代蒸餾已經嵌入 pre-training、mid-training 和 post-training 的多個階段,而不是訓練結束後的壓縮步驟。
3.2 指令合成:從 Self-Instruct 到 Magpie 和 Persona Hub
Self-Instruct 的流程很樸素:用語言模型生成 instruction、input、output,過濾無效或相似樣本,再用這些樣本微調原模型。它的價值在於把“任務設計”自動化,使研究者不必為每個新能力都從零標註大量數據。
Magpie 的思路更激進:利用已對齊模型聊天模板中的用戶消息位置,讓模型自動生成用戶查詢和回答。論文稱其生成了 4M instruction-response,並選擇 300K 高質量樣本用於訓練與評測。它提醒我們,很多閉源/半開源 instruct model 中隱含著一套“用戶分佈”,可以通過提示方式被抽取出來。不過,這類方法也帶來許可、模型使用條款和數據來源審計問題,實際落地時不能只看效果。
Persona Hub 則從 diversity 入手,提出用大規模 persona 作為數據合成的視角載體。對工程系統而言,這個思想比“10 億 persona”這個數字更重要:如果合成數據只來自少數模板,很容易產生風格和任務分佈同質化;如果能顯式管理 persona、場景、難度、語言、領域和安全等級,就能把數據覆蓋變成可調參數。
3.3 AI feedback 與偏好數據:從 RLHF 到 RLAIF/DPO
InstructGPT 的經典流程依賴人工示範和人工排序;Constitutional AI 把部分監督替換為規則列表與 AI feedback;UltraFeedback 把 GPT-4 反饋擴展到大規模偏好數據;DPO 降低了 preference optimization 的工程門檻。它們共同推動了一個變化:偏好數據本身可以被生產、過濾、去偏和版本化。
這裡需要小心兩點。第一,AI feedback 不是客觀真理,它繼承 judge model 的偏見、盲區和安全策略。第二,偏好數據會強烈塑造模型風格,過度優化可能讓模型變得囉嗦、保守、迎合或失去探索性。Llama 4 官方博客中提到 SFT 和 DPO 可能 over-constrain model,因而在 online RL 前減少 easy data,這個經驗很值得工程團隊重視。
3.4 Reasoning data:可驗證答案改變數據生產方式
推理數據的關鍵不是“讓模型寫長思維鏈”,而是“讓訓練信號可驗證”。數學可以比對最終答案,代碼可以跑測試,形式化證明可以調用 proof checker,部分科學問題可以用模擬器或檢索證據校驗。DeepSeek-R1、Tulu 3 的 RLVR、OpenThoughts 的數據 recipe 都把可驗證性放在中心。
OpenThoughts 2025 年論文的目標就是公開 reasoning model 的數據 recipe。摘要稱 OpenThoughts2-1M 訓練出的 OpenThinker2-32B 可匹配 DeepSeek-R1-Distill-32B 的標準 reasoning benchmark,並通過 1000+ controlled experiments 改進數據生成流水線。無論這些具體數字未來是否被新模型刷新,它代表的方向非常清楚:公開社區開始把“數據配方”當作模型能力的可復現實驗對象。
LIMO 則提供了另一個角度。論文提出,在知識已經被 base model 編碼的前提下,少量精心設計的 reasoning demonstrations 可能足以充當認知模板。它提醒我們,合成數據飛輪不能只追求樣本量;數據質量、任務選擇、軌跡結構和 base model 已有能力之間存在強相互作用。
3.5 開放 recipe:Tulu 3、Qwen3 與可復現後訓練
Tulu 3 的重要性在於“把完整 recipe 公開”。arXiv 頁面顯示,它發佈模型、數據、代碼和訓練配方,訓練算法包括 SFT、DPO 和 RLVR,並引入開發集/未見評測、標準 benchmark 實現和去汙染。對研究者來說,這比單純發佈一個高分模型更有價值,因為它讓後訓練成為可審計、可對比、可複用的系統。
Qwen3 技術報告則體現了另一個趨勢:把 thinking mode 和 non-thinking mode 統一在一個模型系列中,並通過旗艦模型知識降低小模型構建成本。它沒有把所有數據細節完全展開,但說明大型模型家族正在把推理模式、蒸餾、小模型效率和多語言覆蓋作為同一條產品線設計。
4. 方法對比表
| 方法 | 主要數據來源 | 訓練目標 | 優勢 | 風險與注意點 |
|---|---|---|---|---|
| SFT on human demonstrations | 人工示範、專家答案、生產案例 | 模仿標準答案格式與行為 | 穩定、易調試、適合冷啟動 | 成本高,覆蓋受限,容易過擬合模板 |
| Self-Instruct / instruction synthesis | 模型自生成任務與答案 | 擴大指令覆蓋 | 低成本擴展任務空間 | 同質化、錯誤自舉、過濾成本高 |
| AI feedback / RLAIF | Judge model 評分、規則原則 | 對齊偏好與安全策略 | 可規模化偏好標註 | judge 偏差、獎勵黑客、過度迎合 |
| DPO / preference optimization | chosen/rejected 對 | 直接優化偏好概率 | 比 RLHF 簡潔,工程門檻低 | 數據質量決定上限,容易學到風格捷徑 |
| RLVR / rule-based reward | 數學答案、代碼測試、格式規則 | 優化可驗證任務表現 | 反饋明確,可自動化 | 只覆蓋可驗證子集,可能犧牲開放問答質量 |
| Rejection sampling distillation | Teacher 生成多候選,驗證器篩選 | 學習高質量軌跡 | 適合 reasoning/code/math | 算力消耗高,驗證器偏差會被放大 |
| Data flywheel | 線上日誌、失敗案例、評測、合成數據 | 持續閉環改進 | 能跟隨真實任務演化 | 隱私、許可、汙染、治理複雜 |
5. 關鍵技術趨勢
趨勢一:數據從靜態數據集變成版本化流水線。 未來論文中“用了某某 dataset”已經不夠,真正有信息量的是生成 prompt、teacher 版本、temperature、採樣次數、過濾器、去重策略、驗證器、汙染檢測、mixing ratio 和失敗樣本回流規則。
趨勢二:驗證器決定合成數據的上限。 在數學、代碼、工具調用和科學模擬中,驗證器可以把合成樣本從“看起來像”提升到“可執行通過”。這也是 reasoning post-training 進展快於開放式寫作的一大原因。開放問答、醫學建議、法律分析這類任務缺少簡單驗證器,需要結合檢索證據、專家審閱和保守安全策略。
趨勢三:教師模型不只是更大,還要更適合作為數據生產者。 好 teacher 應該能生成多樣、可驗證、解釋清楚、符合目標風格的數據;有時一個頂級聊天模型未必是最好的數據生成器。Llama 4 和 DeepSeek-R1 都提示我們,teacher 的能力結構、輸出格式和訓練階段會影響 student 的最終行為。
趨勢四:小模型能力越來越依賴高質量蒸餾。 邊緣部署、企業私有化和低延遲服務都需要 smaller model。蒸餾讓小模型獲得 reasoning/coding/tool-use 的行為模式,但也會繼承 teacher 的錯誤、安全邊界和語言偏好。小模型不是“廉價複製品”,而是需要單獨評測和約束的產品。
趨勢五:數據治理成為模型能力的一部分。 去重、去汙染、版權許可、PII 過濾、安全紅隊、數據 lineage 和回滾機制不再只是合規附屬項。一個不可追溯的數據飛輪很快會把線上 bug、benchmark 洩漏和模型偏見固化到下一輪訓練裡。
6. 工程落地啟發
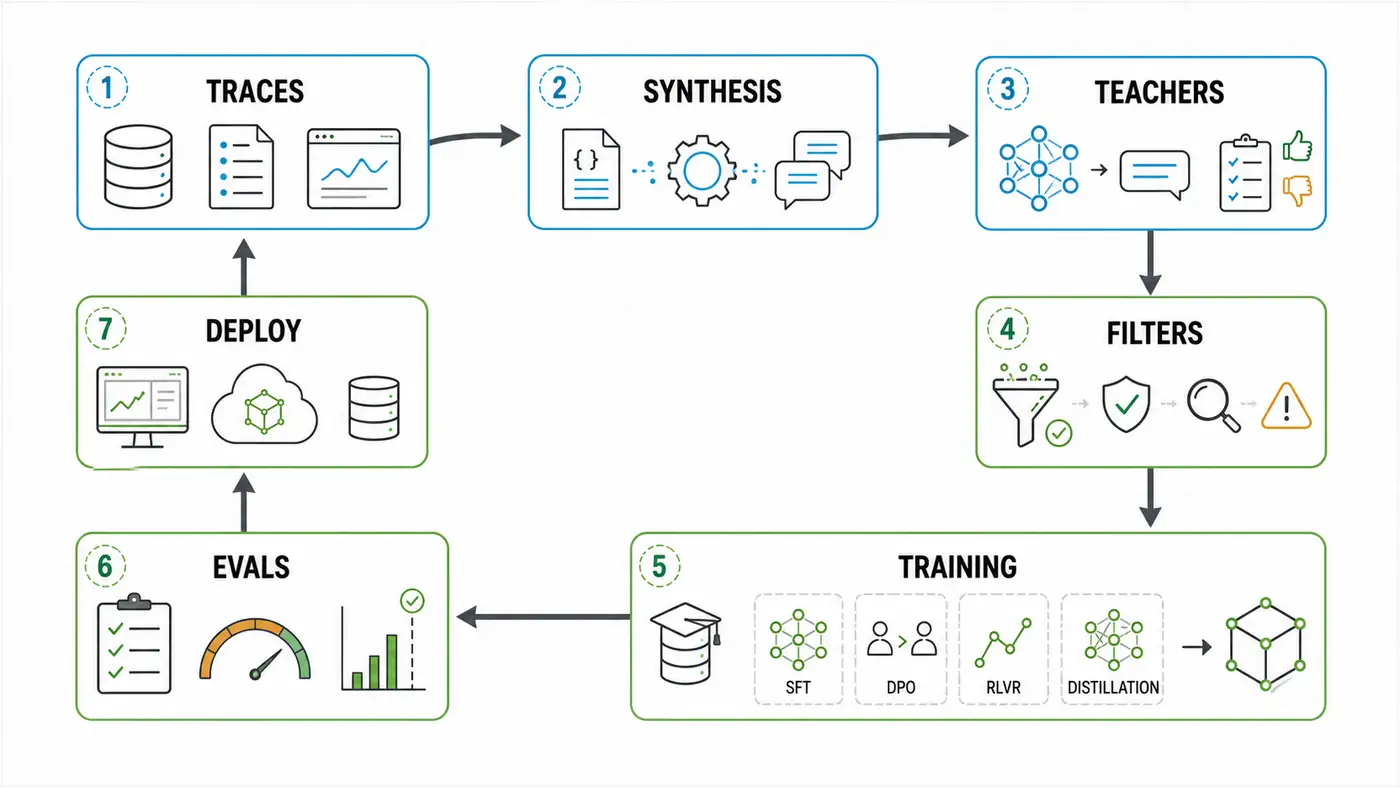
第一,把合成數據系統拆成可觀測組件。至少需要 source registry、prompt template registry、teacher registry、generation jobs、filter jobs、eval jobs、dataset version、training run 和 model card。每個樣本最好能追溯到來源、生成參數、過濾原因和使用過的模型版本。
第二,不要把“更多 synthetic data”當成默認優化方向。更可行的做法是按能力缺口生產數據:先從 eval failure、用戶投訴、低置信度任務和業務高價值場景中抽樣,再決定是人工標註、teacher 蒸餾、檢索增強生成、工具驗證,還是直接修改產品提示和 guardrail。
第三,建立三層過濾:格式過濾、語義過濾和結果驗證。格式過濾保證 JSON、工具調用、引用結構正確;語義過濾檢查重複、低信息量、明顯幻覺和安全問題;結果驗證用 unit test、數學答案、retrieval evidence、專家規則或 judge ensemble 兜底。單一 LLM judge 不應是最後裁判。
第四,訓練集和評測集要分權管理。數據飛輪最容易犯的錯誤是把評測失敗樣本轉成訓練數據後,仍然用原評測集彙報進步。正確做法是保留 frozen holdout,給迴流樣本打標籤,使用時間切分或來源切分,必要時做 contamination scan。
第五,把合成數據的“真實數據錨點”制度化。即使大部分樣本由模型生成,仍需要持續注入人工專家樣本、真實用戶授權樣本、生產環境錯誤樣本和領域 ground truth。否則數據分佈會朝 teacher model 的舒適區收縮。
第六,企業落地時先從可驗證任務開始。代碼修復、SQL 生成、客服分類、文檔抽取、表單校驗、知識庫問答、策略合規檢查都比開放式戰略建議更適合構建數據飛輪,因為它們有日誌、有驗收標準、有錯誤標籤,也更容易做離線回放。
7. 侷限與爭議
模型坍縮不是口號,但也不是合成數據的必然結局。 遞歸訓練在完全替換真實數據時風險最大;如果真實數據持續累積,並且合成數據經過嚴格篩選,風險可以被緩解。工程問題在於,很多團隊沒有足夠的 lineage 和檢測手段知道自己是否正在遞歸汙染。
合成數據會放大 teacher 的盲點。 如果 teacher 不會某類題,student 也很難從 teacher 輸出中學會;如果 teacher 在安全策略、文化背景或語言風格上有偏置,student 會繼承甚至強化這些偏置。
推理軌跡的可解釋性仍有爭議。 訓練模型生成長 chain-of-thought 並不等價於獲得真實內部推理過程。很多系統會蒸餾 reasoning style,但最終產品可能隱藏或壓縮思維鏈。研究者在比較模型時需要區分“軌跡作為訓練信號”和“軌跡作為解釋證據”。
benchmark 數字越來越容易被數據飛輪汙染。 當數據生成器、過濾器和訓練任務都圍繞公開 benchmark 迭代時,未見評測和真實任務評測比排行榜更重要。Tulu 3 強調 decontamination 是一個好信號,但行業整體仍缺統一標準。
法律與平臺條款風險上升。 用某個商業模型批量生成訓練數據,是否允許訓練競爭模型,取決於服務條款和數據來源授權。本文不提供法律意見;涉及商業化訓練時,必須由法務和數據治理團隊核驗。
8. 接下來值得關注的問題
- 可驗證獎勵能否擴展到開放世界任務?數學和代碼已經相對清楚,科研、醫學、法律、企業決策需要更復雜的 evidence graph 和專家審核。
- 數據飛輪如何處理長期記憶與隱私?Agent 系統會產生大量用戶軌跡,哪些可以訓練,哪些只能做個性化記憶,哪些必須刪除,需要清晰邊界。
- 小模型蒸餾會不會成為開源生態的主戰場?如果強 teacher 的 reasoning traces 可獲得,7B-32B 模型可能在大量垂直任務中達到足夠可用。
- 評測是否會從 benchmark-first 轉向 replay-first?真實系統更需要基於生產日誌的離線回放、A/B shadow eval 和風險分層評測。
- 數據 recipe 能否像代碼一樣復現?未來有價值的開源項目可能不只是權重,而是完整的 data generator、filter、eval harness 和訓練腳本。
9. 總結
Synthetic Data、Distillation 和 Post-Training 數據飛輪共同指向一個變化:模型能力越來越像“數據操作系統”的產物。算法名稱仍然重要,但決定上限的往往是數據從哪裡來、如何生成、如何驗證、如何混合、如何迴流、如何審計。
對研究者來說,下一步值得關注的是公開 recipe、驗證器設計和數據汙染控制,而不是單純比較某個模型在單個榜單上的得分。對工程團隊來說,最務實的起點是:圍繞一個可驗證業務任務,把生產失敗樣本、teacher 生成、過濾器、離線評測和小模型蒸餾串成閉環。只有當這個閉環可追溯、可回滾、可度量時,合成數據才從“便宜樣本”變成真正的模型資產。
參考資料
檢索日期均為 2026-07-05。易變化信息如模型版本、官方產品可用性、代碼倉庫狀態和 benchmark 排名,應在發佈前再次人工核驗。
- Geoffrey Hinton, Oriol Vinyals, Jeff Dean. “Distilling the Knowledge in a Neural Network.” arXiv, 2015. https://arxiv.org/abs/1503.02531
- Long Ouyang et al. “Training language models to follow instructions with human feedback.” arXiv, 2022. https://arxiv.org/abs/2203.02155
- Yizhong Wang et al. “Self-Instruct: Aligning Language Models with Self-Generated Instructions.” arXiv, ACL 2023 version. https://arxiv.org/abs/2212.10560
- Yuntao Bai et al. “Constitutional AI: Harmlessness from AI Feedback.” arXiv, 2022. https://arxiv.org/abs/2212.08073
- Rafael Rafailov et al. “Direct Preference Optimization: Your Language Model is Secretly a Reward Model.” arXiv, 2023. https://arxiv.org/abs/2305.18290
- Ganqu Cui et al. “UltraFeedback: Boosting Language Models with Scaled AI Feedback.” arXiv, ICML 2024 version. https://arxiv.org/abs/2310.01377
- Zhangchen Xu et al. “Magpie: Alignment Data Synthesis from Scratch by Prompting Aligned LLMs with Nothing.” arXiv, 2024. https://arxiv.org/abs/2406.08464
- Tao Ge et al. “Scaling Synthetic Data Creation with 1,000,000,000 Personas.” arXiv, 2024. https://arxiv.org/abs/2406.20094
- Nathan Lambert et al. “Tulu 3: Pushing Frontiers in Open Language Model Post-Training.” arXiv, v5 revised 2025-04-14. https://arxiv.org/abs/2411.15124
- DeepSeek-AI et al. “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.” arXiv, first submitted 2025-01-22, revised 2026-01-04. https://arxiv.org/abs/2501.12948
- Yixin Ye et al. “LIMO: Less is More for Reasoning.” arXiv, 2025. https://arxiv.org/abs/2502.03387
- Ke Wang et al. “A Survey on Data Synthesis and Augmentation for Large Language Models.” arXiv, 2024. https://arxiv.org/abs/2410.12896
- Mihai Nadas, Laura Diosan, Andreea Tomescu. “Synthetic Data Generation Using Large Language Models: Advances in Text and Code.” arXiv, 2025. https://arxiv.org/abs/2503.14023
- Ilia Shumailov et al. “The Curse of Recursion: Training on Generated Data Makes Models Forget.” arXiv, 2023. https://arxiv.org/abs/2305.17493
- Matthias Gerstgrasser et al. “Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data.” arXiv, 2024. https://arxiv.org/abs/2404.01413
- Etash Guha et al. “OpenThoughts: Data Recipes for Reasoning Models.” arXiv, 2025. https://arxiv.org/abs/2506.04178
- An Yang et al. “Qwen3 Technical Report.” arXiv, 2025. https://arxiv.org/abs/2505.09388
- Meta AI. “The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation.” Official blog, 2025-04-05. https://ai.meta.com/blog/llama-4-multimodal-intelligence/
- OpenAI Developers. “Supervised fine-tuning / Distilling from a larger model.” Official API docs, accessed 2026-07-05. https://platform.openai.com/docs/guides/distillation