日期:2026-07-04
適合讀者:研究生、LLM 系統研究者、推理平臺與 AI 應用工程師
摘要
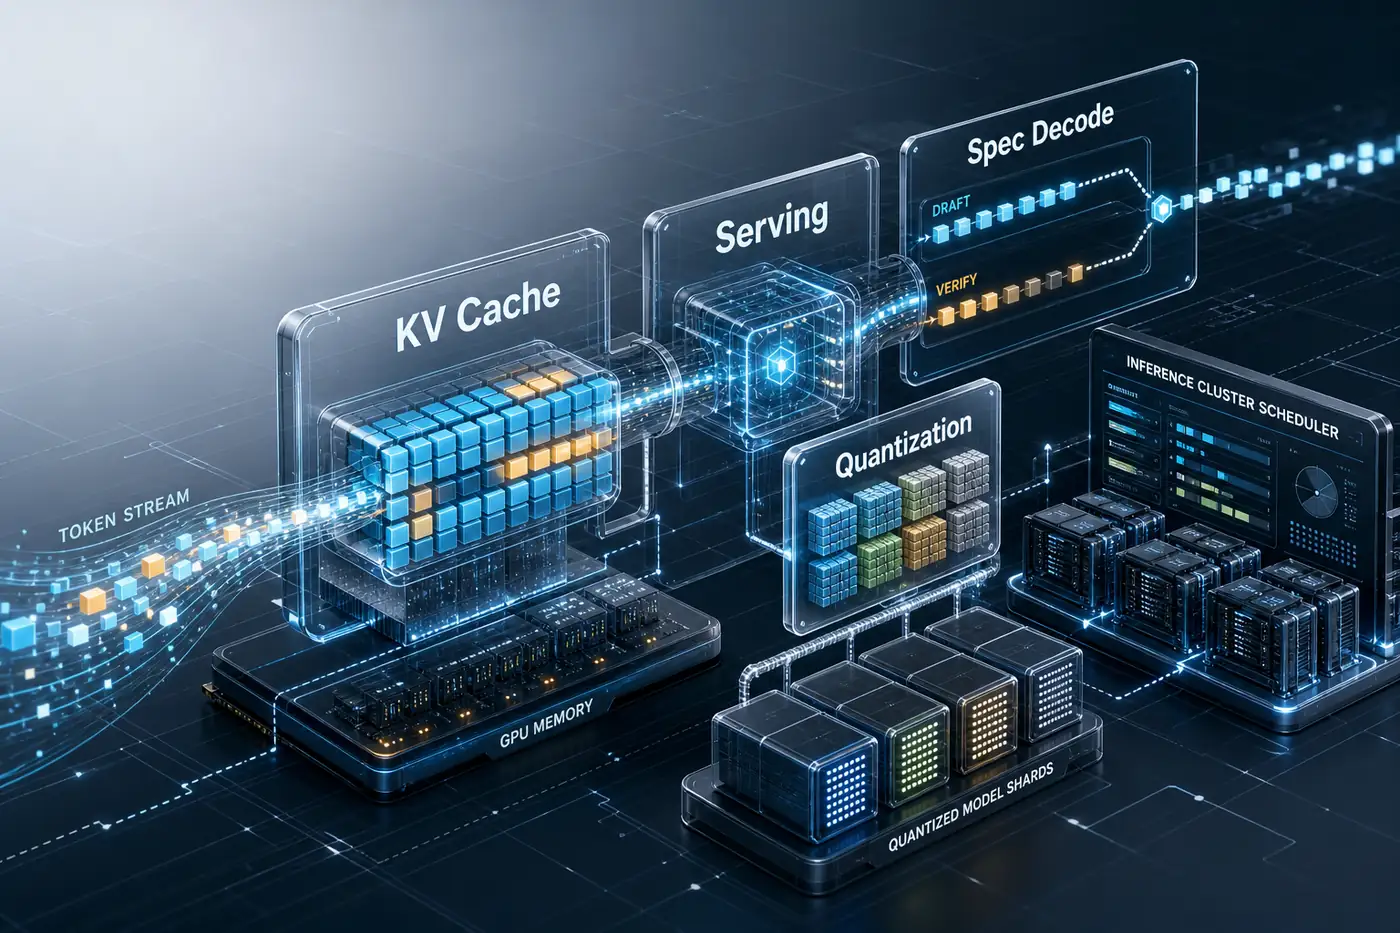
2025-2026 年,LLM 系統的主戰場正在從“如何訓練更大的模型”轉向“如何把模型又快又便宜地服務給真實用戶”。原因很直接:推理不是一次性成本,而是每個請求、每個 token、每次 agent 工具調用都會持續發生的成本。尤其在長上下文、推理型模型、多輪對話和代碼 agent 場景裡,瓶頸往往不再是單次矩陣乘法,而是 KV cache 內存、prefill/decode 階段干擾、請求調度、低 batch 延遲、量化誤差、GPU 內核與網絡傳輸共同組成的系統問題。
這篇文章按系統棧梳理 Efficient LLM Inference 與 Serving 的技術路線:PagedAttention 和 vLLM 如何把 KV cache 當作操作系統式分頁資源管理;SGLang 的 RadixAttention、vLLM Automatic Prefix Caching 和 Mooncake 的 KVCache-centric 架構如何把“重複上下文”變成可複用資產;speculative decoding、Medusa、EAGLE-3 與 TensorRT-LLM 的工程支持如何把串行 decode 改寫成 draft-and-verify;KIVI、QServe、TurboQuant 與 TensorRT-LLM 量化路線如何把低比特從權重擴展到 KV cache;FlashAttention-3 與 FlashInfer 則說明,內核層優化仍然是服務系統的底座。
目錄
- 研究背景:推理為什麼成為 AI 基礎設施瓶頸
- 近一年路線圖:從單機加速到分層 serving 架構
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
研究背景:推理為什麼成為 AI 基礎設施瓶頸
Transformer 訓練時代的核心指標是吞吐、並行效率和訓練穩定性;推理時代的核心指標變成了 TTFT(time to first token)、TPOT / ITL(每個輸出 token 的延遲)、吞吐、SLO 達標率、顯存佔用和單位 token 成本。更麻煩的是,這些指標經常互相牽制:增大 batch 能提升吞吐,卻可能拉高首 token 延遲;激進量化能降低顯存,卻可能引入額外反量化開銷;長上下文提升能力,卻會讓 KV cache 線性膨脹。
生成式 LLM 推理有兩個階段。prefill 階段處理 prompt,通常計算密集、可並行;decode 階段逐 token 生成,常常受內存帶寬、KV cache 讀取和串行依賴限制。短問答服務可能主要卡在 decode;RAG、長文檔問答和代碼倉庫 agent 則常常卡在長 prompt prefill 與重複上下文複用。服務系統的難點就在於:不同請求長度、輸出長度、採樣策略、LoRA adapter、多模態輸入、結構化輸出和 agent 調用鏈會混在同一個集群裡。
經典的 FlashAttention 把注意力優化帶到 IO-aware 層面:不要只看 FLOPs,要看 HBM 與 SRAM 之間讀寫多少。PagedAttention 進一步把 serving 的核心問題落到 KV cache 管理:KV cache 會隨請求動態增長,如果按最大長度預留連續顯存,碎片和浪費會直接壓低 batch size。到了 2025-2026 年,系統開始更明確地把推理平臺視為一個“內存、調度、內核、網絡和緩存”共同優化的問題。
近一年路線圖
第一條線:KV cache 從副產品變成一等資源。
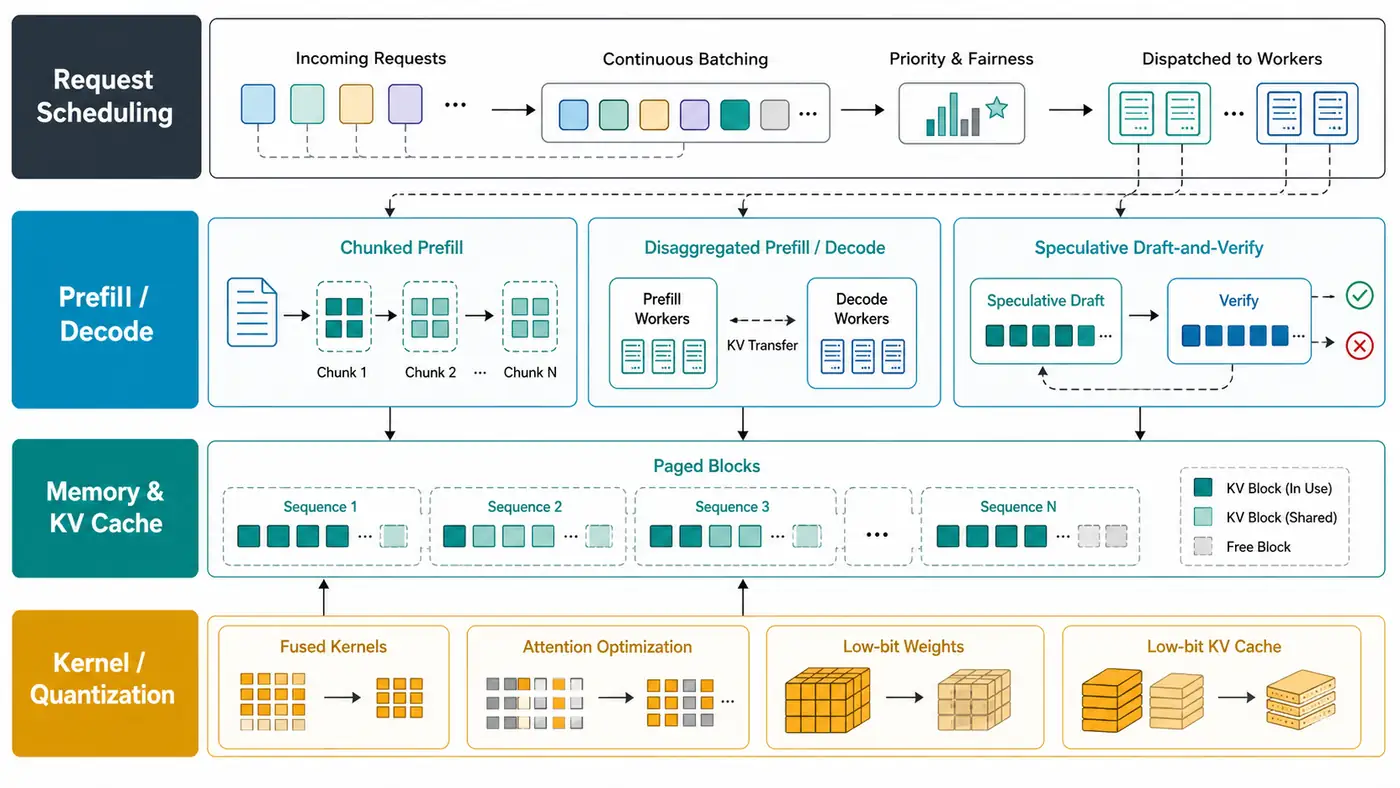
PagedAttention 讓 KV cache 可以按塊分頁、共享和按需分配;vLLM 的 Automatic Prefix Caching 把共享前綴的 KV cache 複用工程化;SGLang 的 RadixAttention 針對結構化 prompt、多輪對話和程序化 generation 複用前綴;Mooncake 則把 KV cache 放到架構中心,用 CPU DRAM、SSD 和獨立 cache 層來服務超長上下文與過載場景。
第二條線:prefill/decode 逐步解耦。
DistServe、Splitwise、Mooncake 和 TensorRT-LLM/vLLM 的 disaggregated serving 示例都指向同一個判斷:prefill 與 decode 的資源畫像不同,強行 colocate 會導致干擾。2025 年以後的工作進一步探索單 GPU 內部的 prefill/decode 分區、跨節點 KV 傳輸和 stage-aware scheduling。
第三條線:decode 串行瓶頸用投機和多 token 預測緩解。
Speculative decoding 的核心是“便宜模型先猜,目標模型批量驗證”。Medusa 不維護獨立 draft model,而是在目標模型上加多頭;EAGLE 系列從 feature-level draft 走向 EAGLE-3 的 token prediction 與多層特徵融合。TensorRT-LLM 文檔到 2026 年已經列出 DraftTarget、Eagle3、NGram、MTP、PARD、DFlash、SA 等多種 speculative decoding 選項,說明它已經從論文技巧變成 serving 框架標配。
第四條線:量化從權重走向端到端 serving。
GPTQ、AWQ、SmoothQuant 等早期路線主要聚焦權重和激活;KIVI 把 2-bit 非對稱量化用於 KV cache;QServe 用 W4A8KV4 做算法-系統協同;TensorRT-LLM 支持 FP8、FP4、AWQ/GPTQ 和 FP8/NVFP4 KV cache;2025-2026 的 TurboQuant、KVTC、GPU-accelerated INT8 KV cache 等工作繼續把長上下文推理的瓶頸指向 KV cache 壓縮。
第五條線:內核庫成為 serving 框架競爭力。
FlashAttention-3 面向 Hopper GPU 的異步、TMA、FP8 注意力優化;FlashInfer 則把可組合 attention template、JIT、block-sparse KV 格式和負載均衡調度做成 LLM serving kernel engine,並已被 vLLM、SGLang、MLC-Engine 等集成。推理服務的上層 API 越像雲服務,底層就越依賴內核細節。
代表論文分組解讀
1. PagedAttention 與 KV cache 內存管理
vLLM / PagedAttention 的貢獻不只是“快”,而是重新定義了 serving 內存管理接口。傳統實現往往給每個請求預留連續 KV cache 區域,長短請求混合時會產生大量內部和外部碎片。PagedAttention 借鑑虛擬內存,把每個序列的 KV cache 拆成固定大小塊,用 block table 做邏輯塊到物理塊的映射。這樣一來,請求不必佔用連續物理顯存,生成過程中可以按需追加塊;共享 prompt、parallel sampling 和 beam search 也可以通過塊共享和 copy-on-write 減少重複。
這條線的工程啟發是:長上下文 serving 首先是內存系統問題。一個模型是否“能跑滿 GPU”,不只取決於 GEMM 吞吐,還取決於調度器能否把更多活躍請求裝進顯存。vLLM 文檔中的 Automatic Prefix Caching 進一步把複用從論文實驗帶到常見場景:同一長文檔被多次查詢、多輪聊天複用歷史前綴時,新的請求可以跳過共享 prefix 的 prefill 計算。但 APC 也有邊界:它主要減少 prefill,不會縮短長回答的 decode。
2. 結構化生成與 prefix 複用
SGLang 的角度更偏“LLM 程序”。當應用不再是一次 prompt 一次 completion,而是包含檢索、分支、並行調用、JSON 約束、多輪自洽和 agent 控制流時,系統需要知道哪些上下文可以複用、哪些生成步驟可以並行。SGLang 論文提出前端語言和後端 runtime,後端的 RadixAttention 用 radix tree 管理可共享前綴,減少重複 KV cache 與重複計算。它尤其適合 few-shot、RAG、多輪對話和結構化輸出這類共享 prefix 明顯的 workload。
這也解釋了為什麼 2025-2026 年的 serving 框架不再只是“模型加載器”。它們越來越像數據庫執行引擎:要理解請求結構、緩存中間狀態、調度不同階段,並在一致性、延遲和吞吐之間做優化。
3. Prefill / Decode 解耦與 disaggregated serving
DistServe 明確提出把 prefill 和 decode 放到不同 GPU 池中,以減少兩階段干擾,並分別優化 TTFT 與 TPOT。Mooncake 進一步把 KV cache 放在架構中心:在 GPU 集群之外利用 CPU DRAM、SSD 和 cache scheduler,目標是支撐 Kimi 這類長上下文聊天服務。TensorRT-LLM 和 vLLM 最新文檔也都把 disaggregated serving、KV cache connector、KV offloading 等能力列為重要工程接口。
這裡的關鍵不是“所有場景都應該拆分”,而是拆分讓資源規劃更精細。短 prompt、長輸出的聊天流量可能需要強 decode 池;長文檔問答則需要強 prefill 與 cache 複用;agent 工作流還會產生 bursty、可中斷、共享上下文的請求。未來的 serving 平臺很可能按 workload 動態選擇 colocated、chunked prefill、disaggregated prefill/decode、KV offload 或 cache transfer。
4. Speculative decoding:把串行 decode 改成草稿與驗證
Leviathan 等人的 speculative decoding 和 DeepMind 的 speculative sampling 都利用一個事實:目標模型一次驗證多個候選 token 的代價,常常接近驗證一個 token;如果便宜 draft model 能猜中多個 token,就能減少目標模型串行 forward 次數。理論上,帶拒絕採樣的版本可以保持目標模型採樣分佈不變。
後續方法開始解決“draft 從哪裡來”。Medusa 在模型上加多個解碼頭,避免維護單獨小模型;EAGLE 系列用目標模型內部特徵或多層特徵構建高接受率 draft;EAGLE-3 在 2025 年報告了對聊天和 reasoning 模型更強的加速效果。TensorRT-LLM 到 2026 年的文檔已經把 EAGLE 3、NGram、MTP、Suffix Automaton 等作為可配置選項。這說明 speculative decoding 的工程問題已經從“能否加速”轉為“什麼 workload、什麼 batch size、什麼 acceptance rate 下值得啟用”。
5. 量化:從模型文件壓縮到 serving 協同
低比特量化最容易被誤解成“把模型變小”。在 serving 中,更重要的是它改變了內存帶寬、cache 容量、反量化開銷和 kernel 形態。QServe 的 W4A8KV4 很典型:它不僅提出 4-bit weight、8-bit activation、4-bit KV cache 的 QoQ 算法,還配套實現 QServe runtime,強調低比特如果讓 CUDA core 上的反量化變慢,理論壓縮不一定轉化成吞吐提升。
KV cache 量化尤其重要。KIVI 觀察 key cache 與 value cache 的分佈不同,分別採用 per-channel 與 per-token 策略,提出 tuning-free 2-bit KV cache 量化。2025-2026 年的 TurboQuant、KVTC、eOptShrinkQ、Fast-TurboQuant 和 GPU-accelerated INT8 KV cache 工作繼續沿著“長上下文內存瓶頸”推進。需要注意的是,2026 年的新論文與廠商博客中有些指標仍需按具體硬件、模型、上下文長度和 workload 人工複測,不能直接當成通用 SOTA。
6. 內核與編譯:FlashAttention-3、FlashInfer 與硬件協同
FlashAttention 的核心思想是 IO-aware exact attention:通過 tiling 降低 HBM 讀寫,而不是隻優化算子 FLOPs。FlashAttention-3 面向 Hopper GPU,利用 Tensor Core 與 TMA 的異步能力、warp specialization、FP8 等硬件特性,說明 attention kernel 會隨著硬件代際持續重寫。FlashInfer 則把注意力內核做成 serving-oriented engine,支持多種 KV cache 格式、JIT template 和負載均衡調度。
對工程團隊來說,這意味著“換一個 serving 框架”不只是 API 遷移,還可能改變 kernel 後端、CUDAGraph 策略、batch invariance、量化 recipe 和可觀測指標。推理性能調優必須用真實請求分佈壓測,不能只看單條樣例或固定長度 benchmark。
方法對比表
| 方向 | 代表工作 / 系統 | 主要解決的問題 | 適合場景 | 主要風險 |
|---|---|---|---|---|
| Paged KV cache | PagedAttention / vLLM | KV cache 碎片、動態增長、共享前綴 | 多租戶 serving、長上下文、beam/parallel sampling | kernel 與內存管理複雜度上升 |
| Prefix reuse | vLLM APC、SGLang RadixAttention | 重複 prompt / 歷史上下文重複計算 | RAG、多輪對話、few-shot、agent 程序 | 對共享前綴敏感,長輸出收益有限 |
| Prefill/decode 解耦 | DistServe、Mooncake、TensorRT-LLM/vLLM disaggregated serving | prefill 與 decode 干擾、SLO 拆分 | 長上下文、混合流量、大規模集群 | KV 傳輸、調度和容量規劃複雜 |
| Speculative decoding | Leviathan、Speculative Sampling、Medusa、EAGLE-3 | decode 串行步數多、低 batch 延遲高 | 低 batch、短到中等輸出、draft 接受率高 | draft 維護成本、接受率波動、batch 大時收益下降 |
| KV / weight 量化 | KIVI、QServe、TensorRT-LLM FP8/NVFP4、TurboQuant | 顯存和帶寬瓶頸 | 長上下文、高併發、邊緣或成本敏感部署 | 精度、反量化開銷、硬件支持差異 |
| Attention kernel | FlashAttention-3、FlashInfer | HBM 讀寫、kernel 調度、硬件利用率 | Hopper/Blackwell 等新 GPU、長上下文 | 依賴硬件與框架集成,復現實驗門檻高 |
關鍵技術趨勢
趨勢一:KV cache 會成為推理系統的“數據層”。
未來 serving 不只是加載權重和跑 forward,而是管理可複用 KV、可壓縮 KV、可遷移 KV、可過期 KV。長上下文 agent、代碼倉庫問答和多輪工作流越普及,KV cache 的生命週期管理越像數據庫緩存和存儲系統。
趨勢二:調度器從 batch scheduler 變成 SLO scheduler。
連續 batching 只是起點。系統需要同時看 TTFT、TPOT、輸出長度預測、prefix 命中率、GPU 顯存水位、KV 傳輸成本、租戶優先級和拒絕策略。Mooncake 的 early rejection、DistServe 的 goodput 優化、Nexus 的 intra-GPU 分區都說明,serving 研究正在從平均吞吐轉向尾延遲和 SLO。
趨勢三:投機解碼會和模型訓練共同設計。
早期 speculative decoding 可以外掛小模型;現在 EAGLE-3、MTP、Medusa 等方法暗示,模型可能在訓練或 post-training 階段就為多 token 預測、draft head 或驗證路徑預留結構。推理系統和模型結構會更強耦合。
趨勢四:低比特不是單點算法,而是系統協同。
權重量化、激活量化、KV cache 量化、FP8/FP4 kernel、反量化 fusion、scheduler batch size 都會影響最終收益。只報告 perplexity 或壓縮率不夠,必須報告端到端 TTFT、TPOT、吞吐和成本。
趨勢五:開源 serving 框架會繼續向生產棧靠攏。
vLLM、SGLang、TensorRT-LLM、llama.cpp、TGI、MLC 等生態不再只拼單機速度,還會拼 OpenAI-compatible API、Kubernetes 部署、metrics、KV connector、LoRA serving、structured output、reasoning parser 和多硬件後端。
工程落地啟發
第一,先做 workload 畫像,再選優化。至少要統計輸入長度、輸出長度、併發、共享前綴比例、流式比例、工具調用鏈長度和 SLO。沒有這些數據,討論 PagedAttention、spec decoding 或量化都是盲調。
第二,把 TTFT 和 TPOT 分開看。長文檔問答的用戶可能最敏感 TTFT;代碼生成和長回答更敏感 TPOT;agent 內部調用可能更在意總完成時間和併發成本。不同指標會導向不同系統方案。
第三,KV cache 預算要獨立規劃。不要只問“模型權重佔多少顯存”。在長上下文和高併發下,KV cache 可能超過權重成為主要顯存佔用;prefix caching、KV offload、KV quantization 和 cache eviction 需要一起設計。
第四,speculative decoding 需要在線開關和回退。它不是普遍加速器:低 batch、draft 接受率高、目標模型驗證效率高時收益明顯;大 batch、長複雜推理、draft 與目標分佈不匹配時可能退化。生產系統應按模型、請求類型和 batch 狀態動態啟用。
第五,量化必須端到端壓測。權重 4-bit 不等於吞吐翻倍,KV 4-bit 也不等於無損。要同時測任務質量、長上下文召回、結構化輸出穩定性、工具調用 JSON 合法率、反量化開銷和硬件兼容性。
第六,保留可觀測性。至少記錄 prefill tokens/s、decode tokens/s、KV cache hit rate、prefix cache 命中、GPU 顯存碎片、queueing delay、spec acceptance rate、rejected tokens、per-tenant SLO 和 OOM/eviction 事件。
侷限與爭議
第一,很多論文指標依賴特定模型、硬件和 workload。比如 EAGLE-3 的加速、QServe 的吞吐提升、TurboQuant 的壓縮收益,都不能無條件遷移到私有模型、不同 GPU 或 agent 流量。
第二,系統複雜度正在快速上升。Paged KV、disaggregated serving、KV offload、speculation、量化和多後端部署疊加後,debug 難度會顯著增加。一次性能回退可能來自調度、網絡、cache 命中、kernel fallback 或 tokenizer 不一致。
第三,質量評估仍不充分。低比特和投機方法常用 perplexity、MMLU、LongBench 或局部任務驗證,但生產應用還關心格式穩定、拒答邊界、工具參數正確性和多輪一致性。這些指標很少在系統論文中完整覆蓋。
第四,生態版本變化快。vLLM、SGLang、TensorRT-LLM 的 feature matrix、支持模型、量化 recipe 和 speculative decoding 實現都在快速演進。本文中涉及 2026 年文檔和新聞的部分,建議在部署前以項目最新 release notes 與本地 benchmark 複核。
接下來值得關注的問題
- KV cache 會不會形成標準化接口?如果 vLLM、TensorRT-LLM、SGLang、LMCache、Mooncake connector 能互通,推理平臺會更像可組合存儲系統。
- 推理型模型會不會原生訓練 speculative head 或 verifier?這可能讓 test-time compute 與 efficient serving 進一步合流。
- 多模態與 agent workload 會怎樣改變調度器?圖像、視頻、工具調用和代碼執行會帶來更異構的階段。
- 低比特 KV cache 的質量邊界在哪裡?長上下文檢索、數學推理、代碼補全和安全拒答可能有不同敏感性。
- AI-generated kernel 能否進入生產閉環?FlashInfer-Bench 這類工作把 agent 寫 kernel、benchmark、替換生產實現連起來,值得持續觀察。
總結
Efficient LLM Inference 與 Serving 已經不是單一加速技巧,而是一整套系統工程:KV cache 管理決定能裝下多少上下文和併發;調度決定吞吐是否能轉化成用戶可感知延遲;投機解碼挑戰 autoregressive 串行瓶頸;量化改變內存、帶寬和 kernel 形態;FlashAttention、FlashInfer 這類內核工作則決定框架能否真正吃到硬件紅利。
對研究者來說,這個方向的機會在於把算法、模型結構和系統約束一起建模。對工程團隊來說,最重要的不是追逐某一個“最快框架”,而是建立可測量、可回退、可分層演進的推理平臺:真實流量畫像、端到端指標、緩存策略、動態調度、量化驗證和版本化 benchmark,才是 2026 年 LLM 應用成本控制的底盤。
參考資料
檢索日期:2026-07-04。以下優先列出論文、官方文檔、項目主頁等一手資料;涉及 2026 年新資料的性能數字建議部署前人工複核。
- Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” arXiv, 2023. https://arxiv.org/abs/2309.06180
- vLLM Documentation, “Automatic Prefix Caching,” latest developer preview, accessed 2026-07-04. https://docs.vllm.ai/en/latest/features/automatic_prefix_caching/
- Zheng et al., “SGLang: Efficient Execution of Structured Language Model Programs,” arXiv, 2023 / NeurIPS 2024. https://arxiv.org/abs/2312.07104
- Zhong et al., “DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving,” arXiv, 2024. https://arxiv.org/abs/2401.09670
- Qin et al., “Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving,” arXiv, 2024. https://arxiv.org/abs/2407.00079
- Leviathan et al., “Fast Inference from Transformers via Speculative Decoding,” arXiv, 2022 / ICML 2023. https://arxiv.org/abs/2211.17192
- Chen et al., “Accelerating Large Language Model Decoding with Speculative Sampling,” arXiv, 2023. https://arxiv.org/abs/2302.01318
- Cai et al., “Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads,” arXiv, 2024. https://arxiv.org/abs/2401.10774
- Li et al., “EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test,” arXiv, 2025. https://arxiv.org/abs/2503.01840
- NVIDIA TensorRT-LLM Documentation, “Speculative Decoding,” accessed 2026-07-04. https://nvidia.github.io/TensorRT-LLM/features/speculative-decoding.html
- Liu et al., “KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache,” arXiv, 2024. https://arxiv.org/abs/2402.02750
- Lin et al., “QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving,” arXiv, 2024. https://arxiv.org/abs/2405.04532
- NVIDIA TensorRT-LLM Documentation, “Quantization,” accessed 2026-07-04. https://nvidia.github.io/TensorRT-LLM/features/quantization.html
- Zandieh et al., “TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate,” arXiv, 2025. https://arxiv.org/abs/2504.19874
- Staniszewski and Łańcucki, “KV Cache Transform Coding for Compact Storage in LLM Inference,” arXiv, 2025. https://arxiv.org/abs/2511.01815
- Dao et al., “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” arXiv, 2022. https://arxiv.org/abs/2205.14135
- Shah et al., “FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision,” arXiv, 2024. https://arxiv.org/abs/2407.08608
- Ye et al., “FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving,” arXiv, 2025. https://arxiv.org/abs/2501.01005
- Xing et al., “FlashInfer-Bench: Building the Virtuous Cycle for AI-driven LLM Systems,” arXiv, 2026. https://arxiv.org/abs/2601.00227
- Li et al., “LLM Inference Serving: Survey of Recent Advances and Opportunities,” arXiv, 2024. https://arxiv.org/abs/2407.12391
- Miao et al., “Towards Efficient Generative Large Language Model Serving: A Survey from Algorithms to Systems,” arXiv, 2023. https://arxiv.org/abs/2312.15234
- Shi et al., “Nexus: Proactive Intra-GPU Disaggregation of Prefill and Decode in LLM Serving,” arXiv, 2025. https://arxiv.org/abs/2507.06608
- Tiwari et al., “QuantSpec: Self-Speculative Decoding with Hierarchical Quantized KV Cache,” arXiv, 2025. https://arxiv.org/abs/2502.10424
- Su, “eOptShrinkQ: Near-Lossless KV Cache Compression Through Optimal Spectral Denoising and Quantization,” arXiv, 2026. https://arxiv.org/abs/2605.02905
- Pereira et al., “Fast-TurboQuant: A Multiplier-Free Online Vector Quantization Approach,” arXiv, 2026. https://arxiv.org/abs/2606.21448