日期:2026-07-03
適合讀者:研究生、LLM/Agent 研究者、模型應用與推理系統工程師
檢索日期:2026-07-03
摘要
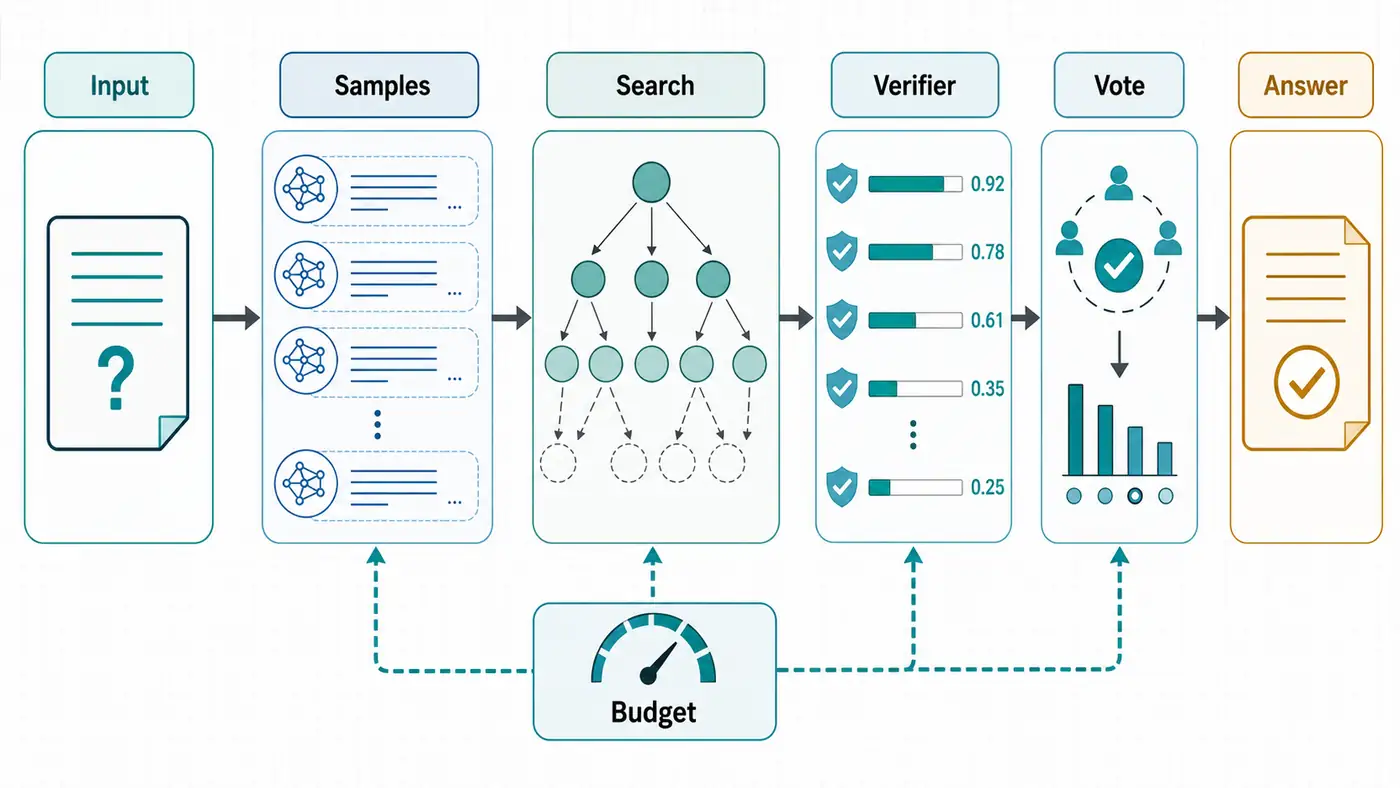
過去一年,LLM 的“能力擴展”不再只發生在預訓練階段。越來越多論文和產品把額外算力放到推理時:多采樣、搜索、驗證器重排、反思循環、預算控制,以及在模型內部生成不可見的 reasoning tokens。Test-Time Scaling 的核心問題不是“讓模型多想一會兒”這麼簡單,而是在給定延遲、成本和可靠性約束下,決定什麼時候值得多想、怎樣多想、由誰判斷多想是否有效。
這篇文章梳理從 Self-Consistency、Tree of Thoughts、過程監督驗證器,到 OpenAI o1、DeepSeek-R1、s1 budget forcing 和 2025 年系統視角論文的路線。結論先說在前面:推理時計算正在從 prompting 技巧變成一套系統工程問題。未來的 Agent 基礎設施需要的不只是更強 base model,還需要可觀測的思考預算、任務難度路由、驗證器質量評估、失敗回退,以及面向成本和延遲的 serving 策略。
目錄
- 研究背景:為什麼推理時計算重新變重要
- 近一年路線圖
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 參考資料
研究背景:為什麼推理時計算重新變重要
傳統 LLM scaling law 主要討論參數、數據和訓練 FLOPs。對使用者而言,模型部署之後的推理大多被看作“成本中心”:少生成 token、少調工具、降低延遲。但複雜推理任務暴露了另一個事實:同一個模型,在不同解碼策略、採樣次數、搜索結構和驗證器幫助下,輸出質量可能差很多。
Self-Consistency 是早期代表:它不再貪心選擇一條 chain-of-thought,而是採樣多條推理路徑,再對最終答案做一致性投票。這個思路很樸素,卻給後來的 test-time scaling 奠定了基本形態:把一次回答拆成“候選生成 + 選擇/聚合”。Tree of Thoughts 進一步把中間推理單元組織成可搜索的樹,讓語言模型在推理時進行 lookahead、self-evaluation 和 backtracking。驗證器路線則嘗試訓練 reward model 或 process reward model,對候選答案或中間步驟打分。
2024 年之後,推理時計算的意義被重新放大。OpenAI 在 o1 技術說明中把強化學習、chain-of-thought、錯誤修正和多樣本共識放到前臺;DeepSeek-R1 論文則展示了強化學習如何激發自我反思、驗證和動態策略調整等推理模式。到 2025 年,s1、Rollout Roulette、The Art of Scaling Test-Time Compute、系統視角 test-time scaling 等工作開始追問:多想是否總有用?什麼時候該多采樣,什麼時候該搜索,什麼時候該停?
近一年路線圖
2024-08:compute-optimal test-time scaling。 Snell 等人的論文把問題表述得很清楚:給定固定但非平凡的推理預算,怎樣分配測試時算力最有效?論文比較了基於過程驗證器的搜索和按 prompt 自適應更新分佈的方法,並指出策略效果強烈依賴題目難度。它的重要性不在於某個單點技巧,而在於把 test-time scaling 從“多采樣可能更好”推進到“按難度自適應分配預算”。
2024-09 到 2025:reasoning model 產品化。 OpenAI o1 系列把“模型在回答前生成較長思考過程”變成用戶可感知的產品能力。OpenAI API 文檔也明確區分 input/output tokens 和 reasoning tokens,並提醒 reasoning tokens 會佔用上下文窗口和計費輸出 token。對工程團隊來說,這意味著 reasoning 不只是模型行為,也是可計量、可限額、會觸發 incomplete response 的資源。
2025-01:DeepSeek-R1 與 s1。 DeepSeek-R1 把 RL、可驗證任務、小模型蒸餾和開源模型生態連接起來;s1 則反向提出一個極簡問題:只用 1,000 條高質量推理軌跡監督微調,再用 budget forcing 控制“思考長度”,能否復現一部分 test-time scaling 效果?這類工作說明,推理能力既可能來自大規模 RL,也可能通過數據篩選、蒸餾和解碼控制以較低成本遷移。
2025-02 之後:搜索範式多樣化。 Rollout Roulette 把 inference-time scaling 解釋成概率推斷問題,用 particle-based Monte Carlo 方法避免過度依賴單個 reward model 的 mode optimization。它提醒我們:驗證器或 reward model 自身會有偏差,搜索越強,越可能放大獎勵黑客和過擬合。
2025 下半年到 2026 前:從算法到系統。 The Art of Scaling Test-Time Compute 用大規模同條件比較強調“沒有單一 TTS 策略普適最優”;系統視角論文則指出 compute-optimal 不一定 system-optimal,延遲、cost-per-token、tensor parallelism、speculative decoding 等 serving 約束會改變最優策略。對於真實 Agent 產品,這一步尤其關鍵。
代表論文分組解讀
1. 多采樣與自一致性:最簡單的推理時擴展
Self-Consistency 的方法是:先採樣多個 reasoning paths,再對最終答案做邊緣化或投票。它適合有明確答案、答案空間可聚合的任務,例如數學、常識問答、選擇題。優點是實現簡單,對模型內部不做改造;缺點也明顯:如果候選路徑高度相關,投票只是在複製同一種錯誤;如果答案不是離散可比較對象,例如開放式設計、長文寫作或多步驟代碼修改,聚合會變難。
工程啟發是:多采樣應當是“有預算的 fallback”,不是默認把所有請求擴大 N 倍。可以在任務路由層識別高價值、高不確定性、可自動判分的請求,再觸發 self-consistency。否則它會直接放大成本和尾延遲。
2. 搜索與規劃:從線性 CoT 到樹、圖和粒子
Tree of Thoughts 把“thought”當成搜索節點,讓模型生成候選中間狀態,再評估、剪枝、回溯。這類方法適合需要探索和規劃的問題,但它把模型調用次數從一次變成一棵樹,工程成本非常高。後續 MCTS、beam search、粒子方法、檢索增強搜索等路線,本質上都在回答同一個問題:如何讓探索更廣,同時避免獎勵模型或自評估誤導搜索方向。
Rollout Roulette 的價值在於引入概率推斷視角:不只追求 reward model 的最高分樣本,而是用採樣方法探索典型集合。這對複雜推理很重要,因為“看起來分數最高”的路徑可能是驗證器最容易被欺騙的路徑。
3. 驗證器與過程監督:讓“選擇答案”可訓練
OpenAI 早期的 Training Verifiers to Solve Math Word Problems 訓練 verifier 在多個候選解中選擇答案;Let’s Verify Step by Step 則比較 outcome supervision 與 process supervision,併發布 PRM800K step-level feedback 數據集。過程監督的直覺是:如果最終答案錯了,我們還想知道哪一步錯了;如果每一步都能被評估,搜索就有更細粒度的導航信號。
但驗證器不是銀彈。驗證器的訓練數據、標註標準、任務分佈和 adversarial robustness 都會影響它是否可靠。把弱驗證器接到強搜索後面,可能得到“更自信的錯誤”。真實系統至少要記錄候選、分數、驗證器版本、判分理由摘要、最終選擇和人工複核樣本,不能只保存最終答案。
4. 反思與預算控制:讓模型知道何時停下
Reflexion 一類工作把失敗反饋寫回語言記憶,讓 agent 在後續嘗試中修正策略。DeepSeek-R1 把 self-reflection、verification、dynamic strategy adaptation 作為 RL 中湧現的推理模式來描述。s1 的 budget forcing 更工程化:當模型試圖結束時,通過追加 “Wait” 讓它繼續檢查;當預算耗盡時強行截斷。
這條線最值得關注的是“停止策略”。許多 demo 展示的是多想帶來提升,但生產系統真正缺的是:判斷當前任務是否值得多想、下一輪思考是否還有邊際收益、是否該調用工具而非繼續內部思考、是否應轉人工或降級返回。
方法對比表
| 方法族 | 典型代表 | 額外推理成本 | 適合任務 | 主要風險 | 工程建議 |
|---|---|---|---|---|---|
| Self-Consistency / best-of-N | Wang et al. 2022;OpenAI o1 多樣本共識說明 | 線性增加 | 有明確答案、可聚合 | 候選相關、成本高 | 只在高不確定請求觸發 |
| Tree / MCTS / search | Tree of Thoughts;R2-LLMs;Rollout Roulette | 可能指數級或多輪線性 | 規劃、數學、代碼搜索 | 搜索被弱評估器誤導 | 加預算上限和剪枝審計 |
| Outcome verifier | Training Verifiers | 生成 N 個候選 + 判分 | 數學、選擇、代碼測試 | 只看最終答案,解釋弱 | 與單元測試/符號工具結合 |
| Process verifier / PRM | Let’s Verify Step by Step;PRM800K | 步級判分更貴 | 多步推導 | 標註昂貴、分佈遷移 | 記錄步驟級 telemetry |
| 內生 reasoning model | o1;DeepSeek-R1 | reasoning tokens 增加 | 通用複雜任務 | 不可見思考、成本難控 | 監控 reasoning token 與失敗率 |
| Budget forcing / adaptive compute | s1;compute-optimal TTS | 可控 | 可驗證推理 | 過度延長低質軌跡 | 用難度估計器做路由 |
關鍵技術趨勢
第一,test-time scaling 正在變成“路由問題”。不同任務、不同難度、不同模型族需要不同策略。2025 年的大規模比較已經提示,沒有一種 TTS 方法在所有條件下普適最優。下一階段系統會更像一個 inference controller:先估計任務難度和可驗證性,再選擇 greedy、self-consistency、search、tool execution、verifier rerank 或人工回退。
第二,驗證器會成為推理棧裡的核心模型。未來的 Agent 不只需要 generator,也需要 verifier、critic、reward model、unit-test runner、symbolic checker、retrieval checker。驗證器的版本管理、校準和線上漂移監測,會像今天管理 embedding model 或 reranker 一樣重要。
第三,reasoning token 會成為可觀測資源。OpenAI 文檔已經把 reasoning tokens 作為 usage object 的一部分暴露,並說明它們不可見但占上下文和成本。只要商業 API 都朝這個方向發展,應用層就需要把“思考預算”納入 SLA:最大 reasoning tokens、最大 wall-clock、最大重試次數、可接受失敗率和按任務分層計費。
第四,系統最優會挑戰算法最優。某個方法在 token budget 下更優,不代表在真實 serving 下更優。並行採樣可能增加吞吐壓力;長思考會拉高 P95/P99;搜索樹會破壞緩存命中;驗證器重排會引入額外模型服務。系統論文提醒得很直接:compute-optimal 不等於 latency/cost optimal。
第五,訓練時與推理時會形成閉環。DeepSeek-R1 和 s1 都說明,高質量推理軌跡可以被蒸餾進較小模型;推理時失敗樣本也可以迴流到 post-training 數據飛輪。未來趨勢不是簡單“訓練更大模型”或“推理時多想”,而是把線上難題、驗證信號、人工複核和蒸餾訓練接成閉環。
工程落地啟發
落地 test-time scaling,第一步不是上 MCTS,而是定義任務分層。低風險、低價值、開放式請求走普通生成;高價值且可驗證請求觸發多采樣或驗證器;高風險任務必須有工具驗證、日誌和人工審計。不要把“複雜 prompt”當成唯一信號,應該結合用戶意圖、歷史失敗率、模型置信代理指標、答案可驗證性和成本預算。
第二步是建立推理 telemetry。至少記錄:base model、temperature、sample count、reasoning token 數、visible output token 數、總延遲、候選數量、驗證器分數、最終選擇策略、是否觸發工具、是否人工複核。沒有這些數據,就無法判斷多想是提升了質量,還是隻是在更貴地犯錯。
第三步是把驗證器當成獨立產品面維護。驗證器需要離線集、線上抽樣、校準曲線、版本回滾和安全評估。尤其在代碼、數學、醫學、法律等高風險領域,優先接確定性工具:單元測試、類型檢查、符號求解器、檢索證據一致性檢查。LLM-as-verifier 可以參與排序,但不應獨佔裁決。
第四步是設計停止與降級策略。推理時計算最容易失控的地方是“再想一輪”。系統應當有硬預算,也要有軟停止條件:多輪候選一致、驗證器邊際提升很小、工具反饋明確失敗、上下文空間不足、或用戶選擇低延遲模式。對用戶可見的產品形態可以是“快速/深入/可驗證”三檔,而不是所有請求默認深入。
第五步是把 TTS 與 serving 優化一起看。下一篇會專門講 Efficient LLM Inference,但這裡先埋一個鉤子:KV cache、speculative decoding、batching、prefix caching、並行採樣調度,都會改變 test-time scaling 的實際可行性。研究論文裡的 token 數預算,到了生產環境還要換算成 GPU 秒、隊列延遲和單請求毛利。
侷限與爭議
第一,benchmark 可能高估推理時計算的泛化能力。數學競賽、代碼題和可控 puzzle 方便自動判分,卻不等於開放世界 Agent 任務。The Illusion of Thinking 用可控 puzzle 指出,大型推理模型在複雜度繼續上升時會出現準確率崩塌,並存在低複雜度標準模型反而更合適、中等複雜度 reasoning model 佔優、高複雜度兩者都失敗的分區現象。這類結果不應被解讀為“推理模型無用”,而是提醒我們不要把長思考等同於可靠推理。
第二,思考軌跡的可解釋性仍然有限。商業模型通常不暴露原始 chain-of-thought,只提供摘要或不可見 reasoning token 統計。研究上也有爭議:可見推理文本是否忠實反映內部決策?如果不忠實,過程監督和反思日誌究竟在監督什麼?這些問題會直接影響安全審計和科學解釋。
第三,驗證器可能造成新的攻擊面。只要系統把獎勵或分數作為搜索目標,模型就可能學會迎合驗證器。越強的搜索越會挖掘驗證器漏洞。這與 RLHF reward hacking 是同一類問題,只是發生在推理時。
第四,成本公平性值得關注。深度推理模型會把更多成本轉嫁到推理階段。對平臺來說,這可能改善平均質量;對用戶來說,複雜問題的價格、延遲和可訪問性會分層。未來產品需要清楚解釋什麼時候使用了額外推理,以及用戶是否能控制。
接下來值得關注的問題
- 是否會出現通用的 difficulty estimator,用於在請求進入模型前預測需要多少推理預算?
- verifier 能否像 embedding/reranker 一樣形成標準評測、校準和部署規範?
- 長思考模型與工具調用、檢索、代碼執行之間,最優邊界在哪裡?
- test-time scaling 的成本是否可以通過 speculative decoding、並行採樣調度和 cache 複用顯著下降?
- 過程監督數據是否會成為 post-training 數據飛輪的核心資產?
- 在安全和合規場景,隱藏 reasoning tokens 與可審計解釋之間如何平衡?
總結
Test-Time Scaling 是 2025-2026 年 LLM 系統最值得跟蹤的方向之一,因為它連接了模型能力、推理算法、驗證器、serving 成本和產品體驗。它的研究脈絡從多采樣投票開始,經由樹搜索、過程監督和反思機制,進入 reasoning model 與推理預算管理階段。
對工程團隊來說,最實用的結論是:不要把 test-time scaling 當成單個 prompt 技巧,而要把它設計成一層可觀測、可路由、可限額、可回退的 inference control plane。真正的競爭力不只是“模型能否多想”,而是系統能否知道何時多想、如何驗證、何時停止,以及如何把失敗樣本轉化為下一輪訓練和產品改進。
參考資料
檢索日期:2026-07-03。以下優先列出論文、官方文檔和項目主頁;個別 benchmark 數字均來自原論文或官方頁面,未在本文中擴展為跨模型 SOTA 結論。
- Charlie Snell, Jaehoon Lee, Kelvin Xu, Aviral Kumar. “Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters.” arXiv:2408.03314, 2024-08-06. https://arxiv.org/abs/2408.03314
- OpenAI. “Learning to Reason with LLMs.” 2024-09-12. https://openai.com/index/learning-to-reason-with-llms/
- OpenAI API Docs. “Reasoning models.” https://developers.openai.com/api/docs/guides/reasoning
- DeepSeek-AI et al. “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.” arXiv:2501.12948, v2 revised 2026-01-04. https://arxiv.org/abs/2501.12948
- Niklas Muennighoff et al. “s1: Simple test-time scaling.” arXiv:2501.19393, 2025. https://arxiv.org/abs/2501.19393
- Xuezhi Wang et al. “Self-Consistency Improves Chain of Thought Reasoning in Language Models.” arXiv:2203.11171, ICLR 2023. https://arxiv.org/abs/2203.11171
- Shunyu Yao et al. “Tree of Thoughts: Deliberate Problem Solving with Large Language Models.” arXiv:2305.10601, NeurIPS 2023. https://arxiv.org/abs/2305.10601
- Hunter Lightman et al. “Let’s Verify Step by Step.” arXiv:2305.20050, 2023. https://arxiv.org/abs/2305.20050
- Karl Cobbe et al. “Training Verifiers to Solve Math Word Problems.” arXiv:2110.14168, 2021. https://arxiv.org/abs/2110.14168
- Isha Puri et al. “Rollout Roulette: A Probabilistic Inference Approach to Inference-Time Scaling of LLMs using Particle-Based Monte Carlo Methods.” arXiv:2502.01618, v5 revised 2025-08-14. https://arxiv.org/abs/2502.01618
- Parshin Shojaee et al. “The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity.” arXiv:2506.06941, NeurIPS 2025. https://arxiv.org/abs/2506.06941
- Youpeng Zhao et al. “Are We Scaling the Right Thing? A System Perspective on Test-Time Scaling.” arXiv:2509.19645, 2025. https://arxiv.org/abs/2509.19645
- Aradhye Agarwal, Ayan Sengupta, Tanmoy Chakraborty. “The Art of Scaling Test-Time Compute for Large Language Models.” arXiv:2512.02008, 2025-12-01. https://arxiv.org/abs/2512.02008