日期:2026-07-02
適合讀者:研究生、科研讀者、AI 工程師、AI 產品/平臺架構師
摘要
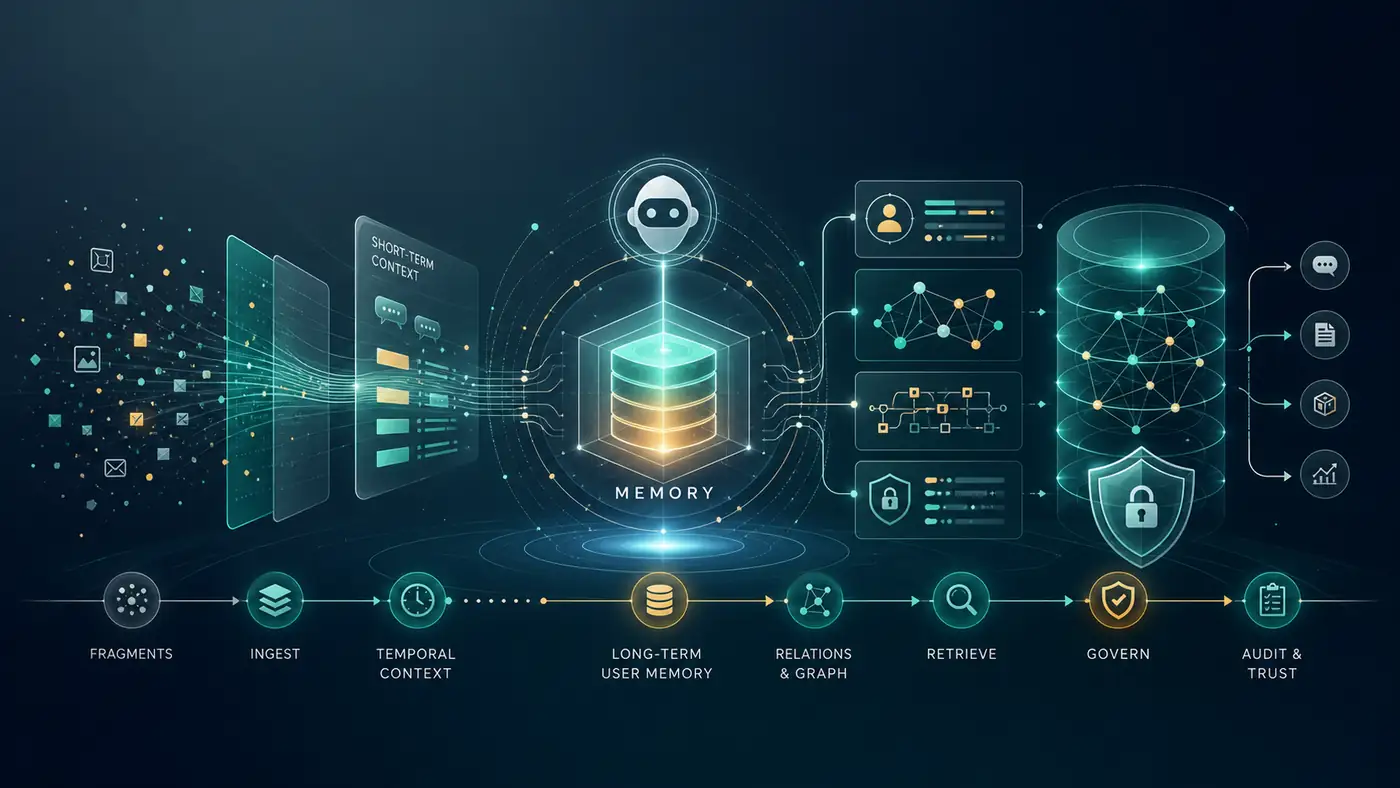
Agent Memory 正在從「把聊天記錄塞進向量庫」變成一套獨立的系統工程:它要決定什麼值得記、怎麼抽取、如何合併衝突、何時遺忘、如何檢索、如何向用戶解釋,以及如何在隱私、審計和刪除權之間取得平衡。2025-2026 年的新論文顯示,長期記憶已經不再只是 RAG 的一個小插件,而是 agent 基礎設施中的核心資源層:Zep/Graphiti 走向時序知識圖譜,Mem0 和 Memoria 強調可生產化的事實抽取與個性化,A-MEM、AgeMem、EverMemOS 試圖讓 agent 自己管理記憶生命週期,MemOS 把記憶抽象成類似操作系統資源,LongMemEval-V2、PersonaMem-v2、MemoryDocDataSet 則把評測從「能否回憶一句話」推進到環境經驗、隱式偏好和跨源推理。與此同時,ChatGPT Memory、LangGraph Memory、Letta、Mem0 等產品與框架已經把長期記憶帶入真實應用。下一階段的關鍵問題不是「要不要記憶」,而是:哪些記憶有證據、誰有權修改、如何避免記憶投毒和隱私洩露、以及記憶系統能否被評測和治理。
目錄
- 研究背景:為什麼長期記憶突然變成 agent 基礎設施
- 近一年路線圖:從向量庫到記憶操作系統
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
研究背景:為什麼長期記憶突然變成 agent 基礎設施
LLM 的「記憶」至少有三層含義。第一層是參數記憶,即模型權重中固化的知識;第二層是工作記憶,即當前上下文窗口;第三層是外部長期記憶,即跨會話保存、檢索和更新的用戶事實、經驗軌跡、任務偏好、工具使用策略和環境知識。過去很多應用把第三層簡化為「聊天記錄 + embedding + top-k 檢索」,但真正的 agent 場景很快會撞到邊界。
邊界來自三個方面。首先,個性化不是簡單相似度檢索。用戶可能在不同時間表達過相互衝突的偏好,過去事實可能已經過期,隱式偏好也不一定應該被系統自動保存。其次,agent 的記憶不只關於用戶,還關於任務和環境:某個代碼倉庫的構建坑、某個網頁後臺的操作路徑、某個科研項目的實驗失敗記錄,都需要長期保留。第三,記憶天然涉及治理。一個能跨月、跨應用、跨設備記住你的系統,也可能錯誤推斷你的心理狀態、洩露敏感信息、被攻擊者寫入惡意記憶,或者在用戶要求刪除後仍通過摘要和派生事實殘留。
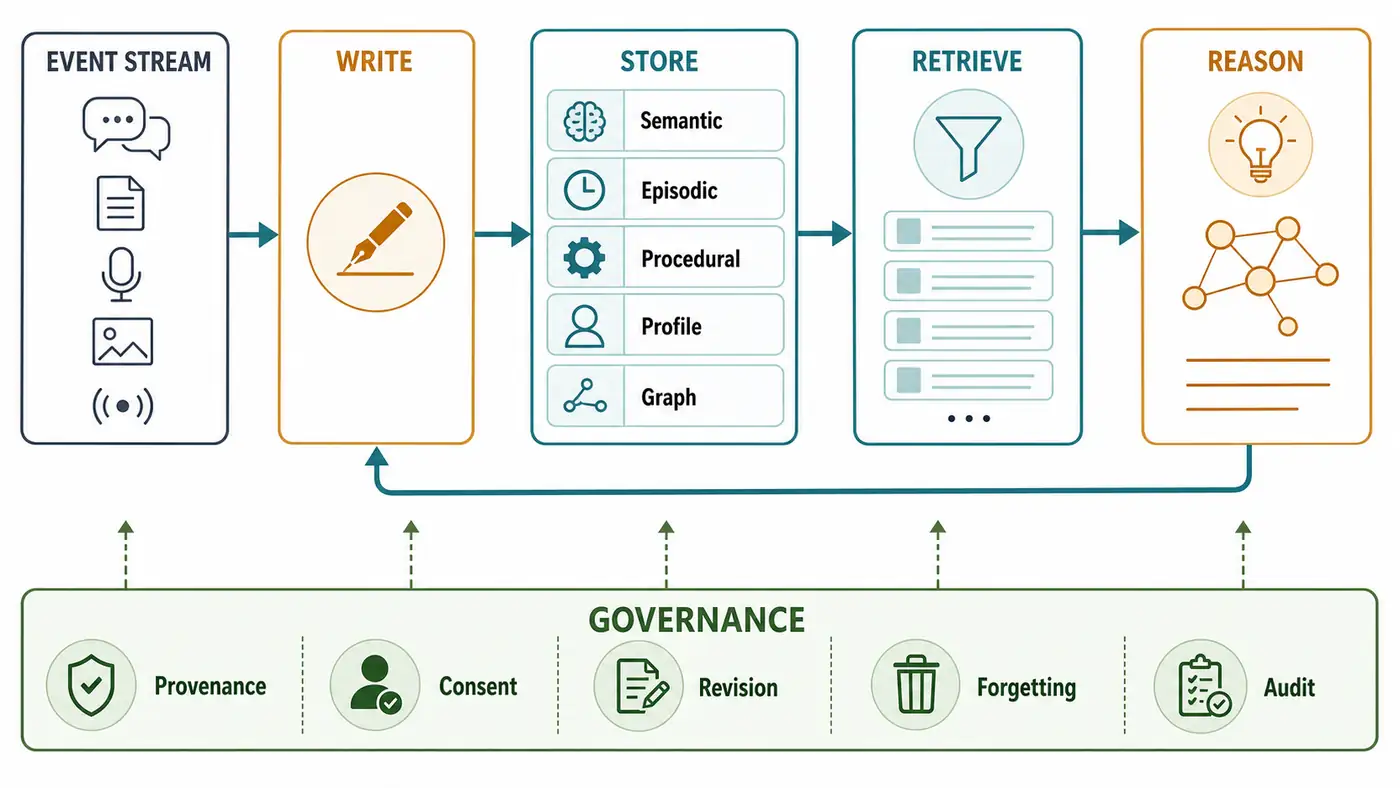
因此,Agent Memory 的研究重心正在從「提升召回率」轉向「生命週期管理」。一個成熟記憶系統至少包含寫入、抽取、歸併、版本化、檢索、重排序、引用、刪除、遺忘、審計和權限控制。它更像數據庫、搜索引擎、日誌系統和隱私平臺的組合,而不是一個普通向量庫。
近一年路線圖:從向量庫到記憶操作系統
2023 年的 Generative Agents、MemoryBank 和 MemGPT 奠定了三條基礎路線。Generative Agents 把觀察、反思和規劃結合起來,讓 agent 從自然語言經驗中形成高層反思;MemoryBank 面向長期陪伴和個性化,嘗試用遺忘曲線、用戶畫像和記憶強化來模擬人類式記憶;MemGPT 則明確借鑑操作系統的層級存儲,把有限上下文窗口看成「虛擬上下文管理」問題。
2025 年開始,路線明顯分化。Zep 提出面向企業 agent 記憶的時序知識圖譜架構,強調動態整合對話和業務數據;A-MEM 借鑑 Zettelkasten,用 agentic 寫入、鏈接和更新組織記憶網絡;Mem0 把生產環境中的長期會話記憶做成可評測框架,並加入圖記憶;MemOS 和 MemoryOS 則把記憶上升為操作系統式資源,討論表示、調度、遷移、融合和治理。到 2025 年底,MIRIX、Memoria、PersonaMem-v2 等工作進一步覆蓋多模態、知識圖譜用戶畫像和隱式個性化。
2026 年的新變化是評測和治理開始補課。LongMemEval-V2 不再只問「用戶過去說過什麼」,而是評測 web agent 是否記住環境狀態、工作流、動態變化和踩坑經驗;MemoryDocDataSet 把多會話記憶與長文檔推理合在一起,暴露出會話檢索和文檔檢索之間的斷裂;Algorithmic Self-Portrait 對真實 ChatGPT 記憶條目做審計,指出系統自動生成記憶會帶來用戶代理權和敏感推斷問題;MemX、SuperLocalMemory、MemPrivacy 等工作則轉向本地優先、記憶投毒防禦和邊雲隱私保護。
代表論文分組解讀
1. 經典基礎:從反思記憶到虛擬上下文
Generative Agents 的核心不是「角色扮演」,而是把 agent 行為拆成 observation、memory stream、retrieval、reflection、planning。它說明長期行為一致性需要經驗記錄和高層反思共同作用。對今天的 agent 平臺來說,這仍是一個重要啟發:原始事件日誌不等於可用記憶,系統需要把低層事件壓縮成可複用經驗。
MemoryBank 則把長期陪伴作為應用場景,強調用戶畫像、情感互動和選擇性遺忘。雖然它的實驗環境與今天生產系統仍有距離,但它提出的「記憶會隨時間強化或衰減」非常現實。不是所有對話內容都應該永久保留;記憶價值應隨新證據、任務頻率和用戶反饋變化。
MemGPT 的影響更偏系統結構。它把上下文窗口視作有限快速存儲,把外部存儲視作慢速長期層,通過模型主動管理內外存交換來擴展有效上下文。這個類比在 2025-2026 年被 MemOS、MemoryOS、EverMemOS 等工作繼續放大:記憶不再是 prompt 附件,而是被調度、壓縮、遷移和審計的資源。
2. 生產化記憶層:事實抽取、圖結構與企業上下文
Zep 的重點是 temporal knowledge graph。它指出企業 agent 面對的不只是靜態文檔,而是持續變化的對話、客戶、項目和業務實體。Graphiti 這類時序圖試圖保存「關係何時成立、何時變化、來自哪裡」。論文報告其在 DMR 和 LongMemEval 相關評測上優於若干基線,但這些數字仍應按預印本和特定實現條件理解,落地前需要在自有數據上覆測。
Mem0 更像一條工程化路線:把會話中的關鍵信息抽取成可檢索事實,並在檢索時只返回最相關記憶。論文報告 Mem0 在 LOCOMO 上相對 OpenAI 記憶方案提升了 LLM-as-a-Judge 指標,並顯著降低 p95 延遲和 token 成本。這裡的關鍵啟發不是某個百分比,而是:長期記憶的收益必須同時看準確率、延遲、token 成本和可維護性。全量上下文也許簡單,但在多會話、多用戶、多 agent 情況下通常不可持續。
Letta 和 LangGraph 的文檔則體現了框架層共識。LangGraph 把短期記憶定義為 thread-scoped state,把長期記憶放入跨線程 namespace/store,並區分 semantic、episodic、procedural memory;Letta 強調 stateful agents,使用 memory blocks、messages、tools 和持久化數據庫管理 agent 狀態。這些產品化接口說明,長期記憶正在成為開發框架的一等公民。
3. Agentic Memory:讓 agent 參與寫入、鏈接和遺忘
A-MEM 的思路是把記憶組織交給 agent,而不是固定 pipeline。新記憶加入時,系統生成帶上下文、關鍵詞、標籤等屬性的 note,並讓 agent 分析歷史記憶、建立連接、更新舊記憶表示。它借鑑 Zettelkasten 的核心思想:知識不是孤立卡片,而是不斷鏈接和演化的網絡。
AgeMem 在 2026 年進一步提出把長短期記憶管理作為 agent policy 的一部分:存儲、檢索、更新、總結、丟棄都可以作為工具動作,並用逐步強化學習訓練何時執行這些動作。這個方向很重要,因為真實 agent 的記憶決策高度依賴任務階段。客服 agent、代碼 agent、科研 agent、個人助理對「值得記住」的判斷完全不同,固定規則很難通吃。
EverMemOS 則強調自組織生命週期:從 episodic trace 形成 MemCells,到 semantic consolidation 形成 MemScenes,再通過 reconstructive recollection 組合下游推理所需上下文。它的概念價值在於把記憶從「寫入一次、檢索多次」改成「持續鞏固、修正、重構」。但這類 agentic 記憶也帶來新風險:系統自動改寫舊記憶時,必須保留原始證據、版本和可回滾能力,否則很難審計錯誤是何時引入的。
4. 個性化與隱式偏好:記住用戶,還是過度推斷用戶?
PersonaMem-v2 把個性化評測推向隱式偏好。現實中用戶很少說「請記住我偏好 X」,更多是在長期對話中間接暴露目標、約束、風格和禁忌。該數據集用大量模擬用戶交互和偏好來評測模型是否能理解隱式 persona,並報告 frontier LLM 在隱式個性化上仍然困難。這裡的工程啟發是:個性化記憶不能只靠顯式 facts,還要處理 preference inference;但推斷越強,治理要求越高。
Algorithmic Self-Portrait 直接審計真實 ChatGPT 記憶條目。論文分析 80 名用戶的 2,050 條記憶,報告多數記憶由系統單方面生成,並包含個人數據和心理推斷。這個結果對所有長期記憶產品都是警示:用戶可能並不知道系統把哪些句子轉化成了長期畫像。記憶界面不應只提供「刪除所有記憶」,還應提供來源、置信度、敏感類型、最近使用記錄和可編輯解釋。
MemPrivacy 則從邊雲架構切入,嘗試在端側識別隱私敏感 span,用類型化佔位符參與雲側記憶處理,再在本地恢復原值。這個方向適合移動端、企業桌面 agent 和醫療/法律/金融等場景:記憶的語義結構可以參與檢索,但原始敏感值不必暴露給雲端。相關實驗數字仍需人工核驗和復現,但問題定義本身已經很清楚。
5. 評測:從聊天回憶到環境經驗與跨源推理
LongMemEval 是長期聊天記憶評測的重要基準,覆蓋信息抽取、多會話推理、時間推理、知識更新和拒答等能力。它提醒我們,長期記憶不是單一檢索任務。一個系統既要找得到舊事實,也要知道事實是否過期,還要在沒有相關記憶時拒絕胡編。
LongMemEval-V2 把對象換成 specialized web environments。它評測 agent 是否能從多達 500 條軌跡、上億 token 的歷史中提取靜態狀態、動態狀態、工作流、環境坑點和 premise awareness。論文報告基於 coding agent 的 AgentRunbook-C 表現強,但延遲成本高。這說明下一代記憶系統可能不只是向量檢索,而是「文件化經驗庫 + 可執行證據收集 agent + 檢索摘要」的混合架構。
MemoryDocDataSet 進一步指出,真實任務往往要求先從對話記憶中找出相關文檔,再在長文檔中做精讀。單獨優化 conversation memory 或 document RAG 都不夠,系統需要聯合檢索和跨源證據鏈。對科研、法律、客服和企業知識庫來說,這可能是非常常見的失敗模式。
方法對比表
| 路線 | 代表工作/系統 | 記憶形態 | 適合場景 | 主要風險 |
|---|---|---|---|---|
| 全量歷史上下文 | 長上下文模型、簡單聊天歸檔 | 原始消息序列 | 小規模、低頻會話、審計回放 | 成本高、干擾強、隱私暴露面大 |
| 向量庫/RAG | 傳統 memory RAG、部分 LangGraph store 實現 | chunk、事實、摘要 | 低成本召回、文檔或會話檢索 | 時間關係弱、衝突處理弱、誤召回 |
| 結構化畫像 | MemoryBank、Memoria、PersonaMem-v2 | 用戶 profile、偏好、屬性 | 個性化助手、CRM、教育陪伴 | 過度推斷、畫像陳舊、用戶代理權不足 |
| 時序/圖記憶 | Zep/Graphiti、Mem0 graph、MemoTime | 實體、關係、時間戳、證據 | 企業上下文、多實體多跳推理 | 圖構建錯誤會長期傳播 |
| Agentic memory | A-MEM、AgeMem、EverMemOS | agent 寫入、鏈接、更新、遺忘 | 長週期任務、研究/代碼/web agent | 自動改寫難審計,訓練和評測複雜 |
| 記憶操作系統 | MemGPT、MemOS、MemoryOS | 層級存儲、MemCube、資源調度 | 平臺級 agent runtime | 抽象宏大,標準和互操作仍未穩定 |
| 本地/隱私優先 | MemX、SuperLocalMemory、MemPrivacy | 本地數據庫、FTS、隱私佔位符 | 桌面 agent、企業內網、敏感行業 | 多端同步、可用性和模型能力受限 |
關鍵技術趨勢
第一,記憶寫入正在從同步工具調用走向異步後臺服務。LangGraph 文檔把寫入分成 hot path 和 background:前者即時可用但增加延遲,後者更易批處理和去重,但可能讓其他線程短期拿不到新記憶。生產系統通常需要兩者結合:顯式用戶指令、偏好修改和安全相關記憶走熱路徑;普通對話摘要、去重和鞏固走後臺任務。
第二,記憶粒度正在從 chunk 走向 evidence-backed fact。長會話中直接存 chunk 容易召回無關上下文;只存抽取事實又容易丟失證據和語氣。較穩妥的設計是同時保存原始 episode、抽取事實、來源 span、時間戳、置信度和更新歷史。回答時返回的是緊湊事實,但審計時能回放原文。
第三,圖和時間成為長期記憶的核心結構。個性化最難的地方往往不是「用戶喜歡咖啡」,而是「用戶過去喜歡咖啡,但最近因為睡眠問題改喝茶」「這個偏好只適用於工作日」「這個結論來自一次玩笑還是明確指令」。沒有時間、實體和關係,很多記憶會在跨月交互中變成誤導。
第四,記憶評測正在多維化。只看 QA accuracy 不夠,還要看拒答、過期事實更新、衝突消解、敏感信息處理、刪除後殘留、延遲、token 成本、寫入噪聲、誤召回率和用戶可控性。記憶系統會有自己的 eval harness,而不是附屬於通用 LLM benchmark。
第五,治理層會成為差異化能力。產品層的記憶開關只是第一步。真正可用的長期記憶需要 memory diff、memory provenance、用戶確認策略、敏感類型策略、租戶隔離、審計日誌、TTL、刪除傳播、導出格式和數據保留策略。
工程落地啟發
如果你今天要給 agent 產品加長期記憶,不建議從「買一個向量庫」開始,而應先定義記憶契約。
第一,定義 memory schema。至少區分事實、偏好、任務狀態、環境經驗、程序性規則和原始事件;每條記憶要有 subject、source、timestamp、confidence、scope、ttl、sensitivity、last_used_at、superseded_by 等字段。沒有 schema 的自然語言記憶很快會失控。
第二,寫入前先設計權限。哪些內容必須用戶顯式同意?哪些內容可以自動保存但必須可見?哪些內容只能在本地保存?哪些內容默認不保存,例如健康、財務、未成年人、身份認證、親密關係和心理狀態?這些策略應在系統層實現,而不是靠 prompt 提醒模型「請謹慎」。
第三,檢索要有 abstention。長期記憶最危險的失敗之一是把錯誤記憶自信地帶入回答。MemX、LongMemEval 等工作都提醒我們,低置信拒絕和「沒有找到相關記憶」同樣重要。工程上可使用混合檢索、RRF、時間過濾、實體過濾、重排序和證據閾值,但必須記錄為什麼召回某條記憶。
第四,給用戶一個 memory inbox。所有新寫入或高敏推斷的記憶都進入可審核列表,用戶可以確認、編輯、降級為短期、設置過期或刪除。對企業場景,還要支持管理員策略和租戶級審計,但不能讓管理員隨意查看個人敏感記憶。
第五,把刪除當成系統功能,而不是 UI 功能。刪除一條記憶後,派生摘要、圖邊、緩存、prompt profile、離線訓練樣本和跨設備副本都要處理。否則「刪除」只是在前端隱藏。
第六,評測要使用你自己的長週期軌跡。公開基準能提供方向,但每個產品的記憶語義都不同。客服要測 ticket continuity,代碼 agent 要測倉庫經驗和構建坑,科研 agent 要測實驗參數演化,個人助理要測偏好更新和隱私控制。
侷限與爭議
第一,很多 2025-2026 年記憶論文仍是 arXiv 預印本,評測數據、實現細節和對照條件需要人工複核。尤其是帶有「SOTA」「大幅降低成本」的聲明,最好在同一模型、同一數據、同一延遲預算下複測。
第二,長期記憶與長上下文模型不是替代關係。長上下文適合一次性讀入大材料,長期記憶適合跨會話、跨任務、跨時間的狀態維護。未來系統大概率同時使用兩者:長上下文做深讀,長期記憶做持續狀態。
第三,個性化和操控之間邊界模糊。當模型長期記住用戶目標、弱點、風格和情緒反應時,推薦、說服和依賴關係都會更強。記憶系統的安全評估不能只看隱私洩露,還要看行為影響。
第四,自動記憶會改變人機關係。一個助手如果主動記住用戶未明確要求保存的內容,短期會更貼心,長期可能讓用戶失去控制感。Algorithmic Self-Portrait 的結果說明,記憶透明度本身就是產品體驗的一部分。
接下來值得關注的問題
- 是否會出現通用 memory schema 或 memory interchange format,讓用戶能在不同 agent 產品之間遷移記憶?
- 記憶寫入是否會從 prompt 規則走向經過訓練的 policy,例如 AgeMem 這類 RL 路線?
- 圖記憶和向量記憶如何結合,才能同時支持事實召回、關係推理、時間推理和低延遲?
- 記憶投毒、跨會話 prompt injection 和惡意偏好寫入會不會成為 agent 安全的新主戰場?
- 刪除權、解釋權和可攜帶權如何在長期記憶系統中實現,而不只是合規文檔中的承諾?
- 本地優先記憶能否在移動端和桌面端形成主流架構,尤其是在個人助理和企業 agent 場景?
總結
Agent Memory 的下一階段不會只是「更大的上下文」或「更好的向量檢索」。真正有價值的長期記憶系統必須同時解決四件事:記得準、用得對、改得動、刪得乾淨。2025-2026 年的研究已經把問題從算法技巧推進到系統架構:記憶有類型、有生命週期、有證據、有權限、有評測,也有風險。對工程團隊而言,最務實的路線是先把記憶當作受治理的數據資產,而不是當作 prompt 的附屬品。只有這樣,個性化 agent 才可能從短期演示走向長期可信協作。
參考資料
檢索日期:2026-07-02。以下優先列出 arXiv、官方文檔和項目文檔;2025-2026 年預印本的實驗結論均建議在引用前再次人工核驗。
- Joon Sung Park et al., Generative Agents: Interactive Simulacra of Human Behavior, arXiv, 2023. https://arxiv.org/abs/2304.03442
- Wanjun Zhong et al., MemoryBank: Enhancing Large Language Models with Long-Term Memory, arXiv, 2023. https://arxiv.org/abs/2305.10250
- Charles Packer et al., MemGPT: Towards LLMs as Operating Systems, arXiv, 2023. https://arxiv.org/abs/2310.08560
- Di Wu et al., LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory, arXiv, 2024. https://arxiv.org/abs/2410.10813
- Preston Rasmussen et al., Zep: A Temporal Knowledge Graph Architecture for Agent Memory, arXiv, 2025. https://arxiv.org/abs/2501.13956
- Wujiang Xu et al., A-MEM: Agentic Memory for LLM Agents, arXiv, 2025. https://arxiv.org/abs/2502.12110
- Prateek Chhikara et al., Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory, arXiv, 2025. https://arxiv.org/abs/2504.19413
- Zhiyu Li et al., MemOS: An Operating System for Memory-Augmented Generation in Large Language Models, arXiv, 2025. https://arxiv.org/abs/2505.22101
- Yu Wang and Xi Chen, MIRIX: Multi-Agent Memory System for LLM-Based Agents, arXiv, 2025. https://arxiv.org/abs/2507.07957
- Bowen Jiang et al., PersonaMem-v2: Towards Personalized Intelligence via Learning Implicit User Personas and Agentic Memory, arXiv, 2025. https://arxiv.org/abs/2512.06688
- Yi Yu et al., Agentic Memory: Learning Unified Long-Term and Short-Term Memory Management for Large Language Model Agents, arXiv, 2026. https://arxiv.org/abs/2601.01885
- Chuanrui Hu et al., EverMemOS: A Self-Organizing Memory Operating System for Structured Long-Horizon Reasoning, arXiv, 2026. https://arxiv.org/abs/2601.02163
- Abhisek Dash et al., The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT, arXiv, 2026. https://arxiv.org/abs/2602.01450
- Lizheng Sun, MemX: A Local-First Long-Term Memory System for AI Assistants, arXiv, 2026. https://arxiv.org/abs/2603.16171
- Di Wu et al., LongMemEval-V2: Evaluating Long-Term Agent Memory Toward Experienced Colleagues, arXiv, 2026. https://arxiv.org/abs/2605.12493
- Qiyang Xie et al., MemoryDocDataSet: A Benchmark for Joint Conversational Memory and Long Document Reasoning, arXiv, 2026. https://arxiv.org/abs/2606.04442
- LangChain Docs, Memory overview, accessed 2026-07-02. https://docs.langchain.com/oss/python/concepts/memory
- Letta Docs, Introduction to Stateful Agents, accessed 2026-07-02. https://docs.letta.com/guides/core-concepts/stateful-agents
- Mem0 Docs, Overview, accessed 2026-07-02. https://docs.mem0.ai/platform/overview
- OpenAI Help Center, Memory FAQ, accessed 2026-07-02. https://help.openai.com/en/articles/8590148-memory-faq