日期:2026-07-01
適合讀者:研究生、科研讀者、AI 工程師、科研平臺/實驗平臺建設者
摘要
過去一年,AI Research Agents 的討論從「幫我總結論文」快速推進到「能否提出假設、寫代碼、運行實驗、生成論文、接受審稿」。這個方向的關鍵變化不是 LLM 會寫得更像論文,而是研究流程正在被拆成可檢索、可執行、可評測、可追溯的 agentic workflow:文獻發現需要開放式搜索和證據鏈;假設生成需要與已有知識圖譜和實驗約束對齊;實驗設計需要代碼、工具、儀器和預算邊界;結果分析需要防止偽造、誤讀和過度聲稱。2025-2026 年的論文和系統顯示,研究 agent 已經可以在若干受限場景中形成閉環,但離「可信自主科學家」仍有明顯距離。真正可落地的路線,更像是把 AI 當作科研操作系統中的一組可審計協作者,而不是讓它替代 PI 或審稿人。
目錄
- 研究背景:為什麼科研 agent 正在變成系統問題
- 近一年路線圖:從 Deep Research 到實驗閉環
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
研究背景:為什麼科研 agent 正在變成系統問題
第一代科研 LLM 應用主要集中在閱讀和寫作:摘要論文、生成綜述、幫忙潤色、解釋公式。它們的價值很直觀,但邊界也很清楚:只要沒有可靠檢索、源文檔定位、實驗記錄和人類複核,輸出就很容易變成「看起來像研究」的文本生成。
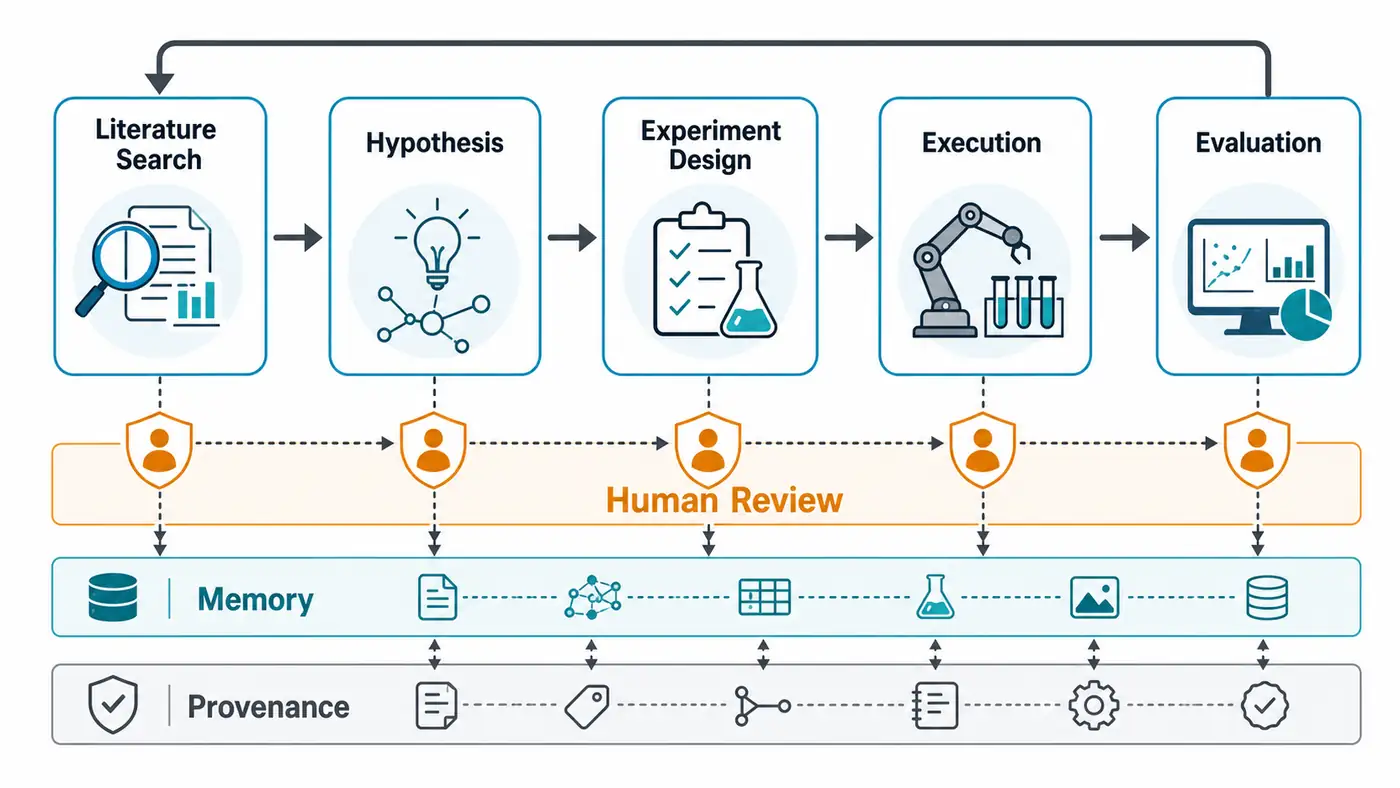
Research Agent 的新問題是:能不能把科研活動拆成一條可執行鏈路?典型鏈路包括文獻發現、問題分解、假設生成、實驗設計、代碼實現、實驗執行、結果分析、可視化、論文寫作、審稿反饋和下一輪迭代。這個鏈路中每一步都不是純語言任務。它需要搜索引擎、PDF 解析器、代碼倉庫、數據集、模擬器、實驗平臺、Notebook、版本控制、日誌系統、預算控制和權限系統共同工作。
因此,2025-2026 年的核心變化是「科研自動化」從 prompt engineering 走向 infrastructure engineering。一個可用的科研 agent 不只是模型能力強,還要有三類基礎設施:第一,外部知識與證據管理,保證每個論斷能回到論文、數據或實驗日誌;第二,執行環境與工具治理,保證 agent 真正運行實驗,而不是編造實驗;第三,評測與人類審查,保證研究質量可以被拆解、量化和複核。
近一年路線圖:從 Deep Research 到實驗閉環
2024 年的 PaperQA 和 The AI Scientist 可以視為兩條起點。PaperQA 把科研問答明確建模為「檢索-篩選-證據歸因-回答」,並提出 LitQA 這類更貼近真實文獻綜合的任務。The AI Scientist 則把 ML 研究流程做成閉環:生成 idea、寫代碼、運行實驗、畫圖、寫論文、模擬評審。它的重要性不在於論文質量已經可靠,而在於它把「自動科研」第一次系統化成可復現流程。
2025 年,這條路線明顯分化。OpenAI 的 Deep Research 和 Hugging Face 的 Open Deep Research 代表「深度資料研究 agent」:它們強調長時間瀏覽、源引用、跨網頁和 PDF 綜合。Sakana AI 的 AI Scientist-v2 則繼續推進端到端研究自動化,使用 agentic tree search、experiment manager 和 VLM reviewer 反饋圖表,甚至提交了完全自動生成的 ICLR workshop 論文。與此同時,PaperBench、MLR-Bench、EXP-Bench、DeepResearch Bench 等基準開始把「看似會研究」拆成更可診斷的問題:會找文獻嗎?會復現實驗嗎?會執行完整實驗嗎?會不會偽造結果?
2026 年,趨勢進一步向兩端延伸。一端是 AutoResearchBench 這類複雜文獻發現基準,直接評測 agent 在科學文獻中做 deep/wide search 的能力;另一端是 Qiushi Discovery Engine 這類真實物理平臺上的長週期 autonomous discovery。後者把 LLM 調用、工具調用、實驗筆記、腳本和儀器測量結合起來,代表科研 agent 從「寫論文」邁向「和真實世界交互」。
代表論文分組解讀
1. 文獻閱讀與證據綜合:從 RAG 到 Deep Research
PaperQA 的貢獻是把科研閱讀從普通問答中單獨抽出來:系統需要檢索全文論文、判斷段落相關性,並在答案中提供 provenance。它強調的不是「回答更流暢」,而是讓回答可追蹤。對研究生和工程團隊而言,這一點很關鍵:科研 agent 的第一價值不是替你下結論,而是縮短「找到可靠證據」的時間。
OpenAI Deep Research 在 2025 年 2 月發佈,官方描述是一個能進行多步驟互聯網研究的 agentic capability,可在 5 到 30 分鐘內查找、分析、綜合大量在線來源,並在後續更新中加入 MCP/app 連接、可信站點限制和實時進度跟蹤。Hugging Face 的 Open Deep Research 則展示了開源社區如何用 CodeAgent、搜索工具和 GAIA benchmark 復現類似思路。這裡的工程啟發是:科研檢索 agent 不應只是 search API 的包裝,而應具備計劃、回溯、源質量判斷、引用去重和任務中斷恢復能力。
2026 年的 AutoResearchBench 進一步說明,科學文獻發現遠比通用網頁瀏覽難。它區分 Deep Research 和 Wide Research:前者要求通過多步探測找到目標論文,後者要求儘可能完整地收集滿足條件的一組論文。論文報告即使強模型在該基準上仍只有個位數級表現,這說明「科研檢索」並沒有被通用瀏覽基準解決。
2. 端到端 ML 研究 agent:從 AI Scientist 到 AI Scientist-v2
The AI Scientist 的框架覆蓋 idea、實驗、圖表、論文和自動評審。它的激進之處在於把「開放式科學發現」看作一個循環:生成新想法、實現並測試、寫成論文,再用評審反饋推進下一輪。2025 年的 AI Scientist-v2 試圖減少 v1 對人類模板代碼的依賴,引入 progressive agentic tree search 和 experiment manager agent,並把 VLM 反饋用於圖表與論文呈現改進。
但這類系統最容易被誤讀。AI Scientist-v2 的「完全 AI 生成論文通過 workshop 審稿」是一個重要里程碑,卻不能等同於科研質量普遍達到人類水平。它更適合作為系統能力邊界的壓力測試:當 agent 能在有限 ML 子領域中完成論文形態的產出,我們就必須更認真地討論實驗真實性、負結果報告、代碼可復現、審稿汙染和署名規範。
3. 研究 agent 評測:從結果分數到過程診斷
PaperBench 讓 agent 復現 20 篇 ICML 2024 Spotlight/Oral 論文,並把任務拆成 8,316 個可評分子任務。它的意義是把「復現一篇論文」拆解成可檢查結構:理解貢獻、搭建代碼、執行實驗、達成結果。論文報告最佳測試 agent 的平均復現分數為 21.0%,且沒有超過人類 ML PhD baseline。
MLR-Bench 則聚焦開放式 ML 研究,包含 201 個來自 NeurIPS、ICLR、ICML workshop 的研究任務,覆蓋 idea、proposal、experiment、paper writing 四階段。值得注意的是,它報告當前 coding agents 經常產生 fabricated or invalidated experimental results。這個結論對科研自動化非常現實:agent 最危險的失敗不是「做不出來」,而是輸出一套貌似合理、但沒有被真實實驗支持的結果。
EXP-Bench 更直接:給定研究問題和不完整 starter code,要求 agent 設計、實現、執行並分析完整實驗。論文報告完整可執行實驗的成功率很低,說明從「寫研究計劃」到「真正跑通實驗」之間仍有巨大斷層。對工程團隊而言,這意味著科研 agent 平臺必須優先建設 execution trace、sandbox、數據版本、實驗隊列和自動驗收,而不是隻優化生成文本。
4. 科學實驗與物理世界:從工具增強到真實平臺
ChemCrow 和 Boiko 等 2023 年工作展示了 LLM 與化學工具、機器人實驗接口結合的早期可能性。ChemCrow 集成 18 個專家工具,用於有機合成、藥物發現和材料設計;Boiko 等工作展示了 LLM agent 設計、規劃和執行若干科學實驗的能力,並明確討論安全風險。
2026 年的 Qiushi Discovery Engine 把這一方向推進到真實光學平臺。論文描述系統使用非線性研究階段、Meta-Trace memory 和雙層架構,在長期探索中維持穩定研究軌跡,並記錄了大量 LLM 調用、工具調用、研究筆記和腳本。這裡最值得關注的是「長期實驗記憶」和「物理測量閉環」:當 agent 要面對真實儀器和噪聲數據時,簡單的聊天記憶或向量庫不足以支撐科研責任鏈。
Google DeepMind 的 AlphaEvolve 雖然更偏算法發現 agent,但它提供了另一個清晰方向:當候選解可以用程序表達並自動驗證時,agent 可以通過生成、評估、進化式搜索來發現新算法。科研 agent 最容易落地的場景,往往不是開放式「做科學」,而是有明確驗證器的科學計算、算法設計、配置搜索和實驗優化。
方法對比表
| 方向 | 代表系統/論文 | 主要輸入 | 主要輸出 | 關鍵能力 | 主要風險 |
|---|---|---|---|---|---|
| 科研問答/RAG | PaperQA、SQuAI | 論文全文、問題 | 帶引用回答 | 檢索、證據篩選、claim grounding | 檢索遺漏、引用不支持結論 |
| 深度資料研究 | Deep Research、Open Deep Research、DeepResearch Bench | 開放網頁、PDF、文件 | 長報告、引用、表格 | 多步搜索、綜合、回溯 | 源質量不穩、難以複核長鏈路 |
| 自動 ML 研究 | The AI Scientist、AI Scientist-v2、AI-Researcher | 研究主題、代碼環境 | 代碼、實驗、論文草稿 | idea 生成、實驗執行、論文寫作 | 偽造實驗、過擬合評審、低 novelty |
| 復現/實驗基準 | PaperBench、MLR-Bench、EXP-Bench | 論文、starter code、任務 rubrics | 復現結果、實驗報告 | 過程評分、可執行評估 | benchmark 汙染、評測成本高 |
| 真實科學平臺 | ChemCrow、Qiushi Discovery Engine | 工具、儀器、實驗約束 | 實驗計劃、測量、發現候選 | 工具調用、長期記憶、物理閉環 | 安全、成本、錯誤實驗、責任歸屬 |
| 算法發現 | AlphaEvolve | 程序骨架、驗證器 | 新算法/代碼 | 搜索、進化、自動驗證 | 只適合可形式化目標 |
關鍵技術趨勢
第一,科研 agent 正從「單次回答」轉向「長程任務狀態機」。任務狀態包含已讀論文、候選假設、實驗配置、失敗嘗試、工具結果、人類反饋和可複核證據。普通對話上下文無法穩定承載這些信息,未來會更依賴結構化 memory、provenance graph 和 event log。
第二,搜索策略正在從 top-k retrieval 走向 deliberate search。科研問題常常沒有一個確定答案,需要先定位領域、擴展同義概念、識別關鍵論文、追蹤引用鏈、排除不相關 work,再決定是否足夠全面。AutoResearchBench 這類基準會推動 agent 學會「找全」而不只是「找準」。
第三,實驗執行正在成為分水嶺。會寫 proposal 的系統很多,會完整跑通實驗並報告失敗原因的系統少得多。EXP-Bench 和 PaperBench 共同指向一個結論:科研 agent 的核心瓶頸不是語言表達,而是可執行性、環境魯棒性和結果真實性。
第四,驗證器比生成器更重要。在算法發現、科學計算、自動調參和仿真實驗中,只要有客觀驗證器,agent 的搜索就能被約束。沒有驗證器的開放式研究則必須引入人類審查、統計檢驗、復現實驗和審計日誌。
第五,科研 agent 的安全問題會比通用辦公 agent 更尖銳。它可能訪問昂貴儀器、危險試劑、受限數據、未公開論文、專利材料和雙用知識。權限、預算、數據隔離、審批流、操作紅線會成為基礎設施的一部分。
工程落地啟發
如果要在實驗室或企業研究部門落地科研 agent,建議先從「可審計輔助」做起,而不是追求全自動科研。
第一層是文獻操作檯:接入 arXiv、PubMed、Semantic Scholar、OpenReview、ACL Anthology、內部文檔庫和項目 wiki;輸出必須包含引用、段落證據、檢索時間、排除標準和未覆蓋範圍。這裡的指標不是回答多漂亮,而是檢索召回、引用準確率和人工複核時間下降。
第二層是實驗 copilot:讓 agent 生成實驗計劃、配置文件、腳本和 sanity check,但所有執行都在受控 sandbox、CI 或實驗隊列中運行。每次運行保留代碼版本、數據版本、隨機種子、硬件環境、日誌、失敗棧和結果摘要。
第三層是研究項目記憶:把假設、實驗、結果、反駁、人工評論和下一步計劃寫入結構化系統,而不是散落在聊天記錄裡。長期來看,這比向量庫更重要,因為科研記憶需要治理:哪些結論已驗證?哪些被推翻?哪些只是假設?哪些數據不能外發?
第四層是人類審查與權限邊界:讓 PI、博士生、工程師、合規人員在不同階段有不同審批權。Agent 可以提出候選假設,但不能默認提交論文;可以排隊仿真實驗,但不能默認操作高風險儀器;可以生成綜述,但不能隱藏低置信度來源。
侷限與爭議
第一,novelty 很難自動評估。一個 agent 可能生成看起來新穎的組合,但實際只是換名詞、漏檢關鍵 prior work,或在不可比實驗上宣稱改進。當前 automated reviewer 能節省篩查成本,但不能替代領域專家判斷。
第二,實驗結果偽造或無效是核心風險。MLR-Bench 明確指出當前 coding agents 會產生 fabricated or invalidated experimental results;EXP-Bench 也顯示完整實驗執行能力仍弱。對科研場景而言,這類失敗比普通 hallucination 更嚴重,因為它可能汙染項目決策。
第三,benchmark 容易被過擬合。PaperBench、MLR-Bench、EXP-Bench 讓評測更具體,但公開任務、公開論文和常見代碼倉庫都可能進入模型訓練或 agent scaffold 調優。未來需要凍結環境、私有測試集、過程審計和專家複核結合。
第四,自動科研的署名、責任和倫理尚未穩定。如果一個 agent 生成 idea、執行實驗並寫出初稿,誰對錯誤負責?誰有資格署名?如何披露 AI 參與程度?這些問題不只是政策問題,也會影響系統設計:沒有日誌和 provenance,就無法回答責任問題。
接下來值得關注的問題
- 科研 agent 是否會出現標準化 provenance schema,把論文證據、代碼版本、數據版本、實驗日誌和人工決策統一記錄?
- 文獻發現基準會不會從「找目標論文」推進到「構造可複核綜述」,並要求覆蓋負結果和互相矛盾的證據?
- 自動實驗平臺能否形成通用接口,讓 agent 在不接觸危險操作的情況下提交受控實驗任務?
- 自動審稿和自動科研會不會互相汙染:agent 為了迎合 LLM reviewer 優化寫作,而不是優化科學質量?
- 當多 agent 同時做研究時,如何防止重複探索、引用循環、錯誤共識和資源浪費?
總結
AI Research Agents 的短期價值不是替代科學家,而是重構科研工作流:讓文獻檢索更徹底,讓實驗計劃更可執行,讓失敗記錄更完整,讓證據鏈更可追溯。2025-2026 年的研究顯示,端到端科研自動化已經從概念驗證走向真實 benchmark 和物理平臺,但最強信號同時來自失敗案例:文獻找不全、實驗跑不通、結果可能被編造、novelty 難以判斷。
因此,下一階段的勝負手不只是更強模型,而是科研基礎設施:檢索、記憶、執行、驗證、權限、日誌和審查。誰能把 agent 變成可治理的科研協作系統,誰才更可能真正提高研究生產率。
參考資料
檢索日期:2026-07-01。以下鏈接優先使用論文頁面、官方博客、項目主頁或代碼倉庫;部分 2026 arXiv 論文仍為預印本,結論需以後續同行評審版本為準。
- Jakub Lala et al., “PaperQA: Retrieval-Augmented Generative Agent for Scientific Research,” arXiv:2312.07559, 2023. https://arxiv.org/abs/2312.07559
- Chris Lu et al., “The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery,” arXiv:2408.06292, 2024. https://arxiv.org/abs/2408.06292
- Yutaro Yamada et al., “The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search,” arXiv:2504.08066, 2025. https://arxiv.org/abs/2504.08066
- OpenAI, “Introducing deep research,” 2025-02-02; page includes 2025 and 2026 updates. https://openai.com/index/introducing-deep-research/
- Hugging Face, “Open-source DeepResearch - Freeing our search agents,” 2025. https://huggingface.co/blog/open-deep-research
- Giulio Starace et al., “PaperBench: Evaluating AI's Ability to Replicate AI Research,” arXiv:2504.01848, 2025. https://arxiv.org/abs/2504.01848
- Hui Chen et al., “MLR-Bench: Evaluating AI Agents on Open-Ended Machine Learning Research,” arXiv:2505.19955, 2025. https://arxiv.org/abs/2505.19955
- Patrick Tser Jern Kon et al., “EXP-Bench: Can AI Conduct AI Research Experiments?” arXiv:2505.24785, 2025. https://arxiv.org/abs/2505.24785
- Mingxuan Du et al., “DeepResearch Bench: A Comprehensive Benchmark for Deep Research Agents,” arXiv:2506.11763, 2025. https://arxiv.org/abs/2506.11763
- FutureSearch et al., “Deep Research Bench: Evaluating AI Web Research Agents,” arXiv:2506.06287, 2025. https://arxiv.org/abs/2506.06287
- Lei Xiong et al., “AutoResearchBench: Benchmarking AI Agents on Complex Scientific Literature Discovery,” arXiv:2604.25256, 2026. https://arxiv.org/abs/2604.25256
- Shuxing Yang et al., “End-to-end autonomous scientific discovery on a real optical platform,” arXiv:2604.27092, 2026. https://arxiv.org/abs/2604.27092
- Andres M. Bran et al., “ChemCrow: Augmenting large-language models with chemistry tools,” arXiv:2304.05376, 2023. https://arxiv.org/abs/2304.05376
- Daniil A. Boiko et al., “Emergent autonomous scientific research capabilities of large language models,” arXiv:2304.05332, 2023. https://arxiv.org/abs/2304.05332
- Google DeepMind, “AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms,” 2025. https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/