日期:2026-06-28
適合讀者:研究生、Agent/多模態方向研究者、做自動化產品或機器人系統的工程讀者
檢索日期:2026-06-28
摘要
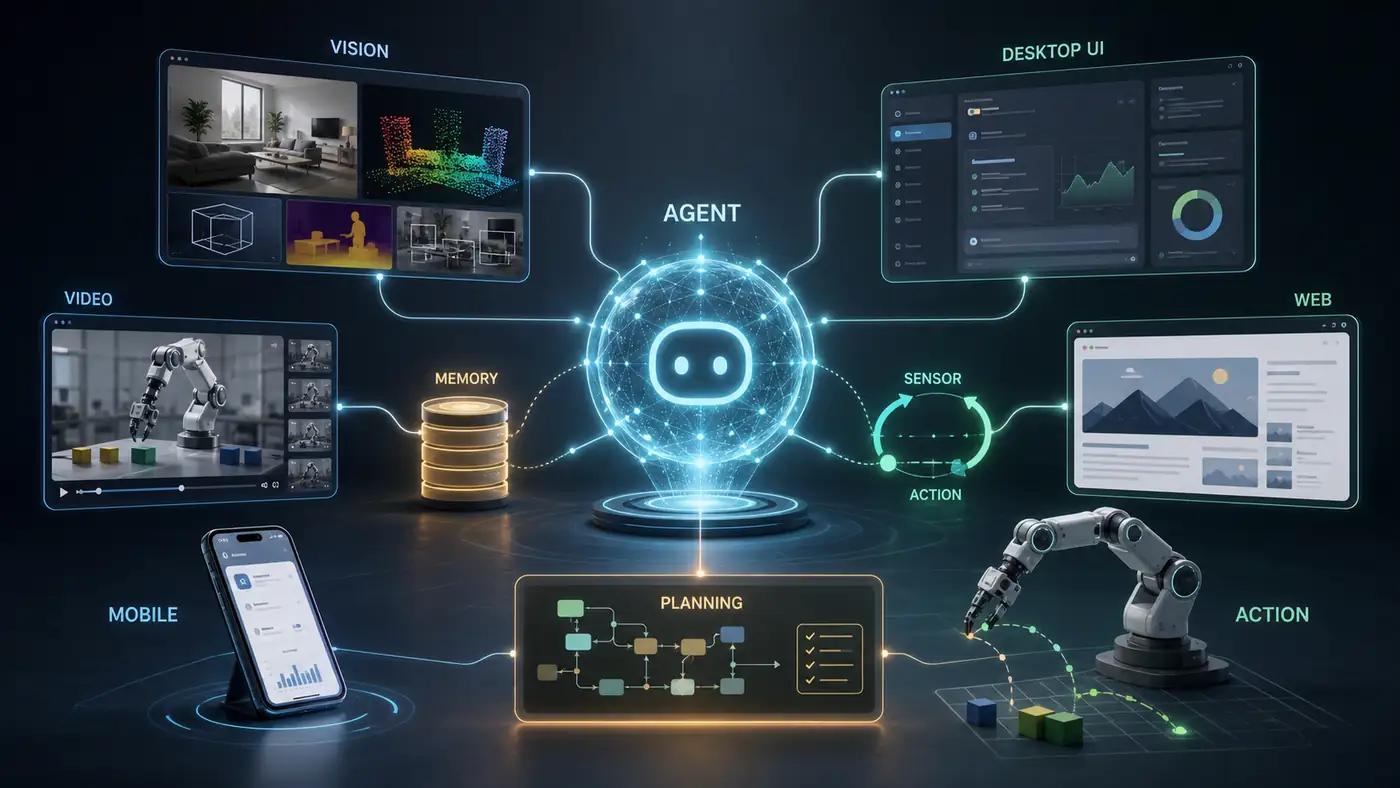
過去兩年,Multimodal Agent 從“把截圖交給 VLM,再讓 LLM 決定點擊哪裡”快速推進到“跨平臺 GUI action model、computer-use skill base、以及能連接數字界面和物理控制的 VLA”。2024 年的 OSWorld、WebVoyager、AndroidWorld 把問題定義清楚:真實環境會變化,任務常跨應用,評價必須看最終狀態。2025-2026 年的 UI-TARS、Magma、CUA-Skill、WindowsWorld、MacArena、OmniGUI、MacAgentBench 則把重點轉向可訓練動作模型、技能複用、多模態事件流和更真實的 benchmark。
本文按技術路線梳理近一年代表論文,並提煉工程啟發:Multimodal Agent 的難點已經不只是“看不懂”,而是動作空間、長期狀態、錯誤恢復、權限邊界、環境復現和可審計執行共同構成的系統問題。
目錄
- 研究背景
- 近一年路線圖
- 代表論文分組解讀
- 方法對比表
- 技術趨勢與工程啟發
- 侷限與爭議
- 總結
- 參考資料
研究背景
傳統 LLM Agent 常把環境抽象成文本 API、HTML DOM 或函數調用 schema。這適合研究規劃與工具調用,但離真實使用還有距離:用戶面對的是屏幕、彈窗、窗口切換、文件系統、通知、權限確認、視頻、語音和偶發錯誤。Multimodal Agent 的核心變化,是讓模型直接或間接處理視覺觀察,並輸出能改變環境狀態的動作。
可以把這個方向分成兩個逐漸靠近的世界。數字世界包括 Web、手機、桌面 OS、辦公軟件和開發工具,輸入是截圖、OCR、accessibility tree、HTML、視頻幀或操作歷史,動作是點擊、輸入、滾動、快捷鍵和文件操作。物理世界包括機器人和 embodied AI,輸入是相機、傳感器與語言指令,動作是離散技能或連續控制。二者的共同問題是:模型必須把多模態感知、任務記憶、動作選擇和環境反饋接成閉環。
基礎論文仍然重要。Mind2Web 推動 Web generalist agent 的數據與評測;SeeClick 強調 GUI grounding 是視覺 GUI agent 的關鍵瓶頸;WebVoyager 用真實網站檢驗端到端視覺 Web agent;OSWorld 將“真實電腦環境中的開放任務”做成可復現 benchmark。它們共同把問題從“生成腳本”推進到“在狀態會變化的 GUI 環境裡可靠完成任務”。
近一年路線圖
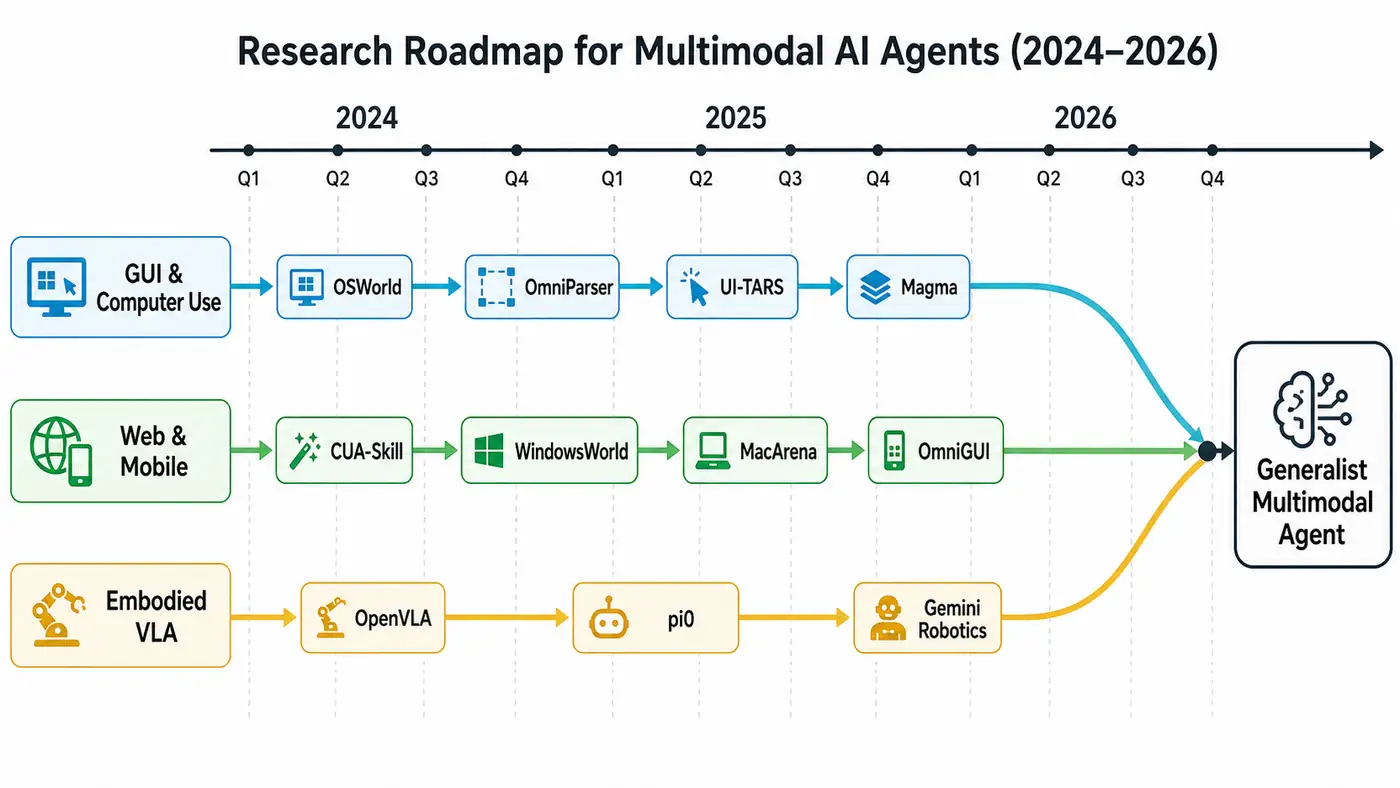
近一年路線可以概括為四條主線。
第一,GUI agent 從 prompt workflow 轉向專門訓練的 action model。OS-ATLAS、ShowUI、Aguvis、UI-TARS 都在嘗試跨桌面、Web、移動端的統一視覺 grounding 與動作建模。UI-TARS 把 GUI screenshot、大規模 action traces、統一動作空間、系統二式推理和在線反思放進 native GUI agent 框架,代表了“模型本身學會操作界面”的路線。
第二,screen parsing 成為實用中間層。OmniParser 將可交互區域檢測和語義描述拆出來,幫助上層 VLM/Agent 更穩定地把意圖落到座標。對工程團隊來說,可解釋的視覺前端通常比完全黑盒端到端 agent 更容易調試、審計和降級。
第三,benchmark 從靜態截圖走向跨應用、長流程和多模態事件。WindowsWorld 強調專業跨應用流程;MacArena 和 MacAgentBench 說明 macOS 不是普通桌面 GUI 的簡單變體;OmniGUI 把手機環境從靜態截圖推進到圖像、音頻、視頻交織的 step-level 評測。
第四,具身 VLA 把“動作”從點擊座標擴展到連續控制。OpenVLA 推動開放 VLA 研究,π0 用 flow matching 建模連續動作,Magma 嘗試把 UI navigation 與 robot manipulation 放進同一個多模態 agent 基座,Gemini Robotics 則代表大模型廠商向物理行動擴展。
代表論文分組解讀
Web 與桌面:從真實網頁到真實操作系統
WebVoyager 的價值在於選擇真實網站,而不是隻在簡化網頁環境裡跑任務。OSWorld 進一步覆蓋真實電腦任務,包含文件 I/O、多應用流程和執行式檢查。論文報告人類完成率顯著高於當時最強模型,說明 GUI grounding、操作知識和長程恢復仍是核心短板。
2026 年的 WindowsWorld 把難點推到職業場景:任務通常包含多個子目標,且多數需要跨應用完成。MacArena 與 MacAgentBench 則提醒研究者不要把一個系統上的結果外推到所有桌面環境。macOS 的菜單、窗口、權限、快捷鍵和應用生態都有獨特約束,模型排序也可能隨任務子集改變。
手機代理:從單 App 導航到多模態事件流
Mobile-Agent 儘量不依賴 XML 或系統元數據,而用視覺感知識別控件;Mobile-Agent-v2 引入 planning、decision、reflection 多代理結構處理任務進度與錯誤恢復。AndroidWorld 提供動態 Android 任務和程序化 reward,GUI Odyssey 則強調跨 App navigation。
OmniGUI 的新意是 omni-modal smartphone environments:每個 action step 不只給靜態圖片,還可能有音頻和視頻片段。這很貼近現實手機使用,因為很多狀態來自短暫 toast、播放器變化、通知聲音或動態畫面。只把截圖交給模型,會天然丟掉這些信息。
GUI action model:從“點哪裡”到“怎麼連續做”
SeeClick 和 ScreenSpot 類評測說明,GUI agent 的第一道門檻是 grounding。OS-ATLAS 通過跨平臺 GUI grounding 語料和 foundation action model 提升開源模型泛化;ShowUI 用 UI-guided visual token selection 減少冗餘視覺 token;Aguvis 強調 pure vision、自主 GUI interaction 與開放訓練 recipes。
UI-TARS 更接近完整 native GUI agent:它用大量 GUI action trace 學習截圖到動作的映射,並通過反思式軌跡增強連續決策。需要注意,論文 benchmark 數字會受模型版本、工具棧、step limit 與 UI 更新影響,本文不把單次 leaderboard 結果視為長期 SOTA 結論。
技能庫與具身 VLA
CUA-Skill 提出 skill + execution graph:模型不必每次從截圖重新發明 Office、瀏覽器或系統設置的操作流程,而是檢索並參數化可複用技能。這對工程落地很關鍵,因為企業自動化更需要穩定、可審計、可回滾的動作宏和 RPA fallback,而不是完全自由的即興操作。
具身方向則把 action 從離散 UI 操作擴展到機器人控制。RT-2 是經典基礎:把機器人動作表示成 token,讓 VLM 共享語言和動作生成範式。OpenVLA 降低復現門檻;π0 用 flow matching 輸出連續動作;Magma 結合 Set-of-Mark 與 Trace-of-Mark 覆蓋 UI、視頻和機器人任務;Gemini Robotics 顯示通用多模態模型正在進入物理行動場景。
方法對比表
| 路線 | 代表工作 | 主要輸入 | 主要動作 | 工程啟發 |
|---|---|---|---|---|
| Web/桌面 agent | WebVoyager, OSWorld, WindowsWorld, MacArena | 截圖、網頁、OS 狀態、歷史軌跡 | 點擊、輸入、快捷鍵、文件操作 | 必須做 sandbox、狀態重置和執行式驗收 |
| 手機 agent | Mobile-Agent, AndroidWorld, GUI Odyssey, OmniGUI | 截圖、OCR、音頻/視頻、操作歷史 | 點擊、滑動、輸入、App 切換 | 靜態截圖不足,需要事件流與設備狀態 |
| GUI action model | SeeClick, OS-ATLAS, ShowUI, Aguvis, UI-TARS | UI screenshot、元素語義、動作軌跡 | 座標、控件選擇、動作 token | 數據質量與統一動作空間比 prompt 更關鍵 |
| Screen parsing | OmniParser | 截圖、圖標、文本、可交互區域 | 結構化 UI 元素 | 適合與閉源/開源 VLM 混合部署 |
| 技能庫 | CUA-Skill | GUI 狀態、任務、技能上下文 | 參數化技能、執行圖 | 把模型輸出限制在可審計邊界內 |
| 具身 VLA | RT-2, OpenVLA, π0, Magma | 圖像/視頻、語言、機器人狀態 | 離散或連續機器人動作 | 真實安全、延遲和數據閉環比 demo 更難 |
技術趨勢與工程啟發
第一,動作空間正在統一。GUI agent 需要把點擊、拖拽、輸入、快捷鍵、App 切換抽象成跨平臺動作;VLA 需要把末端執行器、關節軌跡或高層技能抽象成可學習輸出。統一動作空間決定數據能否混合訓練,錯誤能否復現,策略能否遷移。
第二,視覺前端正在模塊化。屏幕不是普通自然圖片,UI 有層級、邊界、可點擊區域和操作語義。OmniParser、ShowUI、SeeClick、OS-ATLAS 都說明,把這些 inductive bias 寫進數據和模型,通常比堆更長 prompt 更有效。
第三,評測正在交互化。OSWorld、AndroidWorld、WindowsWorld、MacArena、OmniGUI 都要求 agent 改變環境狀態,並用最終狀態或程序化規則檢查結果。這會迫使系統處理加載延遲、錯誤點擊、權限彈窗、任務重試和中間失敗。
第四,技能、記憶和反思會成為必要系統層。長任務失敗常不是第一步看錯,而是後續忘記目標、狀態不同步或恢復策略錯誤。工程上推薦“視覺解析層 + 規劃模型 + 技能執行層 + 審計日誌”的分層架構:模型可以提出計劃,關鍵動作應走受控技能,並對付款、發信、刪文件、改權限等操作設置人工確認。
第五,數據閉環比框架選擇更重要。GUI grounding 數據、真實操作軌跡、失敗軌跡、跨應用流程、音視頻事件和機器人 demonstrations 都是稀缺資產。團隊若有真實場景,應優先建設任務集、回放環境、失敗樣本庫和驗收腳本,而不是頻繁更換 agent 框架。
侷限與爭議
首先,benchmark 仍然碎片化。不同平臺、應用生態、任務分佈和工具接口會改變模型表現,一個 leaderboard 領先不能證明通用電腦使用能力。
其次,很多結果依賴閉源模型版本、step limit、工具棧和 UI 狀態。模型名稱、API 版本、網頁佈局、系統權限和應用更新都會影響復現。本文只保留來源中明確可查的信息;上線選型仍應重新跑本地任務集。
第三,安全問題會比文本 Agent 更棘手。GUI agent 不只會“說錯”,還會“點錯”。網頁、郵件、圖片、文檔、通知和彈窗都可能成為間接注入或界面誤導來源,因此權限、確認、日誌和回滾必須前置設計。
第四,具身 VLA 的 demo 與生產機器人之間仍有距離。連續控制需要低延遲、物理安全、傳感器可靠性和異常停止機制。跨 embodiment 泛化很重要,但在真實工廠、家庭和醫療場景中仍需嚴格驗證。
總結
Multimodal Agent 的最新方法正在形成清晰圖景:模型要看懂屏幕和世界,也要把意圖轉成可執行動作;系統要能評測、回滾、審計和恢復;數據要覆蓋真實軌跡、失敗案例和跨平臺差異。短期最可靠的落地方式不是完全自主代理,而是受限任務、強環境控制、可複用技能庫和人工確認。長期看,GUI action model 與具身 VLA 可能會合流,形成能在數字界面和物理空間中共享感知、記憶、規劃和行動能力的通用多模態代理。
參考資料
檢索日期:2026-06-28。優先使用 arXiv、項目主頁、官方博客或官方文檔;benchmark 數字和模型發佈時間以鏈接頁面為準。
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. arXiv, 2024-04-11. https://arxiv.org/abs/2404.07972
- WebVoyager: Building an End-to-End Web Agent with Large Multimodal Models. arXiv, 2024-01-25. https://arxiv.org/abs/2401.13919
- SeeClick: Harnessing GUI Grounding for Advanced Visual GUI Agents. arXiv, 2024-01-17. https://arxiv.org/abs/2401.10935
- Mind2Web: Towards a Generalist Agent for the Web. arXiv, 2023-06-09. https://arxiv.org/abs/2306.06070
- AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents. arXiv, 2024-05-23. https://arxiv.org/abs/2405.14573
- Mobile-Agent: Autonomous Multi-Modal Mobile Device Agent with Visual Perception. arXiv, 2024-01-29. https://arxiv.org/abs/2401.16158
- Mobile-Agent-v2: Mobile Device Operation Assistant with Effective Navigation via Multi-Agent Collaboration. arXiv, 2024-06-03. https://arxiv.org/abs/2406.01014
- GUI Odyssey: A Comprehensive Dataset for Cross-App GUI Navigation on Mobile Devices. arXiv, 2024-06-12. https://arxiv.org/abs/2406.08451
- OmniParser for Pure Vision Based GUI Agent. arXiv, 2024-08-01. https://arxiv.org/abs/2408.00203
- OS-ATLAS: A Foundation Action Model for Generalist GUI Agents. arXiv, 2024-10-30. https://arxiv.org/abs/2410.23218
- ShowUI: One Vision-Language-Action Model for GUI Visual Agent. arXiv, 2024-11-26. https://arxiv.org/abs/2411.17465
- Aguvis: Unified Pure Vision Agents for Autonomous GUI Interaction. arXiv, 2024-12-05. https://arxiv.org/abs/2412.04454
- UI-TARS: Pioneering Automated GUI Interaction with Native Agents. arXiv, 2025-01-21. https://arxiv.org/abs/2501.12326
- Magma: A Foundation Model for Multimodal AI Agents. arXiv, 2025-02-18. https://arxiv.org/abs/2502.13130
- CUA-Skill: Develop Skills for Computer Using Agent. arXiv, 2026-01-28. https://arxiv.org/abs/2601.21123
- WindowsWorld: A Process-Centric Benchmark of Autonomous GUI Agents in Professional Cross-Application Environments. arXiv, 2026-04-30. https://arxiv.org/abs/2604.27776
- OmniGUI: Benchmarking GUI Agents in Omni-Modal Smartphone Environments. arXiv, 2026. https://arxiv.org/abs/2605.18758
- MacArena: Benchmarking Computer Use Agents on an Online macOS Environment. arXiv, 2026-06-04. https://arxiv.org/abs/2606.06560
- MacAgentBench: Benchmarking AI Agents on Real-World macOS Desktop. arXiv, 2026-06-21. https://arxiv.org/abs/2606.22557
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv, 2023-07-28. https://arxiv.org/abs/2307.15818
- OpenVLA: An Open-Source Vision-Language-Action Model. arXiv, 2024-06-13. https://arxiv.org/abs/2406.09246
- π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv, 2024-10-31. https://arxiv.org/abs/2410.24164
- VLANeXt: Recipes for Building Strong VLA Models. arXiv, 2026-02-20. https://arxiv.org/abs/2602.18532
- OpenAI Operator research preview. OpenAI, 2025-01-23. https://openai.com/index/introducing-operator/
- Anthropic Computer Use announcement. Anthropic, 2024-10-22. https://www.anthropic.com/news/3-5-models-and-computer-use
- Gemini Robotics brings AI into the physical world. Google DeepMind, 2025-03-12. https://deepmind.google/discover/blog/gemini-robotics-brings-ai-into-the-physical-world/