- 日期:2026-06-27
- 適合讀者:研究生、NLP/LLM 研究者、負責模型評測與應用質量保障的工程團隊
- 檢索日期:2026-06-27
摘要
LLM-as-a-Judge 已經從“用 GPT-4 幫忙打分”的工程技巧,演化為開放式任務評測、偏好數據生產、產品迴歸測試和安全驗收裡的核心基礎設施。它的吸引力很直接:比人工評審便宜、比 BLEU/ROUGE 之類表面指標更能理解語義,還能輸出理由、錯誤類型和結構化 verdict。但 2025-2026 年的研究也把一個問題推到臺前:一個 judge 本身是否可靠,不能只看它與人類偏好的平均相關性。位置偏置、長度偏置、rubric 選項順序、跨語言退化、校準漂移、領域錯配、模型自偏好,都會讓排行榜和產品驗收出現“看起來有置信度、實際方向錯了”的風險。
本文按研究脈絡梳理 LLM-as-a-Judge 的基礎範式、近一年可靠性研究、代表論文分組、方法對比和工程落地啟發。核心結論是:未來的 judge 系統會越來越像一套可審計的測量儀器,而不是一個單獨 prompt。可靠性來自任務契約、rubric 設計、順序置換、校準集、統計推斷、judge ensemble、人類抽檢和持續漂移監控的組合。
目錄
- 研究背景:為什麼需要 LLM 裁判
- 近一年路線圖:從“相關性”到“可靠測量”
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
研究背景:為什麼需要 LLM 裁判
傳統 NLG 評測長期依賴 BLEU、ROUGE、METEOR、BERTScore 等指標。它們適合有參考答案、形式穩定的任務,但面對開放式問答、多輪對話、指令遵循、RAG 回覆質量、安全合規、代碼解釋或 agent 軌跡時,經常無法表達“這個回答是否真的滿足用戶意圖”。人工評審能覆蓋這些維度,卻存在成本高、週期長、標註一致性有限、難以持續迴歸的問題。
G-Eval 是早期代表:用 GPT-4 按任務 rubric 和自然語言標準為摘要、對話等輸出打分,強調與人類評分的相關性。隨後 Zheng 等人的 MT-Bench 與 Chatbot Arena 論文系統討論了用 LLM 做 pairwise judge 的可行性,也明確指出 position bias、verbosity bias、self-enhancement bias 等風險。AlpacaEval、Arena-Hard-Auto 等基準進一步把 LLM judge 變成主流排行榜組件;Prometheus 2、JudgeLM 等工作則探索開源或專門訓練的 judge 模型。
這條路線的根本變化在於:judge 不再只是“評測工具”,它會反過來塑造模型研發目標。團隊會根據 judge 分數決定是否上線模型、選擇 RAG reranker、優化 prompt、調參、甚至訓練 reward model。因此,judge 的錯誤不是普通噪聲,而可能成為優化目標本身,觸發 Goodhart 效應。
近一年路線圖:從“相關性”到“可靠測量”
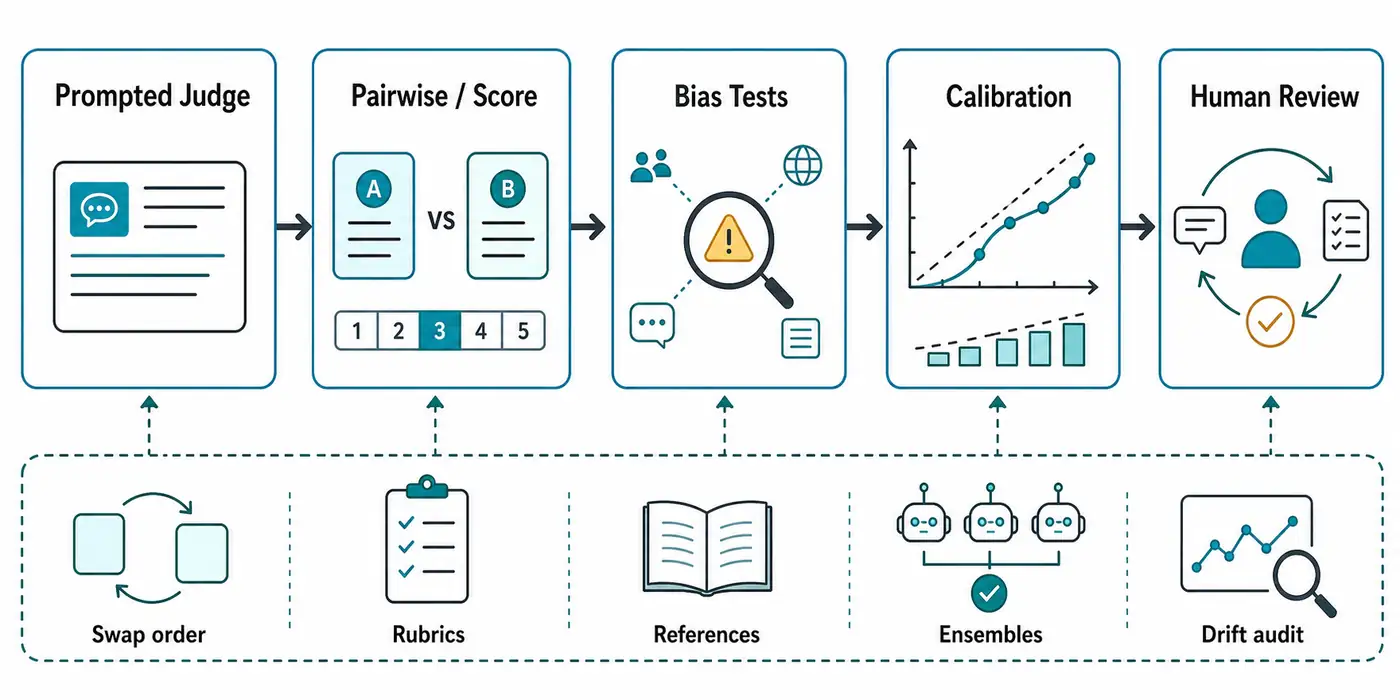
2025-2026 年的論文大致沿五條路線推進:
第一,從“人類一致性”轉向“客觀可判別樣本”。JudgeBench 把 judge 評測從泛泛的人類偏好轉向知識、推理、數學和代碼中的 challenging response pairs,強調當人類偏好本身不能穩定代表事實正確性時,需要構造客觀標籤。Arena-Hard-Auto 也把 crowdsourced 數據轉為更難、更能區分模型的自動評測集。
第二,從 prompt 技巧轉向設計選擇審計。Yamauchi 等人在 2025 年用 BIGGENBench 與 EvalBiasBench 研究評價標準、解碼策略和 CoT 對可靠性的影響,結論很工程化:清晰評價標準比“讓 judge 多推理”更重要;非確定性採樣有時能改善與人類偏好的對齊,但也帶來復現成本。
第三,從單次打分轉向偏置測量。OffsetBias/EvalBiasBench 歸納多類 judge 偏置並構造去偏數據;2026 年的 BabelJudge 進一步把位置偏置、長度偏置、順序不一致和跨語言退化放在同一審計框架裡,還擴展到 agent trajectory 擾動。
第四,從平均分轉向統計保證。Noisy but Valid 研究“不完美 judge”條件下如何做安全閾值認證,通過少量人工校準集估計 judge 的 TPR/FPR,再修正大規模 judge 標籤上的統計檢驗。Bias and Uncertainty in LLM-as-a-Judge Estimation 則討論原始 judge 輸出和共享校準在模型比較中可能造成系統偏差,提醒報告 judge 質量與跨模型校準穩定性。
第五,從通用評價轉向領域契約。2026 年可見多篇面向軟件測試覆蓋、人機協作編程、可持續旅行推薦等垂直場景的 rubric-driven judge。共同特徵是把“好答案”拆成可執行的評價契約:每個維度怎麼判、輸出 schema 怎麼驗證、失敗時怎麼重試、何時需要專家複核。
代表論文分組解讀
1. 基礎範式:prompt judge、pairwise judge 與專用 judge
G-Eval 證明了強 LLM 按自然語言 criteria 評分可以顯著優於傳統表面指標,但它的評估重點仍是相關性。MT-Bench/Chatbot Arena 進一步讓 pairwise preference 成為主流:給同一問題的兩個回答,讓 judge 選擇更好者,再彙總 win rate 或 Elo。pairwise 的好處是比絕對分數更穩定,壞處是位置、長度、風格和候選分佈會影響結果。
專用 judge 模型試圖降低成本和提高可控性。Prometheus 2 訓練開源 evaluator,在給定 rubric 和 reference 的條件下輸出評分和反饋;JudgeLM 把“可擴展裁判”作為微調目標。這類模型更容易本地部署和審計,但通常需要持續跟隨被評模型能力升級,否則會出現“弱裁判評強模型”的瓶頸。
2. 元評測:先評 judge,再用 judge 評模型
JudgeBench 的重要性在於它把 judge 本身當作被測對象。過去常見做法是問“judge 與人類偏好相關嗎”,但對數學、代碼、事實推理來說,人類偏好可能被流暢表達誤導。JudgeBench 通過構造具有客觀正確性的回答對,檢查 judge 能否識別真正更正確的輸出。論文報告稱許多強模型在該基準上仍顯困難,這說明“強聊天模型”不自動等於“強裁判”。
LLMs-as-Judges 的綜述和 A Survey on LLM-as-a-Judge 則把問題系統化:功能層面包括打分、排序、反饋、錯誤分類;方法層面包括 prompt、微調、reference-guided、ensemble;應用層面覆蓋 NLG、信息檢索、教育、代碼、醫療、多模態;元評測層面則關注一致性、魯棒性、公平性和可解釋性。
3. 偏置與魯棒性:位置、長度、rubric 和語言都要測
早期 MT-Bench 已經提示 position bias 和 verbosity bias。後續研究發現問題更細:rubric-based judge 看似 pointwise,實際上可能像多選題一樣受分數選項順序影響。2026 年 Am I More Pointwise or Pairwise? 顯示,對 rubric 分數選項做 balanced permutation 並聚合,可以揭示並緩解這種隱藏位置偏置。
OffsetBias/EvalBiasBench 把偏置類型做成元評測集合,並嘗試用去偏偏好數據微調 evaluator。BabelJudge 則把跨語言可靠性加入討論:低資源語言、順序交換和 agent 軌跡擾動會讓原本看似穩定的 judge 退化。工程上這意味著,中文、英文和低資源語言不能默認共享同一套 judge 可靠性結論;agent 軌跡評測也不能只看最終答案。
4. 校準與統計:把 judge 當噪聲測量儀
當 judge 分數被用於上線門檻或安全認證時,“平均準確”不足夠。Noisy but Valid 的思路是承認 judge 有誤差,用少量人工標註估計錯誤率,再把這個誤差納入假設檢驗。它更接近統計質量控制,而不是模型排行榜。
Bias and Uncertainty in LLM-as-a-Judge Estimation 進一步指出,原始 judge 輸出是有偏估計;即使用校準修正,如果把同一個校準參數共享到不同被評模型,跨模型校準不穩定可能讓比較方向反轉。對產品團隊來說,這比單純“judge agreement = 0.8”更關鍵:上線決策關心的是兩個版本誰更好,而不是 judge 在歷史集合上的平均表現。
5. 垂直場景:rubric-driven evaluation contract
2026 年多篇場景論文都在把 judge 系統工程化。軟件測試覆蓋評估論文把 Gherkin acceptance tests 作為對象,關注準確率、first-attempt completion、重試成本和 JSON 結構化輸出。人機協作編程論文引入 schema-constrained judge、validation/repair、分組切分防洩漏、Brier score、ECE、Cohen/Fleiss agreement 等指標。可持續旅行推薦論文用人類專家校準多維度 judge,發現總排名一致不代表各維度解釋一致。
這些工作說明:可靠 judge 不是一條萬能 prompt,而是一套和任務綁定的評估契約。契約越清楚,後續才越能做校準、抽檢、漂移監控和責任追蹤。
方法對比表
| 方法路線 | 代表工作 | 優點 | 主要風險 | 工程建議 |
|---|---|---|---|---|
| Prompted pointwise scoring | G-Eval、領域 rubric judge | 快速、靈活、能輸出理由 | 分數尺度漂移、rubric 順序偏置、prompt 敏感 | 固定 schema,記錄 prompt 版本,對 rubric 做置換測試 |
| Pairwise preference | MT-Bench、Chatbot Arena、AlpacaEval | 比絕對分數穩定,適合開放式回答 | 位置偏置、長度偏置、候選分佈依賴 | A/B 順序交換,報告 length-controlled 指標 |
| 專用 judge 模型 | Prometheus 2、JudgeLM | 成本低、可本地化、便於復現 | 能力滯後、訓練數據偏差 | 用新任務人工集定期校準,不盲目替代 frontier judge |
| Judge meta-benchmark | JudgeBench、EvalBiasBench、BabelJudge | 直接測試 judge 能力和偏置 | benchmark 仍可能被優化或失效 | 把元評測納入 CI,而不是隻跑一次 |
| 統計校準 | Noisy but Valid、Bias and Uncertainty | 可給上線閾值和置信區間 | 需要人工校準集,假設不滿足會失真 | 每個關鍵任務保留小而新的人工金標集 |
| Ensemble / jury | 多 judge 投票、frontier+compact jury | 降低單模型偏置和偶然錯誤 | 成本上升,judge 間相關錯誤仍存在 | 混合不同模型家族,報告 dissent rate |
關鍵技術趨勢
第一,judge prompt 會被“評估契約”取代。一個成熟評測不只包含 criteria,還應包含輸入字段、rubric 定義、參考答案使用方式、輸出 JSON schema、無效輸出修復策略、tie/abstain 規則、聚合公式和版本號。
第二,可靠性指標會從單一 agreement 擴展為一組儀表盤。至少應包括人類一致性、順序交換一致性、長度敏感性、rubric permutation 穩定性、跨語言/跨領域表現、校準誤差、inter-judge agreement、無效輸出率、成本和延遲。
第三,judge 會更強調“可拒判”。當問題超出 judge 能力、reference 不足、候選都不合格或證據衝突時,強迫輸出 A/B 勝者會製造虛假確定性。abstain、needs human review、insufficient evidence 這類結果應成為一等公民。
第四,judge 與訓練閉環之間的邊界會更受關注。如果同一個 judge 同時用於 leaderboard、數據篩選、reward model 訓練和上線驗收,系統很容易過擬合 judge。更穩妥的做法是區分開發 judge、驗證 judge 和審計 judge,並保留盲測集。
第五,多模態和 agent 軌跡會把問題複雜化。圖像、視頻、工具調用、瀏覽路徑、代碼修改軌跡不再是單段文本,judge 需要判斷中間步驟、證據鏈和工具副作用。BabelJudge 對 agent trajectory perturbation 的擴展,是這個方向的早期信號。
工程落地啟發
先定義失敗類型,再選擇 judge。不要用“整體質量 1-5 分”替代需求分析。RAG 可拆成事實支持、引用覆蓋、無關信息、拒答正確性;代碼助手可拆成編譯、測試、邊界條件、解釋質量;客服可拆成政策合規、語氣、解決率。
每個關鍵 judge 都需要金標校準集。規模不必很大,但必須新鮮、覆蓋邊界案例,並與線上流量同分布。沒有金標集時,judge 只能作為探索信號,不適合做強上線門檻。
默認做順序交換和長度控制。pairwise judge 至少跑 A/B 與 B/A 兩次;pointwise rubric 至少抽樣做分數選項置換;文本長度應作為協變量記錄。
把 judge 輸出結構化。要求 verdict、score、criterion-level reasons、evidence spans、confidence、abstain reason,並用 schema 校驗。無效輸出率本身就是可靠性指標。
不要迷信 CoT。近一年經驗顯示,如果 criteria 清楚,CoT 不一定帶來顯著收益;如果 criteria 模糊,CoT 只是把模糊判斷寫得更長。更重要的是 rubric 可執行、例子覆蓋邊界、輸出可驗證。
用 ensemble 處理高風險場景,但要報告分歧。多個 judge 一致不代表真理,多個 judge 分歧卻很有價值。dissent rate 高的樣本應進入人工複核或錯誤庫。
記錄 judge 版本。模型名、API 版本、temperature、prompt、rubric、reference、schema、解析代碼、重試策略和聚合腳本都要可追蹤。閉源 judge 更新後,應重跑代表性校準集。
侷限與爭議
第一,LLM judge 的“解釋”不等於可解釋性。它可能給出流暢理由,但理由是否真驅動了 verdict 仍需反事實測試。第二,很多研究仍依賴少量任務、少量模型或英文數據,跨領域泛化待人工核驗。第三,開源 judge 降低成本和增強復現,但不一定能評估比自己更強的模型。第四,自動 judge 被廣泛用於排行榜後,候選模型可能針對 judge 風格優化,導致分數上漲而真實用戶收益有限。第五,垂直領域尤其是醫療、法律、金融和安全評估仍不能把 LLM judge 當成專家替代品,只能作為篩查、分流和輔助審計工具。
接下來值得關注的問題
值得關注的第一類問題是 judge 的不確定性表達:如何讓 judge 給出可校準概率,而不是看似確定的自然語言判斷。第二類是 judge 數據治理:哪些樣本應進入校準集,如何防止洩漏,如何定期更新。第三類是 agent 評測:最終答案、工具調用、證據鏈和中間狀態如何共同決定質量。第四類是跨語言公平性:中文、低資源語言和專業術語場景中,judge 是否仍與目標用戶判斷一致。第五類是監管和審計:當 judge 參與高風險決策,評估契約、校準記錄和人工複核流程是否能被外部審查。
總結
LLM-as-a-Judge 的價值並沒有因為偏置研究而下降;相反,這些研究讓它從“方便的自動評分器”走向“需要工程治理的測量系統”。可用的 judge 不等於可靠的 judge,可靠的 judge 也不等於可以完全替代人類。對研究者來說,下一階段的關鍵不是再證明 GPT-4 類模型能和人類相關,而是解釋在什麼任務、什麼樣本、什麼校準條件下,judge 的結論可以被信任。對工程團隊來說,最穩妥的實踐是把 judge 當作 CI 中的質量傳感器:持續校準、持續審計、允許拒判,並把高風險樣本交還給人類專家。
參考資料
檢索日期:2026-06-27。
- Yang Liu et al. G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment. arXiv, 2023. https://arxiv.org/abs/2303.16634
- Lianmin Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv, 2023. https://arxiv.org/abs/2306.05685
- Yann Dubois et al. Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators. arXiv, 2024. https://arxiv.org/abs/2404.04475
- Tianle Li et al. From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline. arXiv, 2024. https://arxiv.org/abs/2406.11939
- Junsoo Park et al. OffsetBias: Leveraging Debiased Data for Tuning Evaluators. arXiv, 2024. https://arxiv.org/abs/2407.06551
- Sijun Tan et al. JudgeBench: A Benchmark for Evaluating LLM-based Judges. arXiv, 2024. https://arxiv.org/abs/2410.12784
- Jiawei Gu et al. A Survey on LLM-as-a-Judge. arXiv, 2024. https://arxiv.org/abs/2411.15594
- Haitao Li et al. LLMs-as-Judges: A Comprehensive Survey on LLM-based Evaluation Methods. arXiv, 2024. https://arxiv.org/abs/2412.05579
- Yusuke Yamauchi et al. An Empirical Study of LLM-as-a-Judge: How Design Choices Impact Evaluation Reliability. arXiv, 2025. https://arxiv.org/abs/2506.13639
- Chen Feng et al. Noisy but Valid: Robust Statistical Evaluation of LLMs with Imperfect Judges. arXiv, 2026. https://arxiv.org/abs/2601.20913
- Yuzheng Xu et al. Am I More Pointwise or Pairwise? Revealing Position Bias in Rubric-Based LLM-as-a-Judge. arXiv, 2026. https://arxiv.org/abs/2602.02219
- Ashmi Banerjee et al. Multi-Dimensional Evaluation of Sustainable City Trips with LLM-as-a-Judge and Human-in-the-Loop. arXiv, 2026. https://arxiv.org/abs/2604.24158
- Md Faizul Ibne Amin et al. LLM-as-a-Judge for Human-AI Co-Creation: A Reliability-Aware Evaluation Framework for Coding. arXiv, 2026. https://arxiv.org/abs/2604.27727
- James Fiedler. Bias and Uncertainty in LLM-as-a-Judge Estimation. arXiv, 2026. https://arxiv.org/abs/2605.06939
- Shreyas KC. BabelJudge: Measuring LLM-as-a-Judge Reliability Across Languages and Agent Trajectories. arXiv, 2026. https://arxiv.org/abs/2606.22329
- Donghao Huang et al. LLM-as-a-Judge for Scalable Test Coverage Evaluation: Accuracy, Operational Reliability, and Cost. arXiv, 2025. https://arxiv.org/abs/2512.01232
- Seungone Kim et al. Prometheus 2: An Open Source Language Model Specialized in Evaluating Other Language Models. arXiv, 2024. https://arxiv.org/abs/2405.01535
- Prometheus Eval project repository. https://github.com/prometheus-eval/prometheus-eval
- JudgeBench project repository. https://github.com/ScalerLab/JudgeBench
- Awesome LLMs-as-Judges resource list. https://github.com/CSHaitao/Awesome-LLMs-as-Judges
- Shreyas KC. BabelJudge project repository. https://github.com/Shreyaskc/BabelJudge