日期:2026-06-26
適合讀者:研究生、LLM 應用研究者、安全工程師、Agent/RAG 系統開發者
檢索日期:2026-06-26
摘要
Prompt Injection 最早像是一個“提示詞工程”問題:用戶在輸入裡寫一句“忽略上文”,模型就可能偏離開發者意圖。到 2025-2026 年,這個問題已經演化成 Agent Security 的核心議題:LLM 不再只是生成文本,而是在瀏覽器、郵件、代碼倉庫、MCP 工具、數據庫和長期記憶之間調度權限。真正危險的不是模型“說錯話”,而是未受信任的網頁、郵件或工具描述影響了帶權限的動作參數,比如收件人、轉賬賬戶、命令行、文件路徑、API endpoint。
近一年研究的主線很清晰:攻擊從直接注入轉向間接注入、工具投毒、記憶投毒和多步狀態汙染;評測從靜態 prompt 集合轉向真實任務環境、瀏覽器代理和利益相關方視角;防禦從“過濾惡意文本”轉向指令層級、結構化通道、能力沙箱、來源追蹤、最小權限和運行時授權。工程上最重要的啟發是:不要把 LLM 當作安全邊界,安全邊界應該在工具、數據流、權限和可審計執行層。
目錄
- 研究背景:為什麼 Agent 放大了注入風險
- 近一年路線圖
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 參考資料
研究背景:從 prompt 混淆到權限混淆
Prompt Injection 的根因是“指令”和“數據”共享同一個自然語言上下文。傳統 Web 安全裡,SQL 注入危險是因為數據被解釋成代碼;LLM 應用裡,外部文本被解釋成更高優先級的任務指令。Simon Willison 在 2022 年將這一類問題命名為 prompt injection;Greshake 等人在 2023 年的 indirect prompt injection 論文進一步指出,攻擊者不必直接向模型輸入惡意 prompt,只要把指令藏在網頁、郵件、文檔或檢索結果裡,應用在讀取外部數據時就可能被劫持。
Agent 讓問題升級。普通聊天機器人最多輸出錯誤文本;Agent 可以讀取郵箱、發請求、寫文件、調用支付或部署接口。此時安全問題不再只是“模型是否拒答”,而是“誰有權讓哪個參數進入哪個工具調用”。OWASP 2025 將 Prompt Injection 放在 LLM 應用風險首位,並把 Excessive Agency、敏感信息洩露、供應鏈和工具調用風險一併納入治理視角;MCP 官方安全實踐也強調用戶同意、least privilege、confused deputy 和 token passthrough 風險。NCSC 更早提醒過:Prompt Injection 可能是 LLM 技術的內生問題,不能只靠更強提示詞完全消除。
近一年路線圖
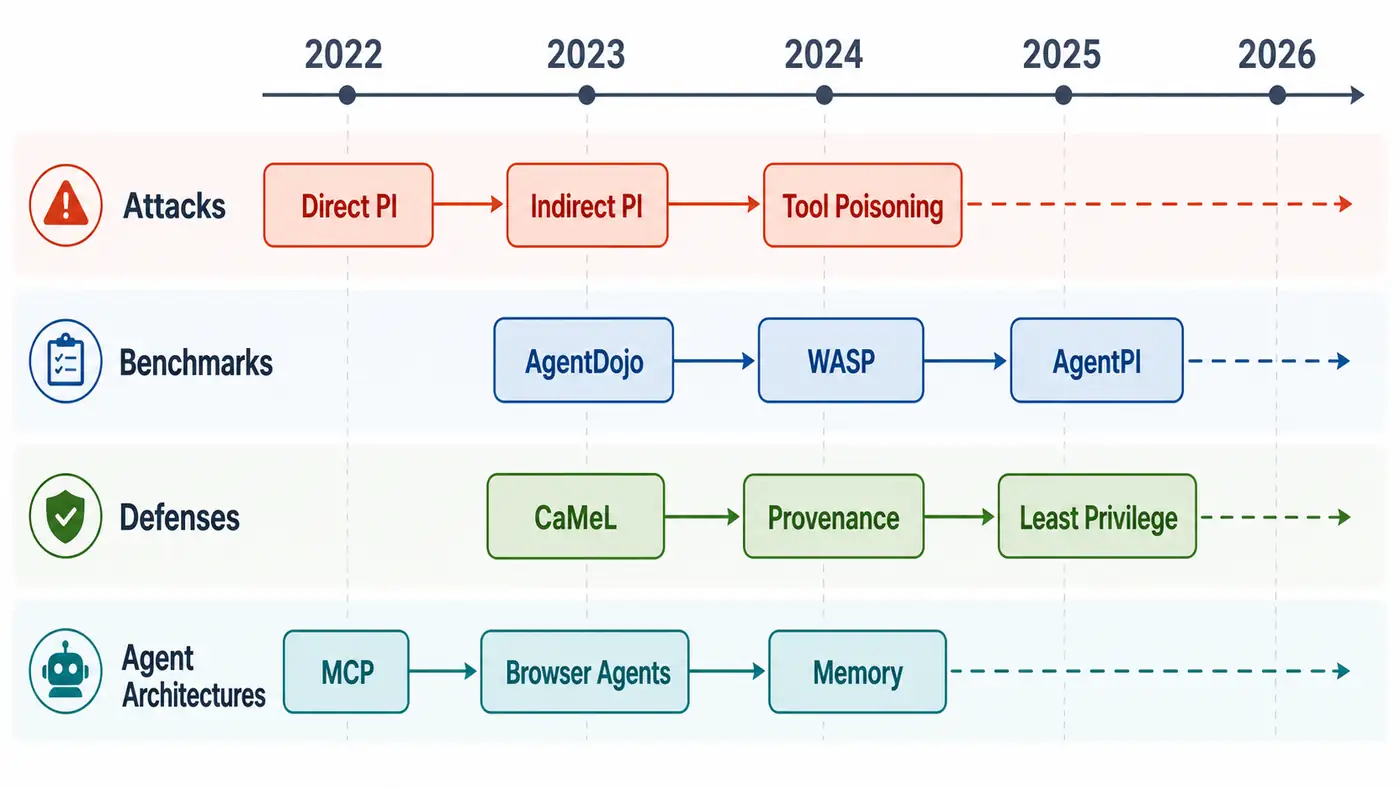
2024 年的重點是定義問題和建立環境:Instruction Hierarchy 把系統、開發者、用戶、工具/第三方內容區分成不同權限層級;StruQ 用結構化查詢訓練模型只服從 prompt 區域的指令;AgentDojo 把郵件、銀行、旅行等工具任務放進可擴展環境,評估 agent 在未受信任數據下的攻擊與防禦。
2025 年,研究明顯轉向“真實 agent 場景”。WASP 聚焦 Web Agent,把攻擊者能力限制在更貼近網頁內容操縱的條件下;CaMeL 把可信用戶請求解析成控制流和數據流,再用 capability 限制未受信任數據影響程序流程;MCP Safety Audit 則把 MCP 生態作為新攻擊面,討論惡意工具、工具描述投毒、憑據竊取和遠程執行風險。
2026 年上半年出現了更細粒度的系統化研究:AgentPI 這類 SoK/benchmark 強調 context-dependent task,即真實 agent 必須讀取環境上下文才能完成任務,簡單隔離外部內容會損害 utility;PACT、AuthGraph、SafeAgent、SecureClaw 等預印本把重點放到參數級 provenance、授權圖、運行時控制器和讀寫雙邊界。它們還需要更多獨立復現,但方向很值得關注:安全不只是輸入分類器,而是執行軌跡上的權限約束。
代表論文分組解讀
1. 攻擊:從直接注入到狀態汙染
直接注入攻擊通常來自用戶輸入,目標是覆蓋系統或開發者指令;間接注入攻擊來自外部數據,威脅更接近真實部署。Indirect prompt injection 的經典結論是:只要應用把網頁、郵件或檢索文檔放進同一上下文,攻擊者就可能讓模型執行“用戶沒有授權但 agent 有能力做”的動作。
近一年攻擊面繼續擴張。Web agent 需要解析頁面視覺元素、隱藏文本、表單和導航狀態;MCP agent 需要信任第三方 server 暴露的 tool descriptions;帶長期記憶的助手可能把惡意規則寫入未來會話。ASB 把系統 prompt、用戶 prompt、工具調用和記憶檢索都納入攻擊階段,說明 agent 安全必須看完整生命週期,而不能只在入口做一次過濾。
2. Benchmark:從靜態集合到任務環境
Prompt Injection 早期 benchmark 往往像分類題:給一段文本,判斷模型是否被誘導。AgentDojo 的貢獻是把任務、工具和攻擊組合成動態環境,並區分 task utility 與 security。論文公開摘要中列出 97 個現實任務和 629 個安全測試用例,這使研究者能比較“能否完成正常任務”和“能否抵抗攻擊”之間的張力。
WASP 更進一步關注瀏覽器代理。其摘要報告了一個有意思的現象:一些 agent 會在 16%-86% 的情況下開始執行惡意指令,但真正端到端達成攻擊目標的比例只有 0%-17%。這不是安全性的勝利,而是提醒我們:當前 agent 能力不足會“偶然降低攻擊完成率”;一旦基礎能力提升,同樣的安全設計可能迅速失效。
2026 年的 StakeBench/AgentPI 類工作把評測焦點從攻擊成功率擴展到受害方和上下文依賴。一個注入可以同時傷害用戶、賣家、平臺或第三方;而防禦如果粗暴屏蔽環境上下文,又會讓 agent 無法完成授權任務。未來 benchmark 應該同時報告任務成功、攻擊成功、誤拒率、延遲、權限越界類型和可審計性。
3. 防禦:三條路線正在成形
第一條路線是模型側指令優先級。Instruction Hierarchy 通過訓練讓模型識別高低優先級衝突;StruQ 則用結構化通道把“指令區域”和“數據區域”分開。它們適合作為基礎能力,但不能單獨承擔系統安全邊界。2025 年關於 fine-tuning 防禦的白盒攻擊預印本顯示,結構化或對齊式防禦在強攻擊者下仍可能被突破,具體結論需結合後續復現核驗。
第二條路線是架構側隔離。CaMeL 的核心思想是:可信請求決定控制流,未受信任數據只能作為數據參與,不應改變程序流程;capability 用來限制數據外流。這類工作對工程師最有價值,因為它把問題從“讓模型更聽話”改寫為“讓模型沒有權限犯關鍵錯誤”。
第三條路線是運行時 provenance 與授權。PACT、AuthGraph、SecureClaw 等 2026 預印本把關注點放到工具參數來源:例如郵件正文可以影響摘要內容,但不應決定轉賬賬號或外發郵箱地址。這個方向更接近傳統信息流控制、taint tracking 和 policy enforcement,可能成為 agent 平臺的基礎設施。
方法對比表
| 類別 | 代表工作 | 主要對象 | 優點 | 風險與待驗證點 |
|---|---|---|---|---|
| 指令層級訓練 | Instruction Hierarchy | 模型行為 | 讓模型理解權限衝突 | 不能替代工具授權 |
| 結構化通道 | StruQ | prompt/data 分離 | 思路清楚,易解釋 | 白盒攻擊魯棒性仍需核驗 |
| 動態評測環境 | AgentDojo, ASB | Agent 工具任務 | 能同時測 utility 與 security | 不同任務生態可遷移性有限 |
| Web Agent 評測 | WASP, WAInjectBench, StakeBench | 瀏覽器代理 | 更貼近真實網頁攻擊 | 頁面複雜度和模型版本變化快 |
| 能力沙箱 | CaMeL | 控制流、數據流、capability | 把安全邊界移出模型 | 工程成本和任務覆蓋率是挑戰 |
| 來源/授權圖 | PACT, AuthGraph, SecureClaw | 工具參數與讀寫邊界 | 貼近權限系統,可審計 | 多為 2026 預印本,待獨立復現 |
| 協議/生態審計 | MCP Safety Audit, MCP-38 | MCP server 與 tool | 覆蓋新興工具生態 | 實際 MCP 部署差異大 |
關鍵技術趨勢
第一,Prompt Injection 正在從“輸入安全”變成“執行安全”。把一句外部文本判定為惡意並不夠,因為同一段網頁內容在摘要任務裡是數據,在轉賬任務裡可能變成危險參數。安全策略要綁定任務、工具、參數和來源。
第二,Agent Security 正在吸收傳統安全範式:least privilege、confused deputy、capability、taint tracking、policy-as-code、審計日誌和人類確認。LLM 負責語義理解,但權限系統必須由確定性組件執行。
第三,MCP 和工具生態會成為高價值研究對象。MCP 降低了工具接入成本,也讓工具描述、server 身份、授權 scope、token 傳遞和多 server 組合成為新邊界。工具描述不應被默認當作可信事實,安裝、更新、授權和調用都需要供應鏈治理。
第四,評測會從“攻擊是否成功”轉向“誰受損、怎麼受損、能否追責”。真實平臺關心的不只是 ASR,還包括 benign task completion、誤攔截成本、用戶確認負擔、洩露路徑、恢復能力和事後取證。
工程落地啟發
- 把所有外部內容標成 untrusted。網頁、郵件、PDF、RAG chunk、工具返回、MCP tool description、長期記憶都不應自動提升為指令。
- 對工具調用做參數級授權。允許 agent 總結郵件,不等於允許郵件正文決定收件人、附件、轉賬目標或 shell 命令。
- 採用最小權限和分階段提交。高風險動作使用 PREVIEW -> USER_APPROVE -> COMMIT;commit 階段由可信 executor 執行規範化請求。
- 記錄 provenance。每個關鍵參數應能追溯到用戶輸入、系統配置、外部數據或模型生成;審計日誌要覆蓋讀取、推理、工具調用和最終輸出。
- 對 MCP/server 做供應鏈治理。固定 server 版本、校驗發佈者、限制 scope、禁止無提示擴權,避免把工具描述當作天然可信。
- 不把“系統提示詞寫得更嚴”當成主要防線。提示詞可以降低誤操作,但不能提供強安全保證。
- 評測要包含真實失敗模式。至少覆蓋直接注入、間接注入、工具投毒、記憶汙染、數據洩露、越權寫操作和 benign utility。
侷限與爭議
當前研究還有三個明顯缺口。第一,很多論文在不同模型、任務和工具生態上評測,結果很難橫向比較;同一個 defense 在郵件 agent 上有效,不代表在代碼 agent 或瀏覽器 agent 上有效。第二,2026 年不少系統架構論文仍是預印本,報告的 0% ASR 或高 utility 數字需要獨立復現、開源實現和更強 adaptive attack。第三,安全與可用性的矛盾尚未解決:完全隔離外部數據會讓 agent 無法完成上下文依賴任務;過度信任上下文又會帶來權限混淆。
因此,本文不把任何單一方案視為最終答案。更現實的部署形態可能是組合式:模型側指令層級作為基礎,工具層最小權限作為硬邊界,運行時 provenance/authorization 作為審計和攔截層,高風險動作交給人類確認。
接下來值得關注的問題
- 是否會出現面向 Agent 的通用信息流控制框架,像 Web 安全裡的 CSP/權限模型一樣成為平臺默認能力?
- MCP 生態是否會形成可驗證的工具身份、權限聲明、簽名更新和安全審計規範?
- 長期記憶如何做可撤銷、可解釋、可隔離的安全治理?
- Web agent 的視覺注入、隱藏文本和跨頁面狀態汙染如何被系統化評測?
- 評測指標能否從 ASR 擴展到 stakeholder harm、誤拒成本和恢復能力?
總結
Prompt Injection 的研究重心已經從“模型會不會聽攻擊者的話”轉向“agent 的權限是否被未受信任數據間接控制”。近一年最重要的趨勢不是某個 detector 分數更高,而是安全邊界正在外移:從 prompt 到結構化上下文,從模型到工具運行時,從文本分類到參數來源和授權關係。對工程團隊來說,最穩妥的路線是承認 LLM 不是安全邊界,把 agent 看成一套有權限、有狀態、有供應鏈的軟件系統來設計。
參考資料
檢索日期:2026-06-26。
- Simon Willison, “Prompt injection attacks against GPT-3”, 2022. https://simonwillison.net/2022/Sep/12/prompt-injection/
- Kai Greshake et al., “Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection”, arXiv, 2023. https://arxiv.org/abs/2302.12173
- Eric Wallace et al., “The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions”, arXiv, 2024. https://arxiv.org/abs/2404.13208
- Sizhe Chen et al., “StruQ: Defending Against Prompt Injection with Structured Queries”, arXiv / USENIX Security 2025. https://arxiv.org/abs/2402.06363
- Edoardo Debenedetti et al., “AgentDojo: A Dynamic Environment to Evaluate Prompt Injection Attacks and Defenses for LLM Agents”, arXiv, 2024. https://arxiv.org/abs/2406.13352
- Hanrong Zhang et al., “Agent Security Bench (ASB): Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents”, arXiv, 2024. https://arxiv.org/abs/2410.02644
- Ivan Evtimov et al., “WASP: Benchmarking Web Agent Security Against Prompt Injection Attacks”, arXiv, 2025. https://arxiv.org/abs/2504.18575
- Edoardo Debenedetti et al., “Defeating Prompt Injections by Design”, arXiv, 2025. https://arxiv.org/abs/2503.18813
- Brandon Radosevich and John Halloran, “MCP Safety Audit: LLMs with the Model Context Protocol Allow Major Security Exploits”, arXiv, 2025. https://arxiv.org/abs/2504.03767
- Yinuo Liu et al., “WAInjectBench: Benchmarking Prompt Injection Detections for Web Agents”, arXiv, 2025. https://arxiv.org/abs/2510.01354
- Peiran Wang et al., “The Landscape of Prompt Injection Threats in LLM Agents: From Taxonomy to Analysis”, arXiv, 2026. https://arxiv.org/abs/2602.10453
- Zihao Wang et al., “Who Pays the Price? Stakeholder-Centric Prompt Injection Benchmarking for Real-world Web Agents”, arXiv, 2026. https://arxiv.org/abs/2606.13385
- Linfeng Fan et al., “The Granularity Mismatch in Agent Security: Argument-Level Provenance Solves Enforcement and Isolates the LLM Reasoning Bottleneck”, arXiv, 2026. https://arxiv.org/abs/2605.11039
- Peiran Wang et al., “Aligning Provenance with Authorization: A Dual-Graph Defense for LLM Agents”, arXiv, 2026. https://arxiv.org/abs/2605.26497
- Hailin Liu et al., “SafeAgent: A Runtime Protection Architecture for Agentic Systems”, arXiv, 2026. https://arxiv.org/abs/2604.17562
- Yuhan Ma and Stefan Schmid, “SecureClaw: Clawing Back Control of LLM Agents”, arXiv, 2026. https://arxiv.org/abs/2606.09549
- Yi Ting Shen et al., “MCP-38: A Comprehensive Threat Taxonomy for Model Context Protocol Systems”, arXiv, 2026. https://arxiv.org/abs/2603.18063
- OWASP, “LLM01: Prompt Injection”, OWASP Top 10 for LLM Applications 2025. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- OWASP Cheat Sheet Series, “LLM Prompt Injection Prevention Cheat Sheet”. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- Model Context Protocol, “Security Best Practices”, specification version 2025-06-18. https://modelcontextprotocol.io/specification/2025-06-18/basic/security_best_practices/
- NIST, “Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile”, NIST AI 600-1, July 2024. https://doi.org/10.6028/NIST.AI.600-1
- UK NCSC, “Exercise caution when building off LLMs”, 2023. https://www.ncsc.gov.uk/blog-post/exercise-caution-building-off-llms