日期:2026-06-25
適合讀者:大模型研究生、評測平臺建設者、模型選型與應用工程團隊
檢索日期:2026-06-25
摘要
過去一年,LLM Evaluation 的核心問題從“哪個模型在榜單上更高”轉向“這個分數是否仍能區分真實能力”。MMLU、BIG-bench、HELM 曾經讓通用評測標準化;MMLU-Pro、LiveBench、SimpleQA、Humanity's Last Exam、BetterBench、SimpleQA Verified 等工作進一步把難度、抗汙染、事實性、可復現性和 benchmark 生命週期推到前臺。
本文的主線是:評測正在從靜態題庫走向動態題庫,從單一 accuracy 走向多指標畫像,從通用榜單走向任務化執行環境,從展示排名走向診斷失敗模式。工程上的結論也很直接:公開榜單隻能初篩,真正可用的評測能力來自私有 golden set、動態 recent set、人工抽檢、統計置信區間和線上迴歸閉環。
目錄
- 研究背景
- 近一年路線圖
- 代表論文分組解讀
- 方法對比表
- 關鍵趨勢與工程啟發
- 侷限與爭議
- 參考資料
研究背景
早期 LLM 評測追求統一可比:給定相同題目,用 accuracy、F1、BLEU、ROUGE 或人工偏好比較模型。MMLU 在 2020 年用 57 個學科的多選題覆蓋知識和問題求解;BIG-bench 在 2022 年擴展為社區貢獻的多任務集合;HELM 則把 accuracy 擴展為 calibration、robustness、fairness、bias、toxicity、efficiency 等多維指標。
這些基準的價值是把模型發佈從“展示樣例”推向“標準化報告”。但 2024-2026 年的現實是,許多公開題庫已接近飽和,訓練語料也更可能包含公開 benchmark 或相似題。對於工程團隊,最危險的不是低分,而是高分不再代表生產任務可靠性。
近一年路線圖
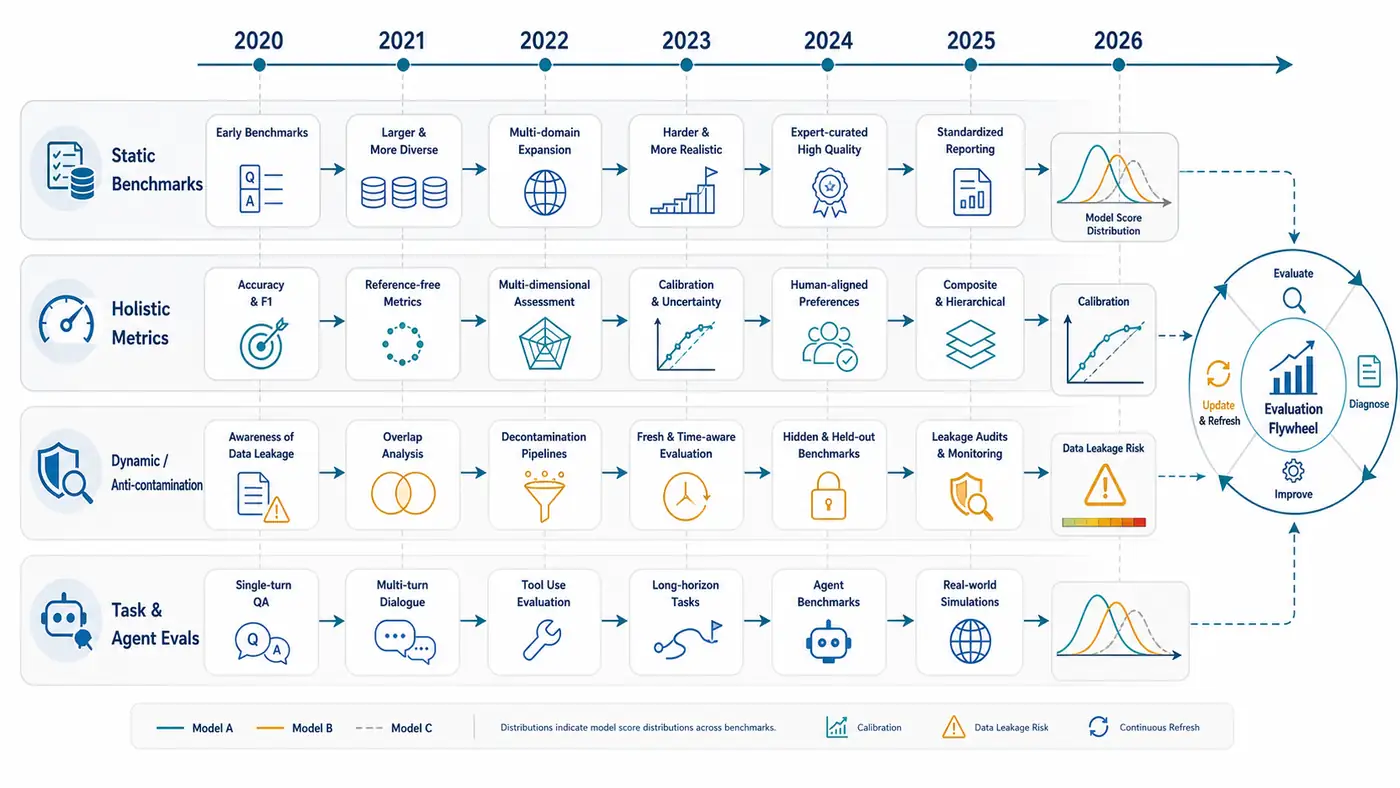
2024:更難、更穩、更抗汙染。 MMLU-Pro 清理 MMLU 噪聲題,加入更強推理需求,並把選項從 4 個擴展到 10 個,以提高區分度和 prompt 穩定性。LiveBench 則把抗汙染作為核心:題目來自近期數學競賽、arXiv、新聞和數據集,按月更新,並儘量採用可自動核驗的客觀答案。
2024-2025:事實性和專家邊界成為重點。 OpenAI 的 SimpleQA 聚焦短事實問答,要求答案單一且可判定,並區分 correct、incorrect、not attempted;Humanity's Last Exam 用專家級、多學科、部分多模態的閉卷題測試前沿模型,回應熱門 benchmark 被高分“打穿”的問題。
2025:評測本身也需要被評測。 BetterBench 用 benchmark 生命週期最佳實踐審視基準質量,強調統計顯著性、復現性、文檔、版本和錯誤修復流程。2025 年的 LLM benchmark survey 將數百個 benchmark 歸類為通用能力、領域能力和目標能力,也把數據汙染、文化/語言偏差、動態環境不足列為系統性問題。
2025-2026:從靜態能力到工作流能力。 SWE-bench、BrowseComp、HealthBench、SpreadsheetBench 等任務化評測把重點從“回答題目”推向“完成任務”。這類評測通常涉及工具調用、文件編輯、瀏覽、測試執行和長上下文,模型分數不再只由模型決定,也由 agent scaffold、運行環境和評分腳本決定。部分 2026 預印本已討論 frontier leaderboard 飽和後的指標輪換;相關結論變化很快,本文標註為“待人工核驗”。
代表論文分組解讀
1. 通用多任務:MMLU 到 MMLU-Pro
MMLU 的歷史地位來自兩點:覆蓋學科廣,題型簡單可復現。但多選題容易受選項分佈、題庫記憶和 prompt 格式影響;當強模型接近飽和時,分數差距也不再穩定。MMLU-Pro 的意義不是單純變大,而是面向前沿模型做壓力升級:清理噪聲、增加推理、擴展選項。企業私有評測也應如此迭代,不能長期依賴舊題庫通過率。
2. 多指標畫像:HELM 的方法論
HELM 的關鍵不是某個榜單,而是“場景 x 指標”的評測觀。一個適合客服、醫療、法律或代碼審查的模型,不只要答對,還要校準、穩健、公平、低毒性、成本可控。工程評測表至少應拆成三層:任務成功率,可靠性指標,運營指標。沒有這三層,榜單高分很難轉化為可控 SLA。
3. 動態抗汙染:LiveBench
公開題庫會進入訓練數據、微調集、提示工程示例和模型發佈材料。一旦汙染髮生,分數可能反映記憶而非泛化。LiveBench 的路線是持續更新題目、使用近期來源、偏向客觀評分。它也帶來復現挑戰,因此評測平臺需要像軟件系統一樣維護版本、變更日誌、凍結快照和回放機制。
4. 事實性:SimpleQA 與 SimpleQA Verified
事實性過去常混在開放生成任務中,評分容易被表達質量掩蓋。SimpleQA 把問題收窄為短事實問答,顯式鼓勵模型在不確定時不作答。SimpleQA Verified 則指出評測集本身會有噪聲、主題偏置和重複問題,需要去重、主題平衡和來源對賬。業務 golden set 也是如此:標籤不可靠時,模型越強越容易暴露評測集錯誤。
5. 專家級閉卷:Humanity's Last Exam
HLE 把難度推向專家邊界。arXiv 頁面顯示其 2025 年提交、2026 年仍有修訂版本;題目覆蓋數學、自然科學、人文社科等多學科,包含多選、短答案和部分多模態題。它的重要性在於重新拉開前沿模型差距,但越難的 benchmark 越依賴專家標註和持續糾錯。引用 HLE 時應關注版本號、公開/私有 split 和錯誤修復記錄。
6. 元評測:BetterBench 與數據汙染綜述
BetterBench 把焦點從“模型評測”轉到“評測 benchmark 的 benchmark”,關注文檔、可復現、統計顯著性、數據治理和維護。數據汙染綜述則系統梳理 test set contamination 的風險。它們的工程含義是:沒有置信區間、版本鎖定和錯誤反饋渠道的 benchmark,很快會失去解釋力。
方法對比表
| 路線 | 代表工作 | 解決什麼 | 優點 | 風險 |
|---|---|---|---|---|
| 靜態多任務 | MMLU, BIG-bench | 通用能力橫向比較 | 易復現、覆蓋廣 | 飽和、汙染、prompt 敏感 |
| 多指標畫像 | HELM | accuracy 不夠 | 暴露可靠性和成本權衡 | 指標解釋成本高 |
| 難度升級 | MMLU-Pro, GPQA, HLE | 前沿模型區分度下降 | 更適合 frontier 模型 | 標註和糾錯成本高 |
| 動態抗汙染 | LiveBench | 公開題庫洩漏 | 降低記憶風險 | 版本比較更復雜 |
| 事實性 | SimpleQA, SimpleQA Verified | 幻覺與不確定性 | 自動評分清晰 | 覆蓋面窄 |
| 任務化評測 | SWE-bench, BrowseComp | 真實工作流能力 | 貼近應用 | harness 影響結果 |
| 元評測 | BetterBench | benchmark 本身質量 | 提升可信度 | 不直接給模型結論 |
關鍵趨勢與工程啟發
第一,benchmark rotation 會成為常態。如果論文只報告舊基準高分,卻不解釋這些基準為何仍有區分度,可信度會下降。第二,動態評測和私有 holdout 更重要。公開榜單適合初篩,最終決策應依賴業務 golden set 和近期樣本。第三,評分器本身需要校準。規則評分、人類偏好、LLM-as-a-Judge 都有偏差;judge prompt、judge model、溫度、版本和原始評分理由都應留檔。第四,任務化評測拉高工程門檻。代碼、瀏覽、表格和醫療評測需要沙箱、依賴、工具日誌、重試和安全邊界。第五,報告應從分數表升級為診斷報告:失敗聚類、混淆矩陣、校準曲線和樣例審計比單點排名更有用。
落地時建議做 7 件事:建立公開 benchmark、私有 golden set、動態 recent set 三類集合;每個樣本記錄來源、標準答案、評分函數、版本和複核時間;同時報告成功率、拒答率、幻覺率、格式錯誤率、延遲和成本;對 LLM judge 做人工抽檢;模型升級採用 paired evaluation;按知識缺失、推理斷裂、指令不遵循、工具誤用等錯誤模式歸因;高風險場景保留人工驗收門檻。
侷限與爭議
LLM Evaluation 仍有幾個矛盾。公開性和抗汙染衝突:公開題庫便於復現,也更容易洩漏;私有題庫降低汙染,卻降低透明度。難度和可判定性衝突:真實任務更開放,評分更難;自動評分更穩定,任務往往更窄。榜單和產品目標衝突:榜單優化追求平均分,生產系統更關心尾部失敗、合規和恢復能力。
還有一個常被忽略的問題:評測集會老化。業務流程、用戶語言、模型能力、攻擊方式和外部知識都在變。一個半年沒有新增樣本和錯誤修復的評測集,應被視為歷史快照,而不是唯一發布門檻。
總結
LLM Evaluation 已經從“給模型排個名”變成“構建可信測量系統”。MMLU、BIG-bench、HELM 提供了標準化基礎;MMLU-Pro、LiveBench、SimpleQA、HLE、BetterBench 則說明,評測本身也需要迭代、審計和治理。對研究者,未來論文應報告協議、版本、統計顯著性、失敗分析和汙染控制;對工程團隊,真正的評測能力來自私有任務集、動態更新、可追蹤評分器和生產迴歸閉環。
參考資料
以下資料均於 2026-06-25 檢索;模型排名、榜單分數和倉庫狀態變化較快,引用前建議再次核對版本。
- Dan Hendrycks et al. Measuring Massive Multitask Language Understanding. arXiv:2009.03300, 2020. https://arxiv.org/abs/2009.03300
- Aarohi Srivastava et al. Beyond the Imitation Game. arXiv:2206.04615, 2022. https://arxiv.org/abs/2206.04615
- Percy Liang et al. Holistic Evaluation of Language Models. arXiv:2211.09110, 2022. https://arxiv.org/abs/2211.09110
- Stanford CRFM. HELM. https://crfm.stanford.edu/helm/latest/
- Yubo Wang et al. MMLU-Pro. arXiv:2406.01574, 2024. https://arxiv.org/abs/2406.01574
- Colin White et al. LiveBench. arXiv:2406.19314, 2024. https://arxiv.org/abs/2406.19314
- LiveBench official site. https://livebench.ai/
- Jason Wei et al. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024. https://arxiv.org/abs/2411.04368
- OpenAI. simple-evals. https://github.com/openai/simple-evals
- Long Phan et al. Humanity's Last Exam. arXiv:2501.14249, first submitted 2025-01-24, latest observed revision v10 on 2026-02-20. https://arxiv.org/abs/2501.14249
- Anka Reuel et al. BetterBench. arXiv:2411.12990, 2024. https://arxiv.org/abs/2411.12990
- Cheng Xu et al. Benchmark Data Contamination of Large Language Models: A Survey. arXiv:2406.04244, 2024. https://arxiv.org/abs/2406.04244
- Shiwen Ni et al. A Survey on Large Language Model Benchmarks. arXiv:2508.15361, 2025. https://arxiv.org/abs/2508.15361
- Lukas Haas et al. SimpleQA Verified. arXiv:2509.07968, 2025. https://arxiv.org/abs/2509.07968
- Hugging Face. Open LLM Leaderboard. https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard
- Adil Amin. The Growing Pains of Frontier Models. arXiv:2605.18840, 2026. https://arxiv.org/abs/2605.18840
- Carlos E. Jimenez et al. SWE-bench. arXiv:2310.06770. https://arxiv.org/abs/2310.06770
- OpenAI. Introducing SWE-bench Verified. https://openai.com/index/introducing-swe-bench-verified/