日期:2026-06-24
適合讀者:NLP / LLM 方向研究生、做 RAG 與 Agent 系統的工程師、關注模型服務成本的技術讀者
檢索日期:2026-06-24
摘要
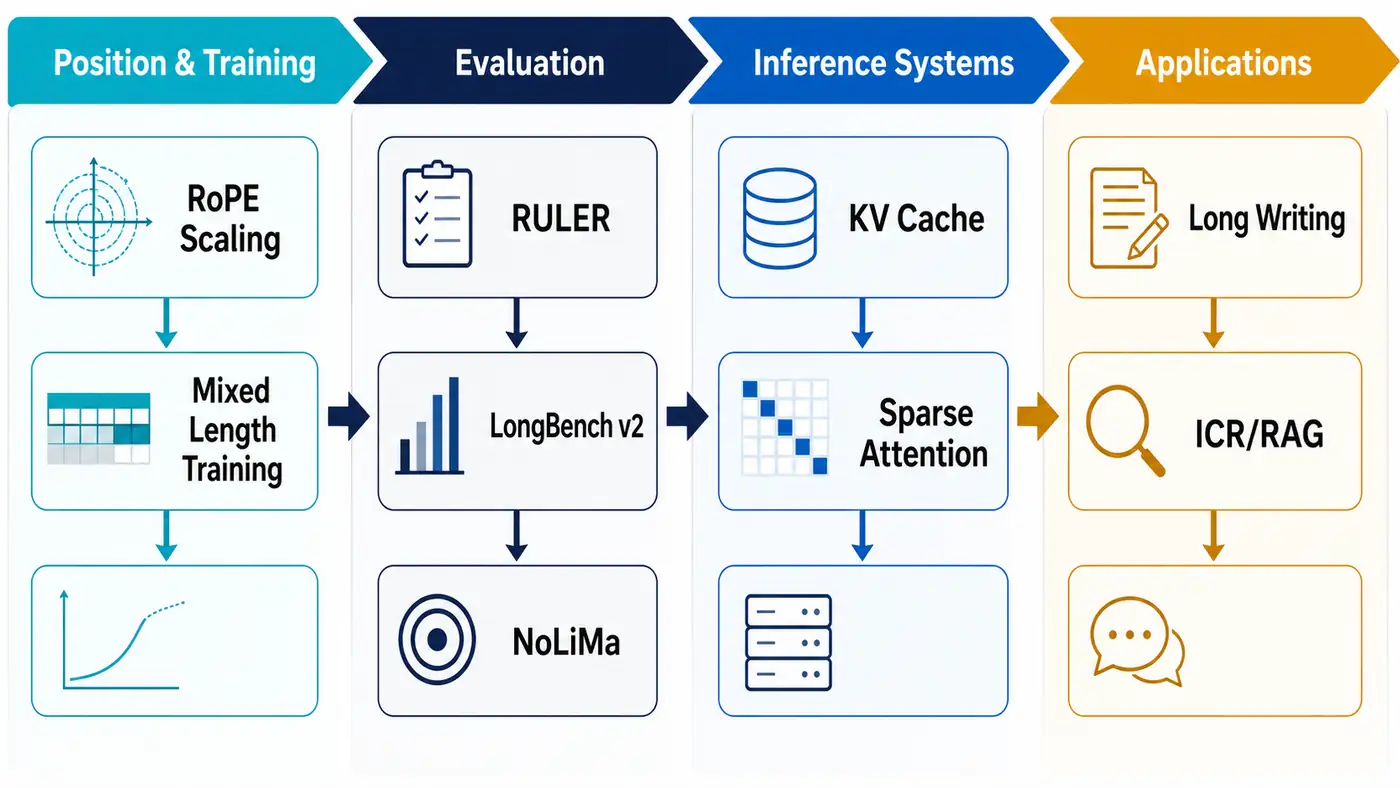
過去兩年,長上下文大模型從 32K、128K 迅速推進到百萬 token 量級。問題也隨之變得更清楚:上下文窗口標稱長度不等於可用長上下文能力。一個模型能接收 1M token,不代表它能穩定找出中間證據、做多跳推理、理解代碼倉庫、生成萬字級高質量輸出,也不代表推理成本可接受。近一年論文的主線可以概括為四條:第一,位置編碼與訓練策略繼續解決“短訓長測”的外推問題;第二,評測從 Needle-in-a-Haystack 轉向更接近真實任務的深層理解、非字面匹配和干擾檢索;第三,系統側圍繞 KV cache、稀疏注意力、緩存壓縮和檢索式解碼降低長上下文服務成本;第四,應用側開始討論長上下文能否部分替代 RAG、SQL、檢索器與寫作規劃器。
這篇文章的核心判斷是:Long Context LLM 正在從“上下文擴容競賽”進入“有效上下文工程”。下一階段的價值不在於把所有材料無腦塞進 prompt,而在於把長上下文模型、檢索系統、結構化記憶、推理預算和評測協議組合起來。
目錄
- 研究背景:為什麼長上下文不是“大 prompt”
- 近一年路線圖
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 總結
- 參考資料
研究背景:為什麼長上下文不是“大 prompt”
早期長上下文研究常被理解為擴大序列長度:把 Transformer 的注意力矩陣、位置編碼、訓練長度和顯存預算一起推大。但 2023 年的 Lost in the Middle 已經提醒社區:模型對信息位置非常敏感,相關證據在開頭或結尾時表現往往更好,落在中部時性能會下降。這個結論後來被大量 needle 類實驗、長文檔問答和代碼倉庫任務重複驗證。
2024 年以後,商業模型與開源模型的上下文窗口快速增加。Google Gemini 1.5 技術報告把“百萬級上下文”帶到主流討論;OpenAI 開發者文檔在 2026 年 6 月檢索時列出 GPT-5.4 / GPT-5.4 Pro 具備 1.05M context window;Anthropic 文檔在 2026 年 6 月檢索時列出 Claude Fable 5、Mythos 5 為 1M token,部分 Claude 4 系列也進入 200K 到 1M 的區間;Meta Llama 4 Scout 的官方資料與模型卡討論 10M token 級別上下文。供應商規格變化很快,具體可用長度、價格、速率限制和模型別名必須以調用當日文檔為準。
學術研究的問題也隨之轉向:如果模型能“看見”一百萬 token,它到底能不能“使用”一百萬 token?如果可以,成本是多少?如果不可以,瓶頸來自位置編碼、訓練數據長度分佈、注意力稀釋、解碼階段 KV cache、還是評測任務本身太簡單?
近一年路線圖
路線一:位置編碼與訓練擴展。 RoPE、ALiBi、YaRN、LongLoRA 等基礎工作讓模型能從較短訓練長度外推到更長推理長度。2025 年的 LongRoPE2 繼續沿著這條線走:它提出高頻 RoPE 維度訓練不足會導致外推 OOD,並用 needle-driven perplexity 的搜索式重縮放與混合上下文訓練,試圖在擴長上下文的同時保留短上下文能力。
路線二:長上下文評測升級。 LongBench v2、NoLiMa、RULER、LOFT、ICR^2 等工作說明,簡單“針藏草堆”已經不夠。真正難的是多文檔推理、結構化表格、代碼倉庫理解、長對話歷史、非字面匹配檢索,以及有強檢索器干擾項的 in-context retrieval。
路線三:推理系統與 KV cache。 只要保持自迴歸解碼,長輸入和長輸出就會把 KV cache 推成服務成本核心。RocketKV、FIER、KV cache clustering、ParisKV 等 2025-2026 年工作從壓縮、稀疏讀取、聚類、GPU 原生檢索和 CPU offload 等方向降低顯存和帶寬壓力。具體速度提升依賴模型、硬件和任務設置,工程選型時不能只看論文摘要中的峰值數字。
路線四:長輸出與應用範式。 LongWriter 與 LongWriter-Zero 把問題從“讀長”擴展到“寫長”。LOFT 與 ICR^2 則把問題推進到“長上下文能否替代檢索系統、RAG、SQL-like 查詢”。結論更像是互補而非替代:模型能直接處理大上下文,但在干擾強、結構化約束強、更新頻繁或需要可審計檢索鏈路的場景,外部檢索和結構化工具仍然必要。
代表論文分組解讀
1. 位置編碼、訓練長度與外推
RoFormer / RoPE 是當前許多 LLM 的位置建模基礎。它把絕對位置映射成旋轉,並在注意力裡自然包含相對位置信息,因此具備一定長度外推潛力。但外推並不是免費午餐:訓練階段沒有覆蓋的頻率維度、位置分佈和長序列模式,會在推理時表現為困惑度上升、局部記憶尚可但跨段推理失效。
LongRoPE2 的價值在於把“擴上下文”拆成兩個目標:目標長度上可用,原始短上下文不退化。它不是簡單改變 RoPE base,而是用搜索式重縮放和混合長度訓練來平衡。對工程實踐的啟發是:如果團隊要擴展一個已有開源模型,不能只跑 NIAH;還要回測短上下文通用能力、指令遵循、代碼和問答,否則可能得到一個“長了但變鈍”的模型。
2. 評測:從 literal retrieval 到真實推理
LongBench v2 是 2024 年末到 2025 年長上下文評測的重要節點。它包含 503 個多選問題,覆蓋單文檔、多文檔、長上下文 ICL、長對話、代碼倉庫和結構化數據等任務,輸入長度可到 2M words。論文報告中,專家在 15 分鐘限制下準確率約 53.7%,直接回答的最佳模型約 50.1%,帶更長推理的 o1-preview 到 57.7%。這些數字的意義不是“哪個模型永久第一”,而是說明長上下文任務已經不只是檢索,還需要推理預算。
NoLiMa 針對 NIAH 的弱點:如果問題和 needle 有大量字面重合,模型可能靠關鍵詞定位而非真正理解。NoLiMa 設計低詞面重合的 needle,要求模型通過隱含關聯找到證據。論文在 2025 年 7 月修訂版中報告,13 個聲稱支持至少 128K 的模型在長上下文下明顯退化;例如在 32K 時,多數模型低於短上下文強基線的一半。這裡最值得記住的是評測思想:不要只測“字符串定位”,要測“語義定位”。
RULER 則追問“真實可用上下文長度”而非標稱長度。它通過可程序化生成的任務和不同長度控制,讓評測者看到模型何時開始崩。對研發團隊來說,RULER 式評測比單個固定長度 benchmark 更接近容量測試。
3. 長上下文能否替代 RAG?
LOFT 討論了一個很有工程誘惑的問題:如果 LLM 能讀入整個 corpus,是否還需要檢索器、RAG、SQL 和其他工具?論文把任務擴到文本檢索、視覺檢索、音頻檢索、RAG、SQL-like 數據查詢和 many-shot ICL。結果顯示,長上下文模型在一些檢索與 RAG 場景中具備競爭力,但在組合推理、結構化查詢和提示策略敏感性上仍有明顯挑戰。
ICR^2 進一步指出,LOFT 一類任務可能低估真實難度,因為真實 RAG 場景裡通常會有強檢索器返回的相似干擾段落。ICR^2 用 confounding passages 構造更貼近實戰的評測,並提出 retrieve-then-generate fine-tuning、retrieval-attention-probing、聯合訓練檢索頭等方法。工程啟發很直接:長上下文不是取消檢索,而是把檢索從外部索引遷移到模型內部注意力和推理流程中;是否值得這樣做,要看成本、可審計性和錯誤恢復能力。
4. 推理系統:KV cache 是真實瓶頸
長上下文推理有兩個階段:prefill 讀入長輸入,decode 逐 token 生成。prefill 成本通常受輸入長度和注意力實現影響,decode 則會不斷讀取越來越大的 KV cache。RocketKV 代表了 2025 年一類訓練無關方法:先做粗粒度 cache eviction,再做細粒度 top-k 稀疏注意力,目標是在較小精度損失下減少顯存和帶寬。FIER、Chelsea、ParisKV 等後續方向則分別探索細粒度檢索、在線聚類、抗漂移檢索和百萬級 KV 訪問。
工程上要警惕兩點。第一,論文報告的 speedup 往往出現在特定 GPU、batch size、上下文長度和任務組合下;上線前必須用自己的 prompt 分佈測試。第二,KV cache 策略會改變錯誤模式:有些方法在普通問答上無感,但在多跳引用、長代碼定位、審計型問答中可能刪掉關鍵證據。
5. 長輸出:讀得長不等於寫得長
LongWriter 指出,一個模型即使能讀 100K token,也可能難以穩定生成超過 2000 words 的輸出,因為 SFT 數據中缺少長輸出樣本。它用 AgentWrite 構造長寫作數據,並提出 LongBench-Write。LongWriter-Zero 在 2025 年 6 月提交、2026 年 4 月修訂,轉向強化學習:不用人工或合成長篇標註數據,從 base model 出發,用獎勵模型鼓勵長度控制、寫作質量和結構格式。論文聲稱其 Qwen2.5-32B 訓練版本在 WritingBench、Arena-Write 等長寫作任務上優於傳統 SFT 方法;具體榜單結論需隨論文版本和榜單狀態人工複核。
這條線對博客、報告、代碼遷移和長文檔生成很重要:長上下文應用不是隻有“讀入”,還包括“規劃、分段、全局一致性、引用回填和後編輯”。
方法對比表
| 方向 | 代表工作 | 解決的問題 | 工程啟發 |
|---|---|---|---|
| 位置編碼擴展 | RoPE、YaRN、LongRoPE2 | 短訓長測、目標長度外推、短上下文保持 | 擴窗後必須回測短任務和真實業務任務 |
| 長上下文評測 | RULER、LongBench v2、NoLiMa | 標稱長度與可用長度不一致 | 用長度掃描、位置掃描和語義檢索測試替代單一 NIAH |
| 長上下文應用 | LOFT、ICR^2 | 長上下文是否替代 RAG / SQL / 檢索器 | 多數場景更適合“檢索 + 長上下文 + 引用校驗” |
| KV cache 系統 | RocketKV、FIER、Chelsea、ParisKV | 長輸入 / 長輸出推理成本高 | 以業務 prompt 分佈做 latency、顯存和準確率聯合評測 |
| 長輸出訓練 | LongWriter、LongWriter-Zero | 模型讀得長但寫不長 | 長文生成需要數據、獎勵、規劃與校驗閉環 |
關鍵技術趨勢
第一,評測會繼續去“模板化”。NIAH 仍適合作為煙測,但不再足夠。未來更有價值的是非字面證據定位、跨模態長上下文、代碼倉庫級修改、多輪會話記憶、帶干擾項的 RAG 和結構化數據問答。
第二,長上下文會與 reasoning-time compute 綁定。LongBench v2 中帶更長推理的模型表現更好,說明上下文長度和思考預算是相互耦合的。只給模型更多 token,但不允許它計劃、重讀、引用和校驗,效果會受限。
第三,系統優化會成為核心差異。百萬 token 的上下文不是“輸入參數”,而是顯存、帶寬、調度、緩存生命週期和計費策略的組合。上下文緩存、prefix cache、分塊 prefill、KV 量化、稀疏讀取和 CPU/GPU 分層存儲會成為服務框架的關鍵能力。
第四,長上下文不會消滅 RAG。更可能出現三類架構:小上下文精檢索、長上下文粗讀全局材料、Agent 在兩者之間迭代。對於審計、合規、金融、醫療和科研檢索,可追溯引用仍比“模型內部記住了”更重要。
工程落地啟發
- 不要用上下文窗口長度選模型。至少要做四組測試:證據位置掃描、干擾項強度掃描、任務長度掃描、輸出長度掃描。
- 對生產 RAG,不要把 top-k 無限制擴大。更穩的方案是“檢索召回 + rerank + 分組摘要 + 關鍵原文片段 + 長上下文複核”。
- 對代碼倉庫任務,長上下文適合給全局結構、依賴圖和關鍵文件片段,不適合把整個倉庫一次性塞入然後期待完美編輯。
- 對長報告生成,要把輸出拆成計劃、章節草稿、引用校驗、全局一致性檢查和最終潤色;不要一次 prompt 生成最終稿。
- 對服務成本,要單獨記錄 prefill latency、decode latency、KV cache 峰值、cache 命中率、每請求 token 成本,而不是隻記錄總延遲。
侷限與爭議
第一,很多論文的長上下文實驗仍以英文、合成任務或少數開放模型為主,對中文長文檔、跨語言資料、表格 PDF、真實企業知識庫的外推有限。第二,商業模型上下文窗口、價格和限流變化很快,本文對模型規格只作為 2026-06-24 檢索時的版本化記錄。第三,長上下文評測容易被 prompt 策略影響:是否允許思維鏈、是否允許分步檢索、是否提供文件名和目錄結構,都會改變結果。第四,KV cache 壓縮方法的“精度無損”通常是統計意義或 benchmark 意義,不能默認適用於高風險問答。
接下來值得關注的問題
最值得跟蹤的不是誰發佈了更長窗口,而是以下問題:模型是否能在 512K 到 1M 範圍內保持多跳推理穩定性?長上下文與工具調用、代碼執行、外部數據庫之間如何分工?能否建立更強的可審計引用機制,讓模型回答中的每個結論都回指上下文片段?服務框架能否在不犧牲關鍵證據的前提下自動壓縮 KV cache?長輸出訓練能否從寫作擴展到長代碼遷移、長實驗報告和複雜 agent 軌跡復盤?
總結
Long Context LLM 的研究已經越過“能不能裝下”的階段。真正的問題是:裝進去之後,模型能不能穩定檢索、推理、生成、引用和自我校驗;系統能不能以可接受成本完成這些動作;評測能不能暴露真實失敗模式。對研究者來說,長上下文提供了新的模型能力邊界問題;對工程團隊來說,它更像一組系統設計約束。下一階段的勝負不在最大 token 數,而在有效上下文利用率。
參考資料
檢索日期均為 2026-06-24。
- Ning Shang et al., “LongRoPE2: Near-Lossless LLM Context Window Scaling”, arXiv, 2025-02-27. https://arxiv.org/abs/2502.20082
- Yushi Bai et al., “LongBench v2: Towards Deeper Understanding and Reasoning on Realistic Long-context Multitasks”, arXiv, v2 revised 2025-01-03. https://arxiv.org/abs/2412.15204
- Ali Modarressi et al., “NoLiMa: Long-Context Evaluation Beyond Literal Matching”, arXiv, v3 revised 2025-07-09. https://arxiv.org/abs/2502.05167
- Payman Behnam et al., “RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression”, arXiv, 2025-02-19. https://arxiv.org/abs/2502.14051
- Yuhao Wu et al., “LongWriter-Zero: Mastering Ultra-Long Text Generation via Reinforcement Learning”, arXiv, v3 revised 2026-04-08. https://arxiv.org/abs/2506.18841
- Yifu Qiu et al., “Eliciting In-context Retrieval and Reasoning for Long-context Large Language Models”, arXiv, v3 revised 2025-06-09. https://arxiv.org/abs/2501.08248
- Jinhyuk Lee et al., “Can Long-Context Language Models Subsume Retrieval, RAG, SQL, and More?”, arXiv, 2024-06-19. https://arxiv.org/abs/2406.13121
- Cheng-Ping Hsieh et al., “RULER: What’s the Real Context Size of Your Long-Context Language Models?”, arXiv, 2024. https://arxiv.org/abs/2404.06654
- Nelson F. Liu et al., “Lost in the Middle: How Language Models Use Long Contexts”, arXiv / TACL, 2023. https://arxiv.org/abs/2307.03172
- Jianlin Su et al., “RoFormer: Enhanced Transformer with Rotary Position Embedding”, arXiv, 2021; revised 2023. https://arxiv.org/abs/2104.09864
- Bowen Peng et al., “YaRN: Efficient Context Window Extension of Large Language Models”, arXiv, 2023. https://arxiv.org/abs/2309.00071
- Yukang Chen et al., “LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models”, arXiv, 2023. https://arxiv.org/abs/2309.12307
- Google AI for Developers, “Gemini API Models”, last updated 2026-06-15 UTC. https://ai.google.dev/gemini-api/docs/models
- Meta Llama, “Llama 4 Model Cards and Prompt Formats”. https://www.llama.com/docs/model-cards-and-prompt-formats/llama4/
- Anthropic, “Claude models overview”, accessed 2026-06-24. https://platform.claude.com/docs/en/about-claude/models/overview
- OpenAI Developers, “GPT-5.4 Model”, accessed 2026-06-24. https://developers.openai.com/api/docs/models/gpt-5.4