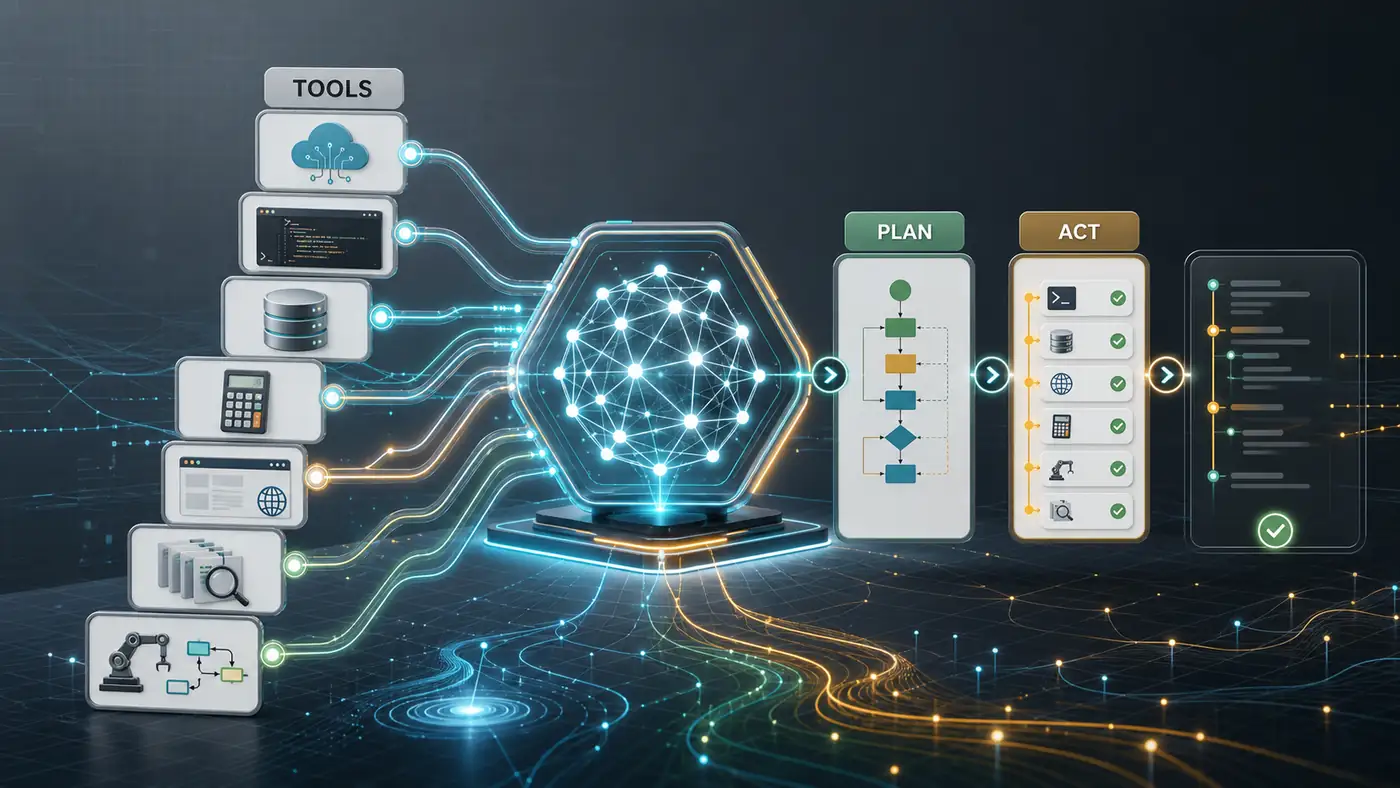
日期:2026-06-23
適合讀者:研究生、LLM/Agent 方向研究者、正在建設工具調用系統的工程讀者
摘要
過去一年,Tool Learning 的主線從“讓模型會調用函數”推進到“讓模型在多輪環境中穩定完成任務”。早期工作關心 API 選擇、參數填充和格式正確性;近一年的重點轉向交互狀態、用戶協作、長上下文工具說明、動態工具集合、RL 訓練以及安全邊界。本文按研究路線梳理代表論文與 benchmark:經典基礎包括 ReAct、Toolformer、API-Bank、Gorilla、ToolLLM;近一年重點包括 BFCL V4、ToolSandbox、tau^2-Bench、ASTRA-bench、ComplexFuncBench、ACEBench、RAGEN、EGPO/RC-GRPO、EigenData 和 MCP 安全相關研究。工程結論很直接:工具調用不是一個“prompt 技巧”,而是一套可評測、可審計、可回滾的分佈式系統接口。
目錄
- 研究背景:工具調用為什麼重新變成核心問題
- 近一年路線圖:從 schema matching 到交互式 agent
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 參考資料
研究背景:工具調用為什麼重新變成核心問題
LLM 本身擅長語言建模,但真實應用往往需要外部能力:查數據庫、調用業務 API、寫入工單、跑代碼、檢索文件、瀏覽網頁、操作 UI。工具調用把“回答問題”改寫成“選擇工具、生成參數、執行動作、讀取結果、繼續決策”的閉環。OpenAI 的 function calling / tools 文檔也把函數、內置工具、遠程 MCP、tool search 放在同一套工具語義下:模型生成 tool call,應用執行並返回 tool output,然後模型再繼續生成回覆或下一步調用。
這帶來兩個研究難點。第一,語言模型輸出不再只是自然語言,而是具備副作用的結構化動作;任何參數錯誤都可能導致真實系統狀態改變。第二,agent 的成功不只取決於單次調用是否正確,還取決於多輪狀態追蹤、錯誤恢復、用戶澄清、權限控制和執行環境。也就是說,Tool Learning 的問題邊界正在從 NLP benchmark 向軟件工程系統擴展。
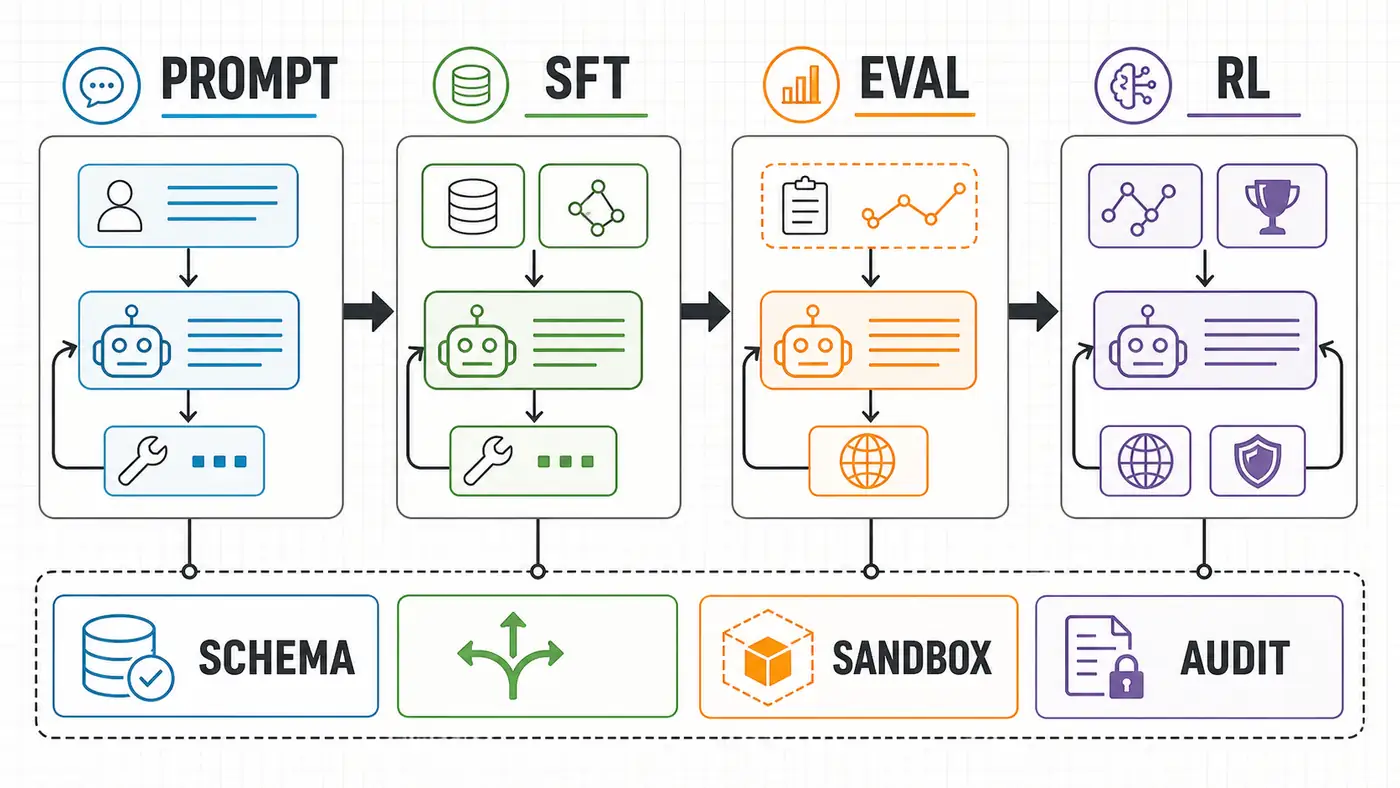
近一年路線圖
階段一:Prompt / ReAct 式工具使用。 ReAct 將 reasoning trace 與 action 交替生成,讓模型一邊推理一邊調用外部環境。它的重要性不在於某個固定 prompt 模板,而在於把“思考”和“行動”編排成軌跡。對今天的 agent 系統來說,ReAct 仍是最常見的執行循環原型:計劃、調用、觀察、修正。
階段二:監督式工具學習。 Toolformer 用少量示例和自監督篩選訓練模型決定何時調用 API、傳什麼參數、如何利用結果。API-Bank、Gorilla、ToolLLM 則把研究焦點擴展到真實 API 集合、工具檢索、調用格式和訓練數據構造。這個階段的核心問題是:模型能否把自然語言意圖映射到正確工具和參數。
階段三:交互式與狀態化評測。 2024 到 2026 年的 benchmark 明顯不再滿足於單輪 JSON 是否匹配。ToolSandbox 引入 stateful tool execution、隱式狀態依賴和用戶模擬器;tau^2-Bench 把用戶也建模為會使用工具的參與方;ASTRA-bench 強調個人上下文、時間演化事件和複雜意圖;BFCL V4 的官方頁面也明確把方向擴展到 holistic agentic evaluation,並標註榜單最後更新為 2026-04-12。
階段四:RL 與過程獎勵。 近一年多篇論文把 tool calling 當作可強化學習的策略問題。RAGEN 關注多輪 agent RL 中的軌跡級訓練、探索和獎勵不穩定;EGPO 試圖用探索增強的 GRPO 訓練更魯棒的 function calling;RC-GRPO 用 reward-conditioned trajectory policy 提高多輪 tool calling 的組內探索多樣性;ToolPRM 則把結構化工具調用的 inference scaling 與過程獎勵模型結合。這裡的共同判斷是:只靠 SFT 學“標準答案軌跡”不足以覆蓋交互式環境中的失敗恢復。
代表論文分組解讀
1. 基礎範式:從語言生成到行動軌跡
ReAct 提供了最小可用的 agent 執行循環:模型顯式生成推理軌跡並穿插動作。它適合工具數量少、環境反饋清晰的任務;缺點是 prompt 暴露的中間推理不一定適合生產系統,也容易把“解釋性文本”與“可執行動作”混在一起。
Toolformer 的貢獻是把工具調用變成可學習的 token-level 行為:模型不僅要知道答案,還要判斷何時藉助計算器、搜索、翻譯、日曆等工具。它證明了工具使用可以通過數據篩選和訓練內化到模型中。但今天看,它的環境還比較理想化:工具集合固定、調用風險低、交互深度有限。
2. API 規模化:檢索、路由與參數生成
API-Bank 構造了可運行 API 環境和工具使用對話,提出規劃、檢索、調用等能力切分。Gorilla 強調大規模 API 連接和減少 API hallucination;ToolLLM / ToolBench 則推進到 16000+ 真實 API 的 instruction tuning 和評測。它們奠定了今天 function calling 模型訓練的三件套:工具說明語料、工具檢索器、調用軌跡數據。
工程上,這條路線提醒我們不要把所有工具一次性塞進上下文。官方工具文檔也強調初始暴露函數過多會增加 token 與選擇難度,建議用更小的初始工具集、明確 schema、嚴格模式,以及 tool search / allowed tools 等機制控制工具面。
3. Benchmark 遷移:從 AST 匹配到任務完成
BFCL 早期用 AST 評估函數調用正確性;V4 官方頁面把重點描述為從 tool use 到 agentic evaluation,覆蓋真實數據、週期更新、成本與延遲等維度。ToolSandbox 進一步強調狀態依賴和對話式 on-policy 評測;ACEBench 把普通、特殊、Agent 三類工具使用場景分開,分析不同錯誤類型;ComplexFuncBench 關注長上下文、多步約束和參數填充;IFEval-FC 則把參數描述中的格式指令作為評測對象,指出“參數值對了但格式沒嚴格遵守”也是生產故障。
這一轉變很關鍵:單步 schema accuracy 只能證明模型會“寫出一個函數調用”,不能證明它能在業務狀態變化、用戶補充信息、權限限制和工具失敗時完成任務。
4. 交互式 agent:用戶不再是被動輸入框
tau^2-Bench 的 dual-control 設計非常有代表性:在真實客服、IT 支持、運營系統裡,用戶不是隻回答問題,也可能自己修改系統狀態。agent 必須協調用戶動作與工具動作,解釋下一步,避免因為狀態競爭而失敗。ASTRA-bench 則把個人上下文、長期事件和複雜引用放進評測,讓工具調用進入“私人助理”場景。
這類 benchmark 對工程架構的啟發是:agent memory、用戶確認、狀態鎖、事務邊界、觀察刷新,比單個模型的 function-call 準確率同樣重要。
5. RL 工具策略:讓模型學會探索與恢復
SFT 往往復制訓練軌跡,適合穩定 API 和單輪任務;但多輪工具環境會出現 sparse reward、錯誤傳播和探索成本高的問題。RAGEN 把多輪 agent RL 的不穩定性作為研究對象,指出缺少細粒度、reasoning-aware 獎勵時,模型可能學到淺層策略。EGPO、RC-GRPO、R2IF 等工作都在嘗試把 GRPO 類訓練遷移到 function calling:有的改 advantage,有的控制軌跡質量,有的把推理過程與調用決策對齊。
這些結果仍需謹慎看待:許多論文報告的 benchmark 提升依賴特定模型、數據和評測實現;是否能泛化到真實業務 API,仍然需要復現實驗和線上 A/B 驗證。本文不把論文聲稱的 SOTA 排名作為穩定事實,相關數字建議以論文版本與 leaderboard 當前頁面再次核對。
方法對比表
| 路線 | 代表工作 | 主要解決什麼 | 工程啟發 |
|---|---|---|---|
| Prompt / ReAct | ReAct | 讓推理與動作交替發生 | 適合原型;生產中要分離可執行動作與解釋文本 |
| 自監督工具學習 | Toolformer | 學會何時調用工具及如何利用結果 | 可用少量 seed demonstrations 擴展訓練數據 |
| API 檢索與 SFT | API-Bank, Gorilla, ToolLLM | 大規模工具選擇、參數生成、API 幻覺 | 工具說明質量和檢索召回決定上限 |
| Function calling benchmark | BFCL, ACEBench, ComplexFuncBench, IFEval-FC | 結構化調用、格式、長上下文、多步約束 | 不只評估 exact match,也要評估執行後狀態 |
| Stateful / conversational eval | ToolSandbox, tau^2-Bench, ASTRA-bench | 狀態依賴、用戶協作、個人上下文 | 需要事務、回滾、用戶確認和審計日誌 |
| RL tool policy | RAGEN, EGPO, RC-GRPO, ToolPRM | 多輪探索、稀疏獎勵、過程監督 | 獎勵設計與環境模擬比算法名稱更重要 |
關鍵技術趨勢
第一,工具 schema 正在從“文檔”變成“控制面”。函數名、參數枚舉、required 字段、additionalProperties、嚴格模式、參數描述中的格式要求,都會直接影響模型行為。好的 schema 應該讓非法狀態儘量不可表達,而不是期待模型憑常識補救。
第二,工具數量管理成為上下文工程問題。大量 API 會增加選擇混淆、token 成本和延遲。tool search、命名空間、分層路由、基於任務的 allowed tools、緩存工具列表,正在成為 agent runtime 的基礎能力。
第三,評測從離線答案轉向可執行環境。未來更有價值的 benchmark 會記錄數據庫狀態、環境變化、用戶模擬軌跡、失敗恢復過程,而不是隻看模型是否生成了參考 JSON。
第四,安全研究開始追上協議生態。MCP 讓工具接入更標準化,但也擴大了工具權限、提示注入、跨工具數據洩露和惡意 server 描述的風險。MCP Safety Audit 等論文提示我們:工具協議不是安全邊界,權限、隔離、審批和可觀測性才是。
工程落地啟發
- 把工具調用當作 RPC 系統設計。每個 tool 都需要 schema、冪等性說明、錯誤碼、權限模型、超時、重試和審計字段。
- 先做小工具集,再做動態發現。默認暴露少量高置信工具;長尾工具通過檢索或 tool search 延遲加載。
- 把“是否調用工具”納入評測。很多失敗不是參數錯,而是過度調用、漏調用、在信息不足時強行調用。
- 記錄完整軌跡,但不要無條件展示完整推理。生產系統可保存工具調用、觀察、狀態差異和用戶確認,不必把內部 chain-of-thought 作為用戶界面的一部分。
- 對有副作用工具使用事務邊界。寫操作前做權限校驗和用戶確認;失敗時支持補償或回滾;高風險動作進入人工審批。
- 建立本地 benchmark。公開榜單隻能提供方向,真正上線前要用自己的 API、數據分佈、權限約束和異常路徑構造任務集。
侷限與爭議
Tool Learning 目前最大的問題是評測碎片化。不同 benchmark 的工具集合、執行器、用戶模擬器和評分函數差異很大,榜單排名很難直接遷移到業務場景。第二個問題是合成數據質量:大規模工具軌跡容易覆蓋格式,卻未必覆蓋真實用戶的含糊表達、錯誤信息和狀態競爭。第三個問題是安全邊界:模型能生成正確 tool call,不代表它應該被授權執行該 call。
還有一個容易被忽視的爭議:RL 是否一定優於 SFT。對固定、低風險、強 schema 的工具,SFT 加嚴格校驗可能已經足夠;對長程、多輪、狀態變化明顯的環境,RL 或過程獎勵才更可能體現價值。工程上不應為了“agent RL”而增加訓練複雜度,先用可執行評測定位瓶頸更穩妥。
接下來值得關注的問題
第一,工具調用的 benchmark 會不會從“函數正確率”轉向“業務狀態正確率”。EigenData 對 BFCL-V3 的審計與修復工作已經指出 schema、實現和參考軌跡本身可能存在系統性錯誤,這類 benchmark hygiene 會越來越重要。
第二,動態工具生態如何做安全隔離。MCP、插件、遠程工具服務器讓能力發現更靈活,也讓供應鏈風險進入 agent 系統。如何定義最小權限、工具信譽、沙箱和跨工具數據流,是下一階段關鍵問題。
第三,小模型和端側 function calling 是否會成熟。Hammer、Granite Function Calling 等工作說明專門訓練的小模型有機會在局部任務上具備實用價值;但它們仍需要面對工具集合變化和複雜對話狀態。
第四,RL 工具策略如何與可解釋性結合。過程獎勵、軌跡過濾、reward-conditioned exploration 都在解決同一個矛盾:模型需要探索,但生產系統需要可控。誰能把訓練收益、可解釋調用和執行安全放在同一框架內,誰就更接近可部署 agent。
總結
Tool Learning 的研究重心已經從“模型會不會輸出函數調用”升級為“agent 能不能在真實工具環境中穩定完成任務”。過去一年最值得關注的不是某個單點 SOTA,而是範式變化:工具面要被檢索和治理,調用軌跡要被執行和審計,評測要覆蓋狀態與用戶協作,訓練要處理探索和失敗恢復。對工程團隊來說,最實用的策略是把 LLM 工具調用納入常規軟件工程紀律:小工具集、強 schema、可執行評測、沙箱權限、日誌審計和逐步放權。
參考資料
檢索日期:2026-06-23。
- Hu et al., “Agentic Tool Use in Large Language Models”, arXiv, 2026-04-01. https://arxiv.org/abs/2604.00835
- Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models”, arXiv / ICLR camera ready, 2022-2023. https://arxiv.org/abs/2210.03629
- Schick et al., “Toolformer: Language Models Can Teach Themselves to Use Tools”, arXiv, 2023-02-09. https://arxiv.org/abs/2302.04761
- Li et al., “API-Bank: A Comprehensive Benchmark for Tool-Augmented LLMs”, arXiv / EMNLP 2023. https://arxiv.org/abs/2304.08244
- Patil et al., “Gorilla: Large Language Model Connected with Massive APIs”, arXiv, 2023-05-24. https://arxiv.org/abs/2305.15334
- Qin et al., “ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs”, arXiv, 2023-07-31. https://arxiv.org/abs/2307.16789
- Berkeley Function Calling Leaderboard (BFCL) V4, official leaderboard, last updated 2026-04-12 on page. https://gorilla.cs.berkeley.edu/leaderboard.html
- Lu et al., “ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities”, arXiv, revised 2025-04-16. https://arxiv.org/abs/2408.04682
- Barres et al., “tau^2-Bench: Evaluating Conversational Agents in a Dual-Control Environment”, arXiv, 2025-06-09. https://arxiv.org/abs/2506.07982
- Xiu et al., “ASTRA-bench: Evaluating Tool-Use Agent Reasoning and Action Planning with Personal User Context”, arXiv, 2026-03-02. https://arxiv.org/abs/2603.01357
- Chen et al., “ACEBench: Who Wins the Match Point in Tool Usage?”, arXiv, 2025-01-22, revised 2025-11-20. https://arxiv.org/abs/2501.12851
- Zhong et al., “ComplexFuncBench: Exploring Multi-Step and Constrained Function Calling under Long-Context Scenario”, arXiv, 2025-01-17. https://arxiv.org/abs/2501.10132
- Wang et al., “RAGEN: Understanding Self-Evolution in LLM Agents via Multi-Turn Reinforcement Learning”, arXiv, 2025-04-24. https://arxiv.org/abs/2504.20073
- Hao et al., “Reasoning through Exploration: A Reinforcement Learning Framework for Robust Function Calling”, arXiv, submitted 2025-08-07, revised 2025-10-10. https://arxiv.org/abs/2508.05118
- Zhong et al., “RC-GRPO: Reward-Conditioned Group Relative Policy Optimization for Multi-Turn Tool Calling Agents”, arXiv, 2026-02-03. https://arxiv.org/abs/2602.03025
- Chen et al., “EigenData: A Self-Evolving Multi-Agent Platform for Function-Calling Data Synthesis, Auditing, and Repair”, arXiv, 2026-03-05. https://arxiv.org/abs/2603.05553
- Rabinovich and Anaby-Tavor, “On the Robustness of Agentic Function Calling”, arXiv, 2025-04-01. https://arxiv.org/abs/2504.00914
- “Function calling”, OpenAI API documentation, accessed 2026-06-23. https://developers.openai.com/api/docs/guides/function-calling
- “Using tools”, OpenAI API documentation, accessed 2026-06-23. https://developers.openai.com/api/docs/guides/tools
- “MCP Safety Audit: LLMs with the Model Context Protocol Allow Major Security Exploits”, arXiv, 2025-04-04. https://arxiv.org/abs/2504.03767