- 日期:2026-06-23
- 適合讀者:研究生、科研讀者、LLM 應用工程師、知識庫與搜索系統開發者
- 檢索範圍:重點覆蓋 2025-06 至 2026-06 公開論文與項目資料;為保持脈絡,保留 2020-2024 的必要基礎工作。
摘要
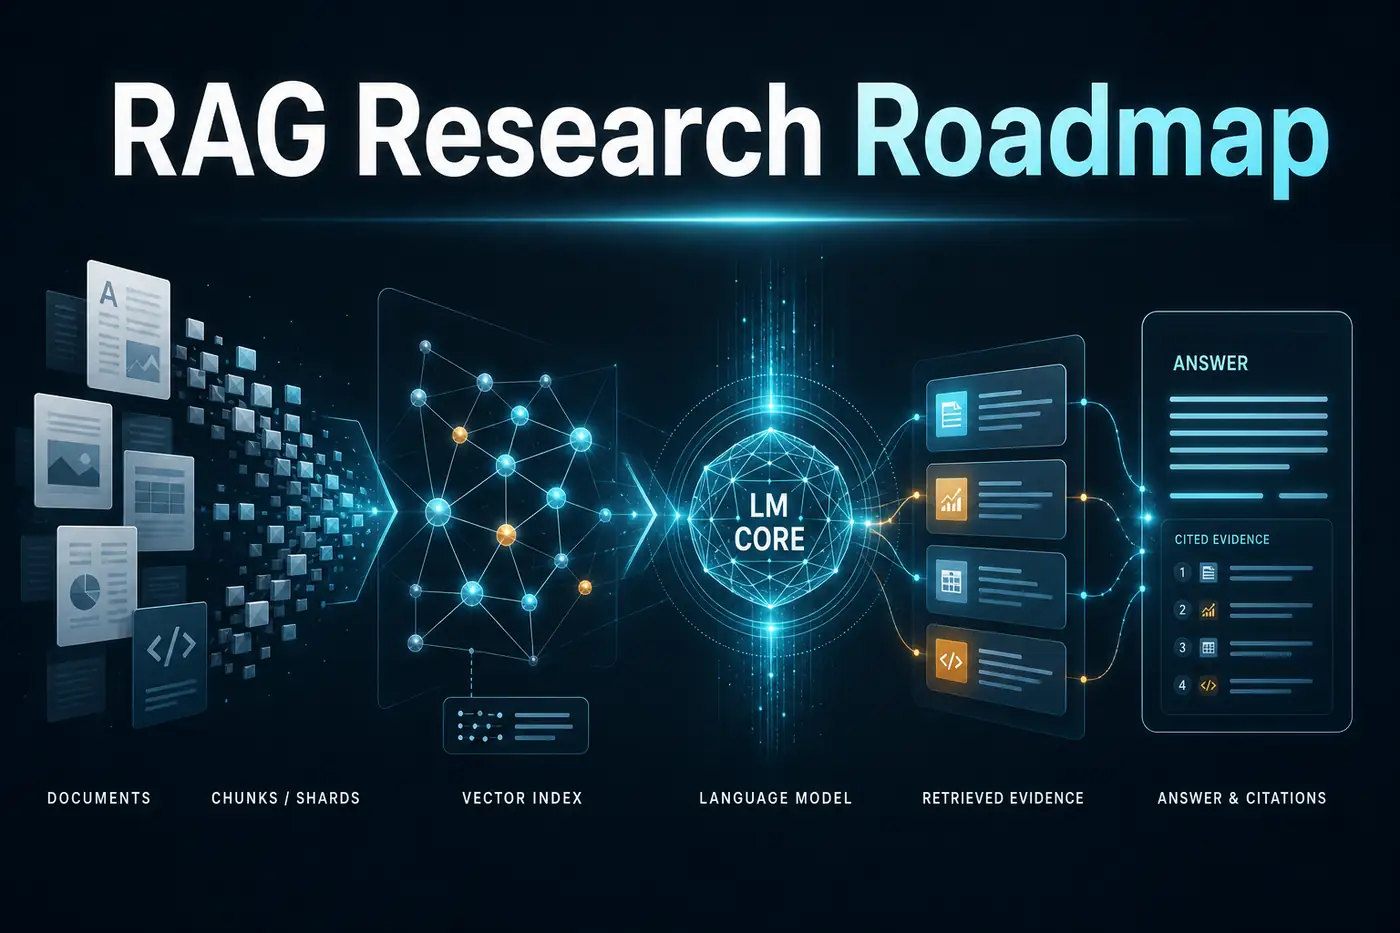
過去一年,RAG(Retrieval-Augmented Generation)的研究重點正在從“把相關文檔塞進上下文”轉向“構建可診斷、可組合、能推理的知識系統”。早期 RAG 關心檢索器和生成器如何聯合工作;2024 年之後,GraphRAG、LightRAG、RAPTOR、Self-RAG、CRAG 等工作把問題拆成了結構化索引、查詢改寫、遞歸摘要、自我反思與錯誤修正。到 2025-2026 年,論文重心繼續外擴:表格和多源文檔的結構化檢索、SQL 與工具調用式檢索、面向複雜任務的推理式搜索、細粒度評測,以及在長上下文模型時代重新定義“什麼時候需要檢索”。
本文不做榜單式 SOTA 羅列,而是按路線拆解 RAG 的研究脈絡:檢索前處理、索引組織、迭代推理、生成後校驗、評測與安全。工程上的核心啟發是:RAG 已經不是一個向量數據庫加提示詞模板,而是一套“查詢規劃 + 證據管理 + 上下文預算 + 結果歸因 + 失敗診斷”的系統工程。
目錄
- 研究背景:RAG 為什麼還沒有被長上下文替代
- 近一年路線圖:五條主線
- 代表論文分組解讀
- 方法對比表
- 關鍵技術趨勢
- 工程落地啟發
- 侷限與爭議
- 接下來值得關注的問題
- 參考資料
研究背景:RAG 為什麼還沒有被長上下文替代
RAG 的經典定義來自 2020 年 Lewis 等人的論文:模型在生成答案前檢索外部知識,以減少純參數記憶帶來的過時和幻覺問題。今天的大模型上下文窗口已經明顯變長,但 RAG 沒有消失,原因主要有三點。
第一,長上下文解決的是“能放進去”,不等於“能用好”。研究和工程實踐都反覆顯示,模型在長文檔中的定位、跨段證據聚合、衝突證據處理上仍會出錯。RAG 通過檢索、重排、摘要、引用和校驗,把原本隱式的注意力分配變成顯式管線。
第二,企業知識庫不是一篇長文檔,而是持續變化的異構系統:PDF、網頁、表格、數據庫、代碼倉庫、工單、郵件、API 文檔同時存在。直接拼上下文既昂貴,也難以保證權限、版本和可追溯性。
第三,可靠 AI 應用需要診斷面。用戶問錯、檢索召回錯、切塊錯、重排錯、生成器誤讀證據,都會造成錯誤答案。沒有 RAG 管線,就很難定位失敗發生在哪一層。
因此,近一年的 RAG 研究不是被長上下文吞併,而是轉向與長上下文、工具調用、知識圖譜和評測框架協同。
近一年路線圖:五條主線
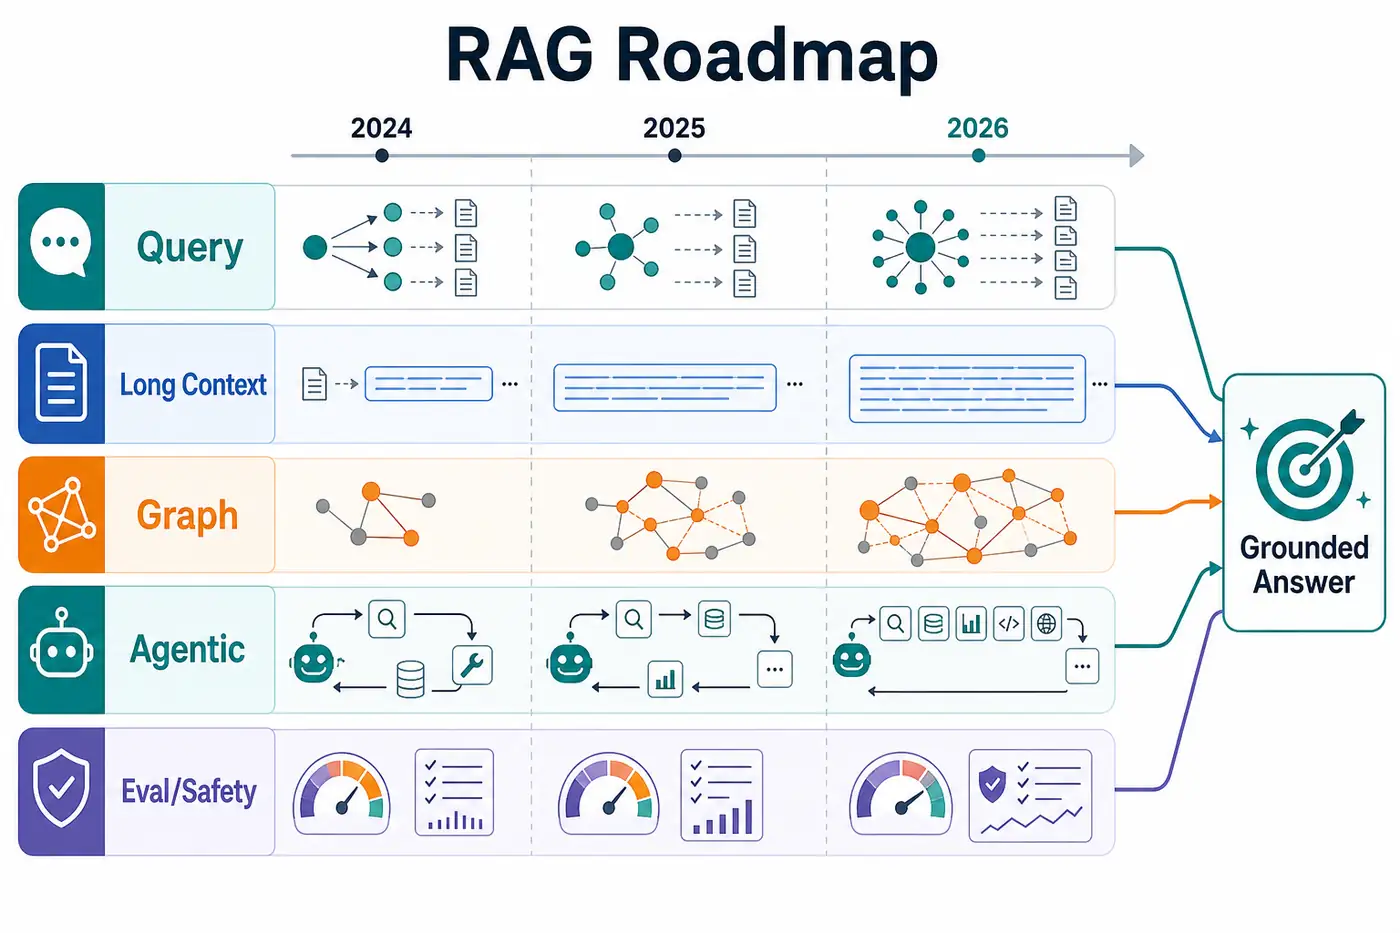
1. 從向量召回到查詢規劃
傳統 RAG 把用戶問題編碼後做向量相似度檢索。新工作更關心“檢索前應該問什麼”。RAG-Fusion 使用多查詢和倒排融合緩解單一查詢表達不足;Self-RAG 讓模型學習何時檢索、何時批判生成內容;CRAG 引入檢索評估器,在檢索質量不夠時觸發糾錯和補充搜索。到 2025 年之後,ReSearch 一類工作把搜索過程進一步變成可學習的推理循環:模型不只拿文檔,而是圍繞中間結論繼續生成搜索請求。
工程啟發是:複雜業務問題不要只做一次 embedding search。至少需要查詢改寫、子問題拆解、召回融合和失敗回退策略。
2. 從平鋪切塊到層級與圖結構索引
RAPTOR 將文檔組織成樹形摘要結構,使系統能在不同粒度上檢索;GraphRAG 把文檔中的實體、關係和社區摘要組織成圖,強調全局問題的回答;LightRAG 則試圖用更輕量的圖結構和雙層檢索降低 GraphRAG 的成本。HippoRAG 借鑑海馬體記憶機制,把開放知識圖譜與個性化 PageRank 風格檢索結合,用於多跳問題。
這條線的共同點是反對“固定 chunk 是唯一索引單元”。當問題需要跨文檔聚合、比較和歸納時,文檔片段本身不夠,系統需要中間知識層:實體、關係、摘要節點、主題社區或時間線。
3. 從文本 RAG 到結構化數據 RAG
2025-2026 年值得關注的增量之一,是表格、數據庫和結構化文檔。2024 年的 TableRAG 討論百萬 token 表格理解中的 schema 與 cell retrieval;2025 年另一篇 TableRAG 進一步面向文本與表格混合文檔,使用查詢分解、文本檢索、SQL 編程與執行、中間答案組合來處理異構文檔推理。這裡不宜只把表格轉成 Markdown chunk,因為表格問題往往需要過濾、聚合、排序和連接操作。
工程上,結構化 RAG 應優先保留數據類型和操作語義:日期、金額、枚舉、主外鍵、列描述、聚合規則都應進入檢索和生成約束,而不只是作為自然語言片段。
4. 從一次生成到推理式搜索
複雜問題常常不是“找一段證據就回答”,而是需要多步推理:先識別缺口,再查資料,再修正假設。ReSearch 等工作把 search operation 作為 reasoning chain 的一部分,並用強化學習訓練模型在推理中決定何時搜索、如何搜索。與普通 agent 不同,RAG 場景中的 agentic 行為應圍繞證據鏈:每一次檢索都要說明為什麼查、查到什麼、是否足以支持下一步。
這也是 RAG 和 Tool Learning 的交叉地帶。檢索器不再只是工具之一,而成為模型推理過程中的外部記憶和事實檢查器。
5. 從整體分數到細粒度診斷
RAG 評測正在從“答案對不對”轉向“哪一層錯了”。RAGChecker 將 RAG 輸出拆成 claim 級別,區分檢索器是否找到足夠證據、生成器是否忠實使用證據、答案是否完整。CRAG、RAGChecker、TREC RAG Track 等工作也在推動更貼近真實檢索和答案生成的評測。
工程啟發是:只看最終準確率會掩蓋問題。生產系統至少要記錄 query、檢索候選、重排結果、上下文片段、引用來源、生成答案和用戶反饋,才能做可復現診斷。
代表論文分組解讀
基礎線:RAG、Self-RAG、CRAG
Lewis 等人的 RAG 論文奠定了“參數知識 + 非參數知識”的範式。Self-RAG 的貢獻在於把檢索和自我批判變成可學習行為,讓模型在需要時檢索並評估自身輸出。CRAG 則更工程化:如果檢索結果質量不足,系統應主動糾錯,而不是把低質量片段硬塞給生成器。
這類工作的價值不在於某個固定模塊,而在於提出了一個原則:RAG 系統必須知道自己什麼時候證據不足。
索引線:RAPTOR、GraphRAG、LightRAG、HippoRAG
RAPTOR 的樹形摘要適合長文檔和層級主題;GraphRAG 強調實體關係和社區摘要,適合“全局概覽”“跨文檔歸因”類問題;LightRAG 試圖減少圖構建與檢索成本;HippoRAG 更偏認知啟發和多跳檢索。它們說明,RAG 的核心瓶頸往往不是向量庫性能,而是知識組織形式是否匹配問題類型。
對工程團隊來說,可以按問題類型選索引:FAQ 與事實查找用 dense + sparse 混合檢索即可;制度、合同、論文綜述可加入層級摘要;跨業務實體、供應鏈、項目依賴等問題更適合圖結構。
長上下文線:LongRAG 與上下文預算
LongRAG 等工作提出一個現實問題:既然模型上下文變長,是否可以少切塊、多放上下文?答案不是簡單的“是”。更長的上下文降低了切塊導致的信息斷裂,但增加了成本和注意力噪聲。合理策略是把 RAG 看成上下文預算管理:先用檢索確定候選,再用長上下文容納更完整的局部證據,而不是盲目擴大 top-k。
結構化線:TableRAG 與 SQL 化檢索
表格 RAG 的難點是答案經常依賴計算,而不只是語義相似。TableRAG 系列工作反映出一個趨勢:RAG 正在從“文本搜索增強生成”擴展成“數據訪問增強推理”。其中 2025 年 TableRAG 論文頁面顯示其版本在 2025-09-30 修訂,並標註 accepted by EMNLP 2025;具體 benchmark 數字建議讀者以論文與倉庫為準,本文不轉述未經複核的實驗數值。
評測線:RAGChecker、TREC RAG Track
RAGChecker 的 claim-level 診斷值得工程系統借鑑:不要只問最終答案是否正確,還要問每個事實斷言是否有證據支持。TREC RAG Track 則體現了評測社區對真實檢索場景的持續關注。對於企業系統,評測集應包含領域內高頻問題、長尾問題、過期文檔問題、權限邊界問題和衝突證據問題。
方法對比表
| 路線 | 代表工作 | 解決的問題 | 適合場景 | 工程代價 |
|---|---|---|---|---|
| 多查詢 / 查詢改寫 | RAG-Fusion、Self-RAG | 用戶問題表達不足、召回不穩 | 開放問答、客服知識庫 | 中等,需要重排與去重 |
| 糾錯式 RAG | CRAG | 檢索結果質量差仍被生成器誤用 | 高風險問答、事實核驗 | 中等,需要檢索質量評估器 |
| 層級摘要 | RAPTOR | 長文檔跨層級信息聚合 | 論文、報告、政策文檔 | 中高,需要離線摘要構建 |
| 圖 RAG | GraphRAG、LightRAG、HippoRAG | 跨實體、跨文檔、多跳關係 | 企業知識圖譜、綜述、調查分析 | 高,需要抽取、消歧、圖維護 |
| 長上下文 RAG | LongRAG | chunk 斷裂和上下文不足 | 長報告、代碼倉庫、法律材料 | 中高,推理成本上升 |
| 結構化 RAG | TableRAG | 表格過濾、聚合、SQL 訪問 | BI、金融、科研數據問答 | 高,需要 schema 與權限治理 |
| 細粒度評測 | RAGChecker、TREC RAG Track | 無法定位 RAG 失敗層 | 生產監控、模型迭代 | 中高,需要日誌和標註體系 |
關鍵技術趨勢
第一,RAG 的邊界正在擴大。檢索對象不再只是文本 chunk,而是實體、關係、表格、SQL 查詢結果、網頁、工具返回值和歷史交互記憶。
第二,索引會越來越任務化。同一批文檔可以同時擁有向量索引、關鍵詞索引、層級摘要索引和圖索引,運行時按問題選擇組合。
第三,評測會從離線準確率走向在線診斷。真正有價值的指標包括:證據召回率、引用忠實度、無答案拒答率、過期知識識別率、權限違規率、延遲和成本。
第四,長上下文不會替代 RAG,而會改變 RAG 的最佳實踐。過去工程師需要切得很碎以適配窗口;未來更重要的是“少而準地檢索,再給模型完整證據”。
第五,agentic RAG 會成為複雜任務入口,但必須剋制。每多一次檢索和工具調用,系統就多一個失敗點。沒有可觀測性和預算控制的 agentic RAG,很容易變成慢且不可靠的循環。
工程落地啟發
先建立失敗分類,再選論文方法。很多團隊直接上 GraphRAG,但真實瓶頸可能只是 query rewrite 或 metadata filter 沒做好。
混合檢索仍然是強基線。dense retrieval 對語義相似友好,BM25 對術語、編號、代碼、法律條款更穩。沒有強理由時,不要只依賴一種召回。
chunk 策略要和引用策略一起設計。若最終答案需要可點擊引用,chunk 不能只為 embedding 效果服務,還要保留章節、頁碼、表格行列和版本信息。
圖 RAG 適合“關係密集型問題”,不適合所有知識庫。若文檔中的實體關係抽取質量不穩定,圖會放大噪聲。
表格和數據庫場景應儘量走結構化查詢。把 CSV 或 SQL 錶轉成文本再向量化,通常會丟失類型、約束和聚合語義。
評測集要包含“檢索不到”的問題。可靠系統不只會回答,還要會拒答、追問和標註證據不足。
生產日誌必須能回放。至少保存用戶問題、改寫後的查詢、召回文檔 ID、重排分數、進入上下文的片段、模型答案、引用和最終反饋。
侷限與爭議
RAG 論文的最大爭議之一,是實驗設置與真實系統差距很大。許多論文在公開 QA 數據集上驗證,但企業知識庫中的文檔版本、權限、噪聲 OCR、重複內容和用戶模糊問題更復雜。另一個問題是成本:GraphRAG、層級摘要和 agentic RAG 往往需要離線構建、在線多輪調用和額外評測器,未必適合低延遲場景。
此外,RAG 並不能自動解決幻覺。若檢索證據錯誤、過時或被提示注入汙染,生成器仍可能給出看似有引用的錯誤答案。Prompt Injection 與 Agent Security 將是本系列安全專題重點討論的話題。
接下來值得關注的問題
- 長上下文模型下,RAG 的最優粒度會如何變化?
- 圖 RAG 的實體抽取、消歧和增量更新能否形成穩定工程範式?
- 評測能否從 answer-level 走向 claim-level、source-level 和 workflow-level?
- Agentic RAG 如何設置調用預算、停止條件和安全邊界?
- 多模態 RAG 如何處理圖片、表格、視頻和版面結構?
- 企業知識庫中的權限控制和引用溯源如何與 RAG 管線深度結合?
總結
近一年 RAG 的主線不是“更大的向量庫”或“更多 top-k 文檔”,而是從單次檢索走向證據驅動的推理系統。基礎檢索仍然重要,但真正的差異開始來自索引結構、查詢規劃、工具化數據訪問、細粒度評測和安全治理。對工程團隊而言,最穩妥的路線是:先把混合檢索、引用、日誌和評測做紮實;再按問題複雜度逐步引入層級摘要、圖索引、結構化查詢和 agentic loop。RAG 的未來形態,更像一個帶記憶、帶審計、帶預算的研究助理,而不是一個簡單的提示詞模板。
參考資料
檢索日期:2026-06-23。以下鏈接優先選擇論文、官方項目頁、官方文檔或評測項目頁。預印本論文的機構、代碼狀態和實驗數字可能更新,使用前建議再次核對。
- Patrick Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, arXiv, 2020. https://arxiv.org/abs/2005.11401
- Akari Asai et al., “Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection”, arXiv / ICLR 2024. https://arxiv.org/abs/2310.11511
- Yanfei Yu et al., “Generate rather than Retrieve: Large Language Models are Strong Context Generators”, arXiv, 2022. https://arxiv.org/abs/2209.10063
- Shao Zhang et al., “Corrective Retrieval Augmented Generation”, arXiv, 2024. https://arxiv.org/abs/2401.15884
- Parth Sarthi et al., “RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval”, arXiv, 2024. https://arxiv.org/abs/2401.18059
- Darren Edge et al., “From Local to Global: A Graph RAG Approach to Query-Focused Summarization”, arXiv, 2024. https://arxiv.org/abs/2404.16130
- Microsoft GraphRAG project documentation / repository. https://github.com/microsoft/graphrag
- Zihan Zhao et al., “LightRAG: Simple and Fast Retrieval-Augmented Generation”, arXiv, 2024. https://arxiv.org/abs/2410.05779
- HKUDS LightRAG repository. https://github.com/HKUDS/LightRAG
- Gabriele Gutierrez et al., “HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models”, arXiv, 2024. https://arxiv.org/abs/2405.14831
- Wei Liu et al., “LongRAG: Enhancing Retrieval-Augmented Generation with Long-context LLMs”, arXiv, 2024. https://arxiv.org/abs/2406.15319
- Yixuan Su et al., “RAG-Fusion: A New Take on Retrieval-Augmented Generation”, project / paper reference. https://github.com/Raudaschl/rag-fusion
- Xiang Chen et al., “RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation”, arXiv, 2024. https://arxiv.org/abs/2408.08067
- RAGChecker project repository. https://github.com/amazon-science/RAGChecker
- Luyu Gao et al., “Retrieval-Augmented Generation for Large Language Models: A Survey”, arXiv, 2023/2024. https://arxiv.org/abs/2312.10997
- Si-An Chen et al., “TableRAG: Million-Token Table Understanding with Language Models”, arXiv, 2024. https://arxiv.org/abs/2410.04739
- Xiaohan Yu et al., “TableRAG: A Retrieval Augmented Generation Framework for Heterogeneous Document Reasoning”, arXiv, 2025. https://arxiv.org/abs/2506.10380
- Jinheon Baek et al., “Knowledge-Augmented Language Model Prompting for Zero-Shot Knowledge Graph Question Answering”, arXiv, 2023. https://arxiv.org/abs/2306.04136
- Mingyang Chen et al., “ReSearch: Learning to Reason with Search for LLMs via Reinforcement Learning”, arXiv, 2025. https://arxiv.org/abs/2503.19470
- TREC RAG Track official page, NIST. https://trec-rag.github.io/
- LangChain RAG tutorial documentation. https://python.langchain.com/docs/tutorials/rag/
- LlamaIndex documentation. https://docs.llamaindex.ai/
- OpenAI File Search tool documentation. https://platform.openai.com/docs/guides/tools-file-search