日期:2026-07-15
適合讀者:機器學習、NLP、AI safety、可解釋性和深度學習系統方向研究生;關注模型內部機制與可靠評測的工程讀者
檢索日期:2026-07-15
摘要
Mechanistic Interpretability(機制解釋,以下簡稱 MI)關心的不是“模型給出的自然語言解釋是否像人話”,而是更硬的問題:一個訓練好的神經網絡內部,哪些激活、特徵、注意力頭、MLP 方向和跨層路徑實際導致了某個行為?如果我們刪除、替換或增強這些內部變量,模型行為是否按預期改變?
這篇文章把 2025-2026 年的 MI 進展拆成五條路線:早期 circuits 傳統如何把 Transformer 拆成可命名電路;activation patching、causal tracing 和自動電路發現如何驗證因果路徑;sparse autoencoder(SAE)、transcoder 和 dictionary learning 如何試圖把混疊表示分解成稀疏特徵;線性表示分析與 steering 如何連接“可解釋方向”和“可控生成”;以及 SAEBench、AxBench、Neuronpedia、Gemma Scope 等新基礎設施如何暴露評測難題。本文不會把“解釋看起來合理”當成結論,重點是哪些證據能支持“這個解釋是因果忠實的”。
目錄
- 研究背景:為什麼 MI 在大模型時代更難也更重要
- 核心科學問題
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:為什麼 MI 在大模型時代更難也更重要
可解釋 AI 很早就有 saliency map、attention visualization、probe、feature attribution 等方法。但 MI 的野心更接近“逆向工程”:找到模型內部實際執行計算的結構。經典脈絡可以從 Transformer Circuits 系列讀起:Anthropic/OpenAI 研究者在《A Mathematical Framework for Transformer Circuits》中把 attention head、residual stream、MLP 寫成可分析的計算組件;隨後 induction head 工作展示了 Transformer 如何通過特定注意力頭實現上下文內複製和模式續寫;toy model of superposition 則解釋了為什麼神經網絡會把多個語義特徵壓進同一組神經元或方向裡。
大模型讓這個問題變得更緊迫。模型越強,越可能在醫學、代碼、科學推理和 agent 場景中被委託更高風險任務;但模型內部表示也更分佈式、更上下文依賴、更難靠單個 neuron 解釋。2023 年的《Towards Monosemanticity》把 dictionary learning 引入小型 Transformer,嘗試從激活中學習“更單義”的稀疏特徵;2024 年 Anthropic 在 Claude 3 Sonnet 上擴展了這種路線,展示了可以在大模型中找到與概念、拒答、代碼、偏見、欺騙等行為相關的特徵。到 2025 年,《Circuit Tracing: Revealing Computational Graphs in Language Models》和 Anthropic 的《On the Biology of a Large Language Model》把焦點進一步推向“從特徵到計算圖”:不僅要找出單個特徵,還要描述特徵之間如何通過模型權重和激活形成因果鏈。
核心科學問題
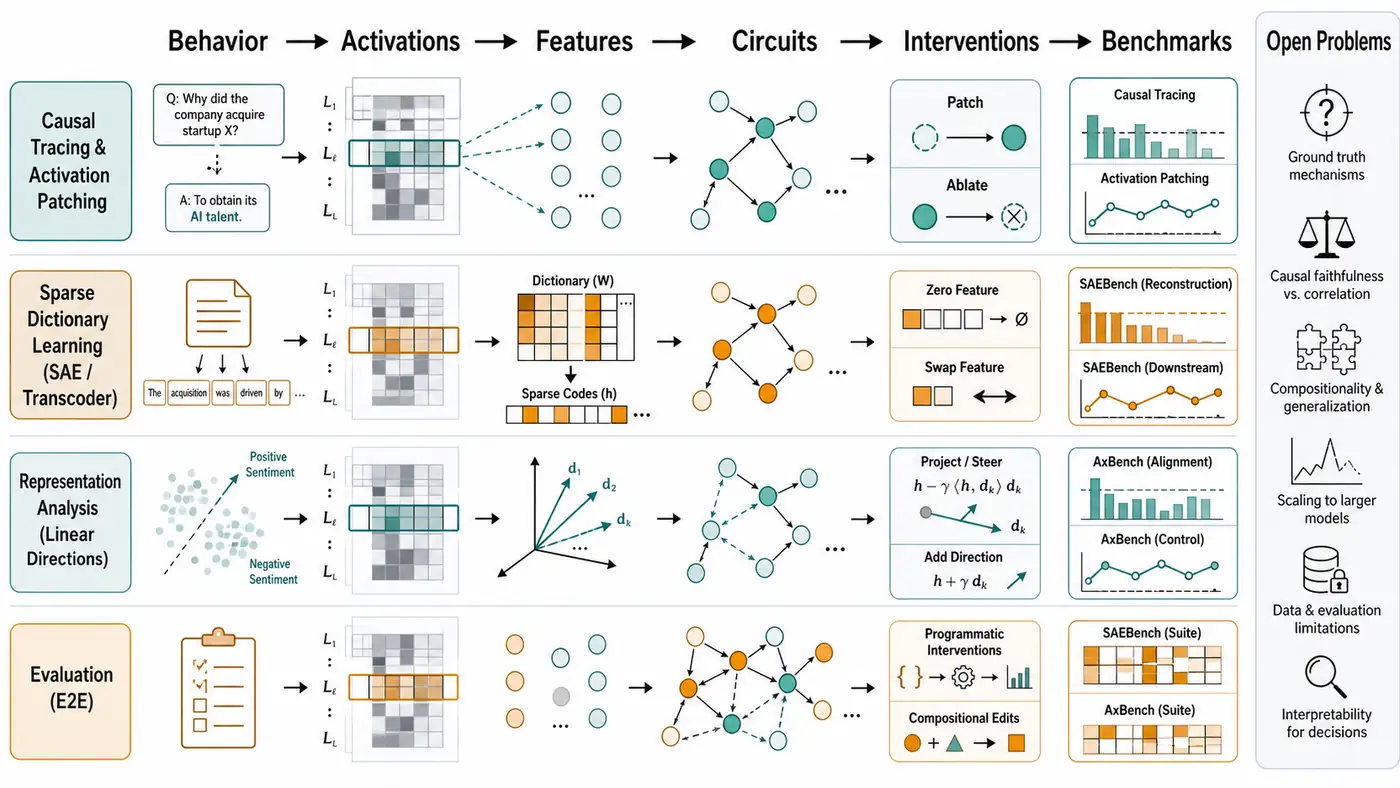
第一,什麼算“機制”?一個 attention head 關注某些 token,一個 SAE feature 對某類文本激活,一個 probe 可以線性讀出實體屬性,這些都只是相關性證據。MI 更強的目標是:如果把這個內部變量 patch、ablate、clamp 或 steer,輸出行為會按機制假設改變。機制應當能支持反事實幹預。
第二,表示是否可分解?superposition 觀點認為,神經網絡常把超過維度數量的特徵壓進有限表示空間。單個 neuron 不一定對應單個概念,單個概念也可能分散在多個方向。SAE 的承諾是把激活分解為稀疏 feature codes,但 SAE 學到的 feature 是否穩定、是否真正對應模型使用的因果變量,仍然需要 benchmark 和干預驗證。
第三,電路如何跨層組合?早期 induction head 很適合做教學樣例,因為路徑相對短、功能相對明確。真實 LLM 行為往往涉及多層 residual stream、MLP 讀寫、attention routing、token position、上下文條件和解碼策略。一個解釋若只定位到“某層某頭重要”,還遠不能說明完整計算。
第四,解釋如何評測?自然語言解釋容易讓人產生理解錯覺。MI 評測需要回答:解釋能否預測 unseen prompts 上的行為?能否通過干預改變行為?能否壓縮模型行為而保留關鍵輸出?能否定位失敗案例?SAEBench 和 AxBench 這類新 benchmark 正是在試圖把“特徵好不好”轉化為可重複測量的問題。
近一年論文路線圖
1. 從特徵可視化到 circuit tracing。 2025 年的 circuit tracing 工作把 SAE/transcoder 特徵、局部替代模型和 attribution graph 結合起來,目標是給出語言模型內部從輸入 token 到輸出預測的計算圖。它的意義不只是“畫圖更好看”,而是把 feature-level 解釋推進到 graph-level 機制假設。需要注意的是,這類圖仍然依賴所選替代模型、閾值、歸因規則和人工解釋,不能自動等同於真實因果機制。
2. SAE 進入 benchmark 階段。 2024 年以後,SAE 從少量概念展示進入基礎設施化階段:Gemma Scope 發佈面向 Gemma 2 的開放 SAE 資源,Neuronpedia 提供特徵瀏覽、解釋、搜索和干預實驗界面;2025 年 SAEBench 提出系統評測套件,比較 reconstruction、sparsity、feature interpretability、downstream behavior 等維度。隨後一些論文開始質疑:SAE benchmark 是否可靠?隨機初始化或不充分訓練的模型上是否也能學到看似可解釋特徵?這些質疑把方向從“展示漂亮特徵”拉回到實驗設計。
3. Steering 與表示分析重新合流。 線性方向、activation steering、representation engineering 不是傳統 MI 的全部,但它們提供了一個強幹預接口:如果一個方向真的編碼某類屬性,那麼加減該方向應當可控地改變輸出。AxBench 這類評測把 steering、control 和 interpretability 放在一起比較,也讓研究者意識到:可控不等於可解釋,解釋也不一定帶來更好的控制。
4. 自動化和工具鏈成為研究對象。 TransformerLens、nnsight、Neuronpedia、SAELens、Circuit Tracer 等工具降低了實驗門檻。與此同時,自動電路發現、LLM 生成 neuron/feature 解釋、自動評分 explanation quality 也變得常見。工具越強,越需要警惕“自動解釋流水線”把相關性、可視化和自然語言描述包裝成過度確定的結論。
5. 2026 年的爭議集中在可遷移性和可靠性。 截至 2026-07-15,可見的新論文更多在追問:SAE 解釋能否跨模型、跨數據集、跨層穩定?benchmark 分數是否與人類理解一致?自動發現的 feature/circuit 是否真的有 causal faithfulness?這些問題比單個 feature demo 更適合成為研究生課題。
代表論文分組解讀
A. Transformer circuits:從組件分解到可命名電路
Transformer Circuits 的基礎工作把 Transformer 拆成 residual stream 中的信息讀寫。attention head 可以被看成把某些 token 的值向量寫入當前位置;MLP 可以被看成 key-value memory 或非線性特徵變換;不同層通過 residual stream 疊加信息。這個框架的價值在於它給了研究者一套“看模型內部計算”的語言。
Induction head 是這條線最著名的成功案例之一。模型在序列中看到 A ... B ... A 時,某些 head 會從前一個 A 後面的 token 複製信息,幫助預測第二個 A 後面的續寫。這類工作說明 MI 可以發現可複用機制,而不是隻做事後可視化。但 induction head 也提醒我們:能解釋一個簡潔機制,不代表能解釋所有複雜行為。
B. Causal tracing 與 activation patching:把解釋變成干預假設
Activation patching 的基本思想是:對同一個模型運行 clean prompt 和 corrupted prompt,把某層某位置的激活從 clean run 替換到 corrupted run,觀察輸出是否恢復。如果恢復,說明該激活攜帶了任務相關信息。Causal tracing、path patching、attribution patching、ACDC 等方法在不同粒度上擴展了這個想法:定位層、頭、MLP、路徑或子圖。
這類方法的優點是直接:它問的是“內部變量是否導致行為變化”。缺點也很現實。patching 結果依賴 prompt pair 設計、metric 選擇、干預粒度和是否引入 out-of-distribution 激活。一個組件被 patch 後有效,可能說明它參與機制,也可能只是它攜帶了可替代信息。好的論文通常會做多組 prompt、負對照、隨機對照、跨模型復現,並報告失敗樣例。
C. SAE、transcoder 與 dictionary learning:從 neuron 到 feature
SAE 把某層激活 x 編碼成稀疏向量 h,再從 h 重構 x。如果訓練成功,h 中的單個 feature 可能比原始 neuron 更單義:例如某個 feature 對括號、某類語言、代碼模式、拒答語氣或地名上下文強激活。Transcoder 則更進一步,嘗試學習從一層激活到後一層或某個模塊輸出的稀疏可解釋映射。
這條路線的強處是規模化:SAE 可以一次性產生大量候選特徵,支持搜索、瀏覽和人工標註。Neuronpedia 使這種探索更加工程化,Gemma Scope 則提供了開放模型上的 SAE 資源,方便不同團隊復現和比較。風險在於“feature naming”很容易過度解釋。一個 feature 的高激活樣例看起來像某個概念,不代表它只表示這個概念,也不代表模型在任務中實際使用它。
D. Circuit tracing:把特徵連成計算圖
2025 年 Anthropic 的 circuit tracing 路線試圖回答一個更難的問題:如果 SAE 給出的是局部 feature,那麼這些 feature 如何通過模型權重和激活相互影響,最終導致輸出?論文和技術報告使用 attribution graph 描述特徵之間的影響路徑,並在案例中分析模型對事實、推理、拒答等行為的內部計算。
它的重要性在於把 MI 從“特徵目錄學”推進到“機制圖譜學”。但讀這類結果要非常謹慎:圖中的邊來自歸因或局部近似,不等於完整因果證明;圖的可讀性受到閾值和篩選影響;人工解釋仍然參與很深。最穩妥的讀法是:把 circuit graph 當成可檢驗假設生成器,再用干預和外部任務驗證。
E. 表示方向、steering 與控制
表示分析常用線性 probe、PCA/CCA、logit lens、activation steering 等工具。它們能快速回答某層是否線性編碼某個屬性,也能通過加減方向改變模型輸出風格或事實傾向。Representation engineering 的一系列工作說明,在 LLM 內部存在可操作的方向,能影響誠實性、情感、拒答、毒性、偏好等行為。
這條線和 MI 的關係有張力。它提供了清晰的干預接口,但未必給出完整機制。一個 steering direction 有效,可能只是利用了模型的局部控制面板,而不是解釋了模型如何產生該行為。AxBench 等評測有價值,正是因為它把 steering success、control specificity 和 interpretability evidence 放到同一個實驗框架中比較。
方法對比表
| 路線 | 主要對象 | 典型證據 | 代表資源 / 論文 | 主要風險 |
|---|---|---|---|---|
| Transformer circuits | attention head、MLP、residual stream | 可命名電路、路徑分析、手工驗證 | Mathematical Framework, Induction Heads | 成功案例可能偏小,難擴展到複雜行為 |
| Activation patching / causal tracing | 層、位置、頭、路徑激活 | clean/corrupted 干預恢復行為 | Causal Tracing, ACDC, path patching | prompt pair 和 metric 選擇影響很大 |
| SAE / dictionary learning | 稀疏 feature、特徵字典 | 重構、稀疏性、高激活樣例、干預 | Towards Monosemanticity, Gemma Scope, SAEBench | feature 命名過度解釋,benchmark 尚不穩定 |
| Circuit tracing / attribution graph | feature 之間的計算圖 | feature graph、邊歸因、局部干預 | Circuit Tracing, On the Biology of a LLM | 圖結構依賴近似和閾值,未必完整因果 |
| 表示方向 / steering | 線性方向、probe、activation edit | 控制效果、屬性讀出、反事實編輯 | Representation Engineering, AxBench | 可控不等於可解釋,可能缺少機制閉環 |
實驗與 benchmark 如何看
讀 MI 論文時,不建議只看漂亮可視化或幾個 anecdote。至少要問七個問題。
第一,解釋的對象是什麼?是單個 neuron、SAE feature、attention head、MLP channel、residual direction,還是跨層 circuit?粒度不同,證據要求也不同。
第二,是否有因果乾預?僅展示高激活樣例或相關性曲線不夠。更強證據包括 ablation、patching、feature clamping、direction steering、path intervention,以及干預後對任務 metric 的影響。
第三,是否有負對照?例如隨機 feature、隨機方向、隨機層、無關 prompt、同頻率但不同語義的 token。沒有負對照時,很難判斷解釋是不是由數據分佈或模型普遍敏感性造成。
第四,benchmark 是否測到了真正目標?SAEBench 關注 SAE 的多維質量,AxBench 關注 steering/control/alignment 風格任務,但任何 benchmark 都會誘導優化。分數提升不一定代表解釋更接近真實機制,需要結合人工審閱和干預實驗。
第五,是否跨模型、跨層、跨數據復現?一個機制如果只在單一模型、單一 prompt family、單一 layer 上成立,結論應當收窄。跨 Pythia、Gemma、Llama、Claude 等模型的可復現性更有說服力,但閉源模型會限制核驗。
第六,是否報告失敗樣例?好的 MI 論文應該展示解釋失效的情形:feature polysemantic、patching 不穩定、steering 產生副作用、circuit graph 漏掉路徑。失敗樣例比只展示成功圖更能幫助後續研究。
第七,是否區分“人類可讀”和“模型實際使用”?一個 feature 名稱可以幫助人理解,但名字不是機制本身。真正關鍵的是該 feature 在模型計算中是否有可測影響。
可復現性與數據問題
MI 的復現難點主要在細節。Patching 實驗需要明確模型版本、tokenizer、prompt pair、層和位置索引、logit metric、採樣設置;SAE 需要報告訓練語料、激活緩存、層位、hidden expansion、稀疏懲罰、dead feature 處理、重構誤差和訓練步數;circuit tracing 需要說明 attribution graph 構造、閾值、局部近似和人工篩選流程。
數據也很敏感。解釋一個事實回憶機制時,prompt 的措辭、實體頻率、訓練語料汙染都會影響結果;解釋安全相關行為時,公開 prompt 可能觸發模型策略差異;解釋代碼或數學能力時,tokenization 和格式細節會改變激活路徑。因此,本文沒有寫“某方法達到 SOTA”這類容易過期的結論。對於 benchmark 結果、倉庫狀態、模型覆蓋範圍和在線平臺功能,出版前應以論文主頁、GitHub release、OpenReview 或 arXiv 最新版本人工核驗。
侷限與爭議
第一,MI 還沒有可靠的“顯微鏡”。SAE、probe、patching、attribution graph 都是工具,而不是保證真相的儀器。工具會帶來自己的偏差。
第二,特徵可能不是自然概念。人類傾向於給 feature 起名字,但模型內部變量可能混合語義、語法、位置、頻率和任務策略。polysemanticity 不是例外,而可能是高效表示的一部分。
第三,解釋和控制可能分離。一個方向能 steer 模型,不代表它解釋了模型為何輸出;一個 circuit graph 能解釋某些樣例,不代表它能穩定控制所有相關行為。
第四,規模化會稀釋人工理解。大模型可能有上千萬候選 feature。即使工具能自動生成解釋,人類也不可能逐一審閱。未來需要更好的抽樣、審計、層級組織和錯誤發現機制。
第五,AI safety 語境容易高估 MI 的短期能力。MI 對發現風險機制很有潛力,但目前還不能保證大型模型沒有隱藏目標、欺騙策略或未知失敗路徑。把 MI 當作安全論證的一部分是合理的,把它當作完整安全證明則過早。
適合研究生繼續做的選題
SAE feature 的因果評測協議:不僅評估重構和稀疏性,還要求 feature ablation、feature swap、跨 prompt family 和負對照。
跨模型 circuit 復現:在同一任務上比較 Pythia、Gemma、Llama 等開源模型,研究相似行為是否由相似路徑實現。
解釋失敗樣例數據集:收集 feature 命名錯誤、patching 假陽性、steering 副作用、benchmark 分數與人工判斷衝突的案例。
自動 circuit discovery 的可信度校準:讓算法輸出機制圖的同時輸出不確定性,並用預註冊干預實驗驗證。
MI 與形式化驗證結合:把發現的電路或表示方向轉化為可測試規範,例如某些安全 feature 被激活時是否必須觸發拒答路徑。
多模態模型的機制解釋:研究視覺 token、語言 token 和 cross-attention 之間的因果路徑,避免只把文本 LLM 方法直接套到 VLM。
總結
Mechanistic Interpretability 正在從小型 circuits demo 走向大模型內部機制工程。2025-2026 年最值得關注的變化,是研究對象從單個 neuron/head 擴展到 SAE feature、transcoder、attribution graph 和 benchmark;研究方法從“可視化解釋”轉向“可干預、可復現、可審計的機制假設”。
這條路線的前景很大,但不宜被漂亮圖譜衝昏頭腦。對科研讀者來說,最有價值的判斷標準仍然樸素:解釋是否能預測新樣例?是否經得起干預?是否有負對照?是否承認失敗?如果答案是否定的,它最多是一個有趣可視化;如果答案逐步變成肯定,MI 才可能成為理解和治理大模型的核心科學工具。
參考資料
檢索日期:2026-07-15。以下優先列出論文、官方研究頁、項目主頁和工具文檔;模型覆蓋、代碼倉庫狀態、benchmark 排名和在線平臺功能均可能變化,出版前建議再次人工核驗。
- Elhage et al., A Mathematical Framework for Transformer Circuits, Transformer Circuits, 2021. https://transformer-circuits.pub/2021/framework/index.html
- Olsson et al., In-context Learning and Induction Heads, Transformer Circuits, 2022. https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html
- Elhage et al., Toy Models of Superposition, Transformer Circuits, 2022. https://transformer-circuits.pub/2022/toy_model/index.html
- Bricken et al., Towards Monosemanticity: Decomposing Language Models With Dictionary Learning, Transformer Circuits, 2023. https://transformer-circuits.pub/2023/monosemantic-features/index.html
- Templeton et al., Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet, Transformer Circuits / Anthropic, 2024. https://transformer-circuits.pub/2024/scaling-monosemanticity/index.html
- Marks et al., Circuit Tracing: Revealing Computational Graphs in Language Models, Transformer Circuits, 2025. https://transformer-circuits.pub/2025/attribution-graphs/methods.html
- Anthropic, On the Biology of a Large Language Model, 2025. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
- Anthropic, Tracing the Thoughts of a Large Language Model, 2025. https://www.anthropic.com/research/tracing-thoughts-language-model
- Meng et al., Locating and Editing Factual Associations in GPT, NeurIPS 2022 / project page. https://rome.baulab.info/
- Conmy et al., Towards Automated Circuit Discovery for Mechanistic Interpretability, NeurIPS 2023. https://arxiv.org/abs/2304.14997
- Wang et al., Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small, ICLR 2023. https://arxiv.org/abs/2211.00593
- Bills et al., Language Models Can Explain Neurons in Language Models, OpenAI, 2023. https://openai.com/index/language-models-can-explain-neurons-in-language-models/
- Google DeepMind, Gemma Scope: helping the safety community shed light on the inner workings of language models, 2024. https://deepmind.google/discover/blog/gemma-scope-helping-the-safety-community-shed-light-on-the-inner-workings-of-language-models/
- Bloom, Neuronpedia: Interactive Reference and Tooling for Mechanistic Interpretability, project page, 2024-2026. https://www.neuronpedia.org/
- Karvonen et al., SAEBench: A Comprehensive Benchmark for Sparse Autoencoders in Language Model Interpretability, arXiv, 2025. https://arxiv.org/abs/2503.09532
- Wu et al., AxBench: Steering LLMs? Even Simple Baselines Outperform Sparse Autoencoders, arXiv, 2025. https://arxiv.org/abs/2501.17148
- Chanin, Are Sparse Autoencoder Benchmarks Reliable?, arXiv, 2026. https://arxiv.org/abs/2605.18229
- Heap et al., Automated Interpretability Metrics Do Not Distinguish Trained and Random Transformers, arXiv, 2025, revised 2026. https://arxiv.org/abs/2501.17727
- Huben et al., Sparse Autoencoders Find Highly Interpretable Directions in Language Models, ICLR 2024. https://openreview.net/forum?id=F76bwRSLeK
- Nanda and Bloom, TransformerLens, documentation and repository. https://github.com/TransformerLensOrg/TransformerLens
- nnsight team, nnsight: interpreting and manipulating the internals of deep learning models, documentation. https://nnsight.net/
- Sharkey et al., Mechanistic Interpretability for AI Safety: A Review, arXiv / TMLR, 2025. https://arxiv.org/abs/2404.14082