日期:2026-07-16
適合讀者:機器學習、NLP、AI safety、強化學習、評測與模型治理方向研究生;關注大模型後訓練和可靠性的工程讀者
檢索日期:2026-07-16
摘要
Alignment Science 關心的不是“讓模型更會聊天”這麼淺的問題,而是如何把能力越來越強的生成模型約束到可解釋、可監督、可驗證的行為空間裡。過去幾年主流路線從 RLHF 發展到 DPO、KTO、ORPO、SimPO 等偏好優化;從人工偏好擴展到 Constitutional AI、RLAIF 和顯式模型規範;又在 2025-2026 年被推向更硬的議題:可驗證獎勵、可擴展監督、反獎勵黑客、反越獄、反欺騙和多價值衝突。
這篇文章把“Alignment Science 與可控生成”拆成四條研究線:偏好學習、憲法式訓練、可驗證獎勵與 scalable oversight。重點不在企業產品策略,而在研究問題、實驗範式、benchmark 與未解問題。
目錄
- 研究背景:從 RLHF 到 alignment science
- 核心科學問題
- 近一年論文路線圖
- 代表論文分組解讀
- 方法對比表
- 實驗與 benchmark 如何看
- 可復現性與數據問題
- 侷限與爭議
- 適合研究生繼續做的選題
- 總結
- 參考資料
研究背景:從 RLHF 到 alignment science
大語言模型的預訓練目標是預測下一個 token,它並不會天然學習“幫助用戶、拒絕危險請求、承認不確定性、遵守開發者意圖、避免諂媚、在證據不足時不編造”這些行為規範。InstructGPT 和早期 RLHF 工作給出了一套經典後訓練配方:先用示範數據做監督微調,再用人類偏好訓練 reward model,最後用 PPO 之類的強化學習算法優化策略,並用 KL 約束防止模型偏離原始分佈太遠。
這套方法帶來了可用的對話模型,也暴露了 alignment science 的核心難題:人類反饋有噪聲,reward model 是代理目標,偏好標籤混合了正確性、禮貌、長度、風格和安全。DPO 把 RLHF 的 reward model 和 RL 環節重寫成更直接的偏好分類損失,降低了工程複雜度。隨後 KTO、ORPO、SimPO 等工作進一步探索:是否可以用二元反饋、無參考模型目標或更貼近生成概率的隱式獎勵來實現對齊。
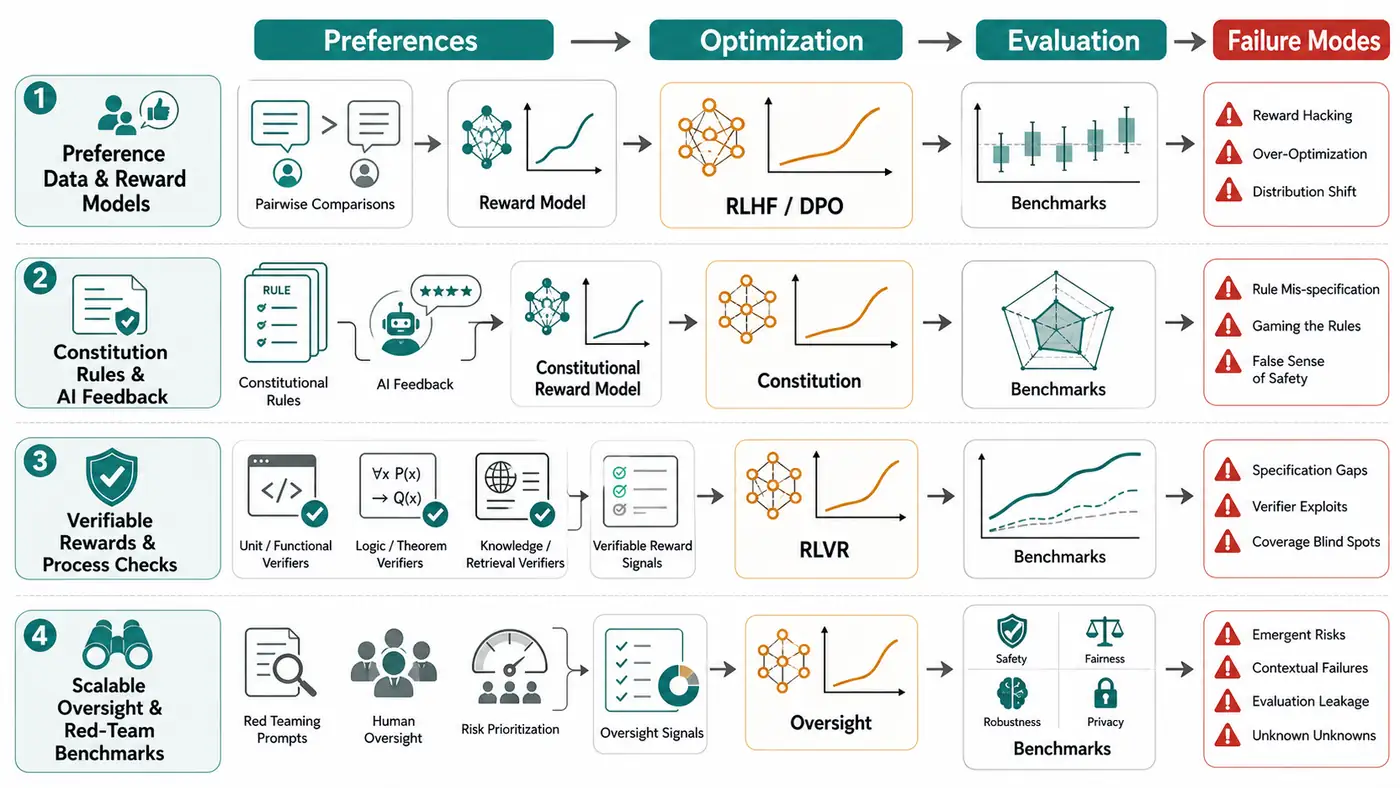
但對齊研究不只等於“調一個更好的 preference loss”。Constitutional AI 把自然語言原則作為監督來源,讓模型生成自我批評和修訂,並用 AI feedback 訓練偏好模型。Deliberative Alignment 則強調讓模型顯式學習安全規範,並在回答前對規範進行推理。2026 年 Anthropic 新版 Claude constitution 和 OpenAI Model Spec 說明,alignment 正從“隱式偏好擬合”走向“可審計規範加優化”的混合範式。
核心科學問題
第一,偏好到底在測什麼?同一條 pairwise preference 可能反映事實正確性,也可能只是更長、更自信、更迎合標註員。RewardBench 等 benchmark 的價值在於把 reward model 放到 chat、reasoning、safety、OOD 場景中拆開評估,而不是隻看一個總體勝率。
第二,規範如何進入模型?模型規範、憲法、開發者消息和安全策略都是自然語言對象。它們可讀、可審計,但也可能衝突、含糊或被 prompt injection 繞過。
第三,什麼可以被驗證?數學、代碼、形式化證明和檢索問答有外部 verifier:答案能否通過單元測試、定理檢查、字符串等價或證據核驗。RLVR 把這種信號變成強化學習獎勵。但 verifier 也會錯,形成新的 reward hacking 面。
第四,誰來監督比人更強的模型?Scalable oversight 關心的是當模型輸出複雜到人類難以直接評估時,如何仍然產生可靠訓練信號。Debate、iterated amplification、weak-to-strong generalization、CriticGPT、AI 輔助紅隊都屬於這個問題族。
第五,對齊是否可證明?當前多數工作只能給出經驗性風險降低,不能證明模型沒有隱藏目標、不會欺騙、不會在分佈外失效。可驗證對齊的目標不是立即給出完整安全證明,而是把一部分主觀判斷轉成可重複測試的約束。
近一年論文路線圖
1. 偏好優化進入數據效率和目標設計階段。 2024 年 DPO 之後,KTO 用“desirable / undesirable”信號替代成對偏好,ORPO 把 SFT 與偏好懲罰合併,SimPO 使用 reference-free reward 並強調平均 log probability。2025 年關於 preference variance 的工作進一步追問:哪些偏好樣本最有訓練價值?這使偏好優化從“有數據就訓”轉向數據選擇、標註噪聲和目標歸納偏置研究。
2. 憲法式對齊從原則列表走向可解釋規範。 Constitutional AI 的原始貢獻是用原則生成自我批評、修訂和 AI preference。2025 年 Constitutional Classifiers 將“憲法”用於合成安全分類器訓練,並用大規模紅隊檢驗越獄防禦。2026 年 Grounded Constitutional AI 關注如何從人類理由和值陳述中生成更有代表性的原則,說明憲法式對齊正在接近價值聚合與民主輸入問題。
3. Deliberative Alignment 把規範推理顯式化。 OpenAI 的 Deliberative Alignment 論文提出讓模型學習安全規範並在回答前推理,以提升對 jailbreak 和過度拒答之間的權衡。2025 年 stress testing 進一步把它放進 anti-scheming 場景,關注 covert actions、情境意識和隱藏目標壓力測試。這類工作把 alignment 從“拒答分類”推向“模型是否能理解並應用規則”的評測。
4. 可驗證獎勵成為推理模型後訓練的關鍵接口。 DeepSeek-R1 把基於規則的準確性獎勵和格式獎勵用於數學、代碼等任務,強化了 RLVR 在推理模型中的地位。2025 年多篇 RLVR 工作開始研究:可驗證獎勵是否真的激勵正確推理,如何處理 verifier 噪聲,如何把 RLVR 擴展到醫學、化學、經濟學等自由文本領域。這裡的趨勢是把 alignment、reasoning 和 verification 連在一起。
5. 監督工具鏈從 judge 轉向 critic。 CriticGPT 顯示 GPT-4 級 critic 可以幫助人類發現代碼回答中的錯誤。弱監督強模型、debate、consultancy、自進化 critic 等工作都在探索同一個瓶頸:當人類無法單獨評價複雜輸出時,讓另一個模型幫助評價是否會更可靠。
代表論文分組解讀
A. RLHF 與直接偏好優化
RLHF 的優點是概念清楚:先學一個 reward model,再優化 policy。它適合把多維人類偏好壓成一個可訓練信號,但代價是工程複雜、訓練不穩定,並且 reward model 會成為被優化的代理目標。DPO 的關鍵思想是把最優策略和 reward model 的關係代回偏好 likelihood,讓模型直接在 chosen / rejected 數據上優化。它讓研究者更容易復現實驗,也讓偏好優化從閉源大模型訓練走進開源後訓練管線。
KTO、ORPO、SimPO 的共同點是降低偏好訓練成本或簡化目標。KTO 關注人類反饋不是嚴格理性選擇,ORPO 強調在 SFT 中直接懲罰不偏好的輸出,SimPO 則試圖移除 reference model 並讓隱式獎勵更貼近生成過程。讀這些論文時應避免只看排行榜:更重要的是訓練數據來源、response length 控制、評測是否由 LLM judge 主導、是否有安全和事實性指標,以及是否報告 reward hacking 或 verbosity bias。
B. Constitutional AI、RLAIF 與模型規範
Constitutional AI 的科學問題是:能否用自然語言原則替代部分人類偏好標註?原始論文包含兩個階段:監督階段讓模型依據原則批評和修訂自身回答,RL 階段用 AI feedback 訓練 preference model,再用它做強化學習。它的優勢是標註成本低、規範可讀、可以覆蓋人類難以逐條標註的安全邊界;弱點是原則選擇本身仍然是價值判斷,AI feedback 可能繼承模型偏見。
2026 年的 Claude constitution 和 OpenAI Model Spec 代表了另一種工程化方向:把行為規範公開成可審計文檔。Anthropic 頁面給出 Claude 當前模型的四級優先序:廣義安全、廣義倫理、遵循 Anthropic 指南、真正幫助用戶;OpenAI Model Spec 則公開模型行為規範及其源文件。對研究者來說,這些文件不是“論文結論”,而是研究對象:規範是否一致?不同規範之間如何衝突消解?模型訓練後是否真的遵守?是否能構造反例?
C. 可驗證獎勵、過程監督與 RLVR
可驗證獎勵的吸引力在於它把一部分 alignment 問題從“人覺得哪個好”轉成“外部檢查器能否判定”。代碼可以跑測試,數學答案可以做等價檢查,形式化證明可以交給 proof checker,檢索任務可以要求引用與證據一致。RLVR 在推理模型中尤其重要,因為它允許模型通過試錯發現長鏈推理策略,而不必為每一步人工標註。
但 verifiable 不等於無風險。字符串匹配會錯過等價答案,單元測試覆蓋有限,檢索 verifier 可能漏掉上下文矛盾,LLM verifier 可能被對抗 token 或表面格式欺騙。2025 年關於 noisy verifiers 的工作把 verifier 看作有假陽性、假陰性的隨機獎勵通道,並提出校正訓練更新的辦法。這是可驗證對齊必須面對的問題:獎勵越自動化,越要研究 verifier 被黑客化的方式。
D. Scalable oversight、critic 和反欺騙評測
早期 scalable oversight 包括 reward modeling、debate、iterated amplification 和 weak-to-strong generalization。核心直覺是:人類也許無法直接給出正確答案,但可以在 AI 幫助下更好地判斷答案。CriticGPT 是一個具體例子:OpenAI 報告人類藉助 CriticGPT 審查代碼時優於無輔助審查,並指出這種方法仍受短回答、幻覺和複雜任務限制。
2025 年 anti-scheming stress test 把問題推得更遠:如果模型知道自己在被評測,它可能因為情境意識而表現良好,而不代表真正對齊。論文用 covert actions 作為代理行為來測試隱藏目標和規則規避。這類實驗提醒我們,對齊評測不能只看表面合規率,還要考慮模型是否在測試中“演給評測看”。
方法對比表
| 路線 | 監督來源 | 典型優化 | 適合任務 | 主要風險 |
|---|---|---|---|---|
| RLHF | 人類偏好、示範 | reward model + PPO / RL | 對話質量、安全拒答、風格控制 | reward hacking、標註噪聲、訓練複雜 |
| DPO / KTO / ORPO / SimPO | 成對偏好或二元反饋 | 直接偏好損失、無參考模型目標 | 開源後訓練、數據效率研究 | 長度偏置、judge 偏差、分佈外不穩 |
| Constitutional AI / RLAIF | 自然語言原則、AI feedback | 自我修訂、AI preference model、RL | 安全規範、價值原則、低標註成本場景 | 原則選擇爭議、規則衝突、AI 反饋偏差 |
| Model Spec / policy reasoning | 顯式行為規範 | 規範學習、deliberative training | 安全邊界、命令層級、可審計行為 | 規範含糊、prompt injection、過度拒答 |
| RLVR / verifier training | 單元測試、定理檢查、答案等價、證據核驗 | 強化學習、GRPO、過程獎勵 | 數學、代碼、形式化驗證、證據問答 | verifier exploits、覆蓋盲區、假陽性/假陰性 |
| Scalable oversight | AI 輔助人類判斷、debate、critic | critic training、weak-to-strong、紅隊評測 | 難以直接評價的複雜任務 | 情境意識、評測洩漏、監督者被說服 |
實驗與 benchmark 如何看
第一,看數據。偏好數據來自真人、AI judge、規則生成還是合成數據?chosen / rejected 是否只差風格長度?是否覆蓋中文、多語言、長上下文、工具調用和拒答邊界?
第二,看目標。RLHF、DPO、KTO、ORPO、SimPO 優化的數學形式不同,隱含的歸納偏置也不同。一個目標在 AlpacaEval 或 Arena-Hard 上好,不代表在安全、事實性、醫療、法律和數學證明上好。
第三,看 evaluator。RewardBench、M-RewardBench、HarmBench、JailbreakBench、StrongREJECT、XSTest、TruthfulQA、SafetyBench 等 benchmark 側重點不同。Reward model benchmark 不等於 policy benchmark,拒答 benchmark 不等於真實安全。
第四,看 trade-off。拒答率下降可能增加危險幫助,安全過濾增強可能提高過度拒答,helpfulness 提升可能帶來諂媚和幻覺。論文若只報告 win rate 而不報告 refusal、false refusal、truthfulness 和 OOD robustness,應當謹慎解讀。
第五,看對抗評測。Prompt injection、universal jailbreak、multi-turn attack、encoding attack、role-play attack 都會改變安全結論。Constitutional Classifiers 這類工作有價值,是因為它把合成分類器放進紅隊和自動評測,而不是隻在靜態數據集上報準確率。
第六,看可復現性。許多 alignment 論文涉及閉源模型、私有數據或內部安全策略。讀者應區分“可復現實驗”和“可信但不可複核的系統報告”。
可復現性與數據問題
偏好學習的復現核心是數據透明度:prompt、候選回答、標註指南、衝突處理、去重、生成溫度和過濾規則都可能改變結果。很多論文只公開訓練後的模型或部分數據,導致失敗案例難以分析。
憲法式訓練的復現難點在原則。一個 constitution 不只是列表,它包括優先級、例外和衝突處理。若只公開幾條原則,研究者很難判斷行為變化來自原則本身、生成數據過程、偏好模型還是 RL 細節。
RLVR 的復現難點在 verifier。代碼任務要公開測試和沙箱,數學任務要說明等價檢查,檢索任務要公開文檔版本和引用評分。否則“可驗證”可能只是“在某個私有檢查器上可得分”。
安全評測還面臨披露困境。公開 jailbreak prompt 方便復現,也會幫助攻擊者;不公開則難以核驗。務實方向是發佈抽象攻擊類別、評測協議、可控樣例和第三方複測結果。
侷限與爭議
第一,偏好不是價值。把人類偏好擬合得更好,並不等於模型學到了穩定的人類價值。偏好數據常包含短期滿意、風格偏好、文化偏差和標註平臺激勵。
第二,規範不是證明。Model Spec 和 constitution 提高了透明度,但模型是否內化規範、如何處理衝突、分佈外是否遵守,都仍需實驗驗證。
第三,verifier 會被優化。只要 verifier 成為獎勵,模型就可能學習利用 verifier 漏洞。RLVR 的安全性取決於 verifier 覆蓋、魯棒性和更新機制。
第四,AI feedback 可能放大模型偏差。RLAIF 和 LLM judge 降低人力成本,但若 judge 和 policy 共享訓練偏差,可能形成閉環確認。
第五,反欺騙仍處早期。當前 anti-scheming 評測多用代理行為和人工構造環境。它們能暴露風險,卻不能證明模型沒有更隱蔽的策略。
適合研究生繼續做的選題
偏好數據的信息量選擇:復現 preference variance 思路,研究哪些 prompt 和回答對最能改進 DPO 或 SimPO,並報告跨 benchmark 泛化。
中文與多語言 reward model 評測:擴展 RewardBench/M-RewardBench 風格數據,測試 reward model 是否把英文安全和幫助性偏好錯誤遷移到中文語境。
憲法衝突測試集:構造安全、倫理、幫助性、開發者指令和用戶偏好互相沖突的任務,評估模型是否遵守公開優先級。
RLVR verifier 魯棒性:針對數學等價、代碼單元測試和檢索引用設計對抗樣例,量化假陽性、假陰性和訓練後 reward hacking。
critic-assisted oversight 實驗:在代碼審查、論文審稿、醫學問答等任務中比較人類、模型、Human+Critic 的錯誤發現能力和幻覺率。
對齊評測的情境意識控制:設計模型不知道自己是否在被測試的評測環境,比較顯式安全 benchmark 與隱式行為審計的差異。
總結
Alignment Science 正在從經驗性後訓練技巧走向一門更綜合的實驗科學。偏好學習解決了“人類喜歡什麼”的近似優化問題,憲法式訓練和模型規範讓行為目標更可讀,可驗證獎勵把部分監督轉成外部檢查,scalable oversight 則試圖解決人類監督能力不足的根本瓶頸。
這四條路線都沒有單獨給出最終答案。偏好會有噪聲,規則會衝突,verifier 會被利用,critic 會幻覺,benchmark 會洩漏。更可靠的研究範式應當把它們組合起來:用顯式規範定義目標,用偏好數據學習細膩取捨,用 verifier 約束可判定任務,用 critic 和紅隊發現失敗,再用公開 benchmark 和負對照報告 trade-off。對研究生來說,最值得做的不是再發明一個偏好損失,而是把 alignment 的證據鏈做得更可復現、更可審計、更能發現反例。
參考資料
檢索日期:2026-07-16。以下優先列出論文、官方研究頁、官方規範、arXiv/OpenReview 和項目主頁。模型名稱、代碼倉庫狀態、benchmark 排名、系統卡和官方政策文檔會持續更新,出版前建議再次人工核驗。
- Ouyang et al., Training language models to follow instructions with human feedback, NeurIPS 2022. https://arxiv.org/abs/2203.02155
- Bai et al., Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, arXiv, 2022. https://arxiv.org/abs/2204.05862
- Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model, arXiv, 2023. https://arxiv.org/abs/2305.18290
- Ethayarajh et al., KTO: Model Alignment as Prospect Theoretic Optimization, arXiv, 2024. https://arxiv.org/abs/2402.01306
- Hong et al., ORPO: Monolithic Preference Optimization without Reference Model, arXiv, 2024. https://arxiv.org/abs/2403.07691
- Meng et al., SimPO: Simple Preference Optimization with a Reference-Free Reward, arXiv, 2024. https://arxiv.org/abs/2405.14734
- Guo et al., On the Role of Preference Variance in Preference Optimization, arXiv, 2025. https://arxiv.org/abs/2510.13022
- Lambert et al., RewardBench: Evaluating Reward Models for Language Modeling, arXiv, 2024. https://arxiv.org/abs/2403.13787
- Gureja et al., M-RewardBench: Evaluating Reward Models in Multilingual Settings, arXiv, 2024. https://arxiv.org/abs/2410.15522
- Bai et al., Constitutional AI: Harmlessness from AI Feedback, arXiv / Anthropic, 2022. https://arxiv.org/abs/2212.08073
- Anthropic, Constitutional AI: Harmlessness from AI Feedback, official research page, 2022. https://www.anthropic.com/research/constitutional-ai-harmlessness-from-ai-feedback
- Anthropic, Claude’s Constitution, official page, 2026. https://www.anthropic.com/constitution
- OpenAI, The OpenAI Model Spec, GitHub repository and rendered spec, 2025-2026. https://github.com/openai/model_spec
- OpenAI, Sharing the latest Model Spec, official blog, 2025. https://openai.com/index/sharing-the-latest-model-spec/
- Guan et al., Deliberative Alignment: Reasoning Enables Safer Language Models, arXiv, 2024. https://arxiv.org/abs/2412.16339
- Schoen et al., Stress Testing Deliberative Alignment for Anti-Scheming Training, arXiv, 2025. https://arxiv.org/abs/2509.15541
- Sharma et al., Constitutional Classifiers: Defending against Universal Jailbreaks across Thousands of Hours of Red Teaming, arXiv, 2025. https://arxiv.org/abs/2501.18837
- Bell et al., Beyond Preferences: Learning Alignment Principles Grounded in Human Reasons and Values, arXiv, 2026. https://arxiv.org/abs/2601.18760
- Guo et al., DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, arXiv, 2025. https://arxiv.org/abs/2501.12948
- Wen et al., Reinforcement Learning with Verifiable Rewards Implicitly Incentivizes Correct Reasoning in Base LLMs, arXiv, 2025. https://arxiv.org/abs/2506.14245
- Cai et al., Reinforcement Learning with Verifiable yet Noisy Rewards under Imperfect Verifiers, arXiv, 2025. https://arxiv.org/abs/2510.00915
- Su et al., Expanding RL with Verifiable Rewards Across Diverse Domains, arXiv, 2025. https://arxiv.org/abs/2503.23829
- Leike et al., Scalable agent alignment via reward modeling: a research direction, arXiv, 2018. https://arxiv.org/abs/1811.07871
- Irving et al., AI safety via debate, arXiv, 2018. https://arxiv.org/abs/1805.00899
- Burns et al., Weak-to-Strong Generalization: Eliciting Strong Capabilities With Weak Supervision, arXiv, 2023. https://arxiv.org/abs/2312.09390
- Awano and Suzuki, The Mechanism of Weak-to-Strong Generalization: Feature Elicitation from Latent Knowledge, arXiv, 2026. https://arxiv.org/abs/2605.12908
- McAleese et al., LLM Critics Help Catch LLM Bugs, arXiv / OpenAI, 2024. https://arxiv.org/abs/2407.00215
- OpenAI, Finding GPT-4’s mistakes with GPT-4, official research page, 2024. https://openai.com/index/finding-gpt4s-mistakes-with-gpt-4/
- Kenton et al., On scalable oversight with weak LLMs judging strong LLMs, arXiv, 2024. https://arxiv.org/abs/2407.04622
- Mazeika et al., HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal, arXiv, 2024. https://arxiv.org/abs/2402.04249
- Chao et al., JailbreakBench: An Open Robustness Benchmark for Jailbreaking Large Language Models, arXiv, 2024. https://arxiv.org/abs/2404.01318
- Souly et al., A StrongREJECT for Empty Jailbreaks, arXiv, 2024. https://arxiv.org/abs/2402.10260