- 日期:2026-11-01
- 讀者:研究生、科研新人和工程型研究者
- 範圍:三項診斷研究的證據深讀;不報告本次模型實驗。
摘要:答案正確,證據可能沒有被用上
問一張香蕉照片“它是什麼顏色”,回答黃色可能來自看圖,也可能來自常識。把香蕉換成紅色,錯誤才顯露出來;但答錯仍可能是沒看清顏色、沒理解問題,或沒有把看到的屬性用於回答。**總正確率不能獨自區分這些解釋。**封面中的紅色香蕉只是概念插畫,不是論文測試樣本。
本文圍繞三個診斷入口展開:VLind-Bench先檢查基礎能力,再評估反常識圖像;Winoground固定詞彙、改變組合關係;VisRes把視覺任務拆成感知和規則推斷。它們不是“視覺有效”與“語言有害”兩個陣營。本篇關心的是:什麼觀察足以支持模型依賴視覺證據,什麼觀察還不能定位失敗原因。
“看圖”至少包含三件不同的事
視覺語言模型,簡稱VLM,是同時處理圖像與文本的模型。視覺問答則要求它依據圖像回答問題。這裡的語言先驗,指從訓練中學到的常見搭配、事實或答案傾向;它能幫助理解問題,也可能在圖像與常識衝突時替代現場證據。
需要區分識別對象、綁定關係和使用證據。看見“杯子”和“碗”,不等於判斷出誰在左邊;正確說出紅色,也不等於回答後續問題時沒有回到“香蕉通常黃色”的默認答案。三個環節可能同時出問題,不能把所有失敗都算作語言偏見。
以下是本篇用於閱讀證據的三種競爭解釋。第一,模型主要靠題目和常見答案,圖像貢獻很小。第二,模型確實接收視覺信息,但壓縮、分辨率或屬性識別限制了可用證據。第三,信息已經可以被單獨識別,卻沒有穩定進入關係判斷。它們對干預的預測不同:改問題措辭、提高分辨率和交換對象關係,不應只被當成三種“提分技巧”。
反常識答錯,先檢查它是否具備前提能力
VLind-Bench給出的關鍵方法是條件化診斷:檢查常識知識、圖中對象識別,以及有明確文字情境時能否接受反常識設定,再在滿足前提的樣本上測圖像條件下的判斷。每項要求正確處理真假兩種陳述。論文表3顯示,過濾後的流水線得分與全體樣本準確率並不相同。Lee等,§3、§5.1與表3
這改變了我們能說的話。若模型連圖中目標都認不出,繼續批評它“明明看見卻不相信”,證據不足;若提供文字情境後仍拒絕反常識回答,也不能只歸因於視覺通道。作者的方法減少了混雜,但其侷限節明確承認仍可能存在未考慮因素與提示敏感性。原文Limitations
**本篇推斷:通過前提測試,不等於完全排除了感知問題。**對象存在性檢查比細粒度屬性、主體與客體綁定更容易。能認出一把劍,未必能穩定判斷它被誰拿著;能接受文字描述,也可能只是文字把答案直接說清楚了。流水線更像診斷篩選器,而非對內部機制的完整證明。
還要留意分母。各模型通過前提的樣本集合可能不同,因此較高的條件得分不自動意味著它在同一組難題上更強。比較時應同時給出進入末階段的覆蓋量、全體題目的任務表現,以及共同通過子集上的結果。只保留一個漂亮的末階段百分比,會把“剩下的題較容易”與“利用視覺更好”混在一起。
詞都認識,關係卻可能沒有配對成功
Winoground把兩張圖與兩句使用相同詞彙、不同排列的描述組成一組。這樣,靠“出現了哪些詞”難以完成匹配。它分別檢查給圖選句、給句選圖,以及兩種方向同時成立的組得分。原文表3中的受測模型在組指標上均低於其隨機基線;這描述的是當時的模型與協議。Thrush等,§3–5、表3
它提供的不是又一個通用榜單,而是一種困難負例設計。負例與正例共享大量對象和詞彙,錯誤集中在組合關係上。普通檢索可能只要求從明顯不同的候選中挑出相關圖片;關係診斷則要求在“對象都對”的候選之間作區分。
**本篇推斷:雙向配對比單次命中更有說服力,但仍不能單獨定位故障。**圖像編碼、文本詞序處理和跨模態比較都參與匹配;失敗可能發生在任一處。照片還可能含有歧義與背景差異,不能把兩張真實照片直接視作只改變關係的完美因果乾預。
因此,不能把該論文的歷史結果改寫為“今天所有多模態模型都不會看圖”。把生成式模型改成回答選擇題,也改變了評分接口。若複測時調整提示、候選位置或回答抽取規則,應先保證每個模型接受同一種協議,再討論進步來自哪裡。
視覺謎題失敗,也可能是輸入表徵的問題
VisRes提供感知補全、單屬性規則和多屬性組合三個層級,並設置視覺上相近的干擾選項。它還單獨測試屬性識別、改變輸入分辨率,並將規則題轉寫成文字。本文實驗依據為2025年12月的arXiv v1;CVPR 2026發表身份由正式目錄核對,不把未取得的會議全文當作已讀版本。Törtei等,§3–5
該版本表7中,GPT-5的第二層級在輸入從1024升至2048時,準確率由49.61降至48.99;所以“更高分辨率逐檔提高所有層級”並不符合表格。文字化規則題也表現更好,但這不能唯一證明視覺編碼器是瓶頸:文字已經完成屬性提取,並改變了表示形式。原文§5.2、表7
**本篇推斷:看清楚與推理正確之間,需要可干預的橋梁。**如果增加分辨率改善成績,它支持輸入細節或處理方式影響結果;但增加圖像信息通常也改變視覺令牌與計算成本。若直接提供準確的屬性表後表現改善,說明該表示對任務有幫助,卻沒有證明模型原本已經感知到同樣的信息。
同理,困難負例會讓測試更有區分度,也會改變測試分佈。選項都很相似時,低分可能暴露精細視覺辨別不足;它不是“訓練中所有視覺知識無效”的證據。研究者需要報告負例如何選擇,以及結論在普通候選和相似候選下是否一致。
三項研究能拼出什麼,不能拼出什麼
| 診斷入口 | 觀察對象 | 能支持的判斷 | 不能直接證明 |
|---|---|---|---|
| 反常識前提篩選 | 基礎測試通過後的圖像判斷 | 部分簡單失敗解釋已被限制 | 剩餘錯誤都由語言先驗造成 |
| 同詞彙雙向配對 | 組合關係與匹配一致性 | 詞彙共現不足以完成任務 | 故障一定發生在視覺端 |
| 感知與規則分層 | 屬性、分辨率和表示改變 | 輸入與任務結構影響表現 | 所有差距只有一個機制 |
上表是對三項協議的歸納,不是跨論文排名。它們的模型起點、數據來源、訓練經歷、推理預算和指標均不統一:有圖文打分,也有真假判斷和四選一;有條件分母,也有成組要求。公開模型與閉源接口的訓練信息可見程度也不同,不能從這些論文拼出“同等訓練預算下哪種架構更會看圖”的結論。
當前證據更適合支持一個有限判斷:**視覺任務高分與穩定依賴視覺證據之間,存在需要單獨測量的距離。**語言知識可以提供概念與規則,視覺輸入提供當前場景;真正的問題是衝突時能否依據任務要求調整,而不是徹底消除語言知識。這是本篇綜合判斷,不是某一篇論文證明的普遍定理。
下一步:讓不同解釋給出不同預測
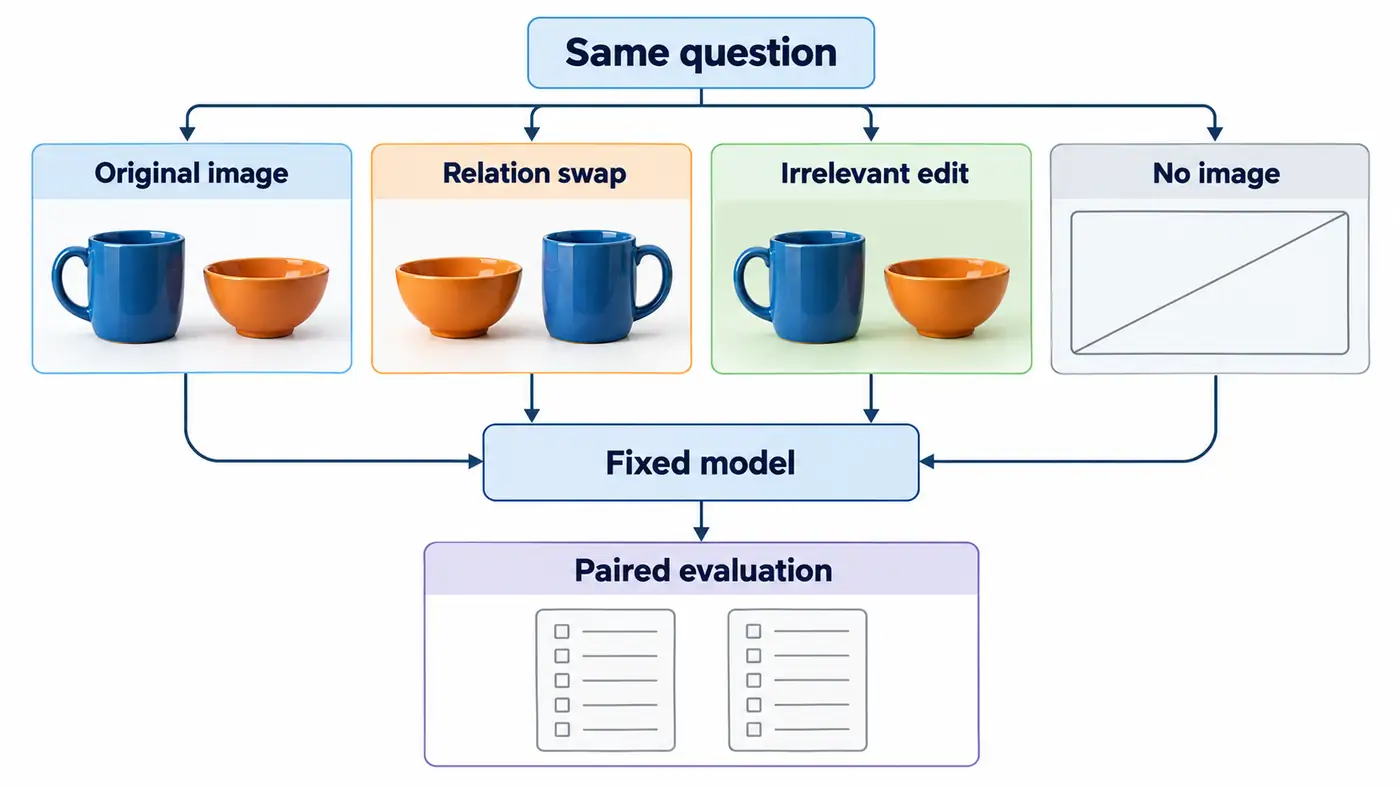
圖:本篇提出的未執行實驗。四種輸入分別送入同一模型,箭頭僅表示評測流程,不表示模型內部因果機制,也沒有已觀察的結果。關係交換圖只是示意,實際測試須保持杯柄方向等非目標因素一致。
可從一組對象關係清楚、答案平衡的場景開始。固定問題,分別提供原圖、改變目標關係的圖、只改變無關背景的圖,以及模型原生支持的無圖輸入。目標關係改變時,正確答案應改變;無關編輯時,正確答案應保持。測試的重點是這兩類響應能否同時成立。
首先,把對象識別與關係判斷分開提問,使用獨立會話,避免前一個回答提示後一個答案。記錄所有樣本,再附上共同通過識別檢查的子集。若只看通過子集,必須報告篩掉了多少、篩掉的是什麼題;否則容易把模型最嚴重的感知失敗從結論中刪除。
其次,固定檢查點、提示、候選順序規則、解碼參數和預算。提高分辨率的實驗另行報告圖像令牌與費用,文字屬性表作為外部信息條件單列。無圖輸入若不受接口支持,就如實標記該控制不可實施;不要默認全黑圖片等價於沒有圖像。
最後,觀察配對正確性,而不僅是答案有沒有變。錯誤答案之間來回切換也很敏感,卻不是證據利用。若關係變化引起正確翻轉、背景編輯保持正確,才較支持選擇性使用相關信息;若所有編輯都擾動答案,更像輸入脆弱性;若所有編輯都不改變回答,則還需區分任務無須看圖與模型忽略圖像。
實際執行前還需要獨立判斷編輯後的語義是否準確,並檢查遮擋、視角和偽影。不能讓同一個待評模型既生成圖片又給出唯一金標。本文沒有開展這項實驗,也不聲稱已有人工標註;上述設計的價值,在於把下一步證據要求寫清楚。
還應提前規定什麼結果會改變判斷。例如,若文字條件同樣頻繁混淆左右關係,就應降低對“純視覺故障”的信心;若只有某種背景編輯導致退化,則先調查編輯痕跡和輸入處理。保留不符合預期的樣本,比在看到結果後重新定義“需要視覺的題”更能約束解釋。
總結:把“看見了”變成可檢驗的問題
判斷視覺推理,不必先選“真理解”或“只猜測”的立場。先問圖像是否必要,再問相關變化能否引起正確變化,最後檢查無關變化是否保持穩定。前提篩選、成組配對和表示干預分別補上一塊證據,但任何一塊都不足以獨自證明內部理解。對科研新人,更有價值的結果是縮小失敗解釋的範圍,並明確哪一次干預可能推翻當前判斷。
參考資料
- Lee, Kang-il; Kim, Minbeom; Yoon, Seunghyun; Kim, Minsung; Lee, Dongryeol; Koh, Hyukhun; Jung, Kyomin. VLind-Bench: Measuring Language Priors in Large Vision-Language Models. Findings of NAACL, 2025。正式全文。
- Thrush, Tristan; Jiang, Ryan; Bartolo, Max; Singh, Amanpreet; Williams, Adina; Kiela, Douwe; Ross, Candace. Winoground: Probing Vision and Language Models for Visio-Linguistic Compositionality. CVPR, 2022。已讀arXiv v2全文;正式發表頁。
- Törtei, Brigitta Malagurski; Dahou, Yasser; Huynh, Ngoc Dung; Para, Wamiq Reyaz; Lê Khac, Phúc H.; Singh, Ankit; Chaybouti, Sofian; Narayan, Sanath. VisRes Bench: On Evaluating the Visual Reasoning Capabilities of VLMs. 2025預印本,CVPR 2026發表。已讀arXiv v1全文;正式發表頁。
檢索與資料截止日期:2026-11-01。檢索覆蓋近十二個月相關工作,並保留經典診斷設計;不聲稱全面覆蓋。CVF頁面直開受限,發表信息使用其官方檢索記錄核對,實驗細節以明確列出的已讀版本為準。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發了一些日常小工具,歡迎瞭解:
- 日常收支小記:記錄日常收支,安排預算和儲蓄目標,讓每一筆錢的去向更清楚。在 App Store 瞭解。
- 一事微光:根據當下的時間、精力選擇小行動,記錄完成後的感受,給日常復盤留下一點線索。在 App Store 瞭解。
更多技術文章和個人作品,歡迎訪問作者個人網站。這些作品與本文論文沒有技術關聯或機構背書。