大模型研究爭議:從論文結論到證據邊界
摘要:預測對了,還缺哪一種證據?
一個模型生成了逼真的多米諾骨牌視頻,倒下的方向也合理。它可能學會了接觸如何傳播,也可能沿用了常見畫面的續寫方式,還可能先生成許多候選,再由另一個模型挑出較合理的一條。僅看最終成片,這些解釋很難區分。
本文討論一個較窄的問題:視頻預測在什麼條件下,能成為模型掌握可遷移動力學的證據?結論是,畫面質量、給定條件下的預測準確度、干預後的穩定響應,需要分別測量。三項研究提供了不同層次的診斷,尚不足以把“世界模型”這個名稱直接兌換成因果理解證明。這裡的“理解”採用可檢驗的行為標準,不討論意識,也不要求模型必須寫出牛頓方程。
從續寫畫面到改變世界
視頻預測是根據已有幀生成後續幀。動力學模型則描述狀態怎樣隨時間、動作和環境參數變化。“世界模型”可以指這兩類模型,也可以指只預測壓縮表徵的模型;使用同一個名稱,並不意味著它們接受了同一種測試。
以小球為假設例子:模型看見小球向右運動,預測它繼續向右,只說明這次續寫正確。把球從藍色改成紅色、保持速度不變,預測應基本不變;把速度改大、保持顏色不變,位移應相應變化。前者檢查對無關外觀的穩定性,後者檢查對相關變量的敏感性。兩種測試缺一,都可能留下捷徑解釋。
“干預”是主動改變某個因素,並儘量保持其他條件一致;“反事實”進一步問,同一個事件若採用另一種干預會怎樣。把提示詞換成“更重的球”不自動構成嚴格反事實:模型可能連材質、背景與初始速度都改了。只有干預對象和共同初始狀態可追蹤,成對比較才有明確含義。
另一個容易忽略的條件是可觀測性。一張靜止照片未必包含速度,外觀相同的球也可能有不同密度。輸入缺失決定未來的信息時,唯一正確的續寫可能根本不存在。此時應檢驗合理結果的分佈,或允許模型請求更多觀測,而不應把猜中唯一錄像當作掌握規律。
三種解釋,需要三種不同的壓力測試
第一種解釋是模型主要依賴外觀與常見軌跡的統計匹配。這不等於逐幀複製訓練集;插值、重組也能生成從未見過的視頻。它的風險在於,無關外觀變化可能改變動力學預測。
第二種解釋是模型形成了某種可遷移的狀態關係。它不必顯式保存質量、速度的變量名,但應在一組事先聲明的干預中保持一致,並能處理未見參數組合。通過測試會增強這一解釋,卻仍不能唯一確定內部實現。
第三種解釋是系統有能力生成合理候選,但默認採樣和篩選不夠好。加入搜索後表現提高,可能說明可用候選原本存在,也可能包含外部獎勵模型提供的信息。它與第二種解釋並不互斥,且必須明確研究對象是單個生成器還是整個系統。
受控實驗告訴我們,泛化必須拆開看
Kang等人的研究將視頻生成放進受控二維物理環境,區分訓練範圍內、範圍外以及已見對象的新組合。擴散模型從頭訓練,但視頻壓縮器使用固定預訓練VAE;因此不能稱整套系統完全沒有預訓練。研究報告範圍內預測隨規模改善,範圍外仍存在明顯誤差,組合泛化則可以受益於擴展數據。1
這一設計的價值在於,物理參數和測試劃分可以控制;其邊界也同樣清楚:它研究的是指定架構、數據範圍與任務,不是證明所有視頻模型永遠無法外推。論文的“基於案例”解釋來自行為診斷,不是直接讀出了內部檢索算法。1
本篇據此提出的判斷是:先問測試樣本到底新在哪裡。“訓練中沒有這一條錄像”,只排除了完全相同的樣本;“已有對象的新組合”也不同於“速度超出訓練範圍”。若論文把三者混稱為未見場景,泛化結論就會被放大。反過來,範圍外失敗也不能抹去範圍內學到的有效關係。
真實錄像更貼近世界,但評分仍是代理
Physics-IQ用真實物理場景檢驗後續視頻,給單幀模型一幀,給支持多幀的模型一段上下文。它結合運動區域的空間、時間重合度與像素誤差,並用兩次真實拍攝間的差異進行歸一化。論文指出,視覺逼真與這些物理預測指標並不等價。2
這個分數不是“理解了多少百分比物理學”,也不是逐條檢查物理定律的通過率。作者明確承認指標是代理,鏡頭移動、切鏡等也會受罰;視覺逼真評估還受作為裁判的多模態模型能力限制。單幀與多幀的信息量不同,所以不能將模型總分直接解釋成架構的因果優勢。2
這提示一種讀論文的方法:把輸入信息、輸出目標和評分器一起讀。若模型預測的位置合理但時間錯位,空間指標可能不錯;若模型擅自換鏡頭,像素對齊會失效。研究者需要拆解失敗發生在狀態估計、運動預測還是輸出呈現,不能讓一個綜合分數承擔全部解釋。
推理時改善,究竟改變了誰?
2026年的WMReward使用V-JEPA 2的表徵預測信號,為生成候選打分或引導去噪。Best-of-N指生成多個候選再挑選。其PhysicsIQ實驗採用16個候選的搜索設置,報告加入該方法後若干條件下分數改善;生成器無需再訓練,但系統增加了獎勵模型與推理成本。3
論文也報告文生視頻中物理一致性與文本符合度的權衡,並承認獎勵模型對重量、摩擦等材料屬性仍有限制。本文采用可訪問的v2預印本,不把挑戰賽成績當會議錄用,也不把文中的歸一化分數當物理定律通過率。3
這裡最有用的推論不是“物理知識已完全藏在生成器裡”,而是默認輸出無法完整代表系統經搜索後的可達表現。若選片器帶來獨立先驗,改善應歸於組合系統。只觀察最後一條影片,無法區分生成器更懂物理、採樣更多或裁判更會識別錯誤三種貢獻。
| 證據來源 | 受控對象 | 支持的觀察 | 尚不能證明 |
|---|---|---|---|
| PhyWorld研究[1] | 合成參數、訓練分佈 | 泛化類型影響結果 | 一切模型的外推上限 |
| Physics-IQ[2] | 真實錄像續寫與評分 | 逼真與預測表現需分開測 | 分數直接代表因果知識 |
| WMReward[3] | 獎勵與推理策略 | 系統輸出可因搜索改善 | 生成器獨自掌握全部規律 |
三篇工作的模型起點、訓練數據、推理預算和指標不同。受控速度誤差不能與真實錄像綜合分數排在同一榜單;搜索系統也不能與單次採樣混作等成本比較。它們是互補診斷,並非相互推翻的兩派。
更能區分解釋的下一步
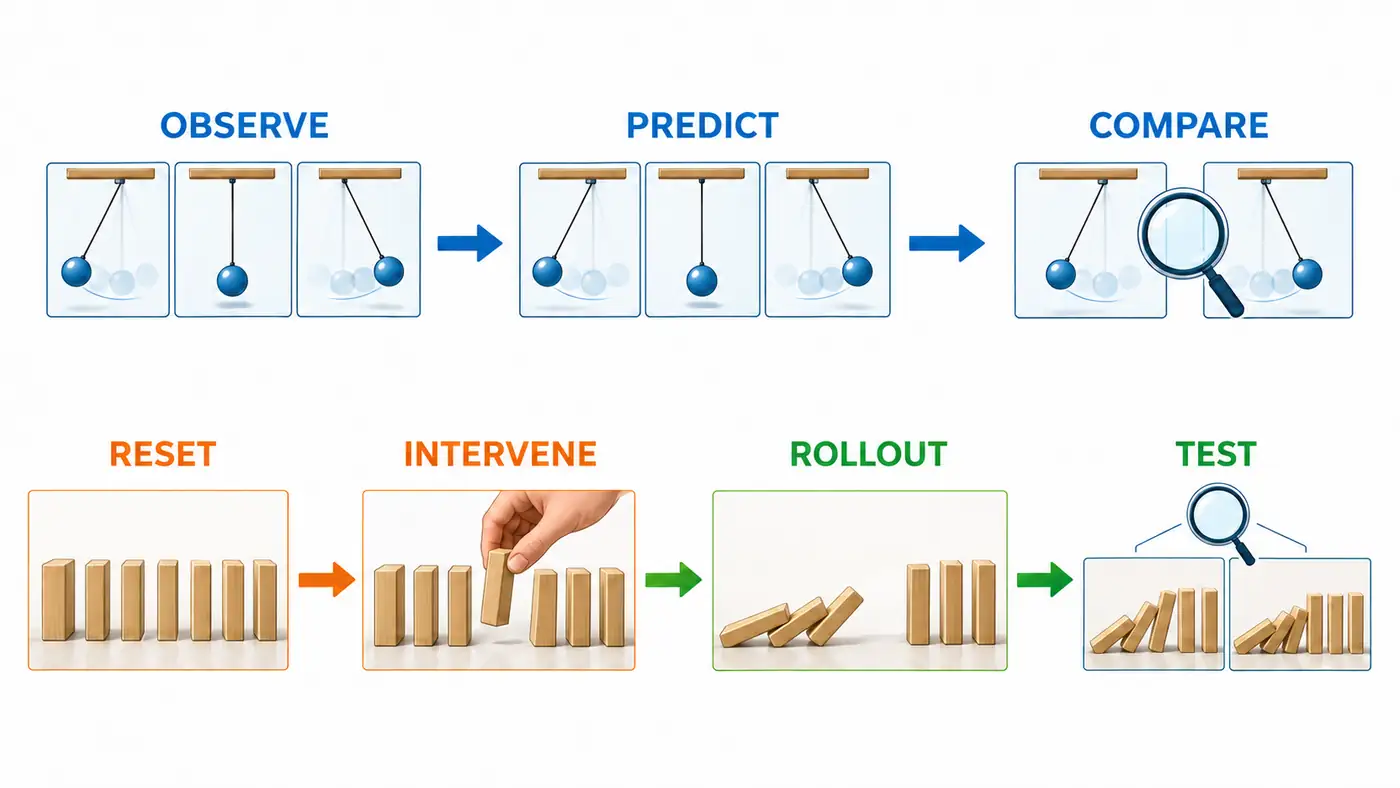
圖:原創測試流程示意,上排檢查觀察後的預測,下排檢查重置、干預後的響應。箭頭只表示評測順序;骨牌是概念圖標,不是模擬數據。右下兩幅表示待比較的候選結果,不宣稱任何論文已經通過這些干預。
下面是尚未執行的研究設計。目標不是再做一個“看起來更好”的展示,而是在同一模型上製造競爭解釋會給出不同預測的條件。
第一,建立成對干預集。用可記錄狀態的簡單環境,同時保存圖像和參數。把顏色、光照作為外觀因素,把初速度、摩擦作為動力學因素,獨立改變並交叉組合。訓練與測試按參數區域及組合分開,防止同一軌跡僅換顏色便跨越劃分。若換色帶來大幅軌跡變化,而改變摩擦卻幾乎無響應,統計捷徑解釋會得到支持;若響應方向和幅度都合理,才能積累關係遷移的證據。
第二,固定候選池比較選擇器。對相同初始條件保存全部隨機種子和候選,分別用隨機挑選、外部獎勵與環境真值評分。真值選擇只作為診斷上限,不能偽裝成部署結果。若真值能挑到好候選而獎勵模型不能,瓶頸更接近選擇;若池中沒有好候選,還需要擴大預算或改變生成器,不能僅憑有限失敗斷言其概率為零。
第三,做重置後的動作分叉。讓系統從同一狀態預測“移走阻擋物”和“保留阻擋物”的後續,再與環境實際執行比較。控制接口必須記錄動作發生的時刻、作用對象與執行結果。只改變文字描述、無法確認環境是否執行的試驗,回答不了動作因果問題。
這些試驗還應預先約定誤差口徑、測試時長與失敗處理:物體出畫、解析失敗、拒絕生成要單獨計數,不能悄悄丟棄;圖像到狀態的解析器要先在真實或模擬真值視頻上校準。多幀輸入和單幀輸入分別報告,採樣次數與總計算預算一起保存,避免把測量誤差、更多信息或更多計算誤判成理解提升。
當前結論與仍然開放的問題
現有證據足以反對一種過強推斷:生成逼真視頻,就已經獲得普遍的因果世界模型。證據也沒有支持相反的絕對判斷:視頻預測只能記憶,規模與推理策略都不可能有用。更穩妥的結論是,把能力綁定到具體狀態、干預範圍、信息條件和預算上。
真正值得追問的不是名稱是否配得上“世界”,而是失敗在哪一層。能否識別狀態,能否響應干預,能否保持長時一致,能否知道信息不足,是不同問題。把這些問題拆開,研究生才可能提出能被實驗否定的解釋,而不是在成功樣例和失敗剪輯之間選邊。
總結
視頻預測提供了學習動力學的訓練信號,也提供了觀察模型行為的窗口;它本身不自動完成因果驗證。讀一篇世界模型論文時,先確認它改變了什麼、固定了什麼、測量了什麼,再判斷證據支持的是合理畫面、準確預測還是可遷移的干預響應。本文不聲稱全面覆蓋截至檢索日的研究,也未執行模型復現。
參考資料
資料檢索及截止日期:2026-10-31。近12個月檢索用於補充新證據,同時保留解釋問題所需的早期研究。
- Bingyi Kang、Yang Yue、Rui Lu、Zhijie Lin、Yang Zhao、Kaixin Wang、Gao Huang、Jiashi Feng. How Far Is Video Generation from World Model: A Physical Law Perspective. ICML 2025;正式發表頁,本文方法與結果核驗採用arXiv v2全文(2025-06-22)。
- Saman Motamed、Laura Culp、Kevin Swersky、Priyank Jaini、Robert Geirhos. Do generative video models understand physical principles?. 2025,arXiv v3全文(2025-02-27)。檢索發現WACV 2026正式頁面線索,但頁面與PDF訪問受限,本文實驗描述嚴格限於已讀v3。
- Jianhao Yuan、Xiaofeng Zhang、Felix Friedrich、Nicolas Beltran-Velez、Melissa Hall、Reyhane Askari-Hemmat、Xiaochuang Han、Nicolas Ballas、Michal Drozdzal、Adriana Romero-Soriano. Inference-time Physics Alignment of Video Generative Models with Latent World Models. 2026,arXiv v2全文(2026-02-27),按預印本引用,未確認會議錄用。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發了兩款日常小工具,歡迎按自己的需要了解:
- 日常收支小記:記錄日常收支,安排預算和儲蓄目標,讓每筆賬有跡可循。在 App Store 瞭解。
- 一事微光:根據當下的時間、精力選擇小行動,記錄完成後的感受,留下一份日常復盤。在 App Store 瞭解。
更多技術文章和個人作品,歡迎訪問作者個人網站。這些作品與本文所述論文沒有背書關係。