- 日期:2026-10-27
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-27;檢索近12個月工作並保留必要經典研究。本文是文獻深讀,未運行模型糾錯實驗,不聲稱全面覆蓋。
摘要:第二次回答,憑什麼更可信?
讓模型“再檢查一遍”,它常會寫出一段反省,再換一個答案。讀者容易把這個過程理解為:模型發現了錯誤,所以修正了錯誤。但同樣的表象也可能來自重新採樣、提示中的暗示,或者執行器提供的新信息。答案變了,只能證明發生了修改。
**本文的判斷是:自我糾錯需要同時考察錯誤識別、修改能力與保留正確答案的能力;不同反饋和訓練條件下的結果,不能合併成一句“反思有效”或“反思無效”。**Self-Refine、Huang等、CRITIC與SCoRe的主要差別,首先在於任務與信息條件,而非各自屬於哪個陣營。相關定義與設置:Huang等§2–3。
本篇追問的是一次作答之後怎樣決定改不改,不討論把自生成材料重新用於訓練的完整閉環,也不重複多智能體分工的預算比較。
“自己改”至少包含三件事
內在自我糾錯指推理時沒有收到新的檢索結果、工具反饋或正確性標籤,由模型根據題目和已有輸出再作判斷。它不意味著模型從未接受人工數據或獎勵訓練。外部反饋則是此次修改新增的觀察,例如執行報錯、網頁證據,或者“這個答案錯了”的標籤。
還要區分生成新候選與選擇最終答案。即使第二份答案更可能正確,系統仍須決定是否替換第一份。反過來,即使候選中存在正確答案,系統也未必能認出來。一個知道標準答案、只讓錯題進入修改的評測器,已經替模型完成了部分判斷;這種知道真值的設置通常叫oracle。
為避免把不同機制混在一起,可以提出三種競爭解釋。第一,重新計算或改用另一條路徑就足以帶來收益,自評文字未必是必要原因。第二,模型確實利用了自己的批評定位錯誤,收益依賴批評內容。第三,新增的工具觀察或正確性信號改變了可用信息。它們可能同時存在,需要分別干預,不能憑一條成功對話確定哪一種主導。
直觀地說,把解題稿重新謄寫一次、指出哪一步不成立、用計算器檢查中間結果,是三個不同動作。最後都可能得到正確答案,但科研問題是:去掉其中哪個動作,改善就會消失?
看似對立的論文,究竟比較了什麼?
Self-Refine:改善輸出不等於普遍識別推理錯誤
Self-Refine讓同一模型依次生成、反饋和修改,不額外更新權重;反饋提示包含任務示範。其任務覆蓋對話、代碼和約束生成,評價既有任務分數,也有偏好判斷。正式論文表1中,GPT-4數學解題率由92.9變為93.1,與若干生成任務的大幅改善不是同一種證據。Madaan等,§2–3、表1。
因此,不能把跨任務的平均提升解釋成“模型能可靠發現自己的邏輯錯誤”。另一方面,數學收益很小也不抹去改善表達或滿足約束的價值。論文附錄K.1還把使用正確性信息的數學結果單獨列出,不能與普通自反饋混用。這裡真正需要統一的是測量對象,而不是口號。
Huang等:停止規則會偷偷帶入答案信息
Huang等對照了有oracle標籤和無外部反饋的修改。前者答對就停止,後者必須自己決定。在其GPT-4的GSM8K子集上,標準提示為95.5%,oracle修改為97.5%;內在修改第一輪為91.5%。這些是論文當時的固定設置,GPT-4使用抽樣的200題,不能當作今天模型的普遍上限。§3.1–3.2、表2–3。
這個對照揭示:不給模型完整答案,也可能洩漏足以保護正確解的信息。它並不證明重新檢查在所有任務上必然有害。初始提示是否充分、修改提示是否暗示“一定有錯”,也應成為實驗條件,而不是藏在方法名稱後面。
CRITIC:工具提供了新的觀察,但沒有接管全部判斷
CRITIC把搜索、代碼解釋器等接入批評過程。問答實驗中的無工具消融移除搜索接口,讓模型自行生成證據;完整方法在相應設置中表現更好。需要注意,普通CRITIC與帶星號、只修改錯誤樣本的oracle版本是分開的。Gou等,§3–4.1、表1。
這支持外部觀察具有價值,卻不能證明收益全部來自模型的自省。搜索結果還需判斷相關性,程序成功執行也不保證題意被正確建模。工具消融同時改變可見信息與交互成本;它不是在保持一切資源相同後,只切換一個抽象“反思能力”。論文附錄A也保留了提示、延遲與任務泛化限制。
SCoRe:測試時獨立修改,可以是訓練後的能力
SCoRe採用兩階段強化學習:先讓後續嘗試學會改善,再用獎勵塑形鼓勵有效糾錯、抑制把正確答案改錯。訓練獎勵來自數學答案匹配或代碼測試;測試修改提示不揭示首答是否正確。Kumar等,§3、§5–6。
正式論文表2中,Gemini 1.5 Flash起點模型兩次作答為52.6%與41.4%,SCoRe訓練後為60.0%與64.4%。這是MATH500留出評測;訓練加入原MATH測試集中的另外4500題。不能拿這些數字直接與別處的完整原始測試集排名,也不能把訓練前後首答和修改收益混為一項。§6、表2。
本文據此作出的有限推斷是:“普通提示未穩定誘發”不等於“無法訓練獲得”。但訓練後無需逐題反饋,與訓練過程中沒有外部監督,是不同主張。
| 路線 | 需要先固定的條件 | 觀察主要支持什麼 | 仍不能證明什麼 |
|---|---|---|---|
| Self-Refine | 任務、提示、偏好或正確性指標 | 一些輸出可通過反饋迭代改善 | 各類推理錯誤都能被識別 |
| Huang等對照 | 是否用真值決定停止 | 判斷與停止會改變淨收益 | 所有模型永遠不能糾錯 |
| CRITIC | 工具、示範、普通或oracle模式 | 外部觀察可幫助修改 | 增益全部來自內在反思 |
| SCoRe | 訓練獎勵、起點和留出劃分 | 專門訓練後可獲得修改收益 | 無監督自省或通用遷移 |
這些論文沒有共享模型起點、訓練數據與總預算。表格用於對照證據條件,不用於排列誰的準確率最高。
總分之外,要看哪些答案被改壞了
2026年9月,Tianzhu Zhang的預印本進一步區分“錯改對”與“對改錯”,並研究何時調用修改過程。本文采用其轉移統計視角,但不把選擇器收益當作已確立結論:作者承認部分歷史結果尚未對應到凍結配置及互不重疊的樣本ID,獨立評測證據不完整。§2.3、§4.2、§6。
對同一批題目、固定解析器和二元正確性判定,準確率變化滿足:
其中是全部題數,兩個分別是兩類轉移的題數;這是計數恆等式,不是本次模型實驗。它說明同一個淨增益,可以來自保守地修好少量錯誤,也可以來自大量修復與大量破壞的抵消。
還應分別報告:初始錯題中多少被修復,以及初始對題中多少被破壞。二者分母不同,不能把百分比直接相減;某類初始樣本為空時,對應條件率應記為未定義。首答越可靠,潛在可修復的題越少,對正確答案的輕微擾動就越值得重視;這是基數變化帶來的風險,而非高能力模型一定不適合修改。
這篇預印本也提示了另一層邊界:缺失答案怎樣計分、KEEP/CHANGE如何落實、推理是否被預算截斷,都可能改變轉移統計。§2.1–2.2。因此,“最終答案更好”仍需建立在相同題目與解析規則上;不能只留下可解析、改成功的樣本。
一個能區分解釋的後續實驗
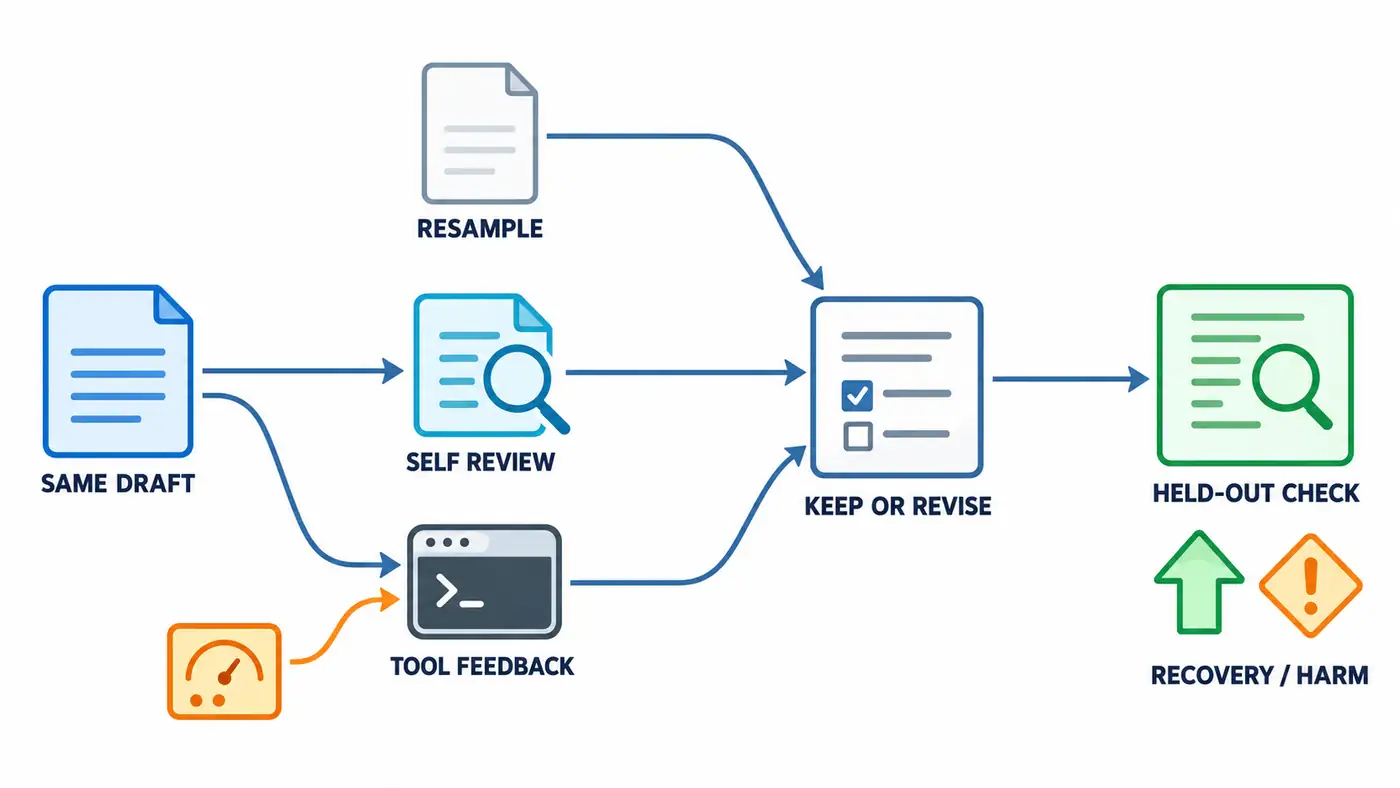
圖:這是本文提出、尚未執行的實驗框架。三條路線分別運行,不把候選合成一個更強系統;重採樣不看舊稿,自評和工具路線接收同一份舊稿。橙色箭頭表示新增外部觀察,右側只負責留出評價、不反饋真值;綠色與橙色符號代表修復和破壞兩類結果,沒有表示測量趨勢。保留原答案的基線未單獨畫出。
研究生可以先選擇一個有明確判分規則的小任務,固定模型版本和題目集合,保存每題首答,再做三個對照:不看舊稿重新作答;看舊稿、生成具體批評再修改;看同一舊稿並加入真實工具反饋。另保留不作修改的基線。所有路線使用同樣完整的任務說明,避免第二輪才補充要求。
第一輪比較應固定修改次數與輸出規則,默認接受各路線的新答案,先測生成階段的變化。第二輪再引入“保留還是替換”的選擇規則,分別與始終保留、始終替換比較。若一開始就用真值挑贏家,就無法判斷模型究竟學會了什麼。
預算也要分層記錄。相同調用次數不代表相同token數:批評、歷史上下文與工具返回都會消耗資源。可以同時報告固定總token上限下的結果和實際延遲,把外部調用費用另列;因預算截斷而失敗的樣本必須保留。機制比較與效率比較可以是兩個實驗,不必假裝一張表已經把二者都控制住。
要進一步檢驗批評是否有因果作用,可在開發階段設計正確批評、來自其他題目的批評及不含診斷內容的等長文字對照,再凍結設計。若打亂批評仍有相近改善,至少會削弱“具體診斷內容導致修復”的解釋;若只有真實工具反饋有效,則應繼續檢查新增信息是否足夠、錯誤反饋會不會反向誤導。任何結果都還需要跨題型驗證。
最後,用互不重疊的數據開發選擇規則和評價規則,保存每題轉移、原始輸出、解析失敗與停止原因。評分所需的隱藏答案或測試只能用於最終評價。需要人工判斷過程正確性時,應由真實標註完成,不能用模型自己的認可冒充語義金標。本篇沒有執行這些實驗,所述均是可檢驗設計。
總結:把“反思”拆成可測的動作
目前更穩妥的結論是:重寫可能有用,工具反饋可能有用,專門訓練也可能使修改更有效;它們並不自動證明同一種內在機制。閱讀論文時,先確認誰提供信息、誰決定停止、誰選擇最終答案,再檢查修復與破壞是否都被計算。
下一步值得驗證的不是模型會不會說“我錯了”,而是:在預算和信息受控時,它能否找到值得修改的答案,並保住已經正確的答案。這會把一段動聽的反省,轉化成可以被支持或被推翻的研究主張。
參考資料
- Aman Madaan 等,2023,Self-Refine: Iterative Refinement with Self-Feedback。NeurIPS 2023正式論文。
- Jie Huang 等,2024,Large Language Models Cannot Self-Correct Reasoning Yet。ICLR 2024正式論文;初版預印本發表於2023年。
- Zhibin Gou 等,2024,CRITIC: Large Language Models Can Self-Correct with Tool-Interactive Critiquing。ICLR 2024正式論文。
- Aviral Kumar 等,2025,Training Language Models to Self-Correct via Reinforcement Learning。ICLR 2025正式論文;初版預印本發表於2024年。
- Tianzhu Zhang,2026,When Should LLMs Trust Their Own Revisions? A Risk-Aware Study of Intrinsic Self-Correction。arXiv:2609.35832v1,2026-09-23,預印本,未確認正式錄用。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發了一些日常小工具,歡迎瞭解:
- 日常收支小記:記錄日常收支,安排預算與儲蓄目標,讓每一筆錢的去向更清楚。在 App Store 瞭解。
- 一事微光:按當下的時間和精力選擇小行動,記錄完成後的感受,為日常行動與復盤留下一點線索。在 App Store 瞭解。
更多技術文章與個人作品,歡迎訪問我的網站:zffjzz.top。這些作品與本文所引論文沒有背書關係。