- 日期:2026-10-25
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-25;檢索近12個月工作,並保留爭議所需的早期研究。本文為證據深讀,未執行模型實驗,不聲稱全面覆蓋。
摘要:團隊贏了,誰貢獻了增益?
讓幾個模型先回答、再討論、最後投票,分數超過一次作答,聽起來很像集體智慧。但這個比較同時增加了嘗試次數、可讀文本和選擇答案的機會。即使成員從未交流,只把獨立答案彙總,也可能得到收益。
本文對照四項研究,追問三個可區分的問題:**多采幾次是否足夠,交換理由是否進一步有效,明確分工是否減少重複工作?**現有證據支持把獨立採樣視為強基線,也保留某些交流與彙總配置更有效的可能;尚不能把所有團隊收益都解釋為分工,更不能把某個基準上的無收益推廣為協作無用。研究起點見Choi等、效率對照見Wunderlich等。
把“多智能體”拆成三個動作
這裡的智能體可以是同一模型的不同會話,並不必然擁有不同權重或知識。自一致性是獨立生成多條解答,再按最終答案投票;多智能體辯論讓成員讀取同伴輸出並修訂;分工則把問題分成互補子任務,最後合成結果。三者可能組合,卻不是同一變量。
可以用一個假設場景理解差異:幾位助手都檢查同一段論證,再投票,這是重複嘗試;交換各自發現的反例,是信息交流;分別核對定義、推導和適用條件,才接近任務分工。這個例子不是本次實驗,也不保證最後一種最好。若定義核錯了,後續推導與條件核查還可能共同建立在錯誤前提上。
“專業身份”也不等於專業能力。給同一個模型貼上數學家、審稿人、工程師的標籤,只證明提示不同;若要聲稱形成互補專長,還需觀察他們在不同子任務上的穩定優勢。相反,沒有角色名稱的模型也可能通過工具或不同證據獲得互補信息。
因此,本篇把成功軌跡當作需要解釋的觀察,而不是機制的直接證明。最終答案正確,不能告訴我們成員是在糾錯、追隨多數,還是彙總器恰好選中了原來就存在的正確候選。
四項研究,各自比較了什麼?
投票已經拿走了多少收益?
Choi等的NeurIPS 2025論文把初始答案投票與後續辯論分開。主比較固定五個成員,在同一批題上評估Qwen2.5-7B-Instruct與Llama3.1-8B-Instruct;辯論並未穩定超過初始投票。**這裡固定的是成員數,並沒有把省下的辯論預算重新分給投票組。**它能顯示初始集成很強,卻不是全部成本配置的最優性證明。§2–3、表1
論文還建立了理想化信念更新模型。其定理要求鄰居的平均正確答案信念等於當前成員的信念,才得到下一輪期望不變。不能把這一有前提的結果改寫成“任何真實語言模型討論都不可能增益”。真實交流能否引入可驗證的新理由,是另一個經驗問題。§4、定理2
配置選得合適,交流仍可能有價值
Wunderlich等在ACL 2026學生研究工作坊論文中,對採樣、反思、辯論及分層彙總比較準確率與成本。分層彙總稱為MoA:多份提議逐層合成,最後輸出答案;它並不自動等同於專業分工。主實驗使用Llama 3.1 70B和一千道抽樣題,在所測MMLU-Pro配置中,採樣、辯論、MoA的最高準確率分別為68.7%、70.0%、71.4%。§3–4.1、圖2
關鍵限定是:這些點處於可比的估算預算,不是逐題耗時完全相同。成本模型計入浮點運算與顯存搬運,使用特定量化、批處理和硬件假設;它不是實測端到端延遲。論文也承認抽樣不確定性。因此,結果為部分配置提供支持,不能據此保證每個差值顯著,或保證換模型、硬件後排序不變。附錄B、Limitations
生成次數相同,也不代表賬單相同
Ferreira等2026年9月的預印本,讓三名成員各運行三輪,並用九次獨立採樣對照。在其小型開放權重模型池和所測離散任務上,辯論沒有表現出穩定的額外優勢。正文所說的匹配首先是生成次數匹配;讀取同伴文本仍帶來額外輸入成本。稿件標註投稿ICLR 2027,本次未核實錄用。§3.2、§5.1、表1
一個值得學習的糾偏是:部分長推理模型的討論記錄擠滿服務上下文,導致末輪空輸出。擴大窗口並重跑受影響配置後,原先部分劣勢接近消失。這說明失敗可能來自實現容量。其極端角色提示也不等於任務專長訓練,不能用該結果否定所有分工方式。§5.5、§7
能答題,不等於能共同執行
Kim等正式發表於Nature Machine Intelligence的研究,把比較擴展到需要工具反饋的任務。在六個基準、五類架構的配置中,金融分析與順序規劃呈現不同方向的協作效果。正式版說明匹配的是系統級推理token預算上限和工具訪問,迭代次數主要是終止上限;實際消耗仍可能不同。Main results、Methods
作者以可拆分程度解釋部分差異,但跨基準比較也同時改變了環境和評分方式;本篇不把它當作對“分工機制”的單變量識別。論文還明確限制跨領域絕對成績預測,部分驗證子集僅二十題。它提供了任務依賴的證據,沒有給出普適協作門檻。Robustness and sensitivity analysis、Discussion
| 研究切口 | 控制或成本口徑 | 主要觀察 | 不能直接推出 |
|---|---|---|---|
| 初始投票與辯論 | 固定成員數 | 初始集成是強基線 | 討論永遠無效 |
| 配置效率比較 | 估算計算與搬運時間 | 部分彙總配置佔優 | 專業分工已被識別 |
| 辯論與重複採樣 | 固定生成次數 | 交流優勢不穩定 | 總token、延遲相同 |
| 工具交互架構 | 系統預算上限 | 任務間效果不同 | 新領域的統一規律 |
表中各行對應上述論文;任務、模型起點、抽樣與計分不同,不做跨論文分數排名。第一項是NeurIPS正式論文,第二項是ACL學生研究工作坊論文,第三項仍是預印本,第四項採用正式期刊版本。
爭議真正落在“預算”和“信息”上
這些研究不構成簡單的正反陣營。固定成員數,問的是現有團隊討論後怎樣;固定生成次數,問的是調用機會如何分配;固定系統預算上限,問的是資源受限時什麼架構有效;比較效率前沿,則是在已試配置中尋找準確率與成本的折中。問題不同,結論可以同時成立。
效率前沿可以直觀理解為:在已測試的方案裡,沒有另一個方案同時更便宜且更準。但它依賴搜索過哪些配置。若只細調團隊、卻只給單體一次嘗試,前沿會偏向團隊;若只測試一種笨重討論協議,也不能代表全部交流機制。配置選擇本身應使用開發集,隨後凍結方案,在獨立測試集上比較。
成本至少應區分生成與讀取。多個成員每次都重新讀完整歷史,即使最終輸出同樣短,也可能消耗更多資源。並行執行可以縮短等待時間,卻未必減少總計算;同樣的token數量跨不同模型也未必對應同樣成本。研究者應先說明自己限制的是調用次數、總算力、延遲還是花費,避免結論在這些含義之間滑動。
信息同樣需要記賬。如果團隊多拿了數據庫、額外檢索結果或更強裁判,它贏的是一個包含這些資源的系統。要問“通信本身是否有效”,必須讓對照有機會獲得同樣的證據。要問“分工是否有效”,則要進一步控制證據總量,只改變誰先看什麼、如何分配任務與合成答案。
一個能區分解釋的後續實驗
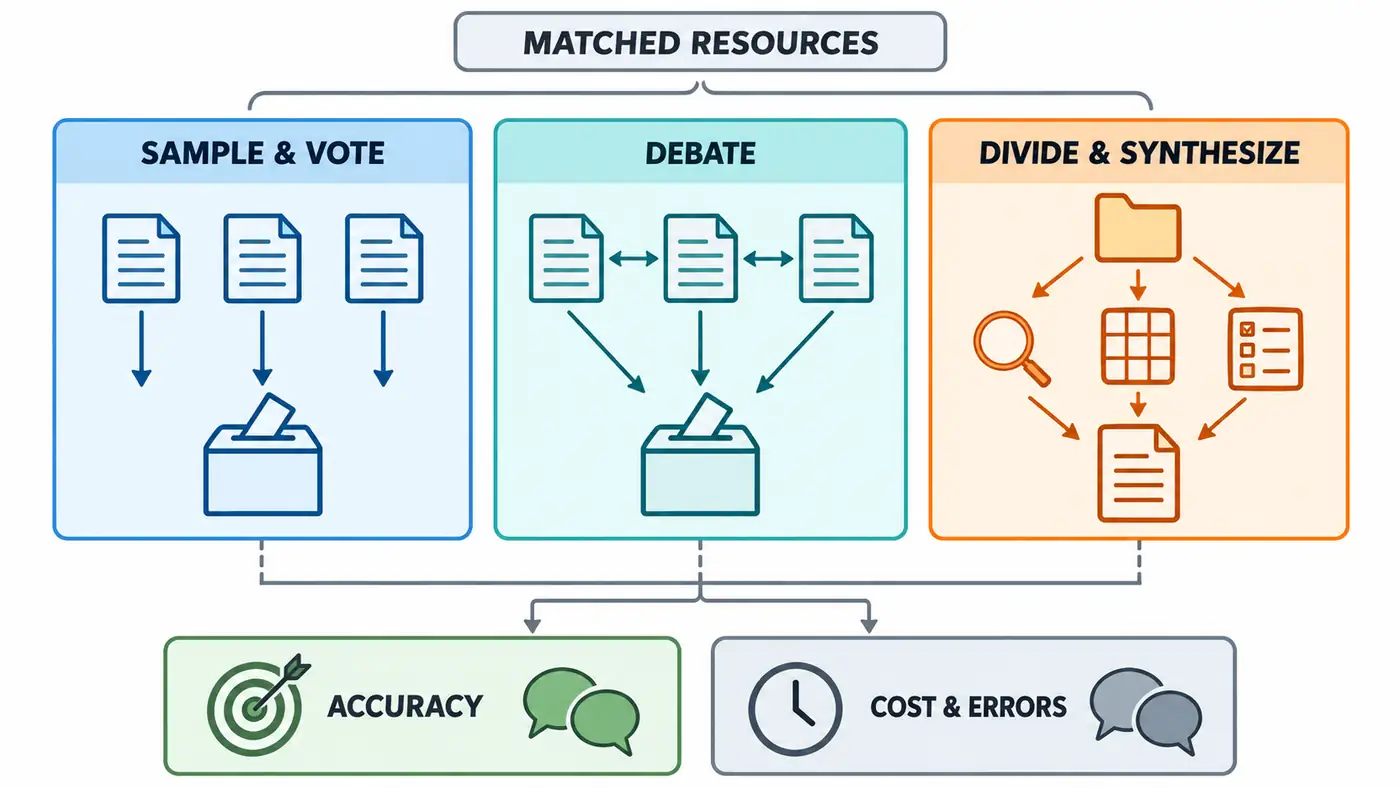
圖示為本篇提出的比較框架,未執行。實線表示預設信息流,虛線連接共同觀測指標;三條路線不是已經證實的因果機制,也不暗示哪條獲勝。頂部資源匹配須落實為明確預算規則,並額外保留單體基線。
可以從一類答案可核驗、又能拆成子問題的任務開始,先固定模型檢查點、題目劃分、證據池、工具權限、解碼和評分器。保存一組初始候選,再構造三條路線:獨立採樣後投票;讀取相同候選後互相修訂;按預先定義的互補子任務處理後合成。另給單體相同的總資源,讓它自行規劃、檢驗與修訂。
這裡最好分開做兩種實驗。機制實驗複用同一批初始候選,研究交流究竟改了什麼;效率實驗允許各方案在同一總預算內自主分配採樣與交流。前者更便於歸因,但不代表最優配置;後者更貼近資源取捨,卻不能僅靠總分定位機制。把兩者混成一張榜單,會重新引入最初的問題。
接著做針對性干預。對辯論組,比較真實理由、只顯示答案、以及長度相近但與當前題不相關的理由。若只有真實理由產生額外糾錯,才更支持內容交換有貢獻;若只顯示多數答案也一樣有效,應考慮答案聚合或從眾的解釋。無關理由可能製造額外干擾,因此仍要保留完全無通信的對照,不能只比較“真實”和“亂序”。
對分工組,保持證據並集不變,比較按子任務分配、隨機分配以及每人看全部證據。還應讓單體執行同一份分解方案:否則團隊優勢可能來自更好的任務說明,而非多主體協作。刪去角色名稱但保留實際分工,也能檢查名字與工作內容各自的影響。這裡的分配規則都應在看測試答案之前確定。
除最終正確率,還需保留逐題軌跡:初始候選有沒有正確答案,哪些錯誤被修正,哪些正確答案被改壞,成員是否重複查同一證據,合成時是否丟失關鍵約束。答案一致率只能衡量共識,不能替代正確性。把糾正與破壞分別統計,才不會讓平均提升掩蓋特定類型的傷害。
最後預先規定資源耗盡、工具失敗、空答案和上下文溢出的處理方式,按題做配對比較,跨隨機種子檢查穩定性。若選擇配置時已經看過某批題,就不再把它當獨立驗證集。這些都是未來實驗設計;本文沒有運行這些路線,也沒有產生新的準確率。
總結:從“人多”走向可反駁的解釋
判斷多智能體的研究價值,不必先相信團隊優越,也不必先否定協作。更有用的順序是:先證明收益超過獨立採樣,再檢查真實信息交換是否貢獻糾錯,最後驗證任務分配是否在相同證據與資源下減少重複、保留約束。
目前更穩妥的結論是,採樣、通信、彙總和分工需要分別舉證。一個系統確實更準,可以是有價值的結果;只有讓競爭解釋接受同樣嚴格的對照,才能進一步回答它為什麼更準、收益何時會消失。
參考資料
- Hyeong Kyu Choi、Xiaojin Zhu、Sharon Li(2025),Debate or Vote: Which Yields Better Decisions in Multi-Agent Large Language Models?。NeurIPS 2025正式版。
- Florian Valentin Wunderlich、Lars Benedikt Kaesberg、Jan Philip Wahle、Terry Ruas、Bela Gipp(2026),Multi-Agent Reasoning Improves Compute Efficiency: Pareto-Optimal Test-Time Scaling。ACL 2026 Student Research Workshop;正式全文。
- Leonardo Ferreira、Gardenia Liu、Kaden Zheng(2026),Beyond Symmetric Agents: Cognitive Diversity and Multi-Agent Debate in Small Language Models。arXiv v1,2026-09-26;投稿狀態不等於錄用。
- Yubin Kim等(2026),Capable language models can outgrow the benefits of collaboration。Nature Machine Intelligence 8,1157–1172;早期預印本題為Towards a Science of Scaling Agent Systems。作者代碼維護記錄說明分析腳本已修正默認配置集合;本文未運行其代碼,也不將已發表數值冒稱為本次復現。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發了兩款讓日常更有條理的小工具,歡迎瞭解:
- 日常收支小記:記錄日常收支,安排預算與儲蓄目標,讓每一筆錢的去向更清楚。在 App Store 瞭解。
- 一事微光:按當下的時間和精力選擇小行動,記錄完成後的感受與發現,給日常復盤留下一點線索。在 App Store 瞭解。
更多技術文章與個人作品,歡迎訪問我的網站:zffjzz.top。也歡迎分享使用感受,幫助這些小工具慢慢改進。