- 日期:2026-10-24
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-24;檢索覆蓋近12個月相關工作,並保留方法起點。本文是文獻深讀,未運行模型實驗,不聲稱全面覆蓋。
摘要:先問“加圖”究竟加了什麼
把一批文檔整理成圖,再回答跨文檔問題,成績提高了。我們容易把結果解釋為“關係建模起作用了”。但建圖通常還會抽取事實、生成描述、合併實體、預先總結文檔,並改變查詢時的計算量。模型看到的內容和獲得內容的過程,都可能一起變化。
**當前證據支持某些圖增強系統在特定任務上的價值,卻不足以把全部收益歸給圖的連接結構。**本文用原始GraphRAG、HippoRAG 2和一項更新至2026年的系統評估,分別考察全局概括、圖引導檢索和預算對照。原始研究、HippoRAG 2、系統評估的任務和評測不同,不能拼成一張冠軍榜。
一條邊,不只是畫在兩個點之間的線
檢索增強生成,簡稱RAG,是先從外部資料找證據,再讓語言模型據此回答。圖增強方法把實體、段落等表示為節點,把關係或歸屬表示為邊。三元組是“主體—關係—客體”這樣的事實單位。圖的拓撲則是節點如何連接;它與節點上的文字、邊的語義標籤不是同一件事。
設想一個純說明性例子:材料甲說某研究者參與項目,材料乙說項目由某基金資助,問題問研究者關聯哪些資助方。按問題與段落相似度各自排序,可能只找到甲;沿項目節點擴展,有機會找到乙。不過,若一段預生成摘要已經寫出兩者的聯繫,即使不遍歷圖,也可能答對。這個例子沒有測量結果,只說明兩種可區分的解釋。
因此,至少要分開三條假設路徑。第一,連接幫助導航:正確關係使檢索器跨過詞面距離,找到缺失證據。第二,加工提高可讀性或覆蓋度:抽取、實體歸併和摘要讓答案更容易被檢索。第三,資源改變搜索機會:更多候選、更長上下文或額外模型調用提高成功率。它們可以同時成立,不必互相排斥。
“更多信息”也需說清:同一語料的摘要未必增加新的外部事實,卻可能增加某次回答實際看到的相關內容;抽取模型還可能混入自身知識。若不給生成內容保留原文出處,就無法分辨有效壓縮與未經支持的補充。這是本篇提出的歸因問題,不是對所有建圖系統的事實指控。
三項研究,回答的是三個層次的問題
**原始GraphRAG研究全局概括。**它從文本抽取實體關係,劃分連接緊密的社區,再生成社區摘要;查詢時分批作答、彙總。實驗既有向量檢索,也有直接對原文做分批匯總的TS基線。社區方案在部分全面性、多樣性比較中佔優,但v2的聲明計數及聚類指標沒有顯示它與TS存在顯著差異。這裡的“聲明”是可核查陳述的抽取單位,不代表每條已核實為真。§3–5,尤其§5.2
這項設計的價值是提醒我們:弱基線可能沒有機會看到全局。圖方案勝過局部檢索,不能直接證明連接本身不可替代;它與全文彙總的對照更接近這個問題。作者也將研究範圍限制在兩套語料上的全局問題,明確保留對虛構內容的進一步評估。較豐富的回答和較可靠的事實,仍是兩種測量。§4.1、§6.1
**HippoRAG 2把圖用於挑選原文段落。**它同時納入短語與段落節點,讓查詢匹配三元組,經語言模型過濾後,用個性化PageRank傳播相關性,再取段落作答。這個算法可以直觀理解為:從與查詢有關的位置出發,按連接分配訪問權重,而不是隻看每段文字單獨有多相似。§3
其多跳檢索消融顯示,去掉段落節點或改變查詢連接方式會影響召回;但查詢到節點的替代方案並未使用同樣的三元組過濾,過濾消融也不是每個數據集都改善。最終系統包含多個相互作用的部件,不能把整套系統與稠密檢索的差值命名為“純拓撲收益”。這裡的召回是找回支持段落的程度,也不同於最終答案正確率。表2–4、§6.1
**Han等的系統評估提供了更直接的預算檢驗。**在其Llama-3.1-8B、MultiHop-RAG設置中,普通RAG、補齊token預算的RAG和社區局部GraphRAG,總體準確率分別為67.02、69.33、69.01。補齊預算後,文本方案的總體分數已接近圖方案;不同題型仍有差異。這裡的token是模型處理文本的計量單位,等數量不等於等證據。附錄M,表31–32
這組結果不能證明圖無用,也不能證明剩餘差異就是圖關係的因果作用。它只改變了一個重要解釋條件:原先的前十個段落與前十個實體及其關聯內容,實際輸入量並不相同。預處理信息、索引和檢索過程仍有差別。論文還測試了更強文本檢索策略,不能把它概括成“只比較最樸素基線”。§3.4、§4.3、附錄M
| 證據切口 | 關鍵條件 | 能觀察到什麼 | 尚不能證明什麼 |
|---|---|---|---|
| 全局概括 | 社區摘要對照原文彙總 | 組織方式與指標相關的差別 | 所有優勢均來自連接 |
| 圖引導檢索 | 段落、查詢連接和過濾消融 | 部件改變後的召回變化 | 孤立的拓撲因果貢獻 |
| 輸入預算對照 | 同任務、同生成模型,補齊token | 部分系統差距收縮 | 等信息、等總計算下仍佔優 |
為什麼不能直接比較論文裡的分數
先看問題要求什麼。跨語料概括需要覆蓋多個主題;多跳問答需要湊齊一條支持鏈。一個答案包含更多視角,不等於它在資助關係問題上找對了全部節點。評價全面性的裁判偏好,也不能直接替代問答準確率。把這些任務都稱作“複雜推理”,會掩蓋真正的測試對象。
再看模型起點。HippoRAG 2主實驗使用Llama-3.3-70B與NV-Embed-v2;上述系統評估採用另一套建圖、嵌入和生成配置。因此,即使都使用某個同名數據集,也要繼續核對抽樣、語料範圍與提示。本文只在各篇內部解釋對照,不用跨篇數字判斷某個方法後來“退步”了。兩篇實驗設置、統一設置說明
還要區分資源的時間位置。建圖調用在索引階段付出,摘要可能被後續查詢複用;查詢擴展和過濾則在每次提問時發生。僅報告最後一次生成長度,會漏掉前面的工作。反過來,把一次建圖成本全部壓給第一道題,也可能誤判大量複用時的效率。更可解釋的比較應分別列出索引成本、每題成本、查詢數量與更新頻率。
這些區分導向一個有限結論:圖是組織和選擇證據的候選工具,系統成績是其有效性的起點證據;要解釋為什麼有效,還需要更細的干預。“關係有幫助”與“摘要有幫助”之間,現有研究並沒有形成必須二選一的陣營。
下一步實驗:讓競爭解釋給出不同預測
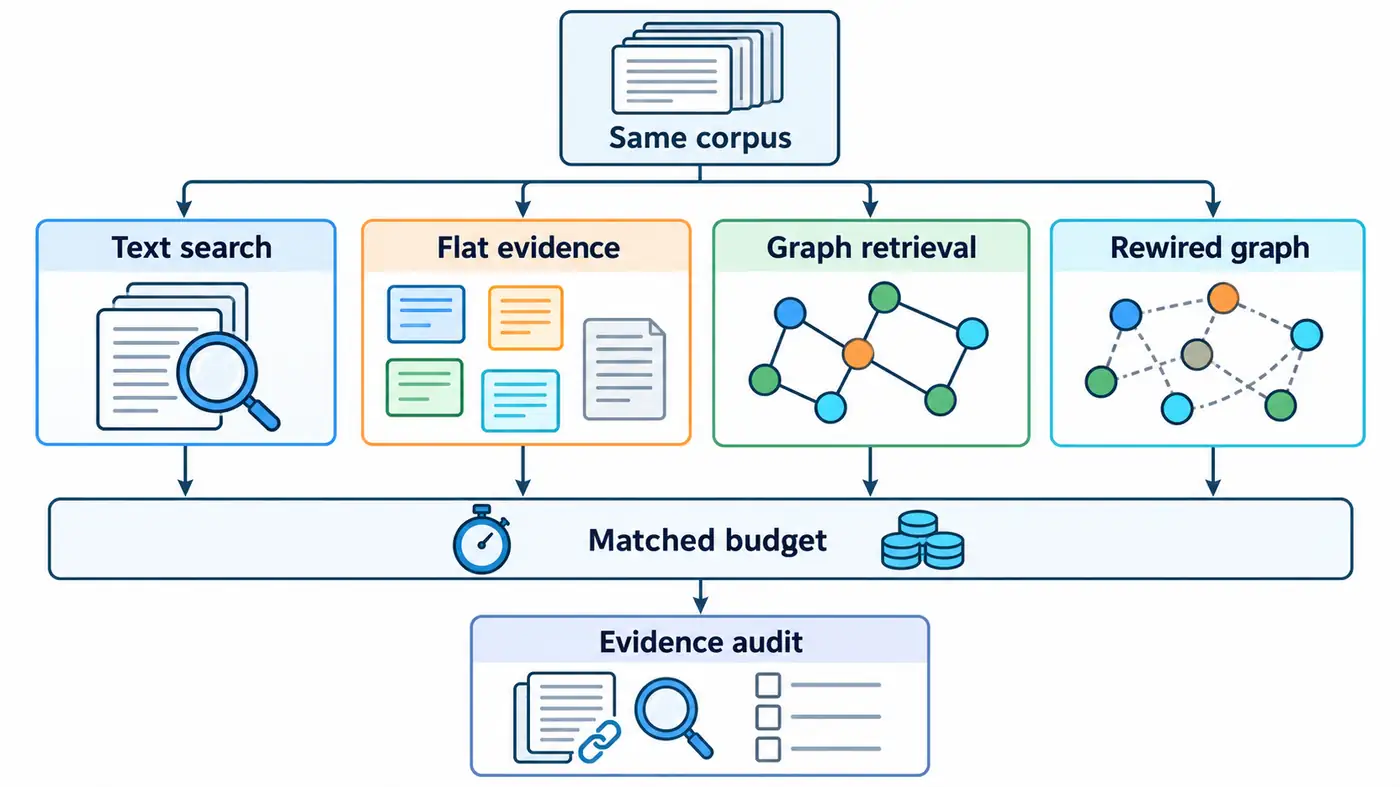
圖:本篇提出、尚未執行的四路對照。實線箭頭表示處理流程;右側虛線邊表示重連干預,不表示已觀測到的機制或效果。節點顏色僅為分組示意,不編碼概率或對應關係;公平控制以保存的數據為準。預算欄要求實驗開始前規定限制,圖中下置只是彙總呈現。
可以先固定一個語料快照和生成模型,設置四路:原文文本檢索;可訪問同批抽取事實與摘要、但不使用鄰接遍歷的平鋪檢索;完整圖檢索;保持節點文本、改變導航連接的圖檢索。第二路回答“信息加工是否已經足夠”,第四路回答“當前連接有沒有被有效利用”。它們與原文基線合用,才比單獨刪掉整張圖更有診斷力。
這裡有一個容易忽略的陷阱:關係文字本身也是信息。若重連同時改寫三元組內容,掉分可能來自讀到了錯誤事實,而不是失去導航結構。因此可先只干預檢索器使用的鄰接關係,讓最終答案仍依據可回查原文;明確不把虛假連接作為事實餵給生成器。隨後單獨開展關係語義干預,兩種實驗不要混報。
重連也不能隨意進行。應保留節點數量、適當的度分佈和候選訪問限制,並記錄斷連、可達距離等變化。否則,系統變差可能只是大量證據變得不可達。這樣的控制依然不完美,但它能讓“正確連接提供導航信號”的解釋比“破壞索引當然變差”更具體。
預算最好分兩輪處理。第一輪匹配最終輸入token和生成設置,考察證據選擇;第二輪匹配總模型調用或計算上限,把節省的預算給文本方案用於重排、多輪檢索。索引構建單獨記賬,並報告不同查詢次數下的攤銷。若某個對照無法同時滿足所有預算,應展示差異,而不是把“公平”當作一個沒有內容的標籤。
評測也應沿流程拆開:先看支持段落是否進入候選,再看是否湊齊跨文檔鏈,最後看答案與引用是否被原文支持。按直接事實、關係組合、全局概括和無答案問題分組,避免一種題型的增加改變總分含義。語義正確性若需要人工金標,就明確安排獨立標註;模型裁判只能作為另一種測量,不能冒充人工判斷。
測試題與建圖提示、過濾提示的開發數據應分開。可以利用公開數據中已有支持段落的題目,但要檢查答案是否被某份摘要提前直接寫出,並把這種情況單獨報告。它仍可能是合法的預處理收益,只是不能被當成查詢時沿邊推理的證據。
最後預先寫下結果如何解釋:平鋪方案追平完整圖,支持信息加工解釋;完整圖在等預算下仍領先,且適當重連後下降,更支持導航結構有用;只有增加調用時領先,則應把優勢表述為資源利用方式。任何一種結果都只約束該語料、任務和實現,不能宣判所有圖方法的價值。
總結:把系統收益拆成可以追問的貢獻
讀到“加入圖後提高”,可以繼續問:新增了哪些文字,改變了哪些連接,多做了哪些計算,最終量到的是覆蓋、召回還是正確性?這四個問題決定結論能走多遠。值得繼續驗證的不是圖是否天然優越,而是在同等信息機會下,哪些關係能讓證據更容易被找到、組合並核查。
參考資料
- Darren Edge等,From Local to Global: A Graph RAG Approach to Query-Focused Summarization,2024初稿、2025年v2。原文v2。本次按預印本引用,未確認正式發表記錄。
- Bernal Jiménez Gutiérrez等,From RAG to Memory: Non-Parametric Continual Learning for Large Language Models,ICML 2025。正式發表頁、本次核驗全文v2。正式PDF訪問失敗,方法和數值均以所讀v2為準。
- Haoyu Han等,RAG vs. GraphRAG: A Systematic Evaluation and Key Insights,2025初稿、2026年3月v3。原文v3。作者發表列表列為KDD 2026;本次未取得可獨立核對的會議收錄條目,ACM頁面訪問受限,不聲稱已閱讀正式終版。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發了一些日常小工具,歡迎瞭解:
- 日常收支小記:記錄日常收支,安排預算與儲蓄目標,讓每一筆錢的去向更清楚。在 App Store 瞭解。
- 一事微光:按當下的時間和精力選擇小行動,記錄完成後的感受,為日常行動與復盤留一點空間。在 App Store 瞭解。
更多技術文章與個人作品,歡迎訪問我的網站:zffjzz.top。也歡迎分享使用感受,幫助這些小工具逐步改進。