- 日期:2026-10-28
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-28;檢索近12個月工作,保留相關經典研究。本文為證據深讀,未運行模型實驗,不聲稱全面覆蓋。
摘要:一條走通的路,可能有不同來歷
智能體連續完成檢索、選取、填寫和提交,看起來像先想好了全程。然而,同一條成功軌跡,也可能來自反覆嘗試後留下的最好分支,或者每走一步都由環境提示下一步。結果是真的,關於結果如何產生的解釋卻還沒有確定。
本文對照形式化規劃、語言智能體樹搜索和規劃診斷研究。當前證據支持部分模型能生成有效行動序列,也支持外部搜索改善系統表現;但僅展示成功軌跡,不能確定收益來自模型預見、熟悉策略、候選篩選還是環境反饋。“規劃還是搜索”不是非此即彼:搜索本來就可以是規劃的實現方式,真正要追問的是誰在表示狀態、誰在提供未來、誰承擔失敗成本。形式化評測、網頁樹搜索
先分清目標、手段與證據
規劃,是尋找能夠從初始狀態到達目標的行動安排;搜索,是在多個候選狀態或行動序列之間展開、比較與捨棄。前者描述要解決的問題,後者描述一種求解手段。看到樹形分支,不能據此否認規劃;看到自然語言計劃,也不能據此確認模型進行了可靠的未來推演。概念背景
狀態表示回答“現在有什麼、哪些條件成立”;轉移規則回答“行動之後會改變什麼”。例如搬箱子之前必須空手,搬走箱子之後原位置會空出來。這裡是概念示例,不是論文中的實驗結果。模型若只會複述行動名稱,卻忘記上一動作改變的條件,仍可能生成語言通順但無法執行的計劃。
還要區分三種“未來”。模型預測是在行動之前推測後繼狀態;環境試探是實際執行一個候選,再讀取返回結果;符號模擬是根據給定規則計算後繼狀態。它們都能輔助選擇行動,卻擁有不同的信息來源。外部程序提供了精確轉移,不意味著這些轉移也已被語言模型獨立掌握。
因此,成功至少有三種可區分解釋:模型依據狀態與約束提前組織行動;模型調用熟悉的策略模板並適配當前對象;系統通過更多分支和反饋篩掉錯誤。三者可以共存。研究任務不是憑輸出風格選一個答案,而是設計改變條件後會產生不同預測的檢驗。
無工具生成有效計劃,是怎樣的證據?
Corrêa、Pereira和Seipp的研究在2026年修訂版中,用新生成的PDDL任務評測前沿模型。PDDL是描述動作條件、效果與目標的形式語言。模型每題一次嘗試,不啟用工具;生成結果交給VAL驗證器核驗。輸入還包括跨領域示例及提示清單。標準任務中,Gemini 3.1 Pro解出245/360題,Scorpion Maidu解出234題;符號名稱混淆後,前者解出231題。§2、表1–2、附錄B–C
這比展示幾段漂亮對話更有約束力:方案必須滿足明確規則,且測試實例是新生成的。它支持該模型在這些任務上具有可觀察的計劃生成能力,不能再用早期模型的失敗概括所有後續模型。
但論文測量的是“找到任意有效計劃”的覆蓋數,不是最短方案保證;模型調用與經典規劃器的資源也沒有配成等成本。正文概稱默認API設置,附錄另列採樣參數,因此本文以附錄限定協議,不把覆蓋領先寫成效率領先。
名稱混淆削弱了熟悉詞義的幫助,卻沒有抹掉任務結構。作者也觀察到模型能從結構認出部分領域。**本篇推斷是:新實例加上符號改名,能降低某些直接記憶解釋的可信度,卻不足以排除學過的結構性解法。**沒有在可見理由中說出領域名稱,也不能證明內部沒有利用相關先驗。§2“Information leakage”、附錄B
這不是貶低成績。使用已學算法解決新實例,本來就是有價值的泛化;只是“在已知結構上適配策略”和“在新規則下建立可用狀態模型”仍是兩個需要分別測量的問題。
加入樹搜索之後,成績屬於哪個系統?
LATS把語言模型生成動作、候選評估、樹搜索和反饋結合起來。其WebShop設置評測50條指令,LATS、重複ReAct和Reflexion的迭代上限均為30;LATS每次擴展多個子節點。作者報告該設置下搜索改善表現,同時明確決策任務依賴環境能夠回退。§4、§5.3、附錄B
這裡需要剋制的是歸因。“同樣30輪”只對齊一種計數單位,不能自動變成相同調用數、詞元數或觀察量。樹中一個迭代可以生成和評估多個候選。把系統提升全部叫作“基礎模型更會規劃”,會把控制程序與環境提供的幫助漏掉;反過來說“只是搜索所以不算能力”,也忽略了候選質量和評估質量對搜索的作用。
Koh等進一步在網頁環境中搜索實際可達狀態,用模型價值函數挑選分支。價值函數就是對候選狀態是否值得繼續的評分規則。GPT-4o在VisualWebArena的對應基線成功率為18.9%,加搜索後為26.4%;這組對照的最終執行步數上限均為5,搜索另外有深度、分支和評估預算。回溯通過重置再重放動作序列實現。§3–4、表2、附錄A.4.1
**執行路徑短,不等於只與環境交互了幾次。**最終採用的五步之外,可能已有許多探測、評分和重放。這條結果能證明搜索系統在該協議中有用,不能證明模型無需探測就知道了這些網頁的後續狀態。
論文也將不可逆動作列為限制。§5.4 對研究者而言,這不是附帶的部署提醒,而是任務定義的一部分:允許撤銷的世界,把失敗分支變成了信息;不能撤銷的世界,失敗分支可能直接改變目標是否仍可實現。兩種環境裡的同名“搜索預算”未必買到了同一種能力。
把計劃拿出來打分,是否就看見了規劃?
APB把完整方案生成與已有反饋條件下的後續步驟預測分開,還測試多餘工具、故障工具和不可解任務。它使用參考答案輔助的模型評審,而不是PDDL式形式證明。正式論文報告,所測模型從預測一步擴展到三步時正確率下降;評審器與作者人工標註做了校準,但仍存在誤差。§3、§5.2、附錄D
這種拆解能幫助定位“會接著做一步,卻不能穩定安排後續多步”的行為差異。不過,多步輸出也增加了需要同時正確的環節,下降不能全部歸因於某個特定內部機制。方案被評為合理,是診斷證據;它與在環境中執行成功仍不是同一個終點。
APB還在兩個受控環境驗證診斷修訂的用途:修訂組從同一初稿出發,獲得一次評審反饋後再執行。評審器可以訪問隱藏的環境監督,反饋有防洩漏約束;因此這是有額外診斷信息的系統對照,不能當作模型憑空自我糾正。論文也明確其框架不建模隨機轉移與信念狀態更新。§5.1、附錄C.10、Limitations
幾項研究並不組成“會規劃”和“不會規劃”兩個陣營。它們觀察的對象不同:
| 證據入口 | 關鍵條件 | 觀察到什麼 | 還不能證明什麼 |
|---|---|---|---|
| 形式化計劃 | 給定規則,一次生成,事後驗證 | 某些模型生成有效序列 | 最優性、等成本優勢、內部算法 |
| LATS | 多分支、反饋、可回退 | 所測系統表現改善 | 收益全部來自基礎模型 |
| 網頁樹搜索 | 實際試探、評分、重置重放 | 同一起點加搜索後的收益 | 不可逆環境中的同等收益 |
| APB診斷 | 固定任務材料、模型評審及受控執行驗證 | 計劃缺陷與修訂價值 | 無誤的機制測量、開放世界保證 |
怎樣讓兩種解釋給出不同預測?
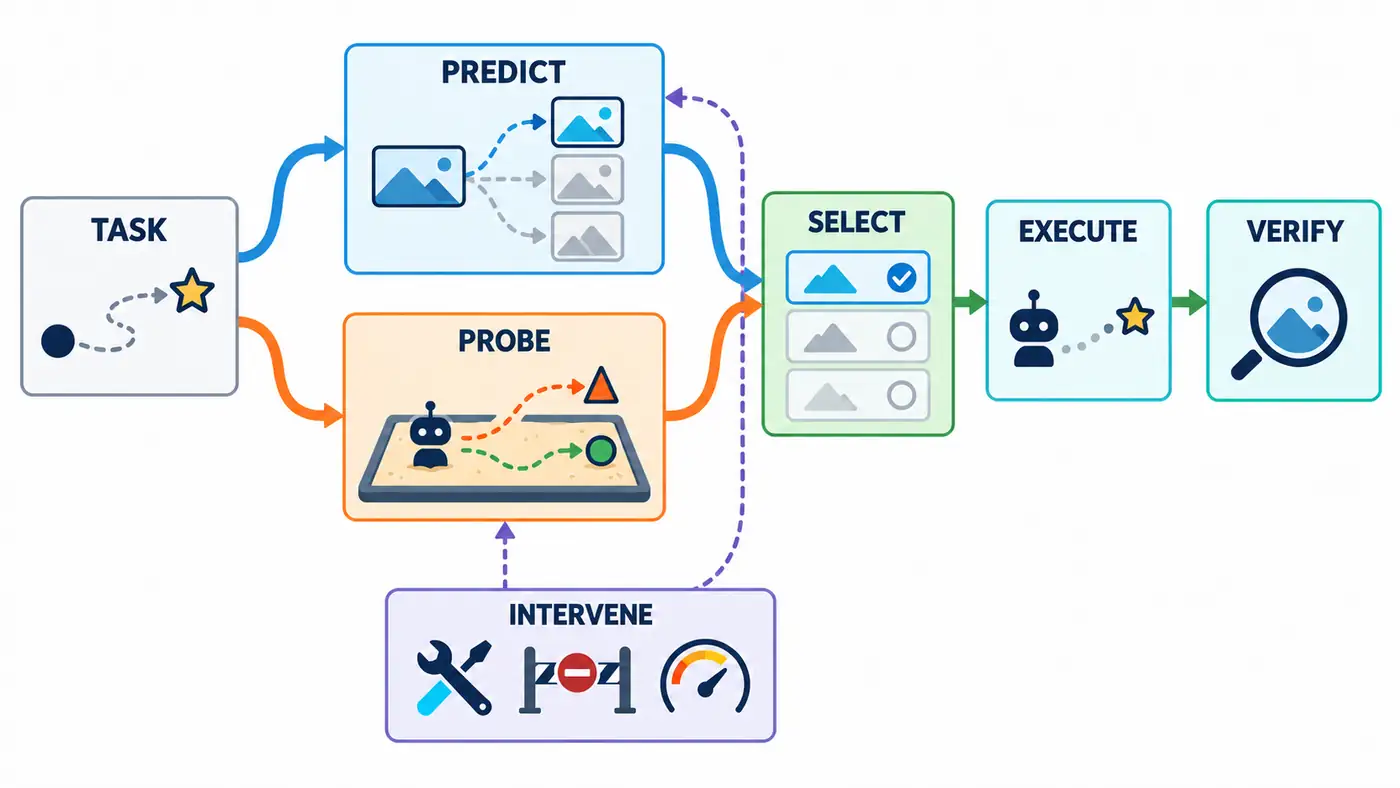
圖:原創分析框架,不是論文測量結果。上路表示預測候選後果,下路表示環境探測,兩者都可進入選擇、執行與驗證。紫色虛線僅表示擬議干預;線條相交處不是額外連接。通過驗證不反向證明內部推演,圖中的勾選只代表候選被選中。
下面是尚未執行的後續實驗設計。比起再收集一批成功截圖,更值得保留整個搜索過程,並讓信息來源成為可控制變量。
**第一組:先承諾預測,再允許行動。**固定模型、任務和觀察歷史,讓它先寫出候選動作的前提、後繼狀態與後續依賴,封存後才查詢環境。對照組直接探測後再選擇。記錄預測錯誤發生在哪個狀態,而不只看最後是否成功。若兩組都成功,但無探測組反覆預測錯誤,那麼系統成功不能歸因於準確預見。
這個設計也有邊界:要求顯式寫狀態可能額外消耗預算,並改變作答方式。因此應同時保留不要求狀態報告的性能基線,避免把“不會按指定格式報告”直接解釋成“沒有狀態表徵”。
**第二組:分開改名字和改規則。**先做保持轉移結構不變的符號重命名,再只改變一項動作前提或效果,並把新規則明確給模型。前者測試對錶面表達的依賴,後者測試是否更新已有策略。任務需由獨立求解器檢查可解性,按結構劃分開發與評測集合,不能讓同一模板的近鄰同時進入兩邊。
如果模型能處理新名字,卻在新規則下堅持舊步驟,更符合策略遷移不充分的解釋;若它能在多種未見規則上正確預測後果並調整行動,就增加了可遷移狀態推演的證據。這裡仍是行為支持,不是對內部實現的唯一證明。
**第三組:把回退權單獨拿掉。**在可完全重置的模擬環境與具有不可逆狀態變化的模擬環境中,分別比較一次規劃、獨立候選篩選和逐步樹搜索。不可逆條件可以用消耗唯一道具等規則實現,不需要在真實網站冒險。每組都記錄全部環境查詢、模型詞元、評估調用、重放次數和時間。
預算應畫成性能隨資源變化的關係,而非只報一個“同輪數”結果;若無法同時對齊所有資源,就分開報告各自約束。最終成功率之外,還應保留無效動作、錯誤停止和失敗分支。這樣才能看清一個方法是在更早排除壞方案,還是靠更多可撤銷的試錯補救。
總結:把能力聲明寫到證據能夠到達的地方
成功軌跡說明系統走通過一條路;經獨立驗證的方案,進一步說明這條路滿足給定規則。要判斷模型是否提前掌握了動作後果,還需要行動前預測、規則干預與信息預算控制。
目前沒有必要否認真實的規劃進展,也不必把搜索當成反證。更有研究價值的表述是:**在什麼狀態信息、反饋權限和回退條件下,哪一部分系統變得更可靠;拿走這些條件之後,能力還剩多少。**這比給一段成功演示貼上“真正理解”或“只會試錯”的標籤,更接近可積累的證據。
參考資料
- Augusto B. Corrêa、André G. Pereira、Jendrik Seipp,Frontier Large Language Models Rival State-of-the-Art Planners,2025初稿、2026修訂。arXiv v2全文。按預印本引用;未核實正式發表。v1題名為 The 2025 Planning Performance of Frontier Large Language Models,本文不混用兩個版本的結果。
- Andy Zhou、Kai Yan、Michal Shlapentokh-Rothman、Haohan Wang、Yu-Xiong Wang,Language Agent Tree Search Unifies Reasoning, Acting, and Planning in Language Models,ICML 2024。正式頁面;方法細節依據arXiv v3全文,正式PDF本次未成功讀取。
- Jing Yu Koh、Stephen McAleer、Daniel Fried、Ruslan Salakhutdinov,Tree Search for Language Model Agents,TMLR 2025(2024初稿)。期刊論文目錄確認發表;本文實驗與限制依據2026年arXiv v4,OpenReview正式PDF訪問受瀏覽器驗證阻擋。
- Haoyu Sun、Wenxuan Wang、Mingyang Song、Jujie He、Weinan Zhang、Yang Liu、Yang Yang、Yu Cheng,Agent Planning Benchmark: A Diagnostic Framework for Planning Capabilities in LLM Agents,Findings of EMNLP 2026。正式頁面與正式全文。arXiv最新v4未成功讀取,本文關鍵論斷回到正式全文核驗。
作者作品推廣
以下是作者自有產品推廣。除了寫技術博客,我也獨立開發一些讓日常更有條理的小工具,歡迎瞭解:
- 日常收支小記:記錄日常收支,安排預算與儲蓄目標,給每一筆錢安排好去處。在 App Store 瞭解。
- 一事微光:按當下的時間和精力選擇小行動,記錄完成後的感受與發現,讓日常復盤從一件小事開始。在 App Store 瞭解。
更多技術文章與個人作品,歡迎訪問我的網站:zffjzz.top,也歡迎分享使用感受。