- 日期:2026-10-13
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-13;檢索近12個月研究,並保留解釋爭議所需的早期論文。本文為證據深讀,未運行模型訓練或復現實驗,不聲稱全面覆蓋。
摘要:數據更多,為什麼仍可能越學越窄?
模型能不斷生成新題目、新答案,看起來像是解決了訓練數據不足的問題。但一萬種措辭可能只覆蓋一種題型;篩掉錯誤答案後,剩下的也可能都是模型早已會做的題。數據量、單條質量與任務覆蓋度,是三個不同的量。
本文對照遞歸訓練、數據累積、局部編輯和指令篩選四條證據線。**當前證據支持:合成數據可以有用,保留原始信息和改變生成、篩選方式也能緩解部分退化;但一次提升、誤差有界和持續獲得新能力,不能互相替代。**論文並未形成“合成數據必然有害”與“無限生成必然有效”兩個可直接對打的陣營。判斷收益能否持續,需要先說明什麼被保留、什麼被替換、什麼被測量。Shumailov等,2024;Gerstgrasser等,2024
先分清質量、覆蓋度和“坍塌”
合成數據指模型生成或改寫的訓練材料。這裡的質量是單條材料是否正確、清楚且適合學習;覆蓋度是材料是否包含目標任務所需的領域、難度、結構和少見情形。“長尾”就是低頻但仍可能重要的部分。質量好的一組樣本,未必覆蓋得廣;罕見樣本也未必正確。
模型坍塌(model collapse)通常描述模型反覆學習生成材料時,逐漸偏離目標分佈的現象。不過,各論文使用的操作定義不同:有的看分佈尾部消失,有的看測試誤差是否隨代數無界增長,有的看留出題表現或技能變化。閱讀時必須把名詞換回指標,不能把“沒有無界增長”讀成“沒有任何損失”。Shumailov等,定義2.1;Gerstgrasser等,§2、§3腳註3
本文把可能的解釋分成三類。第一,信息保留:舊樣本仍在,少見模式不必每次都靠重新採樣才能留下。第二,學習效率改善:同樣的信息被重新表達、清理或安排難度,更容易被學生模型利用。第三,測量範圍收窄:常見題進步掩蓋了少見題退步,平均分看起來仍然不錯。三者可能同時發生,需要不同對照才能區分。
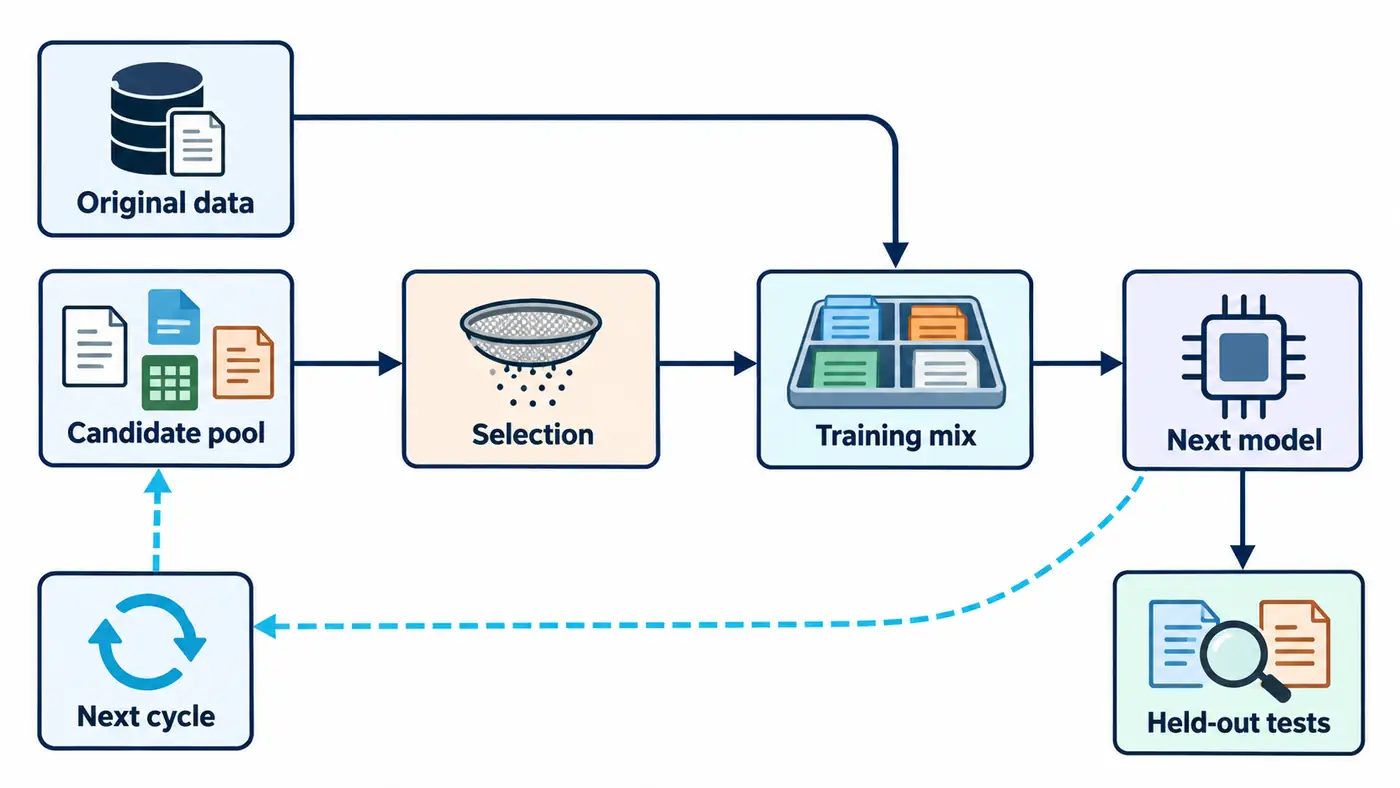
圖:本篇整理的比較框架,並非任何單篇論文的原始流程。實線表示數據進入訓練與獨立評測的步驟;虛線表示可能繼續生成下一輪候選的路徑,不表示已證明的持續增益。原始數據保留多少、篩選依據是什麼、是否引入外部答案,都應作為實驗變量。留出測試沒有迴流箭頭;圖中沒有測量數據。
從“遞歸替換”到“累積保留”,改變了什麼?
遞歸訓練確實有風險,但實驗不是整個互聯網
Shumailov等的Nature論文用簡單分佈模型解釋:有限採樣與擬合誤差能在代際傳遞中累積。語言實驗則是OPT-125m在WikiText-2上的遞歸微調,生成時使用束搜索。論文報告了退化,也報告保留部分原始數據時退化較輕。正式版,“Theoretical intuition”及“Model collapse in language models”,pp.756–759
這裡有兩道邊界。首先,簡單模型的無限代結論,不能直接變成現實大模型在哪一代失效的預測。其次,論文兩組語言設置同時改變了原始數據保留與訓練輪數,因此這組對照不能單獨估計“只改變混合比例”的因果效應。它證明特定反饋流程存在風險,不能推出任何來源、任何篩選方式的合成文本都必然有害。
累積數據的反例,也不等於完整保留所有細節
Gerstgrasser等比較每代用新生成數據替換舊集,與保留舊集並追加新數據。語言實驗從新初始化的小型GPT-2、Llama2架構訓練,累積條件的測試交叉熵較穩定;交叉熵衡量模型對測試文本的預測損失。論文還做了擴大純合成替換集的對照,該條件仍退化,說明觀察不只是“數據條數變多”。§2.1、附錄C表2的對照說明
**一個關鍵細節是:其語言實驗的初始語料TinyStories本身由GPT-3.5/4生成。**這裡更直接檢驗的是保留參考語料與代際累積的作用,不能把它寫成“證明人類原文不可替代”。而且§2.3的圖像實驗仍報告細節多樣性下降;§3的有界誤差結論建立在線性模型中。維持總體誤差與保住每個稀有模式,依然是不同命題。§2.1、§2.3、§3
因此,兩項工作首先說明數據更新規則的重要性,而非得出了同條件下相反的結論。微調與從頭訓練、WikiText-2與TinyStories、固定數據量與逐代增長的數據量,都不相同。累計數據若每代完整訓練,還會改變計算開銷;沒有匹配預算,不能聲稱找到了免費的長期改進。
生成得更“乾淨”,是否就覆蓋得更全?
Zhu等把問題移到單輪預訓練:使用不同佔比的Dolma與Cosmopedia,在其混合實驗中保持總訓練文本量一致,觀察到合成佔比上升伴隨總體評測退化。Cosmopedia來自特定教師和生成流程,Dolma也不是與它逐條配對的反事實版本。因此,這是兩套具體語料及其配方的比較,不能把所有差異只歸給“人寫還是機器寫”。ICML 2025;所讀arXiv v3,§3.1、表1
該研究還用參考模型的困惑度與短詞序列特徵檢查分佈差異。困惑度可直觀理解為模型對文本的意外程度;它依賴參考模型,不是通用的事實正確率,也不能直接當作知識覆蓋地圖。作者據此提出ToEdit:保留原文,優先重新採樣高置信度位置的詞元,即模型處理文本的基本單位,而不是整段自由生成。§3.2、§4.1
論文報告局部編輯在所測訓練階段改善了平均表現,但表中並非每項任務都上升;理論有界結果使用線性模型,不能保證任意編輯器長期無損。§4.2–4.3、表2–4 本篇據此提出的判斷是:篩選只能重排或刪除已有候選,不能憑空補出候選池中完全缺失的題型。把高分樣本挑得更準,與讓關鍵難例進入候選池,必須分別驗證。
近期的正面結果:篩選有幫助,外部反饋也在場
2026年7月的KITE預印本先依據失敗記錄生成面向弱項的指令,再根據多次回答之間的語義不確定性篩選候選。各代保留累積數據,並從相同初始檢查點重新微調;不是沿用上一代權重持續訓練。作者報告主實驗五輪後的優勢,以及單個骨幹模型延長至九代時逐漸趨緩的增益。Luo等,§3、§4.1–4.4
這條證據值得重視,但其含義比“模型可以無限自學”窄。所有方法都使用外部強模型核驗和規範答案,因此比較的是給定答案渠道下怎樣構造指令;標註預算相同也不代表候選生成、重複作答和篩選的總計算相同。作者還承認,弱項診斷依賴未經專家驗證的技能標籤,不能當作精確能力測量,且尚未完成KITE之後的逐技能重新診斷。§6、附錄8.2–8.5
本篇進一步推斷:共用一個核驗器,並不排除它與不同候選題型產生不同交互收益。若要證明收益不依賴該外部渠道,仍需更換或移除核驗器的對照。不能僅由平均分改善,就斷言先前識別的所有弱項均已修復。
| 證據線 | 關鍵條件 | 所觀察或支持的主張 | 尚不能證明 |
|---|---|---|---|
| 遞歸退化 | 小模型微調與特定生成方式 | 反饋循環可能損失分佈信息 | 所有合成訓練必然失敗 |
| 累積保留 | 保留參考集與歷史生成集 | 所測語言損失更穩定 | 全部尾部細節無損 |
| 局部編輯 | 原文保留、有限詞元替換 | 部分配方的平均表現改善 | 無限代持續增長 |
| KITE篩選 | 累積SFT、外部答案核驗 | 有限輪次內改善指令訓練 | 沒有外部信息的自我超越 |
各行對應上文原文,不作橫向數值排名。尤其不能拿預訓練困惑度與指令任務正確率比較提升幅度;KITE部分基準還使用限定學科或抽樣子集,並非都採用完整標準測試集。劃分見附錄8.2.2
怎樣做一個能區分解釋的後續實驗?
下面是本篇提出、尚未執行的實驗設計。選擇一個可承受多輪訓練的模型和有獨立測試集的任務,先固定初始檢查點、原始訓練集、解碼與答案評判規則,再比較三種數據流:只留本輪生成集、保留原始集並追加歷史生成集、固定容量下分層保留原始與歷史樣本。第三組用於區分“保留信息”與“投入越來越多計算”。
每組再比較隨機選擇和質量篩選,保持最終訓練詞元預算一致,並單列生成、核驗成本。如果能使用程序精確檢驗的任務,再交叉設置程序核驗與模型核驗。測試集始終封存,不用於尋找弱項;指導生成的診斷集另行劃分。相同題目的近重複應在訓練、診斷與測試之間排除。
評價至少同時看總體正確率、預先定義的稀有題型表現、跨輪次由對變錯與由錯變對的配對記錄,以及覆蓋度代理指標。代理指標應明確測量什麼:題型標籤覆蓋比詞彙變化更接近任務結構,但仍受標籤體系限制。不能看到句子不重複,就認定能力變多。
如果累積組只在預算增長時佔優,計算資源是競爭解釋;如果質量篩選提高總分卻損傷稀有題型,質量與覆蓋發生了取捨;如果換核驗器後收益明顯變化,就應研究外部反饋與候選分佈的交互。任何有限輪次的正面結果都只能支持該觀察區間。應事先寫明輪數與停止規則,並保存全部輪次,避免只展示最好的一代。
總結:持續收益需要持續檢查信息從哪裡來
合成數據研究最值得追問的,已經不是“模型生成的能不能用”,而是:新材料保留了哪些信息、補進了哪些結構、借用了什麼外部判斷,又遺漏了什麼。已有證據支持研究這些條件,尚不足以給所有任務一個安全混合比例或永久增長配方。
對科研新人而言,一個更可檢驗的問題是:**在同樣預算下,某種生成與篩選機制能否改善獨立任務表現,同時保住預先指定的稀有能力?**把質量、覆蓋與預算分別記錄,正面結果才有清楚的適用邊界,失敗結果也才有可解釋的價值。
參考資料
- Ilia Shumailov、Zakhar Shumaylov、Yiren Zhao、Nicolas Papernot、Ross Anderson、Yarin Gal. AI models collapse when trained on recursively generated data. Nature, 2024. 正式頁面;本次讀取的作者機構存檔PDF。另核驗2025年作者更正,涉及理論段落的誤差項符號;本文未複述該公式。
- Matthias Gerstgrasser等. Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data. 2024. arXiv版本記錄;本次深讀v2全文。會議頁面本次受到訪問驗證限制,本文實驗論斷限定於已讀版本,不把檢索中的會議信息當作全文版本核驗。
- Xuekai Zhu等. How to Synthesize Text Data without Model Collapse? ICML, 2025. PMLR正式記錄;本次深讀arXiv v3。正式PDF本次未能讀取,未假定其與v3逐字一致。
- Xiaonan Luo、Yue Huang、Kehan Guo、Ping He、Chuan Zou、Ting Hua、Xiangliang Zhang. Learning from Synthetic Data without Model Collapse in Iterative Instruction Tuning. 2026. arXiv v1全文;版本與作者記錄。本次僅確認預印本,未確認正式錄用。