- 日期:2026-10-12
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-12。重點檢索近12個月工作,並保留2025年的爭議起點;本文為三篇一手研究的證據深讀,未運行模型訓練,不聲稱全面覆蓋。
摘要:學習方法的名字,不能代替實驗條件
給模型看標準解答,和讓模型嘗試後接收反饋,為什麼會產生不同的遷移表現?“SFT記憶,RL泛化”給出了一個容易記住的回答,也容易讓人忽略:兩組模型是否看過同樣豐富的解法,是否處在同一訓練階段,又是否接受了相同的測試。
本文的判斷是:**強化學習在一些受控任務上表現出更強遷移,但現有證據不足以把泛化能力歸屬於某一種訓練目標。數據選擇、監督內容和優化程度改變後,SFT也能出現跨分佈收益。**這並不意味著兩種方法等價;它意味著需要把“觀察到差距”和“解釋差距來源”分開。Chu等,2025、Lu等,2026、Ren等,2026分別提供了任務對照、數據干預和訓練動態三個切口。
“泛化”首先要說明換了什麼
監督微調(SFT)讓模型在給定問題和示範前綴時,提高示範中下一個詞元的概率。強化學習(RL)則依據生成結果得到的獎勵調整生成策略。這裡主要討論可核驗任務中的RL,不把人類偏好優化的所有結論一併納入。
直觀地說,SFT像閱讀做題過程,RL像交卷後得到反饋。但比喻不能替我們判決:教材可以包含多條解法,反饋也可能只讓學生重複最熟悉的一條路徑。“有探索”描述訓練過程,不自動保證探索到了可遷移的方法。
分佈內(ID)測試沿用訓練任務的主要條件;分佈外(OOD)測試改變其中某些條件。換卡牌規則、換圖像風格、從數學題轉到代碼題,都是分佈變化,卻不是同一項能力。更何況,OOD通常只相對於本次後訓練數據而言,不能據此斷言預訓練從未包含相似知識。
本文把“記憶訓練規則”“保留原有能力”和“獲得遷移收益”分開。換規則後成績下降,只能先說明適應性受損;要進一步聲稱逐字記憶,需要近似複述等額外測量。反過來,遷移成績高於訓練前,也不足以定位內部究竟形成了什麼算法。這是本文采用的證據標準,不是對模型內部狀態的觀測報告。
最早的強證據,也有明確的適用範圍
Chu等在GeneralPoints算牌與V-IRL導航中改變規則或視覺輸入。例如,訓練時把J、Q、K都解釋為10,測試時改為11、12、13,並在提示中告知新規則。模型要根據當前指令重新行動,而不是沿用訓練映射。論文報告RL在這些OOD條件下改善,繼續SFT則退化。原文§4、§5.1—5.2
這項對照並非簡單地給RL更多訓練:兩支從共享的SFT初始化檢查點出發,圖6比較估算計算量相同的位置。主幹是Llama-3.2-Vision-11B;RL允許利用驗證器反饋逐輪修正,而正文SFT主要採用單輪專家示範。附錄還測試了帶錯誤和驗證信息的SFT軌跡,局部結果依然不理想。圖6、附錄C.1—C.3
因此,不能用“完全沒做公平比較”抹去觀察,也不能把局部數據消融提升為“SFT本質上只能記憶”。計算量相近並不使反饋信息、軌跡分佈和目標函數自動相同。論文還報告,RL無法恢復一個過度SFT檢查點的OOD表現。§6 這對“只要加RL就能泛化”的說法構成邊界。
差距也可能來自哪些樣本真正推動了更新
Lu等考察視覺語言模型的分類與定位任務,按初始化模型多次作答的結果劃分難度:全部正確為容易,全部錯誤為困難,有對有錯為中等。這裡的“困難”是相對於模型和採樣協議的觀測標籤,不是題目永恆的屬性。原文§4.1—4.2
其解釋來自組相對策略優化(GRPO):同一問題的候選答案互相比較獎勵;組內獎勵相同時,相對優勢為零,來自該項獎勵的策略更新信號消失。這不等於整個訓練沒有更新,例如約束模型偏離程度的KL項仍可能貢獻梯度。作者據此提出“隱式難度篩選”的解釋,並用顯式篩選的SFT檢驗它。§3—4
在論文的主要設置中,DC-SFT保留中等難度,或同時保留容易與中等難度數據,其平均OOD表現超過對照GRPO。研究採用Qwen2.5-VL的兩種規模,先作共享格式初始化,再主要進行低秩微調;對照固定訓練步數,SFT與GRPO的批量設置不同,不能直接稱為等總算力實驗。表2、§5.1—5.2
這個干預說明:至少一部分差距可以通過改變SFT接觸的數據來改變。它尚未排除其他共同變化,也沒有證明所有RL收益都由難度篩選造成。尤其是一次靜態篩選與持續變化的在線採樣並不相同;初期不會的題,可能在後期成為有效訓練題。把論文讀成“困難樣本永遠有害”,會把條件性發現變成新的口號。
一張訓練曲線,也能改變“不會泛化”的判斷
Ren等從未經指令微調的預訓練檢查點出發,用經過答案驗證的長思維鏈(CoT)數學示範進行SFT。CoT指輸出中展開的中間推理文本。論文在部分跨領域任務上觀察到先下降、後恢復的軌跡:如果只看較早檢查點,容易低估最終遷移表現。原文§2、§3.1,圖3
這並不是“越訓越好”。作者用更激進的學習率與訓練安排觀察到了後期退化,也發現數據質量和模型起點會影響恢復。該文後續GRPO對照匹配了起點、問題池、批量、響應上限及更新次數,但明確沒有匹配總生成詞元和總浮點運算量;其中SFT佔優的結果不能建立普遍排名。§3.4、附錄A及C.14
本文據此推斷:研究者需要檢查整個學習軌跡,而非只取一個訓練時刻作算法歸因。不過,“較晚表現恢復”也不直接證明模型學到了回溯或驗證機制。論文的文本行為檢測器只是可複查的行為代理,作者在侷限中明確承認它不提供參數層面的機制解釋。附錄A
把三種解釋放進同一個比較框架
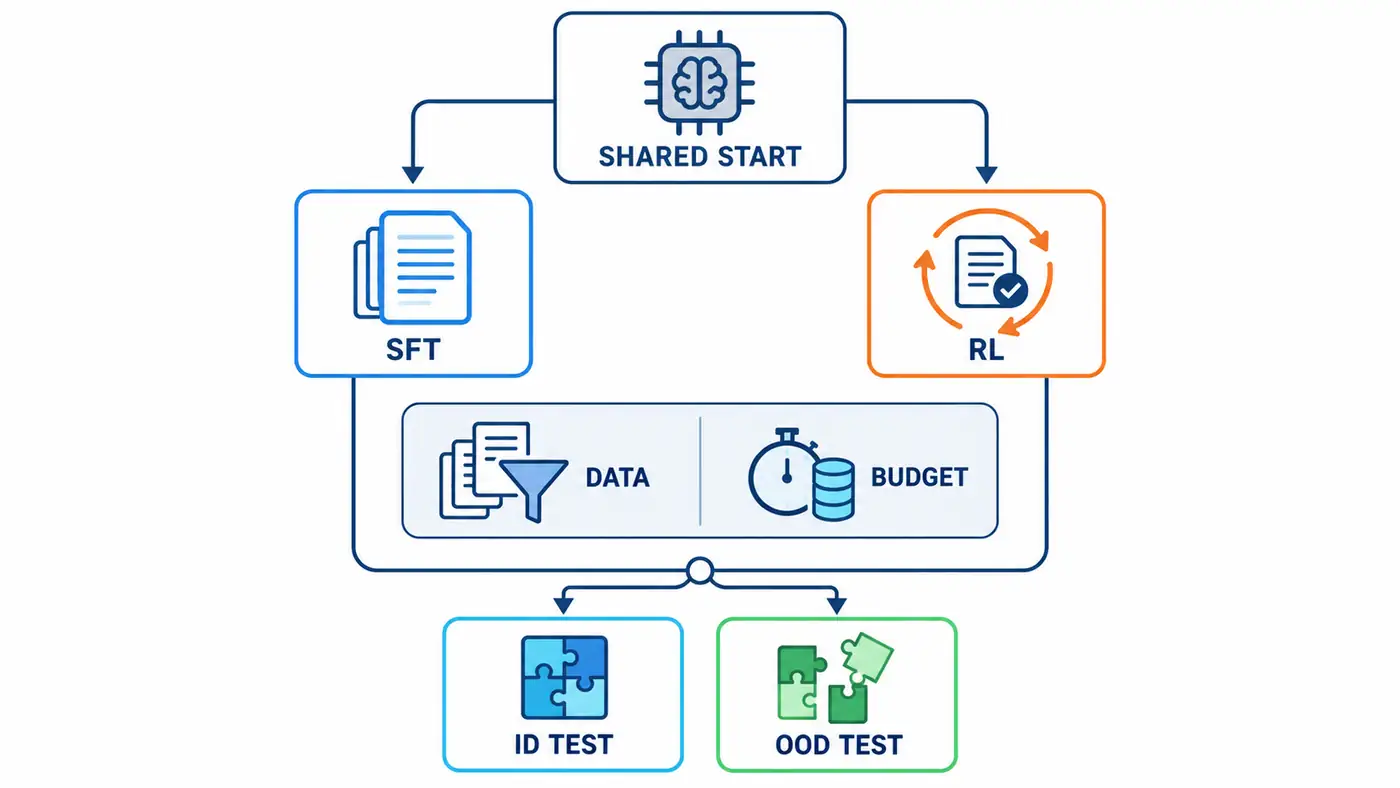
圖:本文提出的比較協議。箭頭表示共享起點後分別訓練、分別接受同一套測試;下方匯合點表示協議共用,不表示模型融合。數據與預算是需要核對的條件。圖中沒有畫出獲勝方法或實測趨勢;“探索、篩選、優化階段”仍是需要區分的解釋。
| 解釋 | 可區分的觀察 | 已有證據與邊界 |
|---|---|---|
| 反饋探索更有利 | 同等數據覆蓋與預算下,在線反饋仍有額外收益 | Chu等支持局部RL優勢,但訓練信號仍有差異 |
| 有效數據分佈不同 | 保持SFT目標,改選樣本後差距縮小 | Lu等提供干預證據,不能解釋全部RL機制 |
| 比較了不同訓練階段 | 相同方法較晚檢查點改變原有判斷 | Ren等觀察到恢復,也觀察到激進訓練下退化 |
這三種解釋可以同時成立。它們分別關注“怎麼獲得經驗”“哪些經驗進入更新”“何時測量結果”,並不是三支互斥陣營。三篇論文的任務、模型、訓練數據和評測指標均不同,因此本文只比較證據結構,不把它們的榜單數字拼成排名。
讀表時還應區分預算的賬本。相同問題數沒有限制每題嘗試次數;相同梯度步數沒有限制每步處理多少詞元;相同訓練詞元也未計入教師生成、困難度篩選和在線驗證。對研究目標而言,可以分別報告“已有示範時的訓練成本”和“從零構造數據的總成本”,但不能混用二者來宣佈效率勝負。
這裡沒有一把能讓所有變量同時相等的尺子。若研究“同樣算力下誰更有效”,就允許兩種方法用不同數量的經驗,但要誠實結算計算成本;若研究“同樣經驗怎樣被利用”,就儘量共享軌跡,再接受優化方式造成的成本差異。前者是資源配置問題,後者更接近學習機制問題。論文可以回答其中一個,卻不應把一個答案包裝成另一個。尤其不能先給SFT額外教師知識,再把提升全部歸因於監督目標;也不能讓RL反覆訪問驗證器,卻把信息來源記為零。
評測同樣需要拆賬。多次作答的平均正確率,和多次中至少成功一次的比例回答不同問題。Ren等的若干推理指標使用前者;Chu等的算牌成功則包含推理時驗證機會。Ren等§2.2、附錄B.4、Chu等附錄C.3 同樣寫著“成功率”,也不能忽略解碼與反饋協議。
一個能區分解釋的後續實驗
以下是實驗建議,尚未執行。選一個能自動驗算、能明確改變規則的任務,固定起點、訓練問題池和獨立開發集,並預先留出不參與調參的新規則測試集。先比較普通示範SFT、難度篩選SFT和在線RL,再增加一組SFT,使用RL實際生成並通過驗證的軌跡。這一組可以檢查:RL獲得的部分收益能否被示範傳遞。
這仍不是一次就能解決的比較。RL軌跡的生成成本應記在供給這組SFT的數據賬本中;若把已訓練RL模型當教師,結論只能是“這些經驗能否傳遞”,不能聲稱不需要RL。還應保留同等條數、近似長度的隨機篩選組,以免把樣本數減少或輸出變短誤認作難度篩選的作用。
預先固定若干預算節點,同時記錄訓練詞元、在線生成詞元、驗證次數和時間;在開發集選檢查點,最終測試只用於報告。除總正確率,還應分開統計格式失敗、繼續套用舊規則和執行新規則時的算錯。這樣才能知道分數變化來自哪裡。所有方法使用同一解碼協議,並報告多次獨立訓練的波動。
如果只改SFT數據就穩定縮小差距,會加強數據解釋;若在覆蓋與預算相近時在線RL仍額外獲益,會加強反饋解釋;若方法排名隨檢查點改變,則應優先報告訓練動態。反之,某一操作沒有奏效,也只能排除那一種實現下的解釋,不能把一次負結果提升為算法不可能性。
總結:把方法標籤還原成可檢驗的問題
現有研究允許我們說,RL有時比某種SFT配置更能適應變化;它們也明確提示,SFT的遷移表現會隨數據和訓練條件改變。對於科研新人,值得追問的不是替哪種方法站隊,而是:這個差距經過哪些控制仍然存在,哪些解釋已被削弱,哪些變量還糾纏在一起。
“記憶、探索、泛化”應當是等待測量的對象。只有把起點、經驗、預算與測試分佈交代清楚,論文標題裡的強判斷才能轉化為可以積累、也可以被修正的研究結論。
參考資料
- Tianzhe Chu、Yuexiang Zhai、Jihan Yang等,SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training,2025。ICML 2025正式記錄;方法與結果核驗使用arXiv v2,2025-05-26。正式PDF本次未成功打開,不宣稱逐字核對兩個版本。
- Aojun Lu、Tao Feng、Hangjie Yuan、Wei Li、Yanan Sun,Why Does RL Generalize Better Than SFT? A Data-Centric Perspective on VLM Post-Training,2026。arXiv v1,2026-02-11全文。檢索到CVPR 2026官方PDF記錄,但本次直接打開失敗;實驗論斷僅依據已讀arXiv版本,不推定終稿完全一致。
- Qihan Ren、Peng Wang、Ruikun Cai等,Rethinking Generalization in Reasoning SFT: A Conditional Analysis on Optimization, Data, and Model Capability,2026。arXiv v2,2026-08-15全文;版本與狀態。作者在arXiv及官方代碼庫聲明獲COLM 2026接收;本次未取得獨立會議正式條目,按作者聲明註明,不混同已檢索到的FoGen非歸檔工作坊版本。