- 日期:2026-10-11
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-11;檢索近12個月工作並保留經典對照。本文為文獻深讀,未運行模型訓練或復現實驗,不聲稱全面覆蓋。
摘要:先問改善了誰
批改數學作業時,只檢查最終答案,可能放過中途的錯誤;逐行檢查,又需要更多時間和專業判斷。把這一直覺搬到大模型,便得到一個誘人的結論:監督越細,推理越可靠。但實驗裡的“更好”可能只是從已有答案中挑得更準,也可能是驗證器更會找錯,或者生成模型本身變得更穩。這三種進步需要不同證據。
**本文的判斷是:過程標籤能夠提供更明確的錯誤位置,但其收益取決於標籤含義、使用方式和評測目標;結果標籤也可能訓練出有用的過程評分器。**真正值得比較的不是兩個縮寫誰獲勝,而是新增的信息與計算究竟改善了哪個環節。下文用四項研究拆開這些問題,不把不同設置下的結果拼成陣營對抗。
“過程”至少有三個位置
首先是監督來源:標籤只說明最終答案對錯,還是說明某個中間步驟是否成立?過程獎勵模型通常簡稱PRM,結果獎勵模型簡稱ORM;不同論文對名稱的用法並不完全相同,應以訓練目標為準。
其次是評分位置:模型可以每一步都輸出分數,但這些分數未必表示本步邏輯正確。若標籤來自“從這裡繼續生成,最後能否答對”,它更接近未來成功潛力。結果監督的模型也可能讀取完整解答,而不是隻看到最後一個數字。Uesato等§2.4、Zhang等§3.1.1
最後是使用位置:把評分器用於候選重排,改變的是選出的回答;把它作為強化學習獎勵,才會更新生成策略。“獎勵模型訓練得更好”與“用獎勵訓練後的模型更好”不是同一項實驗。本文把實際生成解答的模型稱為生成器,把檢查候選的模型稱為驗證器。
Best-of-N指先生成多個候選,再選出評分最高的一條。它檢驗選擇能力;錯誤定位則要求指出最早出錯的位置,或判定整條解答無誤。兩者都有價值,卻不能用同一個總分互相擔保。
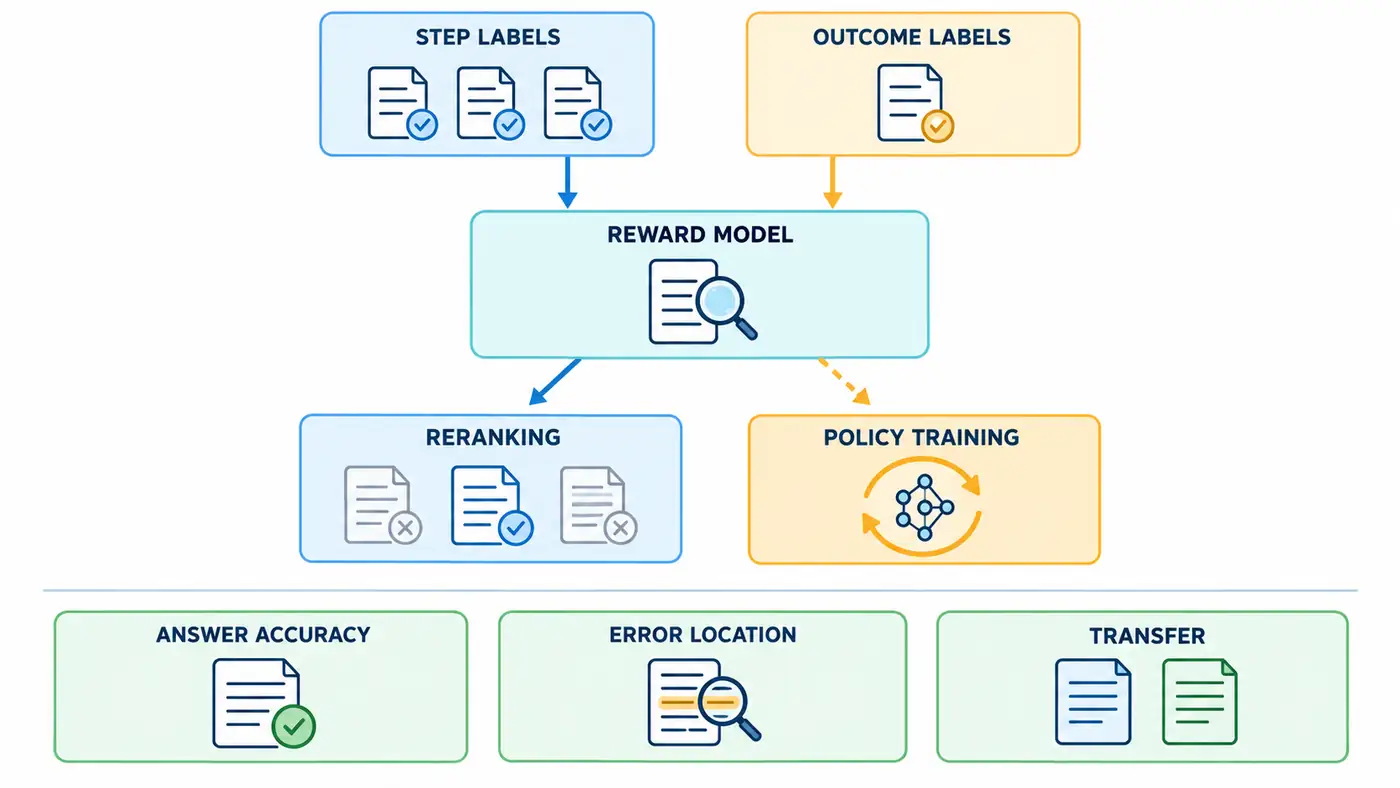
圖中實線表示訓練或使用路徑,不表示必然產生收益;虛線提醒“更新生成策略”需要單獨驗證,並非已有重排結果的自然延伸。底部三項是獨立評測問題,勾叉僅作圖標,不是測量結果。封面的軌道檢查裝置同樣是概念隱喻,不是論文實驗設備。
經典優勢成立,但先看實驗動了哪裡
Lightman等的《Let’s Verify Step by Step》在MATH數學題上比較過程監督與結果監督。其大規模實驗從GPT-4起步,固定生成器,用不同驗證器選擇候選;論文明確說明沒有用強化學習改善生成器。正式版圖3報告,在每題1860個候選的條件下,PRM選出的答案正確率為78.2%,ORM為72.4%;評測採用保留的500道題。正式版§2.1、圖3、附錄C
這首先支持該條件下過程監督的驗證器更會挑答案。它不能改寫為模型單次生成正確率達到同一數值。論文也承認,大規模兩組訓練集並非嚴格可比;小規模實驗另用大模型提供合成監督來做更直接的比較。原文§2、§3–4
因此,觀察到優勢與認定原因之間仍隔著一步:細粒度標籤、樣本選擇和訓練數據分佈可能同時變化。對研究者而言,下一問應是“在相同問題與成本下還剩多少優勢”,而不是從這一個結果推導出所有任務都該逐步打分。
Uesato等更早在GSM8K上比較了多種監督組合,既包含重排,也包含通過專家迭代更新生成器。專家迭代是先搜索較好樣本,再用這些樣本訓練模型。論文報告,結果導向的方法可以獲得相近的最終答案表現,而過程質量還需要另行檢查;學習到的ORM也可能近似過程反饋。原文§2.6、§3及表1
這裡的過程錯誤率尤其容易誤讀:分母是最終答案正確的解答,統計其中有錯誤步驟的比例,並非全部解答的錯誤率。它揭示“答對卻推錯”,不能直接代替整體正確性。作者還按最終答案測試錯誤率選擇迭代檢查點,因此這些結果不宜當成完全未參與選擇的最終測試。原文§2.1、§2.6
兩項研究沒有構成乾淨的相反結論:小學應用題與更難的數學題不同,模型起點、標籤規模、更新方式與解碼協議也不同。後者的結果不能推翻前者;前者的局部優勢也不能替後者回答生成訓練問題。
每步都有標籤,也可能監督錯對象
Zhang等分析了過程獎勵模型的數據構造和評測。常見的蒙特卡洛標註,就是從某個前綴多次續寫,用最終成功情況估計分數;但續寫失敗可能來自後續能力不足,續寫成功也可能經過糾錯或僥倖命中。這使“這一步對不對”與“從這裡還能不能做對”混在一起。原文§2.1、§3.1
論文同時檢查候選篩選與錯誤定位,發現只看Best-of-N會掩蓋過程缺陷:若候選本就包含答案正確但推導錯誤的解答,寬鬆驗證器也能在答案指標上得分。作者因此採用續寫估計與模型裁判對錯誤位置的一致性過濾,並同時評估兩類能力。原文§3.1.3、§3.2
**本篇推斷:**過濾後的提升仍不能單獨證明某種標註方式天然優越。保留下來的題可能更容易達成一致,難以判定的錯誤則被排除。評價標籤質量時,應同時看篩掉了什麼;否則,乾淨的數據與更窄的覆蓋範圍可能被誤認成同一種收益。
只給結果標籤,也能學會找錯嗎?
2026年的LCA研究提供了一個有用的反例方向:主實驗保留Math-Shepherd的推理文本與最終答案標籤,丟棄逐步偽標籤;通過聚合各前綴的預測來學習錯誤歸屬,並分別評估錯誤定位與候選重排。其報告的平均表現支持這條路線具有可行性,不等於每個子任務都領先。Jia等§4–5、表1–2
但“訓練不用步驟標籤”不能擴大成“研究全程不用過程信息”:超參數在ProcessBench的MATH子集上選擇;聚合方法的另一組消融又把人工步驟標籤彙總成軌跡標籤。這兩個實驗的數據來源必須分開。原文§5.1、§5.3、附錄C.5
其理論也依賴整體標籤與局部錯誤關係等假設。答案對而過程錯時,這種對應會失真;總體目標的性質也不保證有限樣本訓練必然收斂到理想解。原文§3.3、附錄C.5與D.1
因此,近期證據收窄了問題:過程監督不必等於逐步人工標註,但要證明學到了可遷移的錯誤判斷,仍需獨立、可信的過程評測。“省去訓練標籤”是成本主張;“找到了真實錯誤”是能力主張,二者應分別驗收。
比較前,把預算與分母放回桌面
| 研究 | 主要條件 | 可支持的觀察 | 不能順推的結論 |
|---|---|---|---|
| Lightman等 | 固定生成器、MATH候選篩選 | 過程監督驗證器有選擇優勢 | 生成器已因RL變強 |
| Uesato等 | GSM8K、多種訓練與重排組合 | 答案表現與條件過程錯誤可分離 | 兩類監督在所有任務等效 |
| Zhang等 | 自動標註、重排及定位評測 | 標籤目標和評測目標可能錯位 | 高重排分就是可靠過程驗證 |
| Jia等 | 結果標籤訓練、結構化聚合 | 可以學習有用的過程評分 | 全程無過程信息或全域領先 |
表中觀察對應上述原文,不橫向排名。GSM8K與MATH的題目難度不能當作已對齊的變量;只寫“同為七十億參數”也不能保證預訓練、數學微調和監督歷史一致。
對後續研究,本篇建議建立兩種成本口徑。等信息口徑固定題目、軌跡和可見反饋,比較目標設計;等成本口徑固定標註工時或總計算,允許各方法自行分配。前者利於研究機制,後者回答資源如何使用;二者不必選出同一個贏家。
人工逐步標籤、模型裁判調用和續寫採樣都要計入成本。相同候選數量還不意味著相同推理預算:候選長度、驗證器大小及評分次數都會改變開銷。如果還要訓練生成器,應另列訓練預算,不能把測試時多采樣的收益記到學習能力上。
三個能區分解釋的後續實驗
以下是本篇提出、尚未執行的設計,不是復現結果。它們分別針對“更會選擇”“更會找錯”“更會生成”三種解釋。
**第一,凍結候選池,只更換驗證器。**保存同題同批候選,比較多數投票、結果評分與過程評分,並對相同題目記錄誰選對、誰選錯。再獨立核查被選解答的推導。如果答案收益存在而過程錯誤沒有減少,就應把結論留在選擇效果層面。候選池中根本沒有正確解的題也要保留,以免把生成失敗隱藏起來。
**第二,固定答案,干預中間過程。**構造語義正確的改寫、確實錯誤的步驟,以及先錯後糾正的軌跡;儘量匹配長度與表達。若評分主要追隨末尾答案或文本風格,就不能解釋成穩定的錯誤定位。真實語義標籤需要有依據的標註和分歧處理,不能讓被測模型自己充當金標準;這些標註本篇尚未採集。
**第三,凍結獎勵後,再訓練生成器。**從相同檢查點開始,在相同訓練預算下分別使用結果獎勵、過程獎勵和組合獎勵。把獨立的答案正確性、過程錯誤和跨生成器驗證表現同時列出,最後換未參與選參的題型。若只有訓練獎勵上升而外部指標不變,應保留這個負結果,而不是繼續調評測器直到出現優勢。
這些設計都應預先約定開發集、最終測試集與停止規則。尤其要把“用過程標籤選擇超參數”記入信息預算,而不只檢查梯度更新讀過什麼。這樣才能判斷較低的標註成本來自真實節省,還是被轉移到了方法選擇階段。
總結:監督粒度不是結論粒度
當前證據支持過程信息對驗證與選擇有價值,也支持從較粗的結果反饋中學習部分過程判斷。但收益不會沿著“步驟分數—選中答案—生成能力—泛化機制”自動傳遞。最有研究價值的報告,應說明改善發生在哪一層、比較消耗了什麼信息,並留下能推翻自身解釋的實驗。讀到“過程獎勵更好”時,先補上對象、預算和指標,爭議才成為一個可以檢驗的問題。
參考資料
- Hunter Lightman等,Let’s Verify Step by Step,2023預印本;ICLR 2024正式發表。arXiv v1;正式會議全文。本文數字按正式版核驗。
- Jonathan Uesato等,Solving math word problems with process- and outcome-based feedback,2022。arXiv v1;全文。本次未確認正式錄用,按預印本引用。
- Zhenru Zhang等,The Lessons of Developing Process Reward Models in Mathematical Reasoning,2025,Findings of ACL 2025。正式頁面;正式全文;arXiv v2全文。
- Tianyu Jia等,The Weakest Link Tells It All: Outcome-Supervised Process Reward Modeling via Learnable Credit Assignment,2026。arXiv v2;全文。本篇採用2026-09-26版本;作者在arXiv註明已獲EMNLP 2026 Oral錄用,本次未獨立取得正式會議錄用頁面,故不將該說明寫成已核驗的正式發表記錄。