- 日期:2026-10-14
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-14;檢索近12個月相關工作,並保留解釋問題所需的早期研究。本文為論文深讀,未運行模型訓練或復現實驗,不聲稱全面覆蓋。
摘要:像教師、答得對、會遷移,是三個問題
小模型開始寫“讓我檢查一下”,答案也更準了,這能說明它學到了大模型的推理方法嗎?至少存在三種解釋:它學到了有用的解題步驟;它學會組織輸出、延長計算,從而更好地調用已有知識;它更會遵守回答格式,原來無法計分的答案終於被識別。幾種變化可以同時發生。
**本文的判斷是:蒸餾能帶來可測的任務收益,但收益不能自動解釋為教師內部推理機制的複製;反過來,發現表達結構有作用,也不能推出學生只會模仿。**下文用輔助理由監督、長軌跡蒸餾、風格干預和跨任務評測四種證據,拆開這個容易被標題壓成二選一的問題。
我們究竟把什麼交給了學生?
這裡的蒸餾,指用教師模型產生的訓練信號更新學生。本文聚焦文本層面的推理蒸餾:教師提供問題、推理軌跡和答案,學生通過監督微調學習這些輸出。監督微調簡稱SFT,就是用示範輸出訓練模型預測接下來的文本;它不等於直接搬運教師參數,也不要求讀取教師全部詞元概率。
思維鏈或推理軌跡,是答案之前可見的中間文字。“表達習慣”可以指語氣、連接詞和篇章結構;“解題能力”則需要通過規定條件下的成功行為來定義。二者並非天然互斥:一個檢查步驟可能既是一句語言表達,也給後續生成增加了重新核對的機會。把它一概歸為裝飾,或一概歸為內部算法,都太快。
為了讓討論可檢驗,本文區分三個層次:表面相似性看學生是否更像教師;任務表現看獨立評分的答案是否更正確;遷移與干預穩定性看換題型、換表達、改變關鍵條件之後,收益是否保持。第三層證據通常比前兩層更能約束解釋,但也不是證明“理解”的單一通行證。
例如,假設一個學生學會在每題末尾加上檢查段落。它可能真正檢查了運算,也可能只是延長輸出,或者在檢查段裡重複了正確答案,使抽取器更容易抓取。這個例子是解釋用的假設,不是論文結果。研究設計需要讓這些解釋產生不同預測,而不只是給輸出取一個更響亮的名字。
四種證據,回答的並非同一道題
理由可以在訓練時有用,而不必在測試時寫出來
Hsieh等的《Distilling Step-by-Step!》把標籤預測和理由生成作為兩個任務,用不同前綴控制同一個學生。教師為PaLM,學生為T5,評測涉及自然語言推斷、常識問答和算術題。論文報告了理由監督的數據效率收益;測試時可以只預測標籤,無須先生成理由。正式論文§3.2、§4
這項設計的重要性在於排除了一種過窄解釋:收益未必全部來自測試時多寫一段話。理由也可能提供額外監督,改變學生如何利用問題信息。不過,這是面向具體任務的訓練,不能直接等同於通用推理方法遷移。作者也指出理由監督增加訓練開銷,理由質量的影響仍需研究。原文Limitations
長軌跡配方有效,不等於每個成分的貢獻已分離
DeepSeek-R1初版技術報告用約80萬條整理後的樣本微調Qwen和Llama學生,學生階段僅使用SFT。其中約60萬條為推理相關數據,約20萬條為非推理數據。報告給出了蒸餾模型在數學、科學問答和代碼評測上的結果。技術報告v1 §2.3.3、§2.4、§3.2
這裡的關鍵邊界是:訓練包同時改變了解題內容、輸出結構和指令行為。它支持這套配方可行,卻沒有通過同題、同學生、只改變軌跡語義的對照,單獨識別“過程內容”貢獻。教師訓練和篩選也有成本,不能僅看學生訓練階段就宣佈總成本優勢。該研究後來發表於Nature;本段配方定位使用明確保留的初版報告,不混用後續版本的章節編號。正式發表記錄
“錯誤答案也能學到東西”,並不等於內容不重要
Lippmann與Yang的《Style over Substance》比較R1軌跡與按結構化模板生成的GPT-4o軌跡,再訓練已有指令微調的學生。模板規定問題組織、探索、檢查和整合等結構。兩類數據都能改善所測任務;另一個消融把結尾改成錯誤答案,仍觀察到部分收益,但弱於正確版本。原文v3 §3–4、表1–2
**最容易漏讀的是作者自己的限定:錯誤結尾版本仍保留了前面的正確推理內容,並非純風格或全錯軌跡。**因此,這個實驗不能證明語義無用。本文進一步認為,結構化模板也可能改變解題行為,不能把這種干預直接視為只替換幾個口頭禪;樣本數相等也不等於訓練詞元量和推理用量相等。原文§4.2、附錄C–D
這篇工作確實給“風格有貢獻”提供了支持,但標題中的強烈措辭不應替代實驗邊界。本次讀到的是arXiv v3全文;作者主頁及arXiv註明COLM 2025,會議PDF的直接訪問受到瀏覽器驗證限制,未把搜索摘錄當作會議全文核驗。
跨任務進步比文風相似更有信息,但仍需拆開來源
Gautam在EACL 2026比較六對原始模型與R1蒸餾模型,任務是英語代詞指代與代詞使用。論文在數據集彙總層面報告改善,並通過人工標註分析錯誤類型;部分改善涉及指令遵循。這裡的人工評價是論文作者開展的,不是本文執行的審核。正式論文§3–5
這提供了超出典型數學題的行為證據,卻不能將效果全部歸於數學推理遷移:訓練混有非推理數據,原始模型多數沒有指令微調。評測雖設相同生成上限,蒸餾模型實際輸出更長;個別模型與數據集組合也會退步。作者明確討論了這些限制。因此,“跨任務有所改善”與“機制已被隔離”必須分開。原文§4、附錄B.1與D
| 證據切口 | 比較條件 | 支持的觀察 | 尚不能證明 |
|---|---|---|---|
| 輔助理由監督 | 任務特定學生,標籤與理由分支 | 理由在訓練中有用 | 通用方法已遷移 |
| 長軌跡蒸餾 | 篩選後的混合訓練包 | 配方帶來任務收益 | 內容是唯一來源 |
| 風格干預 | 模板軌跡與錯誤結尾消融 | 結構值得單獨研究 | 只有表面風格有效 |
| 跨任務評測 | 已發佈模型對,新任務測試 | 行為收益不侷限於文風 | 純推理遷移的因果效應 |
各行對應上述論文,既不是同預算競賽,也不是互相否定的陣營。任務、學生起點和指標不同,把它們的提升數字橫排成榜單,會丟失本篇真正關心的信息。
學生容量與預算,為什麼不能藏在腳註裡?
比較學生時,“同樣大小”不等於“同樣起點”。預訓練知識、數學專訓與指令訓練都可能影響它如何利用一段教師示範。小學生復現不了長解法,不足以說明其中沒有有效信息;大一些的學生表現更好,也不能單憑參數量把差異歸因於容量。更可信的比較應儘量固定模型家族、訓練配方和任務,再把容量作為明確變量。
教師答案正確,也不保證中間每一步都正確。篩選終點可以保留碰巧得對答案的路徑;學生又未必有足夠背景補齊教師省略的步驟。因此,教師越強不必然意味著它寫出的所有軌跡都更適合某個學生。這是需要比較的教學適配假設,本文沒有把它作為四篇研究共同證明的規律。
預算至少包含教師生成、數據篩選、學生訓練和學生推理四部分。同樣的問題數可能對應不同訓練文本量;同樣的最大輸出長度也可能對應完全不同的實際消耗。若關心使用價值,應比較準確率隨預算如何變化;若關心知識傳遞,則還要檢查控制用量之後,語義完整的軌跡是否仍有額外收益。
這也說明,更多“檢查”詞彙不是一個好的獨立能力指標。可以統計這些詞出現的頻率,但應把它當作行為描述,並與正確率、錯誤類型、長度以及新題表現分別記錄。否則,訓練目標與評價標準可能都圍繞教師文風打轉,最終只能得到“學生越來越像教師”的循環結論。
一個更能區分解釋的後續實驗
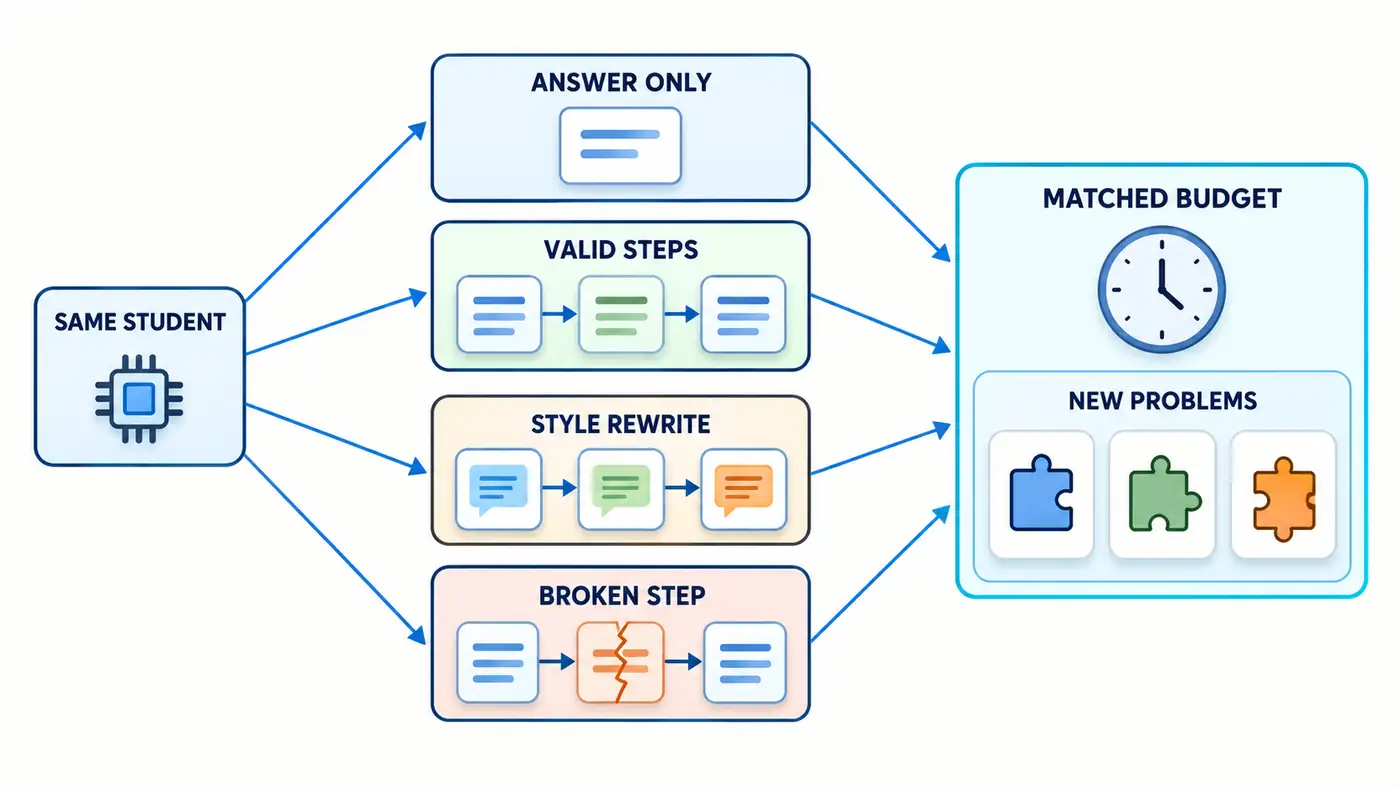
圖示為本文提出、尚未執行的實驗。四條通道從同一學生檢查點分別訓練,再按相同預算口徑評測新問題;箭頭表示實驗流程,不表示已證實的能力傳遞。封面的機械描摹與新迷宮同樣只是問題隱喻,不是內部機制的可視化證據。
先選可以自動驗證答案和中間操作的有限任務,固定一套公開訓練題,保留完全獨立的新結構測試題。為每道訓練題製作四種材料:只有答案、完整有效步驟、語義不變的風格改寫、只破壞一處關鍵步驟的軌跡。最後一組應保持最終答案和篇幅儘可能一致,並記錄矛盾位置,避免把標籤噪聲誤當成過程語義的作用。
風格改寫本身也需要驗證:刪掉“讓我檢查”不能同時刪掉實際檢查;替換措辭不能改掉運算依賴。優先用程序可核驗的步驟表示,再生成不同語言表達。若需要人工語義判斷,就必須真實收集標註,而不能讓自動評分冒充人工金標。所有改寫和剔除規則應在觀察測試結果之前確定。
訓練同時報告按題數對齊和按有效訓練詞元對齊的結果,並說明兩種口徑各自改變了什麼。測試端比較多個固定生成預算,記錄截斷率與實際用量;另設答案規範化評分,減少格式改善對計分的干擾。新題按結構或組合留出,而不只把同一模板換幾個數字;重複運行用於判斷差異是否穩定。
預期如何判讀?若完整步驟與語義等價改寫都優於答案組,並在新結構題上保持,而破壞關鍵步驟明顯傷害收益,就更支持過程語義有貢獻。若優勢主要隨輸出長度變化,匹配預算後大幅縮小,則更支持計算分配解釋。若收益主要來自減少無效答案,則應承認指令遵循是重要來源。它們可能同時成立,實驗應報告各自範圍。
即使得到第一種結果,也只能說在這個任務族、學生和預算內發現了可遷移信息,不能宣佈複製了教師的全部推理算法。下一步應更換題目生成規則、學生起點和教師表達,再看結論能否繼續成立。
總結:把“傳遞了什麼”留給能區分解釋的測量
蒸餾的實際收益無需靠“完全理解”來證明價值,機制研究也不能停在“不過是模仿”的評價上。現有證據允許我們承認理由監督、結構化軌跡和跨任務訓練後的行為進步,同時保留它們各自的因果缺口。閱讀下一篇蒸餾論文時,最值得追問的是:它改變了哪些信息,又排除了哪些替代解釋?
參考資料
- Cheng-Yu Hsieh、Chun-Liang Li、Chih-kuan Yeh、Hootan Nakhost、Yasuhisa Fujii、Alex Ratner、Ranjay Krishna、Chen-Yu Lee、Tomas Pfister,2023。Distilling Step-by-Step! Outperforming Larger Language Models with Less Training Data and Smaller Model Sizes。Findings of ACL 2023;使用正式論文全文。
- DeepSeek-AI,2025。DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning。配方定位使用2025-01-22的v1;Nature正式論文於2025-09-17發表,題名為DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning。
- Philip Lippmann、Jie Yang,2025。Style over Substance: Distilled Language Models Reason Via Stylistic Replication。全文使用2025-07-15的v3;COLM 2025狀態由arXiv與作者研究主頁交叉核對,會議全文直接訪問受限。
- Vagrant Gautam,2026。Training in Step-by-Step Formal Reasoning Improves Pronominal Reasoning in Language Models。EACL 2026短論文,121–135頁;使用正式論文全文。