復現價值:從手動降溫到隔離擬合
前面的實驗已經說明,同一組分類答案可以保持完全不變,同時具有不同的概率質量。但把幾個溫度都試一遍,再挑出最好看的結果,並沒有回答真正的研究問題:如果只允許使用一份事先隔離的校準數據,學到的溫度能否改善另一份數據上的概率?本篇只改變這一個環節。模型權重、分詞器、標籤映射和推理配置全部凍結,新增的可審查產物是校準池預測、溫度優化軌跡和審計池上的配對指標。
先說本次實際驗證:固定的 DistilBERT 情感分類器,在二百五十六條校準樣本上得到溫度約二點四八。隨後對三百六十條協議審計樣本應用這個數,負對數似然和校準誤差均下降,分類正確數保持三百三十。這個結果支持“一次隔離擬合能夠改善本劃分上的概率質量”,不支持“已經獲得普遍可靠的置信度”,更不意味著模型學會了識別所有錯誤。
核心思想:只改變概率的尖銳程度
分類器先輸出兩個未經歸一化的分數,稱為 logits,再用 softmax 轉成概率。溫度縮放在歸一化前把所有分數除以同一個正數:
這裡樣本編號為 ,類別編號為 ,類別數 ;一批輸入的分數張量形狀是 ,溫度 是一個正標量。溫度大於一時,兩類概率向均勻分佈靠近;小於一時,概率更加尖銳。它改變的是模型說話的力度,不改變類別分數的大小關係。
因此,只要保持正溫度和一致的並列處理規則,最大概率對應的標籤不會改變。原先判錯的句子仍然判錯。我們期待修復的是“錯誤答案卻報出接近一的概率”,而不是情感理解本身。這裡的概率針對固定的正負二分類任務,與上一文討論的生成模型有限候選歸一化分數不同,也不能直接解釋為開放生成內容正確的概率。
擬合目標採用負對數似然,簡稱 NLL:
其中 是校準樣本數, 是公開數據的原標籤。對真實標籤分配越小的概率,懲罰越大。選擇規則在新池推理前寫入協議;沒有用審計誤差挑溫度,沒有嘗試多個範圍後保留最優範圍,也沒有優化分箱誤差。
論文報告與官方代碼閱讀路線
Guo、Pleiss、Sun 與 Weinberger 的 ICML 二〇一七年論文討論現代神經網絡的置信度校準,並在其研究的數據與模型中報告溫度縮放的有效性。那是論文報告的證據範圍。本篇使用的是另一個固定文本分類檢查點與較小的探索劃分,因此不復述原論文數值,也不把自己的結果稱作完整論文基準復現。論文與出版信息
閱讀作者代碼時,可以先找 temperature_scale,確認除的是 logits,再看 set_temperature:先收集驗證分數和標籤,再以交叉熵優化單一溫度。作者實現使用 GPU 與 LBFGS;本篇沒有照搬整個訓練棧,而是為二分類目標編寫獨立教學求解器。具體固定提交和函數定位均記錄在源碼地圖中。作者實現
本地改寫的理由是可審查性:令逆溫度為 ,並記兩類原始分數差為 ,則目標的一階導數為:
其中 是 sigmoid 函數,標籤編碼為零或一。導數隨逆溫度單調不減,因此可以在預註冊區間用二分法找零點;如果區間內沒有零點,就報告邊界解。本次固定執行一百次二分並保存每一步,不把迭代次數當作模型訓練輪數。溫度未碰到邊界,最終梯度約為浮點精度下的零。
最小實驗:先凍結身份,再打開分數
數據沿用官方 SST-2 validation 的八百七十二條記錄。既有登記按樣本編號與固定前綴計算哈希,再排序劃為探索二百五十六條、校準二百五十六條、協議審計三百六十條。本次沒有重新洗牌,沒有從探索池挑選“更典型”的校準樣本。三個池的身份清單在基線實驗時就已保存,本次逐項驗證不重疊。
必須披露:SST-2 在歷史研究中已經使用過。新劃分只能隔離本輪擬合的信息流,不能擦除歷史觀察,也不能叫作從未見過的測試集。協議審計池今後同樣屬於已觀察開發證據,不能再被包裝成獨立最終確認。IMDb 三池本次未下載、未預測,最終確認池仍須遵守後續登記與使用規則。
模型是官方固定 revision 的 DistilBERT SST-2 檢查點,權重、配置和詞表都通過文件哈希核對;數據也核對固定 parquet 文件哈希。標籤零為負面、一為正面。推理用 CPU、單精度、四線程、eager attention,批量十六、最多五百一十二個 token,並關閉訓練模式。不更新任何網絡權重,只優化後處理的一個數。
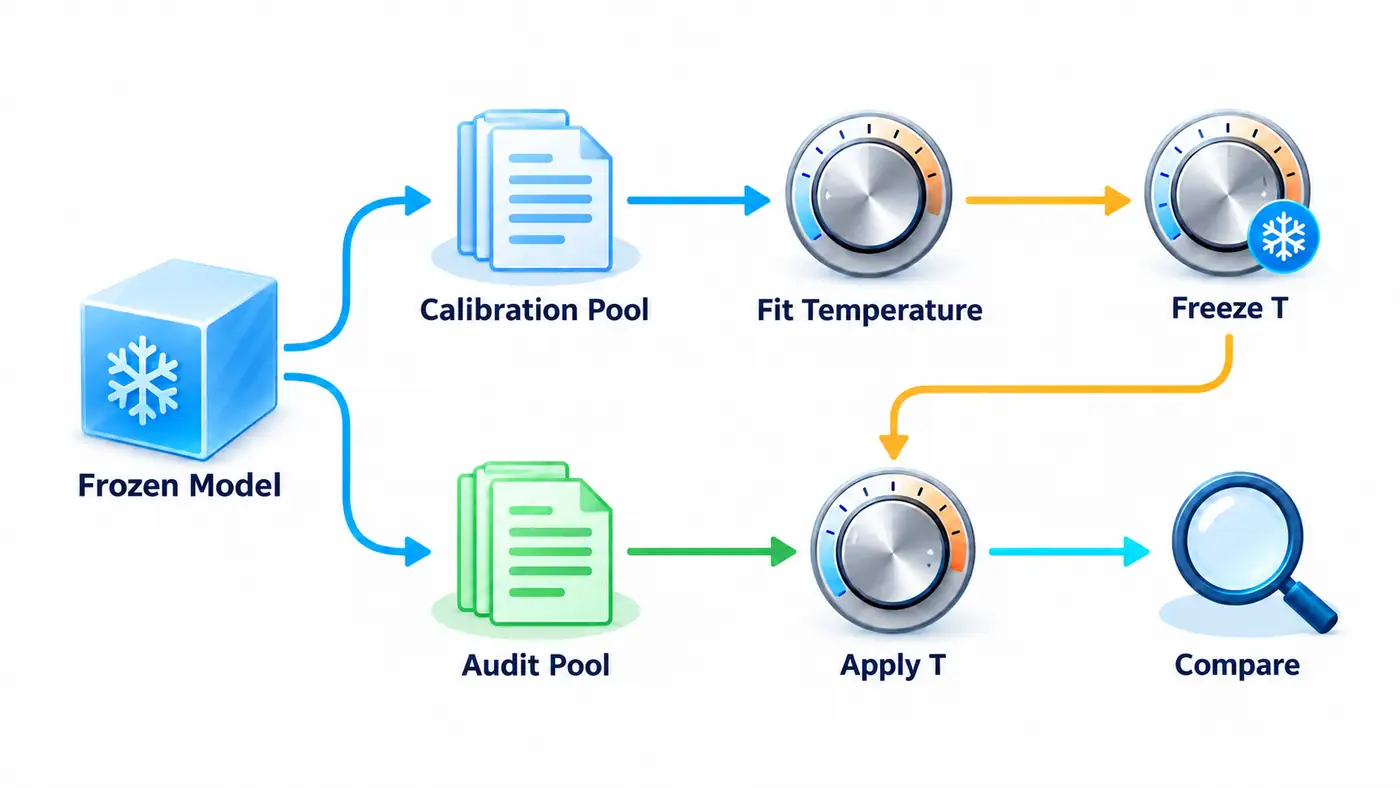
圖中的兩個 Pool 表示相應數據經過凍結模型後的分數集合。上路擬合溫度並凍結,下路僅應用這個數後計算指標;審計結果沒有回到擬合節點。先執行校準池前八條試跑,再運行完整校準池,落盤溫度文件後才執行審計池。每個樣本保存編號、文本哈希、原標籤、兩維 logits 和概率,不再分發原始語句。
評測協議與本次實際驗證
主指標是審計池 NLL,輔助指標包括雙類別求和形式的 Brier 分數、十個等寬箱的預期校準誤差 ECE、平均置信度和準確率。Brier 是兩類平方誤差之和,量綱範圍為零到二;不能與只對正類計算的單項版本混用。ECE 使用左閉右開箱,最後一個箱包含右端點,並保存每箱分母。
| 審計池指標,樣本數360 | 原始概率 | 校準概率 |
|---|---|---|
| 正確數 | 330 | 330 |
| 準確率 | 0.916667 | 0.916667 |
| 平均置信度 | 0.982405 | 0.918592 |
| NLL | 0.384113 | 0.237136 |
| 雙類 Brier | 0.154001 | 0.135151 |
| ECE10 | 0.073274 | 0.019900 |
擬合所得溫度為 。校準池本身的 NLL 從零點四〇三七降至零點二四二六,但這不是獨立的效果驗證;真正需要關注的是凍結溫度之後的審計結果。審計平均置信度與準確率之間的差縮小到約零點〇〇一九,仍不能僅憑這個總體均值聲稱所有概率區間都校準好了。
事先固定的九成閾值也揭示了邊界:原始概率中三百四十三條達到閾值,其中二十三條錯誤;校準後只剩二百七十九條達到閾值,其中十條錯誤。接受集合變小、錯誤比例降低,但被保留的錯誤沒有消失。這只是固定閾值的描述性統計,尚未構成拒答閾值選擇實驗,也沒有校正反覆觀察產生的選擇偏差。
本次完整推理的校準階段約一點一五秒,審計階段約一點三七秒;導入之後整個過程約二點八〇秒,進程峰值常駐內存約九點六八億字節。依賴下載、初次導入和環境修復不包含在該耗時中;沒有測量能耗、服務吞吐或硬件峰值顯存。所有結果來自真實檢查點前向計算,圖示中的光束不是測量曲線。
獨立復算與失敗排查
獨立審計腳本不導入主實驗模塊,用 sigmoid、穩定 softplus 和二分類 Brier 恆等式從 logits 重新計算全部指標;又用直接針對溫度的黃金分割搜索複核優化結果。兩種求解方法的溫度差約二乘十的負八次方,指標最大差約八乘十的負十七次方。它驗證確定性算術一致性,不稱為真人審核,也不能代替語義標註質量判斷。
環境恢復留下了真實失敗記錄:此前臨時環境缺失 PyTorch;默認依賴緩存寫入受限,首次聯網安裝也失敗。工作區舊環境導入出現停滯,之後停止該任務進程,在隔離臨時環境安裝固定依賴並完成試跑。另一次啟動把虛擬環境解釋器軟鏈接解析成基礎解釋器,導致依賴不可見;修正執行路徑後繼續,沒有用合成數據頂替模型實驗。
復現失敗時,優先看資源哈希是否一致,再看標籤映射、推理模式和 logits 形狀。若溫度變成負數、分類答案變化或優化結果落在邊界,先排查實現和數據,不應直接解釋成校準發現。若校準目標改善而審計目標變差,也應保留這份結果;重新調整範圍後再報告同一審計池,會把審計數據逐步變成調參數據。
源碼與復現入口
完整源碼已公開:固定提交目錄、README、SOURCE_MAP。匿名下載的二十六個文件與本地及壓縮包逐一核對一致,公開副本的獨立審計和真實八條試跑通過。配套包包含完整入口、依賴、資源鎖、劃分清單、協議、源碼地圖、兩池逐樣本結果和獨立審計程序。讀者取得公開源碼後,在源碼目錄安裝固定依賴,先執行資源獲取,再運行真實模型:
python run.py prepare --cache .cache117
python run.py smoke --cache .cache117
python run.py run --cache .cache117
python audit.py
預期產物為兩池預測文件、溫度與優化軌跡、聚合指標、形狀與環境記錄、獨立復算結果。已有固定資源可以複用校驗後的緩存,無須反覆下載模型。約二百七十兆字節模型權重通過官方入口獲取,不打進源碼包;數據許可信息不明確,包中只放身份哈希和派生數值,不含原始文本。
還有一個容易混淆的檢查:獨立求解器得到相近溫度,不等於溫度在重新抽樣後也穩定。前者檢查計算,後者檢查數據變化帶來的估計波動。本篇只完成前者,沒有用反覆抽樣挑選更好結果。讀者如果想比較不同機器,應先對齊輸入身份、模型文件與概率計算精度,再比較逐樣本分數;僅比較最終四捨五入後的指標,可能掩蓋標籤錯位或文件混用。保存失敗日誌的意義也在這裡:它讓環境修復與科學選擇可以分開追蹤,避免把一次沒跑通的命令寫成已經驗證的入口。
研究問題與總結
本篇最有價值的證據不是溫度恰好等於多少,而是擬合和評測職責終於分開。一個標量在這個固定劃分上明顯改善了概率質量,且沒有改變任何分類標籤。這讓“校準有用”成為可以獨立復算的具體觀察,同時也限定了它修復不了的部分:錯誤的語義決策、少量高置信錯誤,以及未觀察分佈上的可靠性。
下一步可以檢驗校準樣本數變少時溫度是否穩定,但必須先固定嵌套樣本、隨機種子與彙總規則,不能從審計集裡挑出最順眼的溫度。另一個待檢驗假設是少數嚴重錯誤主導了 NLL 擬合;它需要預註冊影響分析,不能僅從總體均值倒推出結論。本次沒有做顯著性檢驗,沒有給出總體覆蓋保證,也沒有把單次效果推廣為所有模型的規律。
參考資料
檢索與實際訪問日期:2026-11-02。
- Chuan Guo, Geoff Pleiss, Yu Sun, Kilian Q. Weinberger. 2017. On Calibration of Modern Neural Networks,ICML,PMLR 70,1321–1330。
- Geoff Pleiss 等作者代碼:temperature_scaling.py 固定提交,MIT;本次閱讀對照,求解器獨立實現。
- Hugging Face:DistilBERT SST-2 固定模型卡。
- Stanford NLP:SST-2 固定數據卡。
- Hugging Face:Transformers 固定分類器實現,Apache-2.0。
作者作品推廣
以下是作者自有產品推廣。除了寫科研博客,我也獨立開發一些日常工具,歡迎按自己的需要了解:日常收支小記用於記錄收支、安排預算和儲蓄目標,前往 App Store;一事微光幫助你根據時間和精力選擇小行動,並記錄完成後的感受,前往 App Store。更多技術文章與個人作品見作者網站。這些介紹與本篇實驗結論相互獨立,不代表論文作者或機構的推薦。