復現目標:先問概率在什麼範圍內歸一化
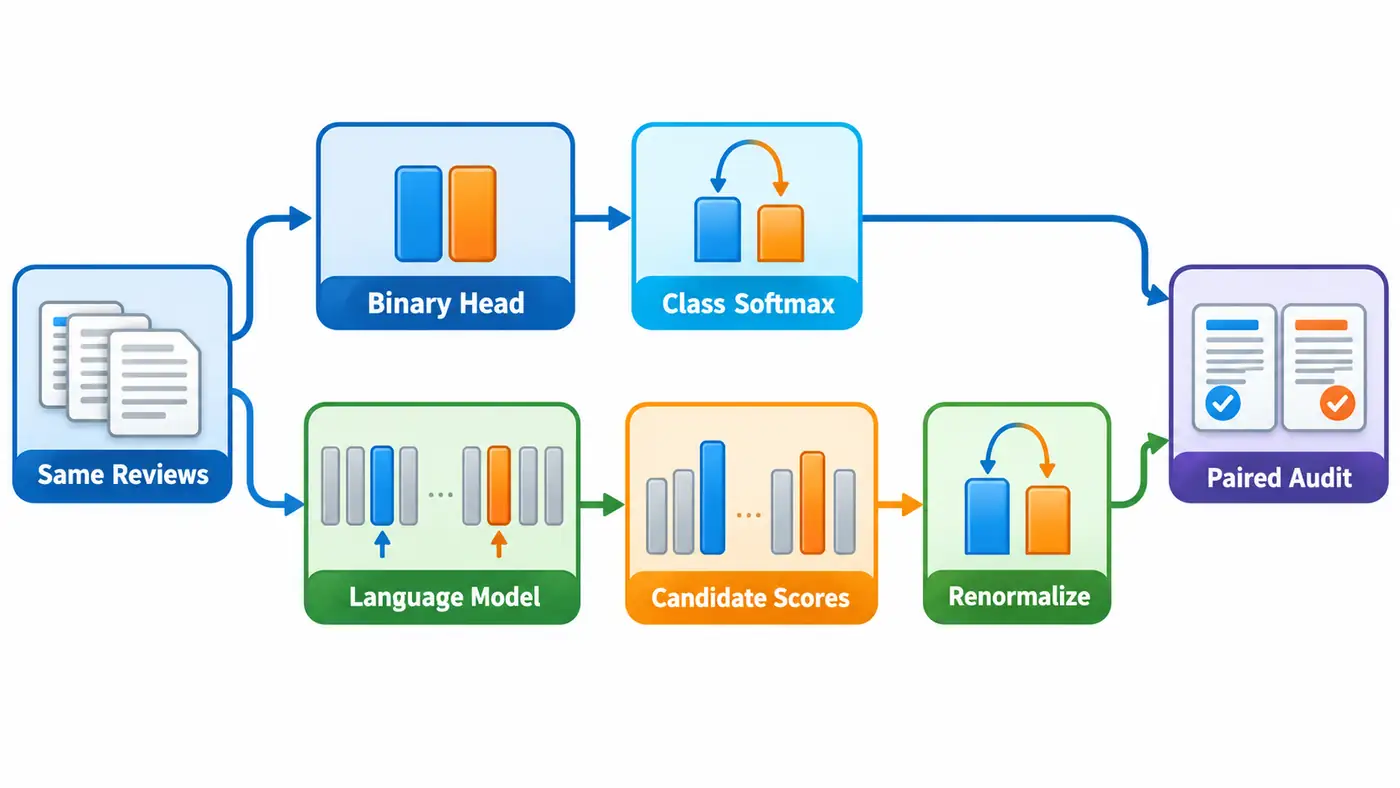
同樣顯示“八成把握”,兩個模型可能在回答完全不同的問題。情感分類器輸出正面、負面的概率;語言模型先給詞表中的續寫分配概率,我們再只保留兩個標籤,把它們重新歸一化。界面上的數值都在零到一之間,並不意味著它們已經成為同一種可靠性證據。本篇固定同一組公開短評,建立可以逐項追蹤的對照,重點是檢查分數的含義,而非爭奪模型排名。
較上一篇高置信錯誤分組,本篇新增的變量是預測接口:一邊沿用已經保存的二分類頭結果,一邊加入真實生成式模型的有限候選計分。樣本身份、原始標籤和比較分母保持一致,不擬合溫度,不挑提示模板,也不調整拒答閾值。新增產物包括每條候選的 token、對數概率、歸一化概率、候選總質量,以及獨立復算記錄。初學者可以沿著“分母”理解差別;工程讀者可以執行入口;研究讀者則應關注結論在哪些條件下成立。
核心思想:兩個數字可以同表評測,不能自動同義
分類頭給每個標籤一個 logit,即尚未歸一化的實數分數。對兩個分數執行 softmax 後得到類別概率:
這裡 是影評, 是標籤編號, 是分類頭輸出;單條輸出形狀為兩個數。預測取最大概率對應的標籤,置信度取最大值。這種概率仍可能失準,不能因為分類頭專門訓練過就把它當成真實正確率。Guo、Pleiss、Sun 與 Weinberger 的校準論文討論的正是預測置信度與實際正確性的關係;它沒有保證本篇某個小模型一定校準良好。
語言模型的輸出則覆蓋整個詞表。給定凍結提示 ,候選字符串 的計分為:
其中 是候選的 token 數, 表示固定模型參數。先按因果順序求每個 token 的對數概率,再求和;沒有長度平均,也沒有附加結束符。本次兩個候選恰好各佔一個 token,因此排除了候選長度差異這一具體混雜因素,但不意味著其他標籤詞也如此。 只表示在這兩個字符串之間重新分配後的相對權重。
如果兩個候選都是不同的單 token,可以進一步計算:
是下一 token 落在這兩個候選中的概率總質量。它與 回答不同的問題:即使兩候選之間一邊佔絕對優勢,它們之外仍可能保留大量詞表概率。多 token 候選、前綴重疊或長度歸一化情形不能不加檢查地沿用這個簡單解釋;本次的單 token 檢查是結論的一部分。
數據、預算與凍結協議
數據來自 Stanford NLP 的 SST-2 validation 固定版本,按 SHA256 對字符串“cycle7:”與樣本編號的拼接結果排序,取前二百五十六條。本輪另外二百五十六條校準池及三百六十條協議審計池沒有參與此次預測,IMDb 也未使用。SST-2 在舊輪已有歷史接觸,因此這是複用公開數據的探索實驗,不能包裝成未見測試。新模型也可能在預訓練中接觸公開文本,本文沒有零汙染證明。
分類器是固定 DistilBERT SST-2 檢查點,生成模型是固定 SmolLM2-135M-Instruct;精確 revision、文件哈希與依賴列在配置和鎖文件中。前者沿用首篇真實推理的二百五十六行記錄,後者本次新執行,不把複用結果的時間寫成新測量。兩者的訓練目標、規模、分詞器和輸入格式不同,因此本實驗不是僅改變架構的因果消融。
生成側使用固定英文問題,要求在 positive 與 negative 之間判斷情感,答案前綴為 Answer:,候選含一個前導空格。沒有聊天模板、少樣本示例、額外起始符或開放生成;這是一種凍結的原始續寫接口,不代表模型卡推薦聊天方式的最優效果。每條先驗證完整字符串分詞保留提示前綴,超過五百一十二 token 則報錯,不靜默截斷。先跑八條試驗,再按預定預算執行全部樣本;未因試驗準確率改變模板。
官方代碼閱讀路線
先看兩個官方模型卡,辨認任務與許可證;再看 Transformers 固定提交中的 DistilBERT 分類頭和 LlamaForCausalLM。前者把隱藏表示映射成兩個標籤分數;後者通過 lm_head 映射到整個詞表。本次 SmolLM2 使用該語言模型實現,已將實際安裝的源碼與固定提交文件逐字節核對,不以類名相同代替版本一致。
閱讀運行腳本時,最容易錯的不是 softmax,而是預測位置:位置上的輸出預測下一個 token,不能把候選 token 本身所在位置的輸出當成它的條件概率。代碼先去掉完整序列末尾 token,再截取提示末位開始的輸出。日誌保存了每次 logits 張量形狀;複查腳本另用“僅提示輸入、取最後位置、全詞表 softmax”的路徑核對八條真實分數。兩條實現路徑吻合才允許討論模型表現。
本地概率公式和算術審計屬於獨立教學實現;神經網絡前向實際調用官方庫,沒有複製或替換模型層。源碼地圖給出固定提交、具體函數、許可證和本地對應關係。數據卡許可標記 unknown,所以分發包只保存身份、哈希和派生結果,不包含原始影評;讀者通過固定下載地址取得數據。
最小實驗與實際結果
正式運行使用 CPU、float32、eager attention 和四個線程,不訓練。新增生成側執行五百一十二次候選前向,每條兩個候選;單 token 情況本可共享同一提示前向,本篇保留直觀實現,並明確其計算冗餘。最終版本復跑的正式前向約十九點五五秒,導入依賴後的總時間約二十點七八秒,進程峰值內存約一點五九 GB。下載耗時沒有重新測量,資源來自已校驗緩存;這些數字不是跨硬件吞吐量基準。
| 指標,同一組256條 | DistilBERT分類頭 | SmolLM2候選歸一化 |
|---|---|---|
| 正確數 | 233 | 130 |
| 準確率 | 91.02% | 50.78% |
| 平均最大概率 | 98.17% | 87.16% |
| 平均負對數似然 | 0.385259 | 0.996743 |
| 兩類別求和Brier | 0.169913 | 0.718332 |
負對數似然取原始標籤對應概率的負對數,Brier 對兩個標籤的概率平方誤差求和後按樣本平均;兩項都越低越好。可以將它們用於同一有限分類任務的比較,但生成側必須明確使用 ,不是全詞表概率。這裡沒有重現某篇論文的表格,也沒有把兩百多條探索樣本當成完整 benchmark。
最明顯的失敗是:生成側二百五十六條全部選擇 negative,正確數恰好等於樣本中負面標籤的數量。兩模型有一百三十三條預測不一致。兩個候選的平均總質量僅約百分之四十六點八四,其餘質量分配給別的下一 token。這足以展示“在兩候選之間自信”與“自由生成答案可靠”之間缺少的環節,但剩餘詞表質量不等於錯誤率:別的 token 可能是換行、解釋或其他合法表達,本篇沒有對其語義做人工判定。
評測協議與失敗排查
先查身份,再查位置,最後看指標。獨立審計逐行核對原始編號、文本哈希和標籤,重建候選求和、二項歸一化、最大值、正確數和均值;分類側與生成側嚴格按身份配對。另一個真實前向複查確認候選解碼分別是帶空格的 negative 和 positive,排除了標籤順序顛倒及錯一位取分這兩種解釋。自動復算只說明這些確定性步驟一致,不稱為人工審核。
全負面現象依然不能直接歸因於模型“只會猜負面”。原始續寫接口、問題中的詞序、標籤詞先驗和未採用聊天模板,都可能影響這一檢查點。以上屬於作者推斷中的競爭解釋,當前實驗沒有逐個隔離。保留失敗比事後替換一個更好模板更有價值:換模板會把本篇從定義清楚的測量實驗,變成未經登記的搜索過程。後續若研究模板遷移,應先登記候選、預算和選擇數據,再運行對照。
還要區分算術正確與科學有效。獨立腳本能夠發現概率沒有歸一化、樣本錯位或正確數算錯,卻不能替人判斷影評真實情感是否有歧義。本篇沿用官方標籤,不增加人工語義標籤,因此無需偽造新的真人確認;未來若改寫文本並聲稱標籤保持,仍必須有真實審核。緩存鍵也需要包含模型、分詞器文件、提示、候選、數據身份、精度、代碼與協議哈希,不能只用樣本編號。
源碼與復現入口
本篇已公開至固定提交:31476a32d0a4 源碼目錄、README 運行說明、SOURCE_MAP 源碼地圖。遠端文件清單及哈希已與本地歸檔核對,公開副本的算術審計和八條真實模型試跑均通過。
安裝固定依賴後,先運行 python prepare.py --cache .cache 獲取並核驗資源,再運行下面的統一入口。將末尾的 --smoke 去掉即執行正式二百五十六條;預期輸出是逐樣本候選記錄、比較彙總和開始時的配置哈希。
python run.py --model-dir .cache/model --data .cache/validation.parquet --smoke
python audit.py
算術審計默認檢查包中保存的正式結果,不把八條 smoke 當作正式評測。真實前向複查使用 check_forward.py 的同名資源參數。配套 README 說明資源量、環境、歸檔復跑與實際執行範圍;沒有依賴作者機器的隱含模塊,也不需要讀者打開本地博客路徑。正式結果保持凍結,復跑請在獨立副本中進行。
復跑時建議先比較逐條結果,再比較聚合數字。均值接近可能掩蓋樣本配對錯誤;相同正確數也可能由完全不同的錯誤集合構成。本次保存文本哈希而不公開原文,是為了兼顧身份核驗與數據分發邊界。若讀者更換依賴或硬件,應報告最大數值偏差和是否改變決策,不要僅憑程序沒有報錯就宣稱逐字節復現。
讀者還可以把候選總質量與最大歸一化概率放在兩列查看,但不要把前者乘以後者後命名為“真實正確率”。這個乘積在本次單詞候選條件下只是被選 token 的原始續寫概率,仍缺少答案語義、生成停止條件與正確性判定。指標命名應保留這些條件,避免在後續可視化和拒答實驗中悄悄更換估計對象。
可檢驗問題與總結
這次證據支持一個有限結論:在相同短評與標籤下,兩類分數可以接受同一分類評測,但候選歸一化改變了概率的條件範圍,不能直接解釋為開放生成的正確概率。生成模型的失敗接口也提醒我們,較低平均置信度本身並不表示校準更好,更不能代替正確數與概率損失。
接下來可以檢驗三個不同問題:固定模型只改模板,是否仍全負面;固定模板替換等長標籤詞,候選質量是否改變;只在隔離校準集擬合溫度,概率損失能否改善。它們需要分開登記,不能一次修改所有因素再挑最好結果。本系列下一步進入溫度校準,先建立合法的數據使用協議;當前負結果與完整日誌保留,作為後續解釋必須面對的事實。
參考資料
檢索與訪問日期:2026-11-01。
- Chuan Guo、Geoff Pleiss、Yu Sun、Kilian Q. Weinberger,2017,ICML:On Calibration of Modern Neural Networks。用於校準概念,不聲稱復現原論文數值。
- HuggingFaceTB:SmolLM2-135M-Instruct固定模型卡。
- DistilBERT:SST-2分類檢查點模型卡。
- Stanford NLP:SST-2數據卡。
- Hugging Face:Transformers固定提交語言模型前向。
作者作品推廣
以下是作者自有產品推廣。除了記錄科研實驗,我也獨立開發了一些整理日常的小工具,歡迎瞭解:日常收支小記用於記錄收支、安排預算和儲蓄目標;一事微光幫助按當下時間和精力選擇小行動,並記錄完成後的感受。更多技術文章與個人作品可以訪問作者網站。這些產品與本文研究結論沒有背書關係,歡迎按自己的需要選擇。