- 日期:2026-10-18
- 讀者:研究生、科研新人和工程型研究者
- 範圍:真實 GPT-2 small,公開 IOI 模板構造的十六條開發樣本,兩種姓名反事實;不是自然語料或完整論文基準。
摘要:最重要的頭,取決於問了什麼
上一篇把乾淨輸入的注意力頭激活放回被改寫的輸入,發現末位置的 L8H10 平均恢復效果最大。這裡的層和頭均從零編號。這個結果還缺一項檢查:如果用另一種方式改變句子,排名是否保持?本篇凍結模型、樣本、干預和計分,只改姓名替換規則,重新跑完整網格。本次實際驗證:前十名有九個相同,全部頭的秩相關為 0.857,但第一名從 L8H10 變成 L9H9;L8H10 的平均恢復比例從 28.6% 降到 12.5%。這是一項局部穩定性實驗,不能把名次相同當成完整電路,也不能把換位直接叫作解釋失效。
一、復現價值:先明確反事實的語義
間接賓語識別(IOI)要求模型根據前文判斷東西交給誰。例如“Michael 和 Christopher 去商店,Christopher 把戒指交給……”,預期續寫 Michael。記收禮人為 IO,重複出現的主語為 S。所謂 corruption,本文指有規則地改寫輸入,形成與原句不同的任務;它並不等於往模型裡隨意加噪聲。
我們保留兩個反事實。S2 Flip 只把第二次出現的 S 改成 IO;Global Swap 同時交換句中所有 IO 和 S。前者改變最後一次行動者,後者一致地交換人物身份。兩種改寫後的收禮人都是原 S,因此模型更偏向原 S 可以是正確理解了新句子。全文始終計算原 IO 相對原 S 的分數,避免換過答案再誤稱恢復成功。
| 設置 | 原句姓名序列的一個例子 | 改寫後序列 | 改動詞元數 |
|---|---|---|---|
| 乾淨輸入 | IO、S、S | 不變 | 0 |
| S2 Flip | IO、S、S | IO、S、IO | 1 |
| Global Swap | IO、S、S | S、IO、IO | 3 |
這裡的姓名都能編碼為含前導空格的單個詞元。兩種輸入長度、姓名頻次與非姓名詞元相同,卻改變了不同位置。不能將差異只歸因於“改動數量”:首次提及順序與替換位置也隨之變化。
二、論文給出動機,本實驗限定問題
論文報告:Wang 等人的 IOI 工作在 GPT-2 small 中結合多種干預研究組件,並用忠實性、完整性和最小性評價解釋[1]。Zhang 與 Nanda 比較了激活替換中的破壞方法和計分方式,報告這些方法選擇可能改變定位結果[2]。後者區分高斯噪聲與語義相關的詞元替換,並討論替換哪些詞元的重要性。
本文只比較兩種離散姓名反事實,沒有重做其高斯噪聲實驗。我們也沒有運行 TransformerLens 的整套模型轉換:實際前向來自官方 Transformers,替換切片的約定參考 TransformerLens 固定源碼[3][4]。這一區別使實現、論文結論和作者解釋各有明確邊界。
一個額外的設計約束是平衡性。十六條材料覆蓋兩模板、兩提及順序、兩個相鄰姓名對及兩種角色方向,僅涉及三個重疊姓名。在完整材料中,每種改寫後的句子多重集合都等於乾淨句子的多重集合,只是與原句的配對關係改變。於是總體基線難度得到控制,但單條輸入的信息路徑並未相同。這個性質由詞元序列逐項核對,不靠事後挑選分數相近的樣本。
三、核心思想、公式與模塊
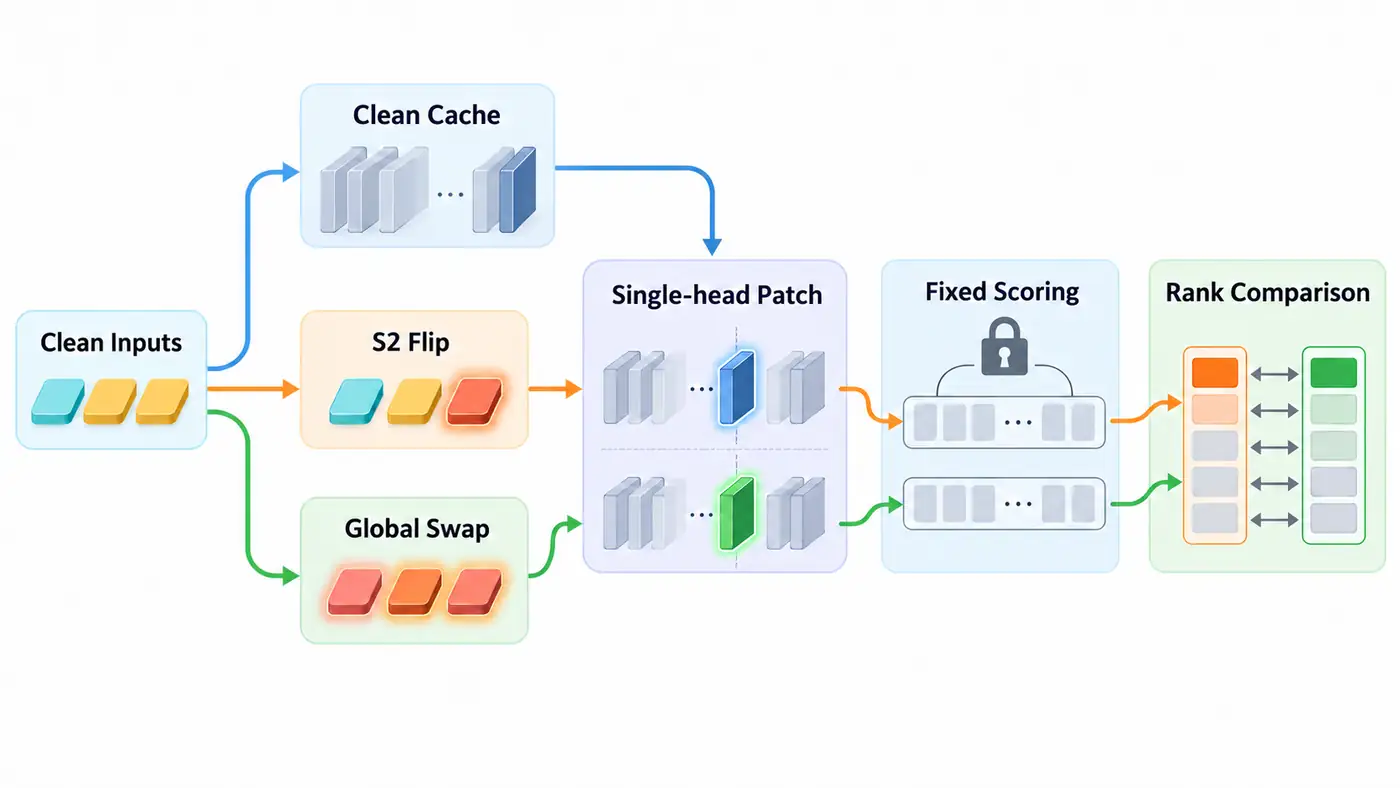
圖中詞元採用原 IO、S、S 的示例順序;暖色突出被改動位置,不編碼人物身份。兩條路徑共享乾淨來源、節點定義與原候選答案,排名結果不會反饋到本次選擇規則。
先定義候選 logit 差。logit 是歸一化為概率之前的模型輸出:
其中 是樣本, 是破壞條件, 在主排名中指末位置的一個層—頭組合; 為原候選的輸出分數, 是干預相對相同破壞基線的增量。正值表示偏好向原答案移動,不保證已經恢復正確預測。
主指標按十六條取平均,輔助報告恢復比例:
。分母是平均乾淨—破壞間距,必須大於預定閾值;不把每題比值再平均,也不把負值裁成零。同一條件下分母相同,因此兩種指標給出相同的頭排名,不能把它們當成獨立支持證據。
干預對象是注意力加權值向量 ,位於輸出投影之前。緩存形狀為 ,查看為 :批次、序列位置、十二個頭、每頭六十四維。一次只替換一個層、位置、頭的向量,再讓後續網絡正常計算。它不同於直接修改注意力權重,也沒有一次替換多個頭。
四、官方代碼閱讀路線
先讀模型卡和資源鎖,確認 GPT-2 與分詞器共用固定 revision[5]。再看官方 GPT2Attention 中加權值輸出的合併與 c_proj,確定鉤子插在正確邊界;最後對照 TransformerLens 的 layer_pos_head_vector_patch_setter,核實位置和頭維的含義。具體提交、行號、許可證及本地映射均在源碼地圖。
本地 run.py 的前向、緩存、單點替換及對照沿用上一篇;新增部分僅為反事實構造、條件循環和日誌標記。analyze.py 聚合排名,audit.py 獨立復算,後者不導入實驗與聚合腳本。公開模板由 rebuild_samples.py 獲取固定源碼並解析常量重建[6],不執行整個上游倉庫。所需自寫模塊全部隨本篇分發。
五、最小實驗與評測協議
模型和分詞器固定在 607a30d783dfa663caf39e06633721c8d4cfcd7e;模板固定在 ea15315dd24481e9e2ac5c3ef335d82907a1dc34。配置沿用種子 101、CPU float32、eager 注意力、四線程、干預批次三十二。沒有訓練、生成、截斷、額外起始詞元或留出集推理。
正式執行前保存協議與腳本哈希。先跑一條材料的兩條件完整網格估計資源,再運行全部十六條。每個條件掃描十二層、十二頭及全部十五或十九個位置,合計 78,336 次單點替換。末位置 END 是上一篇已規定的主排名位置,其餘位置全部留檔,沒有看完熱圖再選亮點。實際資源為 正式進程牆鍾 396.294 秒、峰值常駐內存 1,607,516,160 字節;導入後計時 395.671 秒,系統為 macOS、Python 3.12.14、PyTorch 2.6.0、Transformers 4.49.0;未測能耗或獨立顯存峰值。
主比較事先固定為全部一百四十四個 END 頭的秩相關、前十名重合度以及上一實驗獲勝頭 L8H10 的配對變化。重合度是交集大小除以十,Jaccard 則除以並集大小。排序按平均增量降序,精確相等時按層和頭編號確定次序。我們同時檢查近鄰分差,避免把接近數值誤差的名次變化誇大。樣本共享模板與姓名,不能按十六個獨立自然樣本畫置信區間。
六、結果:同時看穩定部分與改變部分
兩條件的平均乾淨分差均為 4.295,破壞分差均為 −4.295,平均間距均為 8.591。單詞元條件復現上一篇的一百四十四個 END 頭排名及增量。以下是同一節點在兩條件下的真實值:
| END 節點 | 單詞元增量/排名 | 全姓名交換增量/排名 |
|---|---|---|
| L8H10 | 2.455/1 | 1.078/3 |
| L8H6 | 2.215/2 | 0.113/11 |
| L9H9 | 1.859/3 | 1.992/1 |
| L10H0 | 1.332/5 | 1.364/2 |
| L10H7 | −3.841/144 | −3.782/144 |
前十名重合度為 90%,Jaccard 為 0.818;L8H6 退出前十,L10H2 進入。總體排序有相當部分保持,但“唯一最重要頭”的表述不成立。上一實驗預定關注的 L8H10 在十五條材料上增量下降、一條上升,平均配對變化為 −1.377。例外是樣本 2,從 2.363 升到 2.735,說明平均下降不能替代逐例說明。即使分別使用各條件最強的單頭,干預後平均分差仍為負,並沒有恢復完整行為。
兩條件均無精確並列,但一百四十三對相鄰名次中,分別有一百零二對和一百零七對的增量間隔小於 0.001。前十與第十一名的邊界間隔分別為 0.00355 和 0.10615,不能將這個邊界描述成統計顯著。最大換位的 L8H3 從第十四降到第一百三十八,原始增量卻只是 0.079 到 −0.035。名次移動一百多位,不等於出現同等量級的行為損失。
負效果也構成證據。全位置網格中,增量小於 −0.001 的節點數分別為 3,142 和 6,964;這包含不同層與位置,不是相互獨立的失敗次數。L10H7 在兩條件下均排最後,乾淨激活寫入當前破壞上下文會進一步偏向原干擾答案。現階段只能報告這種條件性作用,不能直接給它貼上普遍“有害組件”的標籤。
一個常見誤讀是把全局秩相關當成“解釋可信度百分比”。這裡的一百四十四個頭包含許多近零效果,次序可能對微小變化敏感。因此報告既保留總體排序,也展示主要頭的原始增量、前十邊界間隔與逐條配對結果。閾值附近的換位和顯著幅度的改變應分別理解。
七、失敗排查與獨立驗收
替換實驗先驗證實現,再解釋熱圖。整段嵌入後狀態換成乾淨狀態,應恢復乾淨前向;把破壞緩存寫回其自身,應完全不變。我們還用輸出投影后的線性增量重做預先指定節點,與投影前替換對照,並核對完整官方模型與只讀最後位置的實現。真正修改位置之前的節點應只有容許範圍內的數值差。
本次完整狀態正控與自身回寫誤差均為零。官方完整前向核對最大誤差為 0.000191,獨立投影增量核對為 0.0000534,批次形狀差異為 0.000221;修改位置之前的干預增量最大約 0.0000610,均小於預定 0.001 容差。該容差是實現核驗門檻,不是對真實效應的置信區間。
獨立腳本重算原候選差值、完整網格唯一性、均值、排名、恢復比例及多重集合;秩相關另用序號向量的 Pearson 公式計算。十一項損壞測試故意改候選、改位置、漏節點、重複節點或偽造排名與重合度,均應被拒絕。自動算術復算沒有被稱為真人語義金標。源碼聯網初次受沙箱限制,後續匿名固定版本讀取成功,未改變實驗協議或模型資產。
八、研究問題與邊界
作者推斷:若相同乾淨來源在不同反事實路徑下產生不同效果,組件貢獻可能依賴下游上下文。這是待進一步區分的解釋,當前排名還無法判斷具體是哪條信息通路變化。這裡同時改了姓名位置與提及順序,沒有獨立操縱其中一個因素;也沒有證明兩種路徑在任意自然文本上等價。
可檢驗的後續問題是:固定本次開發集選出的頭,聯合消融的損失是否等於各頭單獨損失之和?若不等,可能存在交互或補償,需要不同消融基線區分。之後才在預留名字、模板上測試遷移。不能在遷移失敗後重新挑頭,再把同一批數據稱為確認集。本次仍是開發階段證據,重複樣本、有限模板與潛在預訓練接觸都限制外推。
源碼與復現入口
已公開並核驗的固定版本:完整源碼目錄、README 與運行步驟、SOURCE_MAP 官方實現映射。49 個文件與本地歸檔逐項一致;公開副本已通過獨立審計和一條樣本雙條件、4,320 次替換的真實試跑。本文正式結果為十六條雙條件完整掃描。
在按 README 安裝鎖定依賴後,最小真實運行命令為:
python run.py --cache ./cache --out replay-smoke --smoke
首次執行按固定 revision 下載並核驗約五百五十兆字節模型資源;已核驗緩存可複用。輸出逐條件樣本、全部干預分數、彙總、階段狀態與運行環境。python audit.py --results replay-smoke 可獨立復算。去掉 --smoke 即為本文十六條完整範圍;輸出目錄需為新目錄,避免覆蓋原證據。公開包包含原始結果和審計記錄,不包含權重、虛擬環境或作者機器的私有路徑。
總結
這次實驗把“哪個頭最重要”改寫為可以複查的問題:在固定模型、候選答案和干預節點後,改變反事實配對,貢獻排序如何變化?穩健結論應同時交代保持的頭、變化的幅度與實驗邊界。排名是選擇後續干預的證據,尚不是機制解釋的終點。
參考資料
檢索與訪問日期:2026-10-18。以下均為一手資料;固定源碼的哈希與許可證見源碼地圖。
- Kevin Wang、Alexandre Variengien、Arthur Conmy、Buck Shlegeris、Jacob Steinhardt,2022 初版:Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small,v1。
- Fred Zhang、Neel Nanda,ICLR 2024:Towards Best Practices of Activation Patching in Language Models: Metrics and Methods,v2。
- TransformerLens:固定版本激活替換實現。
- Hugging Face Transformers:固定版本 GPT-2 前向。
- OpenAI / Hugging Face:GPT-2 固定模型卡。
- Redwood Research:IOI 公開模板固定源碼。