- 日期:2026-10-17
- 讀者:研究生、科研新人、工程型研究者
- 實驗範圍:真實 GPT-2 small,16 對公開模板構造的英語樣本,39,168 次單點干預;開發性定位,不代表完整基準。
摘要:恢復一部分,不等於解釋全部
上一篇確認了模型在固定名字與句式上存在間接賓語識別能力。這次追問:把正確運行中的一個內部向量移植到另一條運行裡,答案偏好能恢復多少?我們掃描全部層、頭與位置,末位置表現最強的注意力頭恢復了約 28.6% 的平均 logit 差距,但恢復後的平均偏好仍指向原題的干擾名字。這個結果提供了一個值得繼續檢查的組件,也留下了明顯的解釋缺口。
本文嚴格區分三層證據:論文報告的是完整研究中的機制解釋;本次實際驗證的是小範圍的激活幹預;作者推斷只用於提出下一步可反駁的假設。我們沒有訓練模型,也沒有通過刪掉其他組件來證明某個頭足以獨立完成任務。
復現價值:讓“相關”變成可以操縱的量
IOI 是間接賓語識別。以本次樣本為例,句子介紹 Christopher 和 Michael,接著說 Christopher 把戒指給了……,待續名字應是 Michael。注意力圖能顯示模型看向哪裡,卻不能直接告訴我們那條信息是否改變了答案。激活替換則在前向計算途中改動一處,比較最終輸出的變化。
Wang 等人的原論文結合路徑替換、消融和其他分析提出電路,並討論忠實性、完整性與最小性;本文只復現其中相關的定位思路,不把單點恢復排名等同於該電路。原論文
較上一篇,模型權重、詞元化器、模板和評分候選保持固定。新增變量只有干預節點及 clean/corrupt 條件;新增產物是逐樣本、逐層、逐頭、逐位置的原始候選分數。這裡的“真實”指真實預訓練模型及官方計算實現,語言材料仍是受控合成樣本。
核心思想:先把破壞說清楚
clean 表示原始輸入,corrupt 表示受控修改後的輸入。我們僅把第二次出現的 Christopher 換成 Michael。此時句子的正確接收者也隨之改變;它不是隨機亂碼,更不能把模型對新句子的正確反應稱為能力下降。
為衡量能否恢復原題偏好,兩個條件都用原題 Michael 減 Christopher 的分數。程序確認兩個名字各為一個帶前導空格的 token,改動恰好發生在一個 token,長度不變,解碼再編碼保持一致。評分身份不隨條件偷偷交換,否則兩個條件都可能得到高分,卻無法測量干預方向。
正式樣本在新推理前確定:從上一篇選前兩個相鄰名字對,配合兩模板、兩種初始名字順序和雙向角色交換,共十六條;實際只涉及三個重疊名字。它們共享結構,不能當作十六個獨立語言現象。留出的八個名字和另外兩模板繼續不用,也不把已看過的開發樣本重新命名為測試集。
公式與模塊:到底替換哪一塊
注意力頭先對 value 向量加權求和,得到頭輸出 ,再經輸出投影寫入殘差流。殘差流可理解為各模塊共同讀寫的中間表示。我們在投影前做替換:
其中 是層、 是 token 位置、 是頭,右側來自同一配對的 clean 運行;其他節點繼續按 corrupt 輸入計算。GPT-2 small 有十二層、每層十二個頭,每頭六十四維。單樣本緩存形狀是 , 為十五或十九;實現中投影前把後兩維展平成七百六十八維,因此必須按頭切分,不能把整個層輸出當作一個頭。
主指標沿用兩個候選的 logit 差。logit 是 softmax 之前的未歸一化分數:
這裡 表示樣本, 是末位置詞表分數,IO 和 S 始終指原始接收者與主語; 是這次干預增加的原題偏好。輔助恢復比例為:
橫線表示十六條樣本的算術平均,END 指各自最後一個輸入位置。我們先求平均再相除,預先要求分母大於零點一;沒有逐條除以可能接近零的差距,也沒有把負值或超過一的值裁掉。恢復比例不是概率,不能解釋成“這個頭承擔了百分之多少智能”。
官方代碼閱讀路線
先讀公開 IOI 數據腳本的名字、模板與順序轉換,再對照本篇樣本重建器。接著看 TransformerLens 的位置—頭替換函數:它只把指定切片換成 clean 緩存,輸出掃描軸是層、位置、頭。固定實現
最後進入 Transformers 的 GPT-2 注意力前向:各頭加權結果拼接後送入 c_proj。本篇在該模塊輸入處掛鉤,沿用官方前向計算,獨立移植替換操作;沒有安裝並運行整套 TransformerLens,也沒有聲稱兩套框架經過權重變換後逐位等價。源碼地圖記錄固定提交、具體行和 MIT/Apache 許可;已下載官方 GPT-2 文件並核對它與安裝文件字節一致。
最小實驗與評測協議
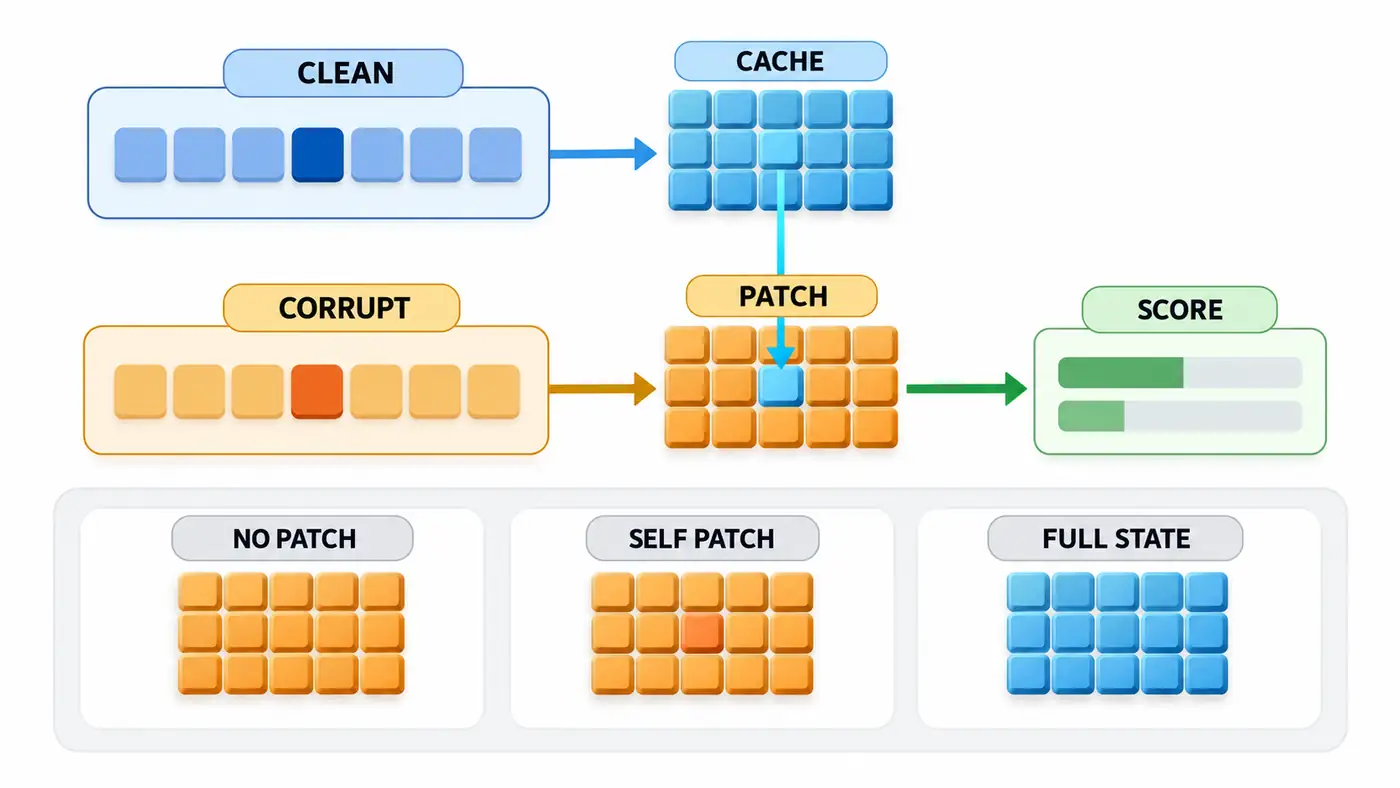
圖中藍色緩存只向橙色運行的一處節點傳值。下方三個方框是獨立對照,不是連續步驟;FULL STATE 實際替換整個嵌入後的殘差狀態,自身替換則使用各層的 corrupt 緩存。圖中的條形只是計分符號,不表示測量數值。
先運行一個樣本的完整掃描估算資源,再執行正式十六條。每次只換一個節點,全部網格都保留;預先規定主要展示末位置頭排名,按平均增益排序,平局按層和頭編號。批大小三十二的每一行代表一個獨立干預,最後不足的批補齊後丟棄多餘輸出;比較基線也使用同樣批形狀。
三項對照缺一不可。未替換的 clean/corrupt 給出真實分母;把整個嵌入後狀態換成 clean,應重建 clean 輸出;把各層頭輸出換回自身 corrupt 緩存,應保持 corrupt 輸出。後兩項均在十六條上得到完整詞表分數的精確相等。完整狀態正控證明運行鏈路能恢復,不證明“所有注意力頭就包含全部機制”。
正式運行使用 CPU、單精度、四線程和固定隨機種子。牆鍾耗時 190.646 秒,進程峰值內存 1,600,782,336 字節。單份 clean 激活緩存最大約 0.76 MB,但不能用它代替包含權重和運行時的進程內存。下載校驗、預處理、推理及評測狀態分別保存;沒有訓練或生成步驟。
本次實際驗證:最高的頭仍沒有恢復答案偏好
以下均來自保存結果,層和頭從零編號。乾淨與修改輸入的平均差分別為 4.295 和 −4.295,平均缺口為 8.591;原題候選偏好分別為十六條全正和全負。兩邊均值恰好反號來自本次對稱角色設計,不是干預方法自帶的性質。
| 末位置干預 | 平均增益 | 恢復比例 | 干預後平均差 |
|---|---|---|---|
| 第八層第十頭 | 2.455 | 28.6% | −1.841 |
| 第八層第六頭 | 2.215 | 25.8% | −2.080 |
| 第九層第九頭 | 1.859 | 21.6% | −2.437 |
| 第十層第七頭 | −3.841 | −44.7% | −8.136 |
前三個頭在每條樣本上都有正增益,但這不意味著每條都答對,更不意味著把比例相加便能得到聯合恢復。排名最高條件的原題答案平均絕對概率從 corrupt 的 0.0108 升到 0.0657,仍低於 clean 的 0.5177。我們沒有另按概率重新挑一個更好看的頭。
負結果同樣重要:有些 clean 頭輸出移植過去,反而增強了相反方向的偏好。這可能涉及下游交互或條件改變,目前不能據此給該頭貼上全局“有害”標籤。原始網格保存了全部效果,不只導出前幾名。
失敗排查:先排數值問題,再講機制
本次模型試跑和正式運行均成功,但通過不等於沒有誤差。為了節約掃描成本,程序只將最後位置送入官方輸出層;與完整模型調用的詞表分數最大差約零點零零零一九。批大小變化最大差約零點零零零二二。它們低於預先設定的零點零零一容差,記錄仍完整保留。
另一個檢查獨立使用“替換前後向量差乘輸出投影”的代數寫法,在預定節點對照輸入掛鉤版本,最大誤差約零點零零零零四六。因果掩碼提供了結構負控:改動詞元之前的位置看不到未來改動,移植效果應接近零,實際最大增益絕對值約零點零零零零六一。
這也解釋了為什麼不數所有嚴格小於零的效果來宣稱抑制機制:三萬九千多格里很多微小負值屬於數值尺度。低於負零點零零一的有三千一百四十二格,但這些格共享樣本和計算路徑,仍不是獨立發現的數量。獨立審計還核對唯一完整網格、候選身份、差值與排名,並用八種故意損壞證據確認檢查確實能報錯。
從定位結果到可檢驗的研究問題
作者推斷是:當前排名可能同時反映輸出端複製能力和本次角色交換製造的錯誤路徑。下一步凍結這份實現,只改變破壞方式,比較同一組頭的恢復效果與排序。如果排名穩定,才增加跨破壞條件的證據;如果變化明顯,就檢查替換改變了哪條信息通路。
另一種競爭解釋是某頭只攜帶適配當前名字的信號。留出名字和模板能區分更一般的角色機制與詞項依賴,但必須先凍結候選,不能看了留出結果再換頭。聯合替換是否出現補償或抵消,也需要真正運行組合實驗;本文沒有這些結果。當前沒有給相關樣本套獨立同分佈置信區間,更沒有把開發排名寫成顯著性結論。
源碼與復現入口
本篇已公開:固定提交源碼目錄、README 與運行說明、SOURCE_MAP 與官方實現對應。該版本四個入口均可匿名訪問,四十七個文件與本地歸檔逐項哈希一致;下載副本的完整審計、八項損壞測試與真實模型試跑均通過。
按 README 安裝鎖定依賴後,最小真實運行命令為:
TOKENIZERS_PARALLELISM=false python run.py --cache ./cache --smoke --out smoke-new
python audit.py --results smoke-new
首次會下載並校驗固定模型資源;已有正確緩存可以複用。預期得到逐樣本記錄、全部單點分數、彙總、環境與階段狀態。試跑覆蓋一條樣本的兩千一百六十個節點;去掉試跑參數才是本文十六條範圍。離線審計能復算已保存證據,但不替代模型前向。分發包包括所有自寫模塊、配置、來源對應和許可,不包含權重、憑據或作者機器的隱含路徑。
總結
激活替換把“哪個組件值得研究”轉化成可以重複的干預問題。本次找到了一組能部分恢復原題偏好的頭,也記錄了無法獨立恢復和方向相反的結果。當前可審查的結論止於這個模型、這套破壞和這些樣本;機制解釋還要繼續接受替代破壞、聯合消融及留出遷移的檢驗。
參考資料
檢索與源碼核驗日期:2026-10-17。
- Kevin Wang、Alexandre Variengien、Arthur Conmy、Buck Shlegeris、Jacob Steinhardt,2022:Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small,v1。
- Fred Zhang、Neel Nanda,2023 初版/2024 修訂,ICLR 2024:Towards Best Practices of Activation Patching in Language Models: Metrics and Methods,v2。該文研究指標與破壞選擇對定位結論的影響,支持本文繼續檢驗協議敏感性的動機。
- TransformerLens:Exploratory Analysis Demo;具體移植依據以本文源碼地圖中的固定提交為準。
- Redwood Research:固定 IOI 數據構造源碼。
- Hugging Face:固定 GPT-2 模型卡,以及 Transformers 4.49 對應 GPT-2 源碼。