- 日期:2026-10-17
- 读者:研究生、科研新人、工程型研究者
- 实验范围:真实 GPT-2 small,16 对公开模板构造的英语样本,39,168 次单点干预;开发性定位,不代表完整基准。
摘要:恢复一部分,不等于解释全部
上一篇确认了模型在固定名字与句式上存在间接宾语识别能力。这次追问:把正确运行中的一个内部向量移植到另一条运行里,答案偏好能恢复多少?我们扫描全部层、头与位置,末位置表现最强的注意力头恢复了约 28.6% 的平均 logit 差距,但恢复后的平均偏好仍指向原题的干扰名字。这个结果提供了一个值得继续检查的组件,也留下了明显的解释缺口。
本文严格区分三层证据:论文报告的是完整研究中的机制解释;本次实际验证的是小范围的激活干预;作者推断只用于提出下一步可反驳的假设。我们没有训练模型,也没有通过删掉其他组件来证明某个头足以独立完成任务。
复现价值:让“相关”变成可以操纵的量
IOI 是间接宾语识别。以本次样本为例,句子介绍 Christopher 和 Michael,接着说 Christopher 把戒指给了……,待续名字应是 Michael。注意力图能显示模型看向哪里,却不能直接告诉我们那条信息是否改变了答案。激活替换则在前向计算途中改动一处,比较最终输出的变化。
Wang 等人的原论文结合路径替换、消融和其他分析提出电路,并讨论忠实性、完整性与最小性;本文只复现其中相关的定位思路,不把单点恢复排名等同于该电路。原论文
较上一篇,模型权重、词元化器、模板和评分候选保持固定。新增变量只有干预节点及 clean/corrupt 条件;新增产物是逐样本、逐层、逐头、逐位置的原始候选分数。这里的“真实”指真实预训练模型及官方计算实现,语言材料仍是受控合成样本。
核心思想:先把破坏说清楚
clean 表示原始输入,corrupt 表示受控修改后的输入。我们仅把第二次出现的 Christopher 换成 Michael。此时句子的正确接收者也随之改变;它不是随机乱码,更不能把模型对新句子的正确反应称为能力下降。
为衡量能否恢复原题偏好,两个条件都用原题 Michael 减 Christopher 的分数。程序确认两个名字各为一个带前导空格的 token,改动恰好发生在一个 token,长度不变,解码再编码保持一致。评分身份不随条件偷偷交换,否则两个条件都可能得到高分,却无法测量干预方向。
正式样本在新推理前确定:从上一篇选前两个相邻名字对,配合两模板、两种初始名字顺序和双向角色交换,共十六条;实际只涉及三个重叠名字。它们共享结构,不能当作十六个独立语言现象。留出的八个名字和另外两模板继续不用,也不把已看过的开发样本重新命名为测试集。
公式与模块:到底替换哪一块
注意力头先对 value 向量加权求和,得到头输出 ,再经输出投影写入残差流。残差流可理解为各模块共同读写的中间表示。我们在投影前做替换:
其中 是层、 是 token 位置、 是头,右侧来自同一配对的 clean 运行;其他节点继续按 corrupt 输入计算。GPT-2 small 有十二层、每层十二个头,每头六十四维。单样本缓存形状是 , 为十五或十九;实现中投影前把后两维展平成七百六十八维,因此必须按头切分,不能把整个层输出当作一个头。
主指标沿用两个候选的 logit 差。logit 是 softmax 之前的未归一化分数:
这里 表示样本, 是末位置词表分数,IO 和 S 始终指原始接收者与主语; 是这次干预增加的原题偏好。辅助恢复比例为:
横线表示十六条样本的算术平均,END 指各自最后一个输入位置。我们先求平均再相除,预先要求分母大于零点一;没有逐条除以可能接近零的差距,也没有把负值或超过一的值裁掉。恢复比例不是概率,不能解释成“这个头承担了百分之多少智能”。
官方代码阅读路线
先读公开 IOI 数据脚本的名字、模板与顺序转换,再对照本篇样本重建器。接着看 TransformerLens 的位置—头替换函数:它只把指定切片换成 clean 缓存,输出扫描轴是层、位置、头。固定实现
最后进入 Transformers 的 GPT-2 注意力前向:各头加权结果拼接后送入 c_proj。本篇在该模块输入处挂钩,沿用官方前向计算,独立移植替换操作;没有安装并运行整套 TransformerLens,也没有声称两套框架经过权重变换后逐位等价。源码地图记录固定提交、具体行和 MIT/Apache 许可;已下载官方 GPT-2 文件并核对它与安装文件字节一致。
最小实验与评测协议
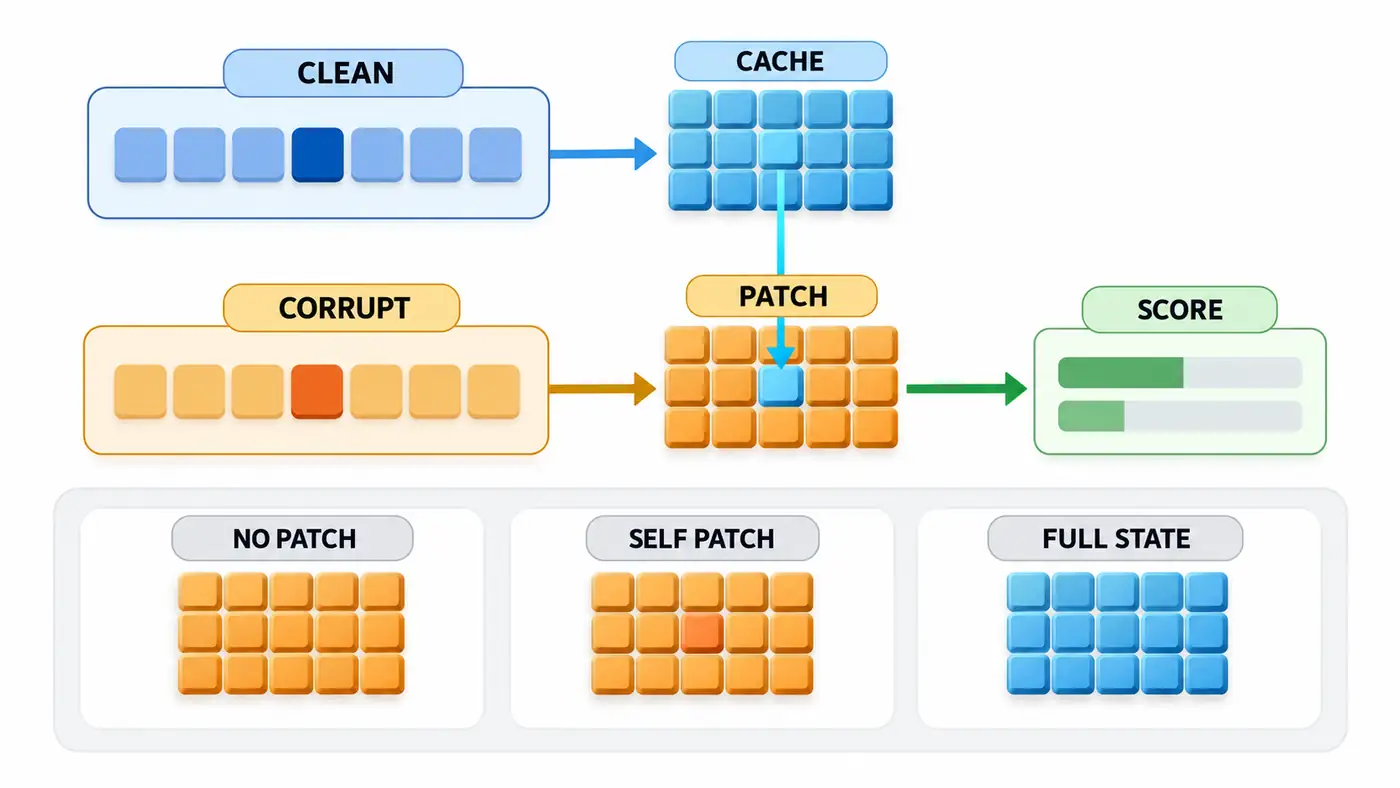
图中蓝色缓存只向橙色运行的一处节点传值。下方三个方框是独立对照,不是连续步骤;FULL STATE 实际替换整个嵌入后的残差状态,自身替换则使用各层的 corrupt 缓存。图中的条形只是计分符号,不表示测量数值。
先运行一个样本的完整扫描估算资源,再执行正式十六条。每次只换一个节点,全部网格都保留;预先规定主要展示末位置头排名,按平均增益排序,平局按层和头编号。批大小三十二的每一行代表一个独立干预,最后不足的批补齐后丢弃多余输出;比较基线也使用同样批形状。
三项对照缺一不可。未替换的 clean/corrupt 给出真实分母;把整个嵌入后状态换成 clean,应重建 clean 输出;把各层头输出换回自身 corrupt 缓存,应保持 corrupt 输出。后两项均在十六条上得到完整词表分数的精确相等。完整状态正控证明运行链路能恢复,不证明“所有注意力头就包含全部机制”。
正式运行使用 CPU、单精度、四线程和固定随机种子。墙钟耗时 190.646 秒,进程峰值内存 1,600,782,336 字节。单份 clean 激活缓存最大约 0.76 MB,但不能用它代替包含权重和运行时的进程内存。下载校验、预处理、推理及评测状态分别保存;没有训练或生成步骤。
本次实际验证:最高的头仍没有恢复答案偏好
以下均来自保存结果,层和头从零编号。干净与修改输入的平均差分别为 4.295 和 −4.295,平均缺口为 8.591;原题候选偏好分别为十六条全正和全负。两边均值恰好反号来自本次对称角色设计,不是干预方法自带的性质。
| 末位置干预 | 平均增益 | 恢复比例 | 干预后平均差 |
|---|---|---|---|
| 第八层第十头 | 2.455 | 28.6% | −1.841 |
| 第八层第六头 | 2.215 | 25.8% | −2.080 |
| 第九层第九头 | 1.859 | 21.6% | −2.437 |
| 第十层第七头 | −3.841 | −44.7% | −8.136 |
前三个头在每条样本上都有正增益,但这不意味着每条都答对,更不意味着把比例相加便能得到联合恢复。排名最高条件的原题答案平均绝对概率从 corrupt 的 0.0108 升到 0.0657,仍低于 clean 的 0.5177。我们没有另按概率重新挑一个更好看的头。
负结果同样重要:有些 clean 头输出移植过去,反而增强了相反方向的偏好。这可能涉及下游交互或条件改变,目前不能据此给该头贴上全局“有害”标签。原始网格保存了全部效果,不只导出前几名。
失败排查:先排数值问题,再讲机制
本次模型试跑和正式运行均成功,但通过不等于没有误差。为了节约扫描成本,程序只将最后位置送入官方输出层;与完整模型调用的词表分数最大差约零点零零零一九。批大小变化最大差约零点零零零二二。它们低于预先设定的零点零零一容差,记录仍完整保留。
另一个检查独立使用“替换前后向量差乘输出投影”的代数写法,在预定节点对照输入挂钩版本,最大误差约零点零零零零四六。因果掩码提供了结构负控:改动词元之前的位置看不到未来改动,移植效果应接近零,实际最大增益绝对值约零点零零零零六一。
这也解释了为什么不数所有严格小于零的效果来宣称抑制机制:三万九千多格里很多微小负值属于数值尺度。低于负零点零零一的有三千一百四十二格,但这些格共享样本和计算路径,仍不是独立发现的数量。独立审计还核对唯一完整网格、候选身份、差值与排名,并用八种故意损坏证据确认检查确实能报错。
从定位结果到可检验的研究问题
作者推断是:当前排名可能同时反映输出端复制能力和本次角色交换制造的错误路径。下一步冻结这份实现,只改变破坏方式,比较同一组头的恢复效果与排序。如果排名稳定,才增加跨破坏条件的证据;如果变化明显,就检查替换改变了哪条信息通路。
另一种竞争解释是某头只携带适配当前名字的信号。留出名字和模板能区分更一般的角色机制与词项依赖,但必须先冻结候选,不能看了留出结果再换头。联合替换是否出现补偿或抵消,也需要真正运行组合实验;本文没有这些结果。当前没有给相关样本套独立同分布置信区间,更没有把开发排名写成显著性结论。
源码与复现入口
本篇已公开:固定提交源码目录、README 与运行说明、SOURCE_MAP 与官方实现对应。该版本四个入口均可匿名访问,四十七个文件与本地归档逐项哈希一致;下载副本的完整审计、八项损坏测试与真实模型试跑均通过。
按 README 安装锁定依赖后,最小真实运行命令为:
TOKENIZERS_PARALLELISM=false python run.py --cache ./cache --smoke --out smoke-new
python audit.py --results smoke-new
首次会下载并校验固定模型资源;已有正确缓存可以复用。预期得到逐样本记录、全部单点分数、汇总、环境与阶段状态。试跑覆盖一条样本的两千一百六十个节点;去掉试跑参数才是本文十六条范围。离线审计能复算已保存证据,但不替代模型前向。分发包包括所有自写模块、配置、来源对应和许可,不包含权重、凭据或作者机器的隐含路径。
总结
激活替换把“哪个组件值得研究”转化成可以重复的干预问题。本次找到了一组能部分恢复原题偏好的头,也记录了无法独立恢复和方向相反的结果。当前可审查的结论止于这个模型、这套破坏和这些样本;机制解释还要继续接受替代破坏、联合消融及留出迁移的检验。
参考资料
检索与源码核验日期:2026-10-17。
- Kevin Wang、Alexandre Variengien、Arthur Conmy、Buck Shlegeris、Jacob Steinhardt,2022:Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small,v1。
- Fred Zhang、Neel Nanda,2023 初版/2024 修订,ICLR 2024:Towards Best Practices of Activation Patching in Language Models: Metrics and Methods,v2。该文研究指标与破坏选择对定位结论的影响,支持本文继续检验协议敏感性的动机。
- TransformerLens:Exploratory Analysis Demo;具体移植依据以本文源码地图中的固定提交为准。
- Redwood Research:固定 IOI 数据构造源码。
- Hugging Face:固定 GPT-2 模型卡,以及 Transformers 4.49 对应 GPT-2 源码。