- 日期:2026-10-20
- 读者:研究生、科研新人和工程型研究者
- 范围:真实 GPT-2 small,公开 IOI 模板构造的合成材料;四组各六十四条,不代表自然语言完整基准。
摘要:方向迁移了,强度却没有照搬
上一实验比较了清零、均值和重采样消融,说明“删掉几个头后分数下降”不能直接证明找到了完整电路。今天增加一个约束:不再寻找更好的头,带着同一组组件走进预留的名字与模板。
本次实际验证中,三个头的联合干预在所有样本上保持同方向:清零降低正确名字相对干扰名字的分数,替换激活则提高该分数。然而,双重迁移的平均消融下降量从原组的 2.387 缩至 1.360,完整模型首选答案正确数从 64 降至 53。恢复比例都约六成,却遮住了不同的原始信号强度。本文复现的是组件集合的局部迁移证据,不把它命名为已验证的完整电路。
一、复现价值:先把“换了还有效”写成能失败的问题
间接宾语识别,简称 IOI,要求模型在句尾预测接收物品的人。例如两个人进入商店,其中一人把戒指送给另一人;候选包括接收者 IO 和赠送者 S。这里观察的是下一个词元,词元即分词器送入模型的离散单位,不执行自由续写。
Wang 等人的原论文用因果干预研究 GPT-2 的 IOI 行为,并以忠实性、完整性、最小性检验解释。论文报告支持研究这种任务的价值,但并不替本次三头实验背书。本文也没有把论文中的组件名单整体移植过来。
本次集合沿用开发阶段排名:零起始编号的 L8H10、L8H6、L9H9,即层号与头号。它们在已有十六条开发材料上被选择,上一实验已使用过;迁移时头号、联合操作和句尾位置全部冻结。预先假设是:三个迁移组的平均消融下降量与恢复增量均为正。强度相同属于更强命题,本次没有为它预设等效界限。
二、实验设计:四组材料回答两个变化维度
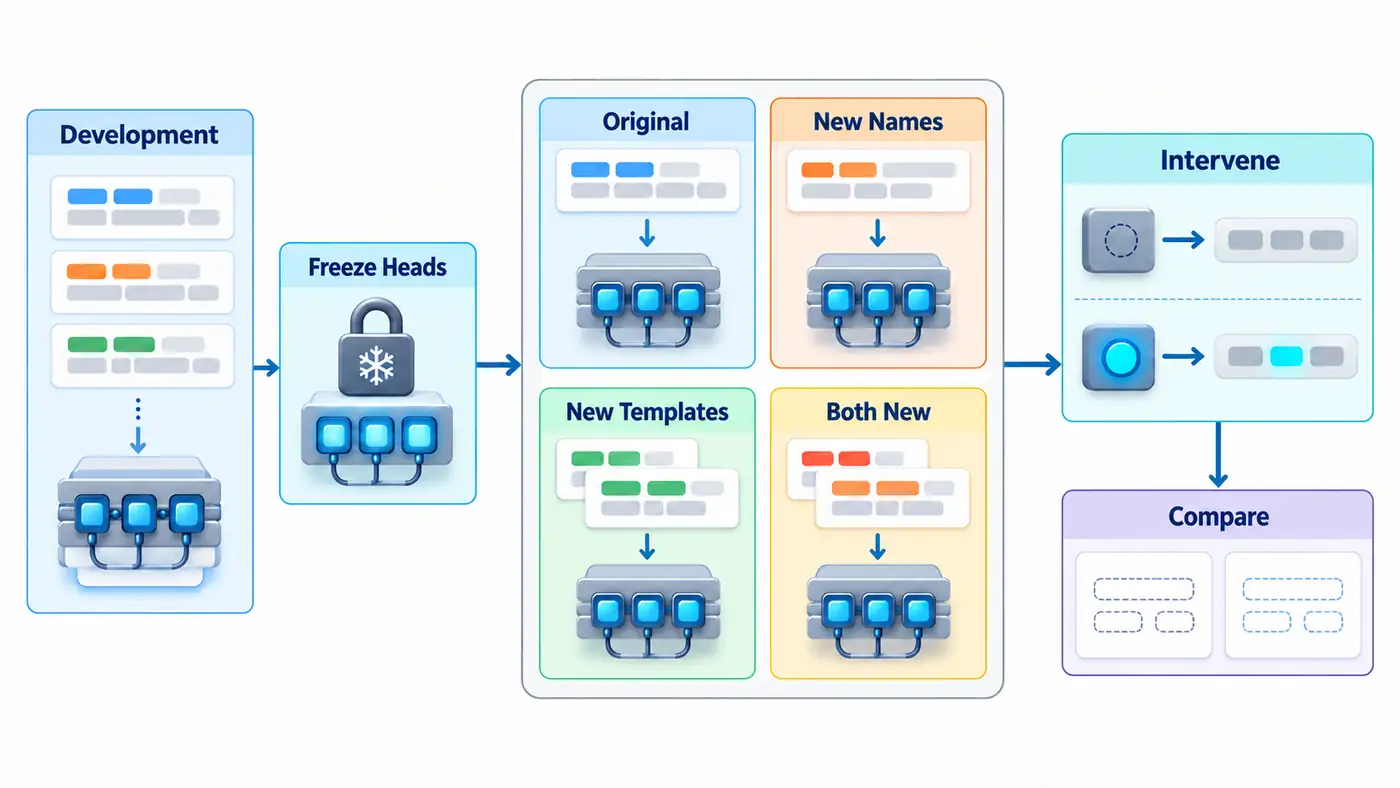
原名字取官方列表前八个,留出名字取紧接着的八个;原模板为索引零、一,新模板为二、三。这些留出材料在行为基线阶段已登记,本次冻结方案之后才做首次推理。“新名字”仅指未用于本项目组件选择,不能声称预训练模型没有见过这些人名。
每组由八个循环相邻名字对、两种角色方向、两种首次提及顺序和两个模板组成,共六十四条。地点与物品固定为商店与戒指。所有名字都验证为带前导空格的单词元;四组组合索引一一对应,便于逐项比较。这里的配对是设计位置相同,不意味着不同人名具有完全一致的语言属性。两组未匹配名字的词频或性别关联,也没有测量它们在预训练语料中的出现率。因此,“换名字效应”只能指这两份冻结名单之间的差异,不能进一步归因于某一种名字属性。
原组复用了此前六十四条行为材料,其中十六条参与过组件选择,因此它是开发参照。其余一百九十二条才是本次预留迁移材料。循环名字对彼此重叠,同一模板又重复使用,不能把这些行当作独立抽取的自然句子。本次只给描述性差值,不画看似精确的逐行自助法置信区间。
新模板包含“正在工作”“想去某地”,同时改变后续动词表达和长度。它们保持公开 IOI 构造,却不是仅替换一个语法成分的严格最小对照。只换名字、只换模板、同时改变三组,可以分开定位变化来源;仍不能从中得出纯句法的因果效应。
三、核心公式与干预:恢复比例必须带着分母看
先定义候选分数差:
是不含答案的输入前缀, 是模型最后位置的未归一化输出分数,即 logit。 仅表示两个名字之间更偏好 IO,不保证 IO 在整个词表中排名第一。因此还记录全词表首选答案和 IO 概率。
主要指标为联合清零下降量:
表示一个实验组,, 是三个选定头在句尾的输出激活同时清零后的分数差。模型权重没有删除;所有后续计算照常进行。数值越大,表示这种清零操作对该组的分数影响越大,不等于解释覆盖率。
恢复实验把最后一次出现的主语换成原 IO,得到反事实前缀 ;仍按原 IO 与原 S 计分。再将对应干净输入中三个头的句尾激活放入反事实运行,得到 。定义:
横线是组内均值; 是原始恢复增量, 是均值之比,不是逐行比例的平均。若平均分母绝对值不超过百万分之一,脚本返回空值而不硬除。负效果与超过一的值也不裁剪。Zhang 与 Nanda研究了指标及破坏方式对定位结果的影响,因此本文同时保留原始增量与分母。
迁移的是组件位置和操作规则,每条新句子仍需要自己的干净激活。这没有证明一个固定向量可以跨句通用,也没有把三头同时替换称作逐边路径修补。
四、官方代码阅读路线与最小运行
先读官方 ioi_dataset.py 的名字、模板与首次提及换序,再看 ioi_utils.py 的候选差值;最后追到 Transformers 的注意力输出投影 c_proj。源码地图给出了固定提交、具体行号及许可证,避免读者面对不断变化的主分支。
投影前激活可解释为形状 :批量一、长度 、十二个头、每头六十四维。官方实际传入投影的是拼接后的 ,本地钩子只改最后位置的三个切片。模板长度变化时,句尾由实际前缀长度定位,不能沿用旧整数位置。
本次使用官方完整语言模型前向,输出形状为 ,不再以单独最后位置矩阵乘法替代读出。每行另用投影后的增量实现交叉检查,验证两种干预表达在浮点容差内一致。没有安装或运行 TransformerLens,也没有把不同框架的转换权重混进来。
模型和分词器固定在 607a30d783dfa663caf39e06633721c8d4cfcd7e,模板固定在 ea15315dd24481e9e2ac5c3ef335d82907a1dc34。八个资源文件逐一核对哈希;复用已有缓存,不把重新下载当作实验进度。CPU、单精度、四线程、批量一,关闭训练、生成与截断。
五、本次结果:同方向不等于同等解释力
下表全部来自保存的真实模型日志;原组为开发参照,其他组为冻结后的迁移测量。表中下降量与增量的单位都是 logit 差。
| 条件,每组六十四条 | 干净均值 | 干净首选正确 | 清零下降量 | 恢复增量 | 恢复比例 |
|---|---|---|---|---|---|
| 原名字、原模板 | 4.446 | 64/64 | 2.387 | 5.387 | 60.59% |
| 新名字、原模板 | 2.947 | 64/64 | 1.720 | 3.834 | 65.04% |
| 原名字、新模板 | 3.877 | 56/64 | 1.947 | 4.207 | 54.24% |
| 新名字、新模板 | 2.479 | 53/64 | 1.360 | 2.997 | 60.43% |
所有二百五十六条的清零下降量与恢复增量都为正,预设的方向假设得到本组材料支持。但双重迁移的下降量比原组少 1.027,恢复增量少 2.391。恢复比例接近,是因为平均干净—反事实间距也从 8.892 缩至 4.959;不能只摘取约六成就声称机制强度不变。
恢复后全词表首选正确数依次是 46、47、23、26。尤其在原名字配新模板时,恢复后两候选差为正的有四十条,真正首选 IO 的却只有二十三条。两个名字间的局部改善,离完整词表的答案恢复还有距离。
本次正式运行约六十二秒,进程峰值内存约一点四六六 GB,详细字节值与环境存于运行记录;未单独测量显存或能耗。共记录一千零二十四个评分条件,另有一千二百八十次实现控制前向。模板前缀长度为十五、十九、十八、二十,计算量差异如实保留,没有裁短新模板来伪造等成本。
六、失败排查:从具体反例回到测量定义
样本一百三十六中,Jennifer 打算把戒指给 Ashley;模型对 Ashley 相对 Jennifer 的差为正,词表第一却是代词“her”。这属于本协议的名字精确首选失败,不宜解释成模型完全不理解接收者。其他失败还出现“the”,提示开放词表竞争与两候选判断不是同一任务。
双重迁移的样本二百四十二则更直接:David 与 James 的前缀中,候选差为负零点四四零。本文没有剔除它后再报告恢复率,也没有据此回到留出集重新挑头。单个失败只能揭示边界,不能证明某种人名属性就是原因。
实现层先查答案拼接的分词边界,再查主语出现次数、唯一替换位置、句尾索引及钩子范围。空钩子和两种自替换全词表误差均为零;投影两种实现最大误差约万分之一。独立脚本复算全部算术,并拒绝七类故意破坏的数据。另一实现重放全部评分条件,首选词元全部一致;候选分数与概率存在微小浮点差异,记录中没有把它说成逐位相同。
七、研究问题:下一次需要怎样的反证
作者推断是:这组头承载的局部作用可以跨本次材料保持方向,但强度和完整答案恢复仍依赖输入分布。它尚未排除清零造成的分布外扰动;上一篇已显示替换基线重要,今天没有重新运行所有均值与重采样条件。
一个可检验后续问题是:在另行登记的材料上,用长度更匹配的模板与预先固定的替换基线,原始恢复增量是否仍随干净分数一起缩小?竞争解释包括完整模型本身信号变弱,以及选定组件对新表达的相对作用改变。需要新增受控证据区分,不能由当前四个均值替代机制结论。
这些留出名字和模板现已被使用,不能在后续文章重新称为未见确认集。下一步评估保留组件与完整模型之间的剩余误差时,也必须承认今天看到过的失败。完整性要求的是更强的排除证据,正向迁移不是终点。
源码与复现入口
本篇已公开:固定版本源码目录、运行说明 README、官方实现对应表 SOURCE_MAP。四十八个分发文件已匿名下载并与本地逐项核对;公开副本也通过真实试跑。安装锁定依赖后,最小命令为:
python run.py --cache ./cache --out smoke-new --smoke
它运行原组一条真实样本的四条件与控制检查,产出逐行记录、汇总、阶段状态和资源日志。去掉 --smoke 并使用新输出目录可运行全部二百五十六条;python audit.py results 可离线审计归档结果。依赖、下载器、独立复算、固定上游映射与许可证完整提供,模型大文件由固定版本下载,不随源码分发。
总结
迁移实验最有价值的地方,是让一项解释面对它没有参与选择的材料。本次证据支持三个固定头的局部干预方向迁移,同时留下强度缩小、词表竞争与恢复不足。把这些现象并列保存,比仅展示稳定百分比更接近可检验的科研问题。
参考资料
检索与固定源码访问日期:2026-10-20。
- Kevin Wang、Alexandre Variengien、Arthur Conmy、Buck Shlegeris、Jacob Steinhardt:Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small,2022,所读版本 v1。
- Fred Zhang、Neel Nanda:Towards Best Practices of Activation Patching in Language Models: Metrics and Methods,ICLR 2024,v2。
- 作者官方仓库:固定模板与名字实现、候选分数实现。
- Hugging Face Transformers:固定 GPT-2 实现,4.49.0。
- OpenAI / Hugging Face:GPT-2 固定模型卡。