- 日期:2026-10-18
- 读者:研究生、科研新人和工程型研究者
- 范围:真实 GPT-2 small,公开 IOI 模板构造的十六条开发样本,两种姓名反事实;不是自然语料或完整论文基准。
摘要:最重要的头,取决于问了什么
上一篇把干净输入的注意力头激活放回被改写的输入,发现末位置的 L8H10 平均恢复效果最大。这里的层和头均从零编号。这个结果还缺一项检查:如果用另一种方式改变句子,排名是否保持?本篇冻结模型、样本、干预和计分,只改姓名替换规则,重新跑完整网格。本次实际验证:前十名有九个相同,全部头的秩相关为 0.857,但第一名从 L8H10 变成 L9H9;L8H10 的平均恢复比例从 28.6% 降到 12.5%。这是一项局部稳定性实验,不能把名次相同当成完整电路,也不能把换位直接叫作解释失效。
一、复现价值:先明确反事实的语义
间接宾语识别(IOI)要求模型根据前文判断东西交给谁。例如“Michael 和 Christopher 去商店,Christopher 把戒指交给……”,预期续写 Michael。记收礼人为 IO,重复出现的主语为 S。所谓 corruption,本文指有规则地改写输入,形成与原句不同的任务;它并不等于往模型里随意加噪声。
我们保留两个反事实。S2 Flip 只把第二次出现的 S 改成 IO;Global Swap 同时交换句中所有 IO 和 S。前者改变最后一次行动者,后者一致地交换人物身份。两种改写后的收礼人都是原 S,因此模型更偏向原 S 可以是正确理解了新句子。全文始终计算原 IO 相对原 S 的分数,避免换过答案再误称恢复成功。
| 设置 | 原句姓名序列的一个例子 | 改写后序列 | 改动词元数 |
|---|---|---|---|
| 干净输入 | IO、S、S | 不变 | 0 |
| S2 Flip | IO、S、S | IO、S、IO | 1 |
| Global Swap | IO、S、S | S、IO、IO | 3 |
这里的姓名都能编码为含前导空格的单个词元。两种输入长度、姓名频次与非姓名词元相同,却改变了不同位置。不能将差异只归因于“改动数量”:首次提及顺序与替换位置也随之变化。
二、论文给出动机,本实验限定问题
论文报告:Wang 等人的 IOI 工作在 GPT-2 small 中结合多种干预研究组件,并用忠实性、完整性和最小性评价解释[1]。Zhang 与 Nanda 比较了激活替换中的破坏方法和计分方式,报告这些方法选择可能改变定位结果[2]。后者区分高斯噪声与语义相关的词元替换,并讨论替换哪些词元的重要性。
本文只比较两种离散姓名反事实,没有重做其高斯噪声实验。我们也没有运行 TransformerLens 的整套模型转换:实际前向来自官方 Transformers,替换切片的约定参考 TransformerLens 固定源码[3][4]。这一区别使实现、论文结论和作者解释各有明确边界。
一个额外的设计约束是平衡性。十六条材料覆盖两模板、两提及顺序、两个相邻姓名对及两种角色方向,仅涉及三个重叠姓名。在完整材料中,每种改写后的句子多重集合都等于干净句子的多重集合,只是与原句的配对关系改变。于是总体基线难度得到控制,但单条输入的信息路径并未相同。这个性质由词元序列逐项核对,不靠事后挑选分数相近的样本。
三、核心思想、公式与模块
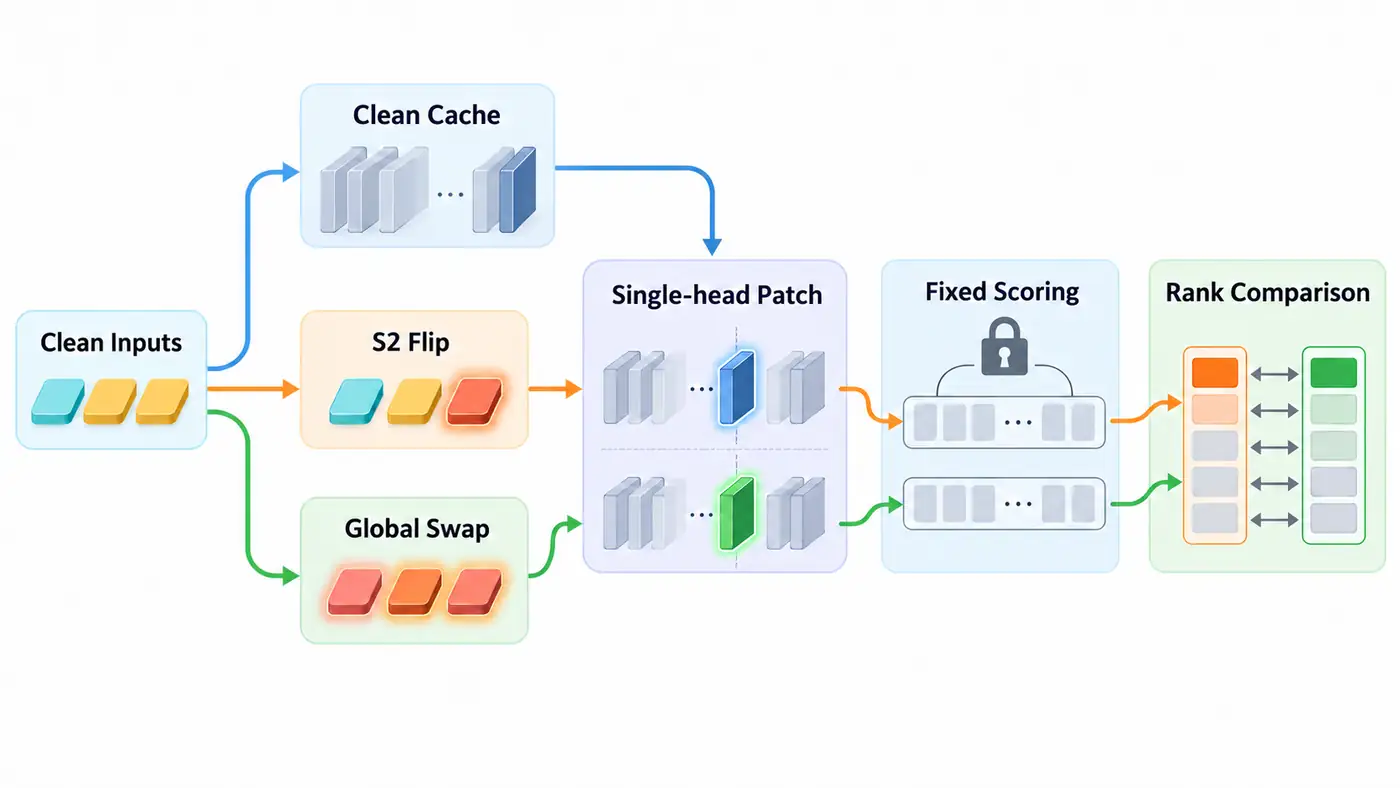
图中词元采用原 IO、S、S 的示例顺序;暖色突出被改动位置,不编码人物身份。两条路径共享干净来源、节点定义与原候选答案,排名结果不会反馈到本次选择规则。
先定义候选 logit 差。logit 是归一化为概率之前的模型输出:
其中 是样本, 是破坏条件, 在主排名中指末位置的一个层—头组合; 为原候选的输出分数, 是干预相对相同破坏基线的增量。正值表示偏好向原答案移动,不保证已经恢复正确预测。
主指标按十六条取平均,辅助报告恢复比例:
。分母是平均干净—破坏间距,必须大于预定阈值;不把每题比值再平均,也不把负值裁成零。同一条件下分母相同,因此两种指标给出相同的头排名,不能把它们当成独立支持证据。
干预对象是注意力加权值向量 ,位于输出投影之前。缓存形状为 ,查看为 :批次、序列位置、十二个头、每头六十四维。一次只替换一个层、位置、头的向量,再让后续网络正常计算。它不同于直接修改注意力权重,也没有一次替换多个头。
四、官方代码阅读路线
先读模型卡和资源锁,确认 GPT-2 与分词器共用固定 revision[5]。再看官方 GPT2Attention 中加权值输出的合并与 c_proj,确定钩子插在正确边界;最后对照 TransformerLens 的 layer_pos_head_vector_patch_setter,核实位置和头维的含义。具体提交、行号、许可证及本地映射均在源码地图。
本地 run.py 的前向、缓存、单点替换及对照沿用上一篇;新增部分仅为反事实构造、条件循环和日志标记。analyze.py 聚合排名,audit.py 独立复算,后者不导入实验与聚合脚本。公开模板由 rebuild_samples.py 获取固定源码并解析常量重建[6],不执行整个上游仓库。所需自写模块全部随本篇分发。
五、最小实验与评测协议
模型和分词器固定在 607a30d783dfa663caf39e06633721c8d4cfcd7e;模板固定在 ea15315dd24481e9e2ac5c3ef335d82907a1dc34。配置沿用种子 101、CPU float32、eager 注意力、四线程、干预批次三十二。没有训练、生成、截断、额外起始词元或留出集推理。
正式执行前保存协议与脚本哈希。先跑一条材料的两条件完整网格估计资源,再运行全部十六条。每个条件扫描十二层、十二头及全部十五或十九个位置,合计 78,336 次单点替换。末位置 END 是上一篇已规定的主排名位置,其余位置全部留档,没有看完热图再选亮点。实际资源为 正式进程墙钟 396.294 秒、峰值常驻内存 1,607,516,160 字节;导入后计时 395.671 秒,系统为 macOS、Python 3.12.14、PyTorch 2.6.0、Transformers 4.49.0;未测能耗或独立显存峰值。
主比较事先固定为全部一百四十四个 END 头的秩相关、前十名重合度以及上一实验获胜头 L8H10 的配对变化。重合度是交集大小除以十,Jaccard 则除以并集大小。排序按平均增量降序,精确相等时按层和头编号确定次序。我们同时检查近邻分差,避免把接近数值误差的名次变化夸大。样本共享模板与姓名,不能按十六个独立自然样本画置信区间。
六、结果:同时看稳定部分与改变部分
两条件的平均干净分差均为 4.295,破坏分差均为 −4.295,平均间距均为 8.591。单词元条件复现上一篇的一百四十四个 END 头排名及增量。以下是同一节点在两条件下的真实值:
| END 节点 | 单词元增量/排名 | 全姓名交换增量/排名 |
|---|---|---|
| L8H10 | 2.455/1 | 1.078/3 |
| L8H6 | 2.215/2 | 0.113/11 |
| L9H9 | 1.859/3 | 1.992/1 |
| L10H0 | 1.332/5 | 1.364/2 |
| L10H7 | −3.841/144 | −3.782/144 |
前十名重合度为 90%,Jaccard 为 0.818;L8H6 退出前十,L10H2 进入。总体排序有相当部分保持,但“唯一最重要头”的表述不成立。上一实验预定关注的 L8H10 在十五条材料上增量下降、一条上升,平均配对变化为 −1.377。例外是样本 2,从 2.363 升到 2.735,说明平均下降不能替代逐例说明。即使分别使用各条件最强的单头,干预后平均分差仍为负,并没有恢复完整行为。
两条件均无精确并列,但一百四十三对相邻名次中,分别有一百零二对和一百零七对的增量间隔小于 0.001。前十与第十一名的边界间隔分别为 0.00355 和 0.10615,不能将这个边界描述成统计显著。最大换位的 L8H3 从第十四降到第一百三十八,原始增量却只是 0.079 到 −0.035。名次移动一百多位,不等于出现同等量级的行为损失。
负效果也构成证据。全位置网格中,增量小于 −0.001 的节点数分别为 3,142 和 6,964;这包含不同层与位置,不是相互独立的失败次数。L10H7 在两条件下均排最后,干净激活写入当前破坏上下文会进一步偏向原干扰答案。现阶段只能报告这种条件性作用,不能直接给它贴上普遍“有害组件”的标签。
一个常见误读是把全局秩相关当成“解释可信度百分比”。这里的一百四十四个头包含许多近零效果,次序可能对微小变化敏感。因此报告既保留总体排序,也展示主要头的原始增量、前十边界间隔与逐条配对结果。阈值附近的换位和显著幅度的改变应分别理解。
七、失败排查与独立验收
替换实验先验证实现,再解释热图。整段嵌入后状态换成干净状态,应恢复干净前向;把破坏缓存写回其自身,应完全不变。我们还用输出投影后的线性增量重做预先指定节点,与投影前替换对照,并核对完整官方模型与只读最后位置的实现。真正修改位置之前的节点应只有容许范围内的数值差。
本次完整状态正控与自身回写误差均为零。官方完整前向核对最大误差为 0.000191,独立投影增量核对为 0.0000534,批次形状差异为 0.000221;修改位置之前的干预增量最大约 0.0000610,均小于预定 0.001 容差。该容差是实现核验门槛,不是对真实效应的置信区间。
独立脚本重算原候选差值、完整网格唯一性、均值、排名、恢复比例及多重集合;秩相关另用序号向量的 Pearson 公式计算。十一项损坏测试故意改候选、改位置、漏节点、重复节点或伪造排名与重合度,均应被拒绝。自动算术复算没有被称为真人语义金标。源码联网初次受沙箱限制,后续匿名固定版本读取成功,未改变实验协议或模型资产。
八、研究问题与边界
作者推断:若相同干净来源在不同反事实路径下产生不同效果,组件贡献可能依赖下游上下文。这是待进一步区分的解释,当前排名还无法判断具体是哪条信息通路变化。这里同时改了姓名位置与提及顺序,没有独立操纵其中一个因素;也没有证明两种路径在任意自然文本上等价。
可检验的后续问题是:固定本次开发集选出的头,联合消融的损失是否等于各头单独损失之和?若不等,可能存在交互或补偿,需要不同消融基线区分。之后才在预留名字、模板上测试迁移。不能在迁移失败后重新挑头,再把同一批数据称为确认集。本次仍是开发阶段证据,重复样本、有限模板与潜在预训练接触都限制外推。
源码与复现入口
已公开并核验的固定版本:完整源码目录、README 与运行步骤、SOURCE_MAP 官方实现映射。49 个文件与本地归档逐项一致;公开副本已通过独立审计和一条样本双条件、4,320 次替换的真实试跑。本文正式结果为十六条双条件完整扫描。
在按 README 安装锁定依赖后,最小真实运行命令为:
python run.py --cache ./cache --out replay-smoke --smoke
首次执行按固定 revision 下载并核验约五百五十兆字节模型资源;已核验缓存可复用。输出逐条件样本、全部干预分数、汇总、阶段状态与运行环境。python audit.py --results replay-smoke 可独立复算。去掉 --smoke 即为本文十六条完整范围;输出目录需为新目录,避免覆盖原证据。公开包包含原始结果和审计记录,不包含权重、虚拟环境或作者机器的私有路径。
总结
这次实验把“哪个头最重要”改写为可以复查的问题:在固定模型、候选答案和干预节点后,改变反事实配对,贡献排序如何变化?稳健结论应同时交代保持的头、变化的幅度与实验边界。排名是选择后续干预的证据,尚不是机制解释的终点。
参考资料
检索与访问日期:2026-10-18。以下均为一手资料;固定源码的哈希与许可证见源码地图。
- Kevin Wang、Alexandre Variengien、Arthur Conmy、Buck Shlegeris、Jacob Steinhardt,2022 初版:Interpretability in the Wild: a Circuit for Indirect Object Identification in GPT-2 small,v1。
- Fred Zhang、Neel Nanda,ICLR 2024:Towards Best Practices of Activation Patching in Language Models: Metrics and Methods,v2。
- TransformerLens:固定版本激活替换实现。
- Hugging Face Transformers:固定版本 GPT-2 前向。
- OpenAI / Hugging Face:GPT-2 固定模型卡。
- Redwood Research:IOI 公开模板固定源码。