- 日期:2026-10-09
- 讀者:研究生、科研新人和工程型研究者
- 範圍:凍結小模型、SST-2的64條開發樣本、五種呈現與計分條件;不是完整基準或未見測試。
摘要:只多答對一題,可能換了六十三個答案
**本次實際驗證:**同一模型以字母計分時,交換選項內容後,正確數從32變為33,看起來幾乎沒變;但映射回正負情感後,63/64題改變了預測。若對答案文本計分,換序只改變1/64題。平均準確率描述答對多少,卻未告訴我們模型是否還在作出相同判斷。
上一篇研究示例選擇與順序,本篇把示例數固定為零,新增問題是:選項的內容、位置、字母與計分字符串,能否被當成同一個答案?我們沿用模型、數據版本和開發題號,新增可審計的置換映射、候選token記錄與逐題差異,不從五種設置中挑一個最高分包裝成改進。
復現價值與論文位置
多項選擇評測常把開放生成變成有限候選比較,便於執行,卻額外引入了表示方式。Pezeshkpour與Hruschka在2024年研究了選項順序對大模型的影響;Wang等同年指出,首token概率與模型實際生成的文本答案可能不一致。[1][2] 這些論文支持研究問題的必要性,不支持把它們報告的幅度搬到本篇小模型上。
**論文報告與本次實驗的區別:**本文沒有復現論文中的完整模型矩陣、自由生成或去偏算法。SST-2原本是二分類情感任務;我們在官方文本候選協議上添加A/B列表,這是刻意構造的測量對照。它能檢驗這個提示下的穩定性,不能代表模型全部閱讀理解能力。[3][4]
核心思想:先區分三種“答案”
原始標籤零表示負面,一表示正面。正序列表為A對應negative、B對應positive;反序則A對應positive、B對應negative。位置字母仍按A、B排列,移動的是內容。若反序後仍把A當成負面,即使模型分數完全正確,評測也會算錯。
令第題上下文為,候選位置的答案字符串包含個token,則條件對數似然為
是凍結權重,是候選的第個token;只累計答案部分,負值越接近零越優。模型不是自由說出答案,而是在我們指定的兩個續寫字符串之間被比較。
把顯示位置映射為原始語義標籤,是數據金標籤,是官方評分所需的正確候選位置。正序映射為零、一,反序為一、零;必須先還原語義預測再做跨條件配對。並列最大值取首項,規則在推理前凍結。
同一列表提示下比較A/B概率,估計的是字母續寫偏好;比較negative/positive概率,估計的是文本續寫偏好。我們沒有另外添加“只回答字母”或“只回答文本”的指令,因此兩組上下文逐題完全相同。這隔離了候選空間的變化,但並不測量輸出格式服從度,也不能斷言兩種受限概率就是自由回答時的選擇。[2]
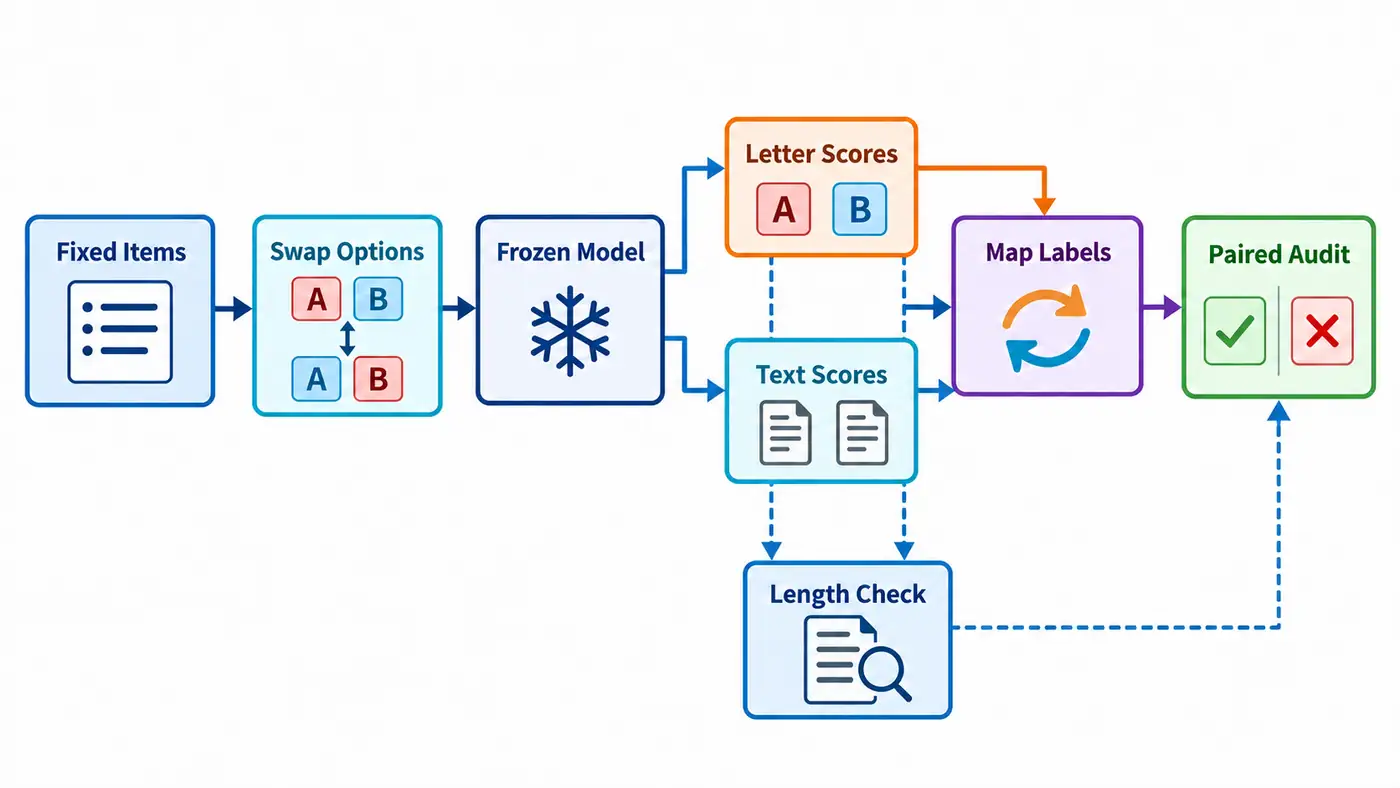
圖中顏色表示語義內容,字母表示顯示位置。兩條計分支路先映射標籤,再逐題比較;長度檢查讀取兩路候選,不能拿示意圖中的圖標當成測量結果。
公式之外:長度歸一化的分母是誰
常見的“歸一化”至少有兩個定義:把除以實際續寫token數,或除以候選字符串字符數。本次固定harness的acc_norm使用後者;前置分隔空格參與分詞,但不計入候選字符數。[5] 名字相同並不保證數學對象相同。
實際分詞中,帶空格的negative、positive、A、B分別對應單個token,編號3524、2731、330、389。兩個情感詞各八個字符,兩個字母各一個字符。因此在每個條件內,兩種分母都相等:三種計分必然保持argmax,實測也逐題一致。這是本設置的代數性質,不是“歸一化永遠無影響”的經驗結論。我們沒有事後換成長短不同的近義詞製造效果,因為那會同時改變答案措辭。
官方代碼閱讀路線
先讀固定提交的SST-2配置,確認題幹、Answer:結尾、negative/positive順序和原始標籤。[4] 接著讀api/model.py的_encode_pair:完整拼接後的分詞未必等於分別編碼再拼接。獨立實現斷言上下文token是完整序列的前綴,超出512長度直接失敗,不允許靜默截斷。
再看Hugging Face後端的_loglikelihood_tokens。若題幹長、完整序列長,輸入形狀為,logits為;第一個答案token讀取位置的分佈。最後檢查process_results中的標籤、argmax和字符歸一化。[5][6] 本篇直接調用官方似然與任務評分接口,外層循環是自寫教學代碼,沒有聲稱運行完全未改動的默認任務。
六個實際安裝文件已與固定官方源碼逐字節比對,並重新匿名下載核驗。SOURCE_MAP.md列出函數、行號、許可證和本地對應關係,避免讓“官方實現”成為無法追蹤的口號。
最小實驗與評測協議
模型與tokenizer凍結為SmolLM2-135M-Instruct的12fd25f…;完整revision保存在資源鎖中。[7] GLUE數據凍結為bcdcba79…,讀取sst2的train與validation,僅推理既有64條開發題;128條SST-2確認題及64條新聞確認題沒有進入模型。[8] 同一開發集此前已被觀察,本文屬於探索性協議研究。
五個條件為原始文本基線、帶列表文本正反序、帶列表字母正反序。每題每組兩個候選,共640個候選分數;每個都經過獨立前向和官方後端雙路徑計算。主要指標預先定為換序後的語義預測翻轉數及勝負題數,準確率和長度診斷為輔助指標。統計單位仍為64道題,不能把320條條件記錄說成320個獨立樣本。
CPU單精度、四線程、eager注意力、種子96,關閉聊天模板、訓練和推理緩存,不加BOS或EOS。緩存身份保存模型、tokenizer、數據、提示構造代碼、配置與計分協議。四個列表條件的上下文逐題同長,為27至69個token;候選輸入總量各5530,原始基線為4506。列表相對基線多了提示token,不能把這項比較稱為嚴格等計算量。
本次實際驗證:總分掩蓋了什麼
| 條件 | 正確數 | 預測positive數 | 選第一位置數 |
|---|---|---|---|
| 原始文本基線 | 32/64 | 3 | 61 |
| 列表文本正序 | 31/64 | 0 | 64 |
| 列表文本反序 | 32/64 | 1 | 1 |
| 列表字母正序 | 32/64 | 1 | 63 |
| 列表字母反序 | 33/64 | 64 | 64 |
文本正反序只翻轉題號170,新增一題正確;字母正反序翻轉63題,其中32題由錯變對、31題由對變錯,淨增同樣只有一題。反序下比較兩個候選空間,也有63題語義預測不同。正序則只有題號287不同。只寫“差一點點”,會漏掉這組最主要的證據。
這張表還有一個容易忽略的背景:開發標籤包含31條負面和33條正面。反序字母全部預測正面,正好得到33題正確;這個數已經能由類別分佈解釋,不能據此稱該設置更會理解情感。相應地,文本正序全部預測負面,也能得到31題正確。報告常量類別基線,能阻止我們把一兩個百分點誤寫成任務能力提升。
候選分數本身也有邊界。某個字符串在兩者中概率較大,不代表模型把大部分概率質量分配給這兩個字符串;其他詞、換行或解釋前綴仍可能更可能出現。尤其不能把文本支路的負對數概率直接與字母支路相減,解釋為“信心提高多少”:兩個續寫空間不同,缺少共同的校準定義。本文只比較各空間內部的選擇和還原後的語義結果,不報告跨空間置信度增益。
題號400提供了一個可復算例子:正序字母A、B得分約為−5.079、−5.904,選擇A並映射為負面;反序得分約−3.946、−4.844,仍選擇A,但映射為正面。原標籤為正面,因此它成為一次收益。題號615同樣保持選A,卻從正確變錯誤。兩例無需編寫模型心理故事,就能說明收益與損失為何相互抵消。
**作者推斷:**字母支路表現出強烈的A或第一位置偏好,文本支路則大多保留負面預測;但A始終處於第一位置,兩者在本實驗中混雜,尚不能區分符號先驗與位置偏好。文本更穩定也不等於更正確:它幾乎總選負面。這是穩定性與能力必須分開報告的反例。
獨立復算覆蓋320條記錄、640候選,官方得分最大差為零;標籤映射、正確數、配對收益損失與形狀檢查全部通過。兩題全條件試跑估算正式運行約280秒,低於1200秒預算;正式流程導入後耗時43.56秒,峰值RSS為1568227328字節,外部命令牆鍾47.12秒。GPU內存未測量,資源數字不包含依賴下載。
失敗排查:先懷疑協議,再解釋模型
第一次試跑把新增標籤字段當作字符串配置,框架把它理解成模板文本,官方指標一致性斷言失敗。改成讀取該字段的函數後,又因任務初始化探測原始樣本而觸發缺字段錯誤。最終直接從原始label計算置換後位置,才同時滿足初始化和正式評分。兩次失敗及修復前源碼均保留,沒有刪除後只報成功。
復現遇到異常,應依次核對句子哈希與題號、原標籤與顯示位置、候選前空格、因果移位、長度上限,再檢查累計與歸一化。獨立腳本沒有導入推理程序;六個變異測試主動破壞標籤、分數、條數、重複記錄、token數和預測,均被拒絕。這是自動算術復算,不是人工審核。OneDrive環境啟動阻塞通過同版本臨時環境重建恢復,模型與數據哈希未變。
源碼與復現入口
配套源碼已公開:固定提交源碼目錄、README與運行說明、SOURCE_MAP源碼地圖。43個文件已匿名下載,逐文件哈希與本地歸檔一致;所有鏈接固定到同一提交。
依README安裝固定依賴並用prepare.py獲取哈希鎖定資源後,最小真實運行命令為:
python run.py --cache ./cache --out ./replay-smoke --smoke
預期產生逐題候選記錄、彙總、環境、階段狀態與身份文件;去掉--smoke執行64題正式範圍。audit.py可離線復算已保存結果。本次真實運行覆蓋五條件的全部開發題,不包含生成、訓練或人工金標。公開包不分發許可未明確的影評原文、題幹token和模型權重,保留固定下載入口、索引與派生分數;本地ZIP用於歸檔驗收。
可檢驗的研究問題與總結
下一步可以凍結其餘設置,讓A/B保持各自語義、僅改變顯示行次序,再與當前交換內容的對照組成因子設計,區分字母身份和物理位置。若偏好跟隨A移動,支持符號解釋;若始終跟隨第一行,支持位置解釋。正式執行前應登記預算,不能看結果後補故事。
另一問題是受限概率與實際生成是否一致。下一篇將轉向答案抽取,並準備真實人員標註的小金標;當前算術審計不能替代語義判斷。這裡得到的可複查結論是:總分僅差一題,仍可能對應六十三次語義翻轉。研究報告應交付這種差異的路徑,而不只交付一個排名數字。
參考資料
檢索並打開日期:2026-10-09;固定源碼另保存匿名下載與哈希核驗記錄。
- Pezeshkpour, Pouya; Hruschka, Estevam. 2024. Large Language Models Sensitivity to The Order of Options in Multiple-Choice Questions. Findings of NAACL,會議版。
- Wang, Xinpeng等. 2024. “My Answer is C”: First-Token Probabilities Do Not Match Text Answers in Instruction-Tuned Language Models. Findings of ACL,會議版。
- Socher, Richard等. 2013. Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank. EMNLP。
- EleutherAI. 固定SST-2任務配置,harness 0.4.9.2。
- EleutherAI. process_results與字符長度歸一化。
- EleutherAI. Hugging Face候選似然後端。
- HuggingFaceTB. SmolLM2-135M-Instruct固定模型卡。
- NYU. GLUE固定數據卡,sst2配置與數據版本見資源鎖。