- 日期:2026-10-09
- 读者:研究生、科研新人和工程型研究者
- 范围:冻结小模型、SST-2的64条开发样本、五种呈现与计分条件;不是完整基准或未见测试。
摘要:只多答对一题,可能换了六十三个答案
**本次实际验证:**同一模型以字母计分时,交换选项内容后,正确数从32变为33,看起来几乎没变;但映射回正负情感后,63/64题改变了预测。若对答案文本计分,换序只改变1/64题。平均准确率描述答对多少,却未告诉我们模型是否还在作出相同判断。
上一篇研究示例选择与顺序,本篇把示例数固定为零,新增问题是:选项的内容、位置、字母与计分字符串,能否被当成同一个答案?我们沿用模型、数据版本和开发题号,新增可审计的置换映射、候选token记录与逐题差异,不从五种设置中挑一个最高分包装成改进。
复现价值与论文位置
多项选择评测常把开放生成变成有限候选比较,便于执行,却额外引入了表示方式。Pezeshkpour与Hruschka在2024年研究了选项顺序对大模型的影响;Wang等同年指出,首token概率与模型实际生成的文本答案可能不一致。[1][2] 这些论文支持研究问题的必要性,不支持把它们报告的幅度搬到本篇小模型上。
**论文报告与本次实验的区别:**本文没有复现论文中的完整模型矩阵、自由生成或去偏算法。SST-2原本是二分类情感任务;我们在官方文本候选协议上添加A/B列表,这是刻意构造的测量对照。它能检验这个提示下的稳定性,不能代表模型全部阅读理解能力。[3][4]
核心思想:先区分三种“答案”
原始标签零表示负面,一表示正面。正序列表为A对应negative、B对应positive;反序则A对应positive、B对应negative。位置字母仍按A、B排列,移动的是内容。若反序后仍把A当成负面,即使模型分数完全正确,评测也会算错。
令第题上下文为,候选位置的答案字符串包含个token,则条件对数似然为
是冻结权重,是候选的第个token;只累计答案部分,负值越接近零越优。模型不是自由说出答案,而是在我们指定的两个续写字符串之间被比较。
把显示位置映射为原始语义标签,是数据金标签,是官方评分所需的正确候选位置。正序映射为零、一,反序为一、零;必须先还原语义预测再做跨条件配对。并列最大值取首项,规则在推理前冻结。
同一列表提示下比较A/B概率,估计的是字母续写偏好;比较negative/positive概率,估计的是文本续写偏好。我们没有另外添加“只回答字母”或“只回答文本”的指令,因此两组上下文逐题完全相同。这隔离了候选空间的变化,但并不测量输出格式服从度,也不能断言两种受限概率就是自由回答时的选择。[2]
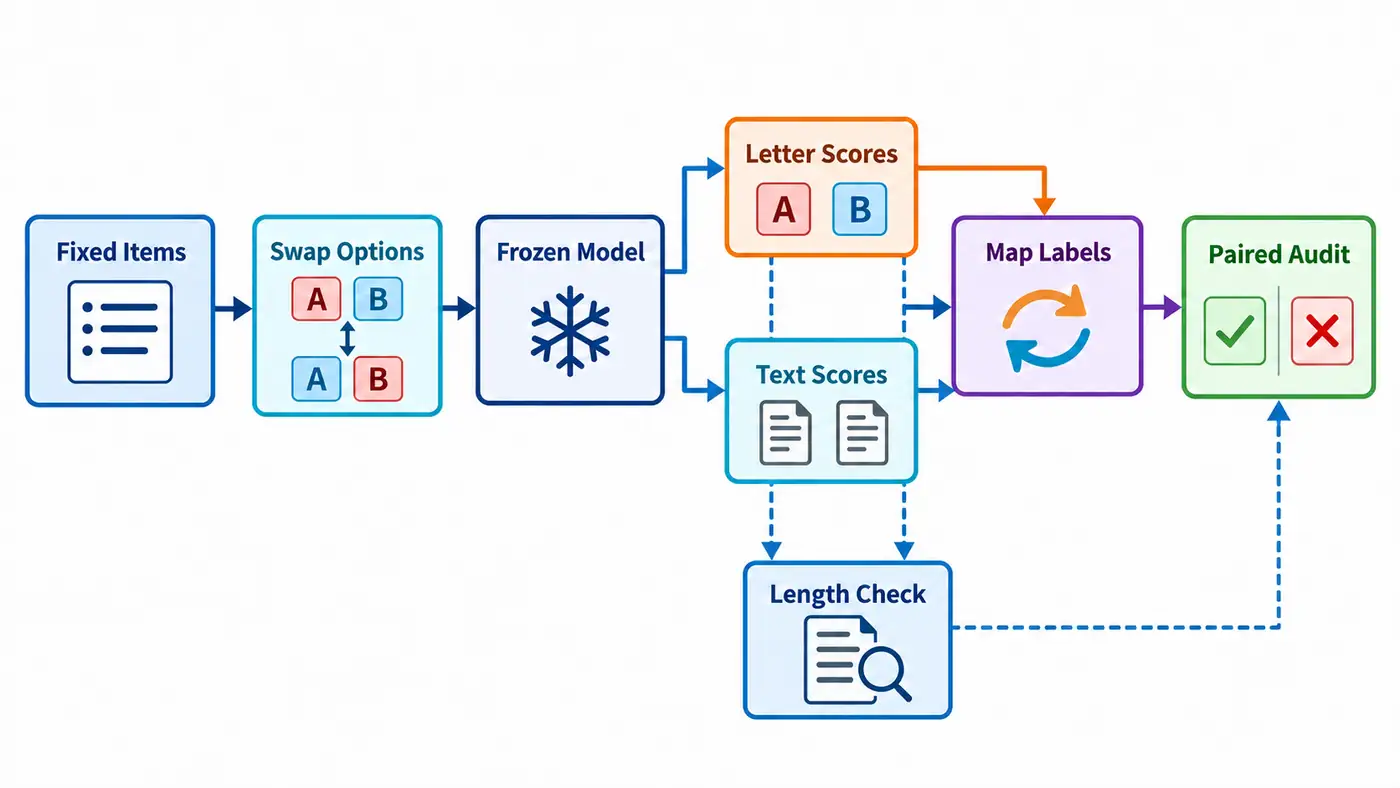
图中颜色表示语义内容,字母表示显示位置。两条计分支路先映射标签,再逐题比较;长度检查读取两路候选,不能拿示意图中的图标当成测量结果。
公式之外:长度归一化的分母是谁
常见的“归一化”至少有两个定义:把除以实际续写token数,或除以候选字符串字符数。本次固定harness的acc_norm使用后者;前置分隔空格参与分词,但不计入候选字符数。[5] 名字相同并不保证数学对象相同。
实际分词中,带空格的negative、positive、A、B分别对应单个token,编号3524、2731、330、389。两个情感词各八个字符,两个字母各一个字符。因此在每个条件内,两种分母都相等:三种计分必然保持argmax,实测也逐题一致。这是本设置的代数性质,不是“归一化永远无影响”的经验结论。我们没有事后换成长短不同的近义词制造效果,因为那会同时改变答案措辞。
官方代码阅读路线
先读固定提交的SST-2配置,确认题干、Answer:结尾、negative/positive顺序和原始标签。[4] 接着读api/model.py的_encode_pair:完整拼接后的分词未必等于分别编码再拼接。独立实现断言上下文token是完整序列的前缀,超出512长度直接失败,不允许静默截断。
再看Hugging Face后端的_loglikelihood_tokens。若题干长、完整序列长,输入形状为,logits为;第一个答案token读取位置的分布。最后检查process_results中的标签、argmax和字符归一化。[5][6] 本篇直接调用官方似然与任务评分接口,外层循环是自写教学代码,没有声称运行完全未改动的默认任务。
六个实际安装文件已与固定官方源码逐字节比对,并重新匿名下载核验。SOURCE_MAP.md列出函数、行号、许可证和本地对应关系,避免让“官方实现”成为无法追踪的口号。
最小实验与评测协议
模型与tokenizer冻结为SmolLM2-135M-Instruct的12fd25f…;完整revision保存在资源锁中。[7] GLUE数据冻结为bcdcba79…,读取sst2的train与validation,仅推理既有64条开发题;128条SST-2确认题及64条新闻确认题没有进入模型。[8] 同一开发集此前已被观察,本文属于探索性协议研究。
五个条件为原始文本基线、带列表文本正反序、带列表字母正反序。每题每组两个候选,共640个候选分数;每个都经过独立前向和官方后端双路径计算。主要指标预先定为换序后的语义预测翻转数及胜负题数,准确率和长度诊断为辅助指标。统计单位仍为64道题,不能把320条条件记录说成320个独立样本。
CPU单精度、四线程、eager注意力、种子96,关闭聊天模板、训练和推理缓存,不加BOS或EOS。缓存身份保存模型、tokenizer、数据、提示构造代码、配置与计分协议。四个列表条件的上下文逐题同长,为27至69个token;候选输入总量各5530,原始基线为4506。列表相对基线多了提示token,不能把这项比较称为严格等计算量。
本次实际验证:总分掩盖了什么
| 条件 | 正确数 | 预测positive数 | 选第一位置数 |
|---|---|---|---|
| 原始文本基线 | 32/64 | 3 | 61 |
| 列表文本正序 | 31/64 | 0 | 64 |
| 列表文本反序 | 32/64 | 1 | 1 |
| 列表字母正序 | 32/64 | 1 | 63 |
| 列表字母反序 | 33/64 | 64 | 64 |
文本正反序只翻转题号170,新增一题正确;字母正反序翻转63题,其中32题由错变对、31题由对变错,净增同样只有一题。反序下比较两个候选空间,也有63题语义预测不同。正序则只有题号287不同。只写“差一点点”,会漏掉这组最主要的证据。
这张表还有一个容易忽略的背景:开发标签包含31条负面和33条正面。反序字母全部预测正面,正好得到33题正确;这个数已经能由类别分布解释,不能据此称该设置更会理解情感。相应地,文本正序全部预测负面,也能得到31题正确。报告常量类别基线,能阻止我们把一两个百分点误写成任务能力提升。
候选分数本身也有边界。某个字符串在两者中概率较大,不代表模型把大部分概率质量分配给这两个字符串;其他词、换行或解释前缀仍可能更可能出现。尤其不能把文本支路的负对数概率直接与字母支路相减,解释为“信心提高多少”:两个续写空间不同,缺少共同的校准定义。本文只比较各空间内部的选择和还原后的语义结果,不报告跨空间置信度增益。
题号400提供了一个可复算例子:正序字母A、B得分约为−5.079、−5.904,选择A并映射为负面;反序得分约−3.946、−4.844,仍选择A,但映射为正面。原标签为正面,因此它成为一次收益。题号615同样保持选A,却从正确变错误。两例无需编写模型心理故事,就能说明收益与损失为何相互抵消。
**作者推断:**字母支路表现出强烈的A或第一位置偏好,文本支路则大多保留负面预测;但A始终处于第一位置,两者在本实验中混杂,尚不能区分符号先验与位置偏好。文本更稳定也不等于更正确:它几乎总选负面。这是稳定性与能力必须分开报告的反例。
独立复算覆盖320条记录、640候选,官方得分最大差为零;标签映射、正确数、配对收益损失与形状检查全部通过。两题全条件试跑估算正式运行约280秒,低于1200秒预算;正式流程导入后耗时43.56秒,峰值RSS为1568227328字节,外部命令墙钟47.12秒。GPU内存未测量,资源数字不包含依赖下载。
失败排查:先怀疑协议,再解释模型
第一次试跑把新增标签字段当作字符串配置,框架把它理解成模板文本,官方指标一致性断言失败。改成读取该字段的函数后,又因任务初始化探测原始样本而触发缺字段错误。最终直接从原始label计算置换后位置,才同时满足初始化和正式评分。两次失败及修复前源码均保留,没有删除后只报成功。
复现遇到异常,应依次核对句子哈希与题号、原标签与显示位置、候选前空格、因果移位、长度上限,再检查累计与归一化。独立脚本没有导入推理程序;六个变异测试主动破坏标签、分数、条数、重复记录、token数和预测,均被拒绝。这是自动算术复算,不是人工审核。OneDrive环境启动阻塞通过同版本临时环境重建恢复,模型与数据哈希未变。
源码与复现入口
配套源码已公开:固定提交源码目录、README与运行说明、SOURCE_MAP源码地图。43个文件已匿名下载,逐文件哈希与本地归档一致;所有链接固定到同一提交。
依README安装固定依赖并用prepare.py获取哈希锁定资源后,最小真实运行命令为:
python run.py --cache ./cache --out ./replay-smoke --smoke
预期产生逐题候选记录、汇总、环境、阶段状态与身份文件;去掉--smoke执行64题正式范围。audit.py可离线复算已保存结果。本次真实运行覆盖五条件的全部开发题,不包含生成、训练或人工金标。公开包不分发许可未明确的影评原文、题干token和模型权重,保留固定下载入口、索引与派生分数;本地ZIP用于归档验收。
可检验的研究问题与总结
下一步可以冻结其余设置,让A/B保持各自语义、仅改变显示行次序,再与当前交换内容的对照组成因子设计,区分字母身份和物理位置。若偏好跟随A移动,支持符号解释;若始终跟随第一行,支持位置解释。正式执行前应登记预算,不能看结果后补故事。
另一问题是受限概率与实际生成是否一致。下一篇将转向答案抽取,并准备真实人员标注的小金标;当前算术审计不能替代语义判断。这里得到的可复查结论是:总分仅差一题,仍可能对应六十三次语义翻转。研究报告应交付这种差异的路径,而不只交付一个排名数字。
参考资料
检索并打开日期:2026-10-09;固定源码另保存匿名下载与哈希核验记录。
- Pezeshkpour, Pouya; Hruschka, Estevam. 2024. Large Language Models Sensitivity to The Order of Options in Multiple-Choice Questions. Findings of NAACL,会议版。
- Wang, Xinpeng等. 2024. “My Answer is C”: First-Token Probabilities Do Not Match Text Answers in Instruction-Tuned Language Models. Findings of ACL,会议版。
- Socher, Richard等. 2013. Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank. EMNLP。
- EleutherAI. 固定SST-2任务配置,harness 0.4.9.2。
- EleutherAI. process_results与字符长度归一化。
- EleutherAI. Hugging Face候选似然后端。
- HuggingFaceTB. SmolLM2-135M-Instruct固定模型卡。
- NYU. GLUE固定数据卡,sst2配置与数据版本见资源锁。